登录社区云,与社区用户共同成长
邀请您加入社区
Mahdieh Allahviranloo作为某中心最后一英里科学团队的访问学者,正在利用她在纽约市立学院的学术休假期间,研究提升某中心最后一英里配送网络效率的方法。
具体到落地上,我们可以通过Copilot Labs,在Copilot Daily中以AI主播播报要闻、在Copilot Podcasts生成播客式讨论,Copilot Labs 提供可玩Demo(可以自定义内容、叙述风格等)。这标志着在多年依赖OpenAI模型之后,微软AI部门正式与OpenAI及整个行业正面竞争,也意味着微软在AI竞赛中,开始掌握更多主动权。我们必须具备内部能力,来打造世界最强的
随着云计算、微服务架构的普及,现代信息系统的复杂度呈指数级增长。以某头部电商平台为例,其单日产生的服务器日志、交易日志、用户行为日志总量已超过500TB。规则滞后:新异常模式需人工定义,无法应对0day攻击或系统升级后的未知异常;误报/漏报率高:静态阈值难以适应动态业务场景(如大促期间QPS自然飙升);维护成本高:微服务架构下服务实例数可达数万,规则需逐个配置。本文聚焦大数据场景下的日志异常检测日
基于Python的高校毕业生招聘信息推荐系统摘要 该系统采用Python+Django+Vue技术栈,结合协同过滤算法与数据爬虫技术,构建智能招聘信息推荐平台。核心功能包括:1)BOSS直聘数据爬取与清洗;2)基于用户行为的协同过滤推荐;3)Echarts可视化大屏展示就业市场多维度分析;4)完整的用户-企业-管理员三方交互体系。系统实现了招聘信息精准匹配、就业市场动态可视化、高效求职服务等功能,
本文比较了机器学习和深度学习两大人工智能技术的核心区别。机器学习通过算法从数据中学习规律,强调特征工程和通用算法,适用于结构化数据;深度学习是机器学习的子集,利用多层神经网络自动学习特征,擅长处理图像、语音等复杂数据。机器学习更简单可解释但依赖人工特征工程,深度学习性能更强但需要海量数据和算力。实际应用中应根据数据类型、任务复杂度等选择合适技术,未来两者将协同发展。
机器学习入门实践:加州房价预测从 0 到 1 全过程。
在工业领域,设备状态监测至关重要。其目的是预防设备故障、保障生产活动的更高质量,同时减少停机时间、提高工厂设备利用率。在此背景下,本研究提出通过实验台对液压泵运行时的电流与电压特性进行识别。研究搭建了一套液压系统原型用于数据采集,并通过自主开发的算法,从工业生产过程产生的目标信号中提取关键信息。研究采用机器学习工具进行属性提取与筛选(如标准差、熵、谐波等属性),以识别与液压泵故障相关的特征参数。本
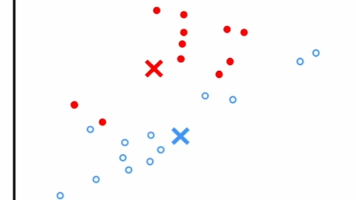
机器学习可以分为无监督学习与有监督学习两类,之前所了解的线性回归、逻辑回归与决策树等等,都是有监督学习,根据学习输入样本特征与标签之间来进行回归、分类等。而无监督学习则没有标签,需要自动的来寻找挖掘来一些可用的信息,对于聚类而言,则是。
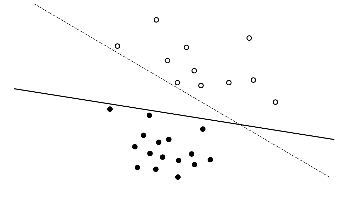
本文介绍了统计机器学习中的岭回归和感知机方法。岭回归通过引入L2范数惩罚项解决了线性回归中多重共线性导致的矩阵不可逆问题,推导了其闭式解。感知机则是一种线性分类器,通过定义误分类点距离损失函数,并采用随机梯度下降进行优化。文章详细阐述了两种方法的数学原理、损失函数设计及优化过程,特别强调了岭回归中惩罚参数λ的作用和感知机中损失函数的推导思路。
# sklearn Pipeline 简明摘要 **核心功能**:Pipeline 是 scikit-learn 提供的链式估计器工具,支持将数据预处理和模型训练步骤串联成统一流程。 **主要优势**: - 简化代码结构,避免中间变量 - 防止交叉验证时的数据泄露 - 支持统一参数调优 - 便于模型保存与部署 **两种创建方式**: 1. `Pipeline(steps)`:需显式命名每个步骤 2
并指导模型通过优化算法(如梯度下降)不断调整参数以减少这种差异。是衡量模型预测结果与真实值之间差异的核心工具。(预测离散类别,如图像分类、文本情感分析)。(预测连续数值,如房价、温度)。
大数据不会+框架不熟+算法头疼?基于Spark+Django的食物口味分析系统一站式解决方案
scikit-learn中的FeatureUnion工具可以并行组合多个特征提取器,将不同特征提取方法的结果横向拼接成一个更大的特征矩阵。它支持多种特征处理方式(如TF-IDF、词袋模型、PCA等)的并行执行,并通过统一接口进行调用。典型应用场景包括:同时使用多种特征提取方法、处理异构数据以及构建复杂特征工程流水线。使用示例展示了文本特征组合(TF-IDF+词袋模型)、数值特征组合(PCA+标准化
结合信息检索与生成式大模型,使得模型在回答问题时,实时引入外部知识库,提升模型的在知识密集任务中的表现。Agent(智能体),AI系统实现自主决策的核心载体。机制:奖励系统驱动模型在试错中优化策略,模拟人类“先思考后回答”的认知过程。核心思想:智能并非孤立于大脑,而是身体、环境、感知运动系统协同作用的产物。模型表示自然语言文本的最小单位,计费的基本单位。模型输出答案前的思考步骤长度,提升答案准确性
本文介绍了如何使用 scikit-learn 的 HTML 可视化功能来直观展示机器学习流程。主要内容包括: 通过 set_config(display='diagram') 启用 HTML 图表显示功能 支持 Pipeline、ColumnTransformer 等复杂结构的可视化展示 图表特性: 可展开/折叠的嵌套结构 参数悬停提示 绿色对勾标记已拟合状态 颜色编码区分不同类型组件 支持动态更
机器学习:Spark抖音短视频数据分析可视化系统 Hadoop+Hive 机器学习 线性回归预测算法 情感分析 舆情分析 爬虫 毕业设计✅
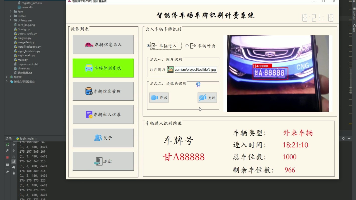
优秀毕业设计:python车牌识别计费管理系统 智能停车场 HyperLPR 中文车牌识别框架 OpenCV 深度学习 毕业设计(源码+文档)✅
机器学习是人工智能的核心领域,使计算机能够从数据中自动学习规律,而非依赖人工编程指令。主要包括两种范式:监督学习通过带标签数据训练预测模型(如房价预测、垃圾邮件过滤),无监督学习则从无标签数据中发现隐藏模式(如新闻分类、客户分群)。通过优化算法持续调整模型参数,最终实现对新数据的智能预测与分析。机器学习,就是让计算机程序(机器)通过从数据中自动学习和分析获得规律(模式),并利用这些规律对未知数据进
本文介绍了一个基于Hadoop+Spark的全球游戏评分与销量可视化分析系统,该系统通过整合游戏销量、用户评分等数据,利用大数据技术进行分析,为玩家提供个性化推荐,并为游戏开发商提供市场趋势分析。系统涵盖数据采集、处理、分析及可视化模块,采用Python、Spark等技术,结合Vue和Echarts实现直观的可视化界面。核心功能包括数据清洗、游戏类型评分分析等,旨在提升用户体验并支持行业决策。开发
本文详细解析了 sklearn 中回归任务目标变量转换的方法与实现。主要内容包括:目标转换的必要性(满足模型假设、稳定方差、处理非线性等);常用的转换方法如对数变换、Box-Cox变换等;核心工具 TransformedTargetRegressor 的使用与参数详解。文章通过具体示例展示了如何应用这些技术,并强调了转换器选择与逆变换的注意事项,为回归建模中的目标变量预处理提供了全面指导。
本文介绍了基于Hadoop+Spark的化妆品销售数据可视化分析与商品推荐系统。系统采用Python爬虫采集淘宝美妆数据,通过Hadoop进行分布式存储,利用Spark进行数据处理和协同过滤推荐算法建模。前端使用Vue+Echarts实现交互式可视化大屏,展示商品地域分布、价格区间、销量趋势等多维度分析结果。系统包含用户端(商品浏览、个性化推荐)和管理端(数据管理、可视化分析)功能模块,为电商运营
优秀毕业设计:python朴素贝叶斯垃圾邮件分类与检测系统 邮件分类检测 Flask框架 可视化 数据分析 机器学习 大数据毕业设计✅
计算机毕设选题太普通?基于Hadoop+Django的食物营养数据可视化分析系统让你脱颖而出毕业设计/选题推荐/深度学习/数据分析/机器学习/数据挖掘/随机森林
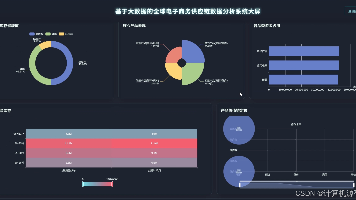
本文介绍了一个基于Spark的全球电子商务供应链数据分析系统,旨在通过大数据技术优化供应链管理。系统整合了销售分析、库存健康评估、市场趋势预测等功能模块,采用Python、Spark、Hadoop等技术处理海量数据,并提供可视化大屏辅助决策。开发者具有8年全栈经验,涵盖Java、Python等多种技术栈,提供源码支持和技术交流。系统通过实时数据分析帮助企业降低库存成本、提升响应速度,适用于电子商务