登录社区云,与社区用户共同成长
邀请您加入社区
本文详细解析了 sklearn 中回归任务目标变量转换的方法与实现。主要内容包括:目标转换的必要性(满足模型假设、稳定方差、处理非线性等);常用的转换方法如对数变换、Box-Cox变换等;核心工具 TransformedTargetRegressor 的使用与参数详解。文章通过具体示例展示了如何应用这些技术,并强调了转换器选择与逆变换的注意事项,为回归建模中的目标变量预处理提供了全面指导。
我们同样使用 nn.Sequential类用来实现的顺序连接模型,首先放入一个展平层nn.Flatten(),将二维灰度图像降维,原来28*28的二维张量就变成长度为784的一维张量。接下来连接一个线性层,由于输入已经在上一层展平,所以线性层的输入长度为784,又由于我们规定结果分为10个类,所以线性层的输出长度为10。在模型初始化时,这里用了方法 model.apply() ,其会递归地遍历mo
一、研究背景与算法改进动因:GRNN 的预测特性适配性动态多目标优化问题(DMOOPs)中,环境变化的非线性程度与数据稀疏性仍是预测模块的核心挑战 ——CEC2018 测试集(DF1-DF14)中,DF4、DF7 等非线性场景的目标空间映射关系复杂,DF5、DF8 等离散场景的历史数据分布不均,传统 RBF 神经网络虽能局部拟合,但在数据稀疏区域易出现预测偏差,且隐含层节点中心的 K-means
本文针对小样本回归任务(几十到几百个样本)提出实用建议。核心思路是避免过拟合,推荐优先使用简单模型(线性/非线性回归、浅层决策树),慎用复杂模型。提出6个关键技巧:1)严格清洗异常值;2)精选强相关特征;3)采用交叉验证;4)添加正则化约束;5)合理数据增强;6)接受合理误差范围。强调训练与测试误差应接近,避免过度追求完美拟合。按此流程可提升30%准确率,有效规避过拟合风险。
有欲以观其妙,无欲以观其徼,此二者同出而异名。
来自MLACADEMY.AI的图表,清晰展示了六种关键回归评估指标,每个指标都配有数学公式和两点评述!🤖 欢迎评论分享你的经验,转发给小伙伴,或加入粉丝群【智能时刻的铁粉群】这些指标是机器学习回归任务中的核心工具,帮助评估模型性能!🟢 Weighted MAPE (加权平均绝对百分比误差)🟢 MAPE (平均绝对百分比误差)→ 如果模型表现比基线差,可能为负。🟢 RMSE (均方根误差)?
落日与晚风,尽情的相拥。
机器学习实战项目中,回归与分类模型中该如何科学定义目标变量Y?
【机器学习与实战】回归分析与预测:线性回归-03-损失函数与梯度下降
【机器学习与实战】回归分析与预测:线性回归-05-多元线性回归与实战
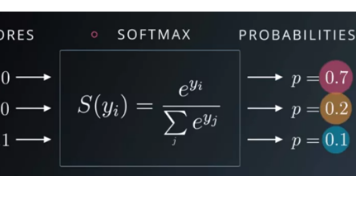
本文系统介绍了深度学习中的两大基础模型:线性回归和Softmax回归。线性回归用于连续值预测,通过线性方程构建特征与输出的映射关系,采用均方损失和梯度下降进行优化;Softmax回归则用于多分类任务,在线性层基础上通过Softmax函数将得分转换为概率,使用交叉熵损失优化。二者虽简单但蕴含了深度学习核心思想:任务适配的模型设计、梯度优化的参数学习、从简单到复杂的进阶路径。掌握这两个模型不仅能解决实
在深度学习的知识体系中,线性回归和Softmax 回归是两大基石模型 —— 前者是解决 “连续值预测” 的入门工具(如房价估计),后者则是实现 “多类别分类” 的核心方法(如手写数字识别)。
线性回归是回归问题的基础模型,通过梯度下降优化。Softmax回归适用于多类分类,输出为概率分布。小批量随机梯度下降是深度学习中默认的优化算法。学习率和批量大小是训练过程中需要精心调优的超参数。
线性回归与 Softmax 回归虽同属基础线性模型,但在任务目标、输出形式和损失函数上存在本质区别:线性回归针对连续值预测,输出单个连续结果,用均方损失衡量误差;Softmax 回归针对多类别分类,输出类别概率分布,用交叉熵损失优化模型。从深度学习体系来看,这两个模型是理解复杂网络的关键起点:线性回归的参数优化逻辑(梯度下降、超参数调整)可直接迁移到深度网络训练中;Softmax 回归的全连接层结
本文介绍了线性回归、神经网络优化及分类问题的核心概念。线性回归用于连续值预测,通过建立线性模型拟合特征与输出关系。神经网络通过梯度下降等优化算法调整参数,其中小批量随机梯度下降是常用方法,需合理设置学习率和批量大小。分类问题中,Softmax回归将输出转换为概率分布,配合交叉熵损失函数衡量预测准确性。总体而言,梯度下降是参数优化的关键,Softmax回归适用于多分类任务,超参数选择对模型性能至关重
维度线性回归Softmax 回归核心任务预测连续值(如房价、销量)划分离散类别(如图像、文本分类)输出结果单个连续数各分类的概率(总和为 1)核心函数线性公式y = Xw + b线性公式 + Softmax 函数损失函数平方损失、L1 损失、Huber 损失交叉熵损失模型本质单层神经网络单层全连接神经网络(输出层神经元数 = 类别数)
线性回归是深度学习的 “基础积木”,理解其参数优化逻辑(梯度下降、损失函数),就能迁移到复杂模型;适用场景:房价预测、销量估算、气温预测等连续值预测任务。Softmax 回归是 “回归到分类” 的关键桥梁,通过 Softmax 运算解决了分类任务的概率输出问题;适用场景:手写数字识别、图像分类(如 ImageNet 1000 类)、文本分类(如恶语评论分类)等多类分类任务。共性与延伸两者都是 “单
线性回归和 Softmax 回归是深度学习中的基础模型,分别适用于连续值预测和多类分类任务。梯度下降算法是它们背后重要的优化手段,通过不断沿着梯度反方向更新参数,逐步减小损失函数值,从而找到最优的模型参数。小批量随机梯度下降凭借其在效率和稳定性之间的良好平衡,成为了深度学习中的默认求解算法。而学习率和批量大小这两个超参数,对模型的训练效果和效率有着关键影响,需要根据具体任务进行合理选择。
深度学习-线性回归与 Softmax 回归
本文介绍了深度学习中两个基础模型——线性回归和Softmax回归。线性回归通过最小化预测值与真实值的差异(如平方损失函数)来解决回归问题,使用梯度下降等方法优化参数。Softmax回归则将线性输出转换为概率分布(通过Softmax函数),采用交叉熵损失进行多类分类。这两个模型分别适用于连续值预测(如房价)和离散分类任务(如图像识别),是机器学习的重要基础工具。
模型定位:线性回归用于连续值预测,Softmax 回归用于多类分类,后者可视为针对分类任务优化的单层全连接神经网络。优化核心:梯度法是参数优化的基础,通过沿损失函数的负梯度方向更新参数实现误差最小化;小批量随机梯度下降是深度学习的默认优化算法。关键超参数:批量大小和学习率直接影响模型训练效率与收敛效果,需根据任务场景合理调优。损失函数选择:回归任务可选用平方损失、L1 损失等;分类任务优先使用交叉
线性回归是预测连续值的基础模型,其数学表达式为y=wTx+b(多变量),可看作最简单的神经网络。Softmax回归是解决多分类问题的重要模型,通过Softmax运算将模型输出转换为概率分布,结合交叉熵损失进行训练。损失函数是衡量模型误差的标准,常见的有平方损失、L1损失、Huber损失、交叉熵损失等,需根据具体问题选择。优化算法是寻找最优参数的关键,梯度法是基础,随机梯度下降和小批量随机梯度下降是
Softmax运算:将输出转为概率分布。交叉熵:L = -Σyᵢlog(ŷᵢ)学习率(learning_rate)输出层设计:分类问题用Softmax。随机梯度下降(SGD):单样本更新。学习率选择:需平衡收敛速度与稳定性。批量大小(batch_size)核心模型:y = wx + b。损失函数:平方误差(L2损失)梯度下降:沿负梯度方向更新参数。小批量SGD:深度学习默认算法。全连接层:所有输入
线性回归和 Softmax 回归虽然简单,但它们是深度学习的 “敲门砖”。掌握这两个模型,不仅能解决很多基础的回归和分类问题,更重要的是能理解 “建模→损失→优化” 的核心逻辑 —— 这个逻辑在后续的神经网络、CNN、Transformer 等复杂模型中完全通用。
梯度指向函数值增加最快的方向,因此其反方向是函数值减小最快的方向,这为寻找损失最小值提供了 “方向指引”。离函数最小值点越远,梯度的绝对值越大,意味着在远离最优解时,参数调整的 “步幅” 可更大;靠近最优解时,步幅会自动减小,避免越过最优解。模型定位:线性回归是回归任务的基础模型,输出连续值;Softmax 回归是多分类任务的入门模型,通过 Softmax 运算输出概率分布,本质是单层全连接神经网
摘要:线性回归和Softmax回归是深度学习的基础模型,分别用于连续值预测和离散分类任务。线性回归通过梯度下降优化参数,预测房价等连续值;Softmax回归则通过Softmax运算将输出转化为概率分布,适用于手写数字识别等多分类问题。二者虽结构简单,却体现了模型构建、损失定义和参数优化的核心思想,是理解复杂神经网络的基础。掌握这两个模型对深入学习AI至关重要。
1. 准备数据集2. 构建模型3. 模型训练 2层循环,外层遍历轮次,内层遍历批次4模型预测/评估 和模型训练类似,但是比模型训练简单。
天接云涛连晓雾,星河欲转千帆舞。
空山新雨后,天气晚来秋。明月松间照,清泉石上流。
连山若波涛,奔凑似朝东。
停车坐爱枫林晚,霜叶红于二月花。
训练集样本数目:{(x1,y1),(x2,y2),……}:测试集样本数目x:nx维的特征向量 y∈{0,1}输入X :m列,nx行 : X.shape=(nx,m)输出Y:m列 ,1行 :Y.shape=(1,m)
栀子比众木,人间诚未多。
使用PyTorch的高级API更简洁地实现线性回归模型
之前我们学习了线性回归,可以用于预测多少的问题。现在我们学习另外一种回归,softmax回归,用于解决分类问题。那么接下来我们开始。Softmax回归,也称为多项逻辑回归,是一种用于解决多分类问题的模型。核心思想:对于一个输入样本,Softmax回归会为每一个可能的类别计算出一个概率值。最终,样本被预测为概率最高的那个类别。经过简单介绍之后,我们知道了这个东西大概是什么一回事,只要记住,接下来的东
在工业设备健康管理领域,轴承剩余寿命(RUL)回归预测是保障设备安全运行的核心技术。Transformer-BiLSTM 模型凭借 Transformer 的全局多特征关联捕捉能力与 BiLSTM 的双向时序演化拟合特性,在 RUL 预测中实现高精度表现,但 “黑箱” 特性导致工程师难以知晓 “哪些特征主导寿命预测”“模型为何出现偏差”,制约了工程决策信任度。
一、切削工具剩余可用寿命(RUL)预测的机器学习算法1. 核心问题与数据基础切削工具寿命受磨损累积(后刀面磨损 VB、月牙洼磨损)、加工载荷(切削力 Fz、扭矩 T)、环境参数(切削液温度、振动加速度)影响,RUL 预测需基于时序监测数据(采样频率 100-1000Hz),核心目标是通过历史数据建立 “特征 - 寿命” 映射模型。2. 关键技术环节特征工程:时域特征(均值、方差、峭度)+ 频域特征