沐神《动手学深度学习》之3.4softmax回归
目录
前言
之前我们学习了线性回归,可以用于预测多少的问题。现在我们学习另外一种回归,softmax回归,用于解决分类问题。那么接下来我们开始。
一、简单介绍
Softmax回归,也称为多项逻辑回归,是一种用于解决多分类问题的模型。
核心思想:对于一个输入样本,Softmax回归会为每一个可能的类别计算出一个概率值。最终,样本被预测为概率最高的那个类别。
经过简单介绍之后,我们知道了这个东西大概是什么一回事,只要记住,接下来的东西都是服务于这个功能。
二、分类问题独热编码
这个问题描述起来很简单,把一张照片喂给计算机,让它判断它归属于“猫”或“狗”的哪一类?
可是这有一个问题,计算机无法识别“猫”“狗”这两个概念,那怎么办呢?你可能想到用数字代替,“1”代表猫,“2”代表狗。{猫,狗}={1,2}。恭喜你发明了标签编码。
这很好,可是又有新的问题出现了。
对于机器学习算法来说,数值本身是具有意义的,2比1大,1比0大。如果只是简单的标签分类{苹果,橘子,香蕉,樱桃}分别用{1,2,3,4}代替,那么深度学习可能会得到一个没有用的信息:苹果<橘子<香蕉<樱桃。
为了解决上面出现的问题,聪明的你肯定能想到我们之前学过的向量。把上面提到的水果对应的标签,映射到向量中。如下:
{苹果,橘子,香蕉,樱桃}={(1,0,0,0), (0,1,0,0), (0,0,1,0), (0,0,0,1)}这完美解决了上面遇到的问题。于是你发明了独热编码。
当然,标签编码也不是一无是处,如果有这样的数据{婴儿,孩童,青年,中年人,老年人},标签编码的数值也有了意义。
三、网络架构
书上的原话:为了估计所有可能类别的条件概率,我们需要一个有多个输出的模型,每个类别对应一个输出。为了解决线性模型的分类问题,我们需要和输出一样多的仿射函数。
和线性回归、逻辑回归一样,Softmax回归首先进行线性计算。对于每个类别,它都有自己的一套权重和偏置。
-
对于一个输入样本 xx(比如一张图片的像素特征),我们为每个类别计算一个“得分”:
-
s猫=W猫⋅x+b猫
-
s狗=W狗⋅x+b狗
-
s鸟=W鸟⋅x+b鸟
-
这些得分(scores)反映了输入样本与每个类别的匹配程度。得分越高,说明模型认为样本属于该类的可能性越大。
四、softmax函数
这是最关键的一步。直接使用得分作为概率是不合适的,因为得分可能为负数、总和也不为1。Softmax函数的作用就是将这三个得分标准化为三个概率值,且这些概率之和为1。
Softmax公式:
对于类别 j的得分 sj,其概率 P(j) 为:
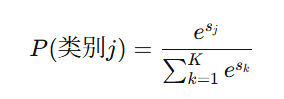
(其中 K 是总类别数,在我们的例子中是3)
这样,就完美避免了概率加起来不等于1,或者概率是负值的问题了。
五、小批量样本的矢量化
5.1. 从单个样本到小批量
在真正的训练中,我们几乎永远不会一个一个地处理样本(这被称为“随机梯度下降”),也不会一次性处理所有样本(这被称为“批量梯度下降”)。而是折中采用小批量梯度下降。
-
小批量:一次性处理一小部分(比如32, 64, 128个)样本。
-
优势:
-
计算效率:利用现代线性代数库和GPU的并行计算能力,一次性计算一个批量的效率远高于循环计算单个样本。
-
稳定性:比单个样本更稳定,比整个数据集更节省内存。
-
矢量化就是实现小批量处理的关键:不使用循环,而是使用矩阵运算来一次性处理整个批量的数据。
5. 2矢量化组件
这边书上用的是字母,我把它换成了具体数字,我觉得这样比较容易理解。这边比较抽象,多看几遍一定要知道这到底是怎么回事。
假设:
-
批量大小:
batch_size =64(一批次64个) -
特征数量:784,像 flattened 的 28x28 手写数字图像(输入的x)
-
类别数量:10(输出的y)
定义矢量化变量:
-
输入数据矩阵
X:-
形状:
(64, 784) -
每一行是一个样本的特征向量。
-
X = [x^(1); x^(2); ...; x^(64)]^T(这里^T表示转置,所以每一行是一个样本)
-
-
权重矩阵
W:-
形状:
(784, 10) -
每一列对应一个类别的权重向量。
W = [w_(1), w_(2), ..., w_(10)] -
w_(1)是识别“类别1”的权重向量。
-
-
偏置向量
b:-
形状:
(1, 10)或(10,) -
每个类别有一个偏置项。
b = [b_(1), b_(2), ..., b_(10)]
-
-
得分矩阵
S:-
形状:
(64, 10) -
每一行是一个样本对于所有K个类别的得分。
-
六、损失函数
6.1我们想要什么?
在多分类问题中(例如,识别图片是{猫,狗,鸟}):
模型(Softmax)的输出:一个概率分布。例如,对于某张图片,模型输出 [0.1, 0.7, 0.2],表示它认为图片是狗的概率最大。
我们的目标:调整模型参数,使得对于训练数据,模型为“正确类别”预测的概率尽可能接近 1。
6.2线性回归(MSE)的均方误差行吗?
均方误差的公式:MSE =
y:真实标签(独热编码,如 [0, 1, 0])。
:模型预测的概率(如
[0.1, 0.7, 0.2])。
均方误差的问题:
收敛慢,性能差:MSE 是一个非凸的损失函数(对于Softmax输出),存在很多局部最优点,使得优化过程非常困难,难以找到最佳参数。
梯度不直接:损失对模型参数的梯度在预测接近正确时变得非常小,导致学习速度缓慢。
6.3最佳方案:交叉熵损失(CE)
交叉熵损失源于信息论,它衡量的是两个概率分布之间的差异。在这里,就是衡量真实分布(y) 和预测分布(ŷ) 之间的差异。
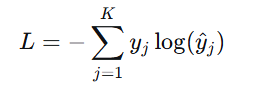
K:类别总数。
yj:真实标签中第 j 类的值(由于是独热编码,只有正确类别 c的 yc=1,其他都为 0)。
y^j:模型预测的该样本属于第 j 类的概率。
这个式子有些复杂,我们来把它简化一下:
因为y是独热编码,所以除了一项概率为1,其他的概率都为0。
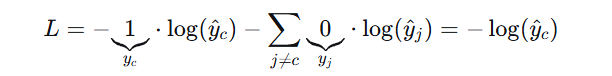
可以得到如下结果:
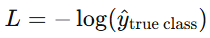
以下是一个例子,假设真实类别是“狗”(对应索引1,所以 y=[0,1,0]y=[0,1,0])。
| 模型预测 (ŷ) | 描述 | 交叉熵损失 L=−log(y^1)L=−log(y^1) | 直观感受 |
|---|---|---|---|
[0.0, 1.0, 0.0] | 完美预测 | -log(1.0) = 0 | 损失为0,非常满意。 |
[0.2, 0.7, 0.1] | 还不错 | -log(0.7) ≈ 0.36 | 损失较小,可以接受。 |
[0.4, 0.4, 0.2] | 犹豫不决 | -log(0.4) ≈ 0.92 | 损失变大,模型不够自信。 |
[0.8, 0.1, 0.1] | 完全错误 | -log(0.1) ≈ 2.30 | 损失非常大! 模型错得离谱。 |
6.4对比
假设一个三分类问题,真实标签是类别2(独热编码 [0, 1, 0])。
场景A:模型预测为 [0.1, 0.8, 0.1] (相当自信且正确)
场景B:模型预测为 [0.4, 0.4, 0.2] (犹豫不决,但正确类别的概率最高)
-
交叉熵损失的反应:
-
A:
L_ce = -log(0.8) ≈ 0.22 -
B:
L_ce = -log(0.4) ≈ 0.92 -
CE 明确地惩罚了不确定性。它告诉模型B:“你虽然猜对了,但不够自信,需要继续优化!”
-
-
均方误差的反应:
-
A:
L_mse = (0-0.1)² + (1-0.8)² + (0-0.1)² = 0.01 + 0.04 + 0.01 = 0.06 -
B:
L_mse = (0-0.4)² + (1-0.4)² + (0-0.2)² = 0.16 + 0.36 + 0.04 = 0.56 -
表面上MSE也惩罚了B,但问题在于它的梯度信号。
-
直观理解:MSE平等地对待所有误差。它希望所有输出(包括错误类别)都完全匹配0或1。而CE只“关心”正确类别的概率是否被推向1,它允许错误类别的概率只要相对小就行,不强制它们为0。这种差异在梯度上被急剧放大。
直观理解智能帮助我们简单理解二者之间的不同,其中涉及到更为深层次的数学原因,但那个对于现阶段的学习不重要,感兴趣的同学自行取搜索,我在这里就不展开赘述了。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 8
 0
- 0


 已为社区贡献20条内容

所有评论(0)