登录社区云,与社区用户共同成长
邀请您加入社区
2026年9月,OpenAI推出GPT-6Astra,强化计算机操作与智能体执行能力;Anthropic发布ClaudeFable5.1,聚焦长上下文处理与代码开发。前者擅长复杂任务自动化,后者在长文档分析与高频复用场景更具优势。两者API输入价同为$10/MToken,但缓存读取成本差异显著:ClaudeFable5.1为$0.25,远低于GPT-6Astra的$1。选型应基于任务类型:自动化执
你的API账单里有多少钱花在了杀鸡用牛刀?谷歌Gemini 3.8 Flash促销价约为Claude Opus 5的七分之一。本文给一套可复制的多模型路由降本方案:路由策略、成本追踪代码、以及促销价窗口下的工程应对。
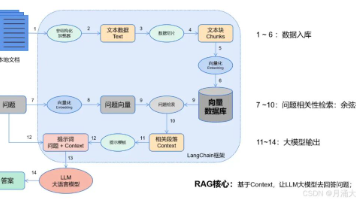
【干货收藏】RAG实战指南:从概念到落地,解决大模型应用中的核心难题
LoRA 是在模型内部权重矩阵旁插入低秩模块,Prefix/Prompt-Tuning则是通过在输入或注意力前缀插入可训练向量实现轻量微调。
在汽车前向仿真中会用到纵向驾驶员模型,根据当前的实际车速与目标车速控制踏板行程得到需求转矩。纵向驾驶员模型的作用除了更好地跟踪目标工况,还要反映驾驶员的实际操纵行为,从而使整车仿真模型能更好地反映实车的运行特征[1]。对驾驶员操纵行为的预测难于用简单的公式来描述,如果有大量的路谱数据,包括实车行驶过程的海拔、车速、发动机转速、油门开度等信息,可以用机器学习算法获得驾驶员的行为预测模型,根据历史路谱
具体到落地上,我们可以通过Copilot Labs,在Copilot Daily中以AI主播播报要闻、在Copilot Podcasts生成播客式讨论,Copilot Labs 提供可玩Demo(可以自定义内容、叙述风格等)。这标志着在多年依赖OpenAI模型之后,微软AI部门正式与OpenAI及整个行业正面竞争,也意味着微软在AI竞赛中,开始掌握更多主动权。我们必须具备内部能力,来打造世界最强的
本文比较了机器学习和深度学习两大人工智能技术的核心区别。机器学习通过算法从数据中学习规律,强调特征工程和通用算法,适用于结构化数据;深度学习是机器学习的子集,利用多层神经网络自动学习特征,擅长处理图像、语音等复杂数据。机器学习更简单可解释但依赖人工特征工程,深度学习性能更强但需要海量数据和算力。实际应用中应根据数据类型、任务复杂度等选择合适技术,未来两者将协同发展。
并指导模型通过优化算法(如梯度下降)不断调整参数以减少这种差异。是衡量模型预测结果与真实值之间差异的核心工具。(预测离散类别,如图像分类、文本情感分析)。(预测连续数值,如房价、温度)。
本文介绍了一个基于大数据技术的全球用水量数据可视化分析系统,该系统采用Python开发,结合Spark、Hadoop、Django、Vue和Echarts等技术框架,构建了前后端分离的架构。系统功能包括全球水资源消耗的时序演变分析、各国用水特征对比、水资源稀缺性归因分析等五大核心维度,通过时间序列分析、聚类算法等技术实现多维度水资源利用规律挖掘。文中展示了系统的大屏页面、分析页面等功能模块,并提供
本文介绍了使用迁移学习实现食物分类的代码实现。通过加载预训练的ResNet18模型,冻结底层参数并替换全连接层,构建了一个新的分类模型。然后定义了数据预处理流程、数据集类和数据加载器,并设置了训练和测试过程。代码展示了如何利用迁移学习技术,通过微调预训练模型来适应新任务,显著减少训练时间和计算资源需求。最后进行模型训练和测试,记录准确率和损失值来评估模型性能。
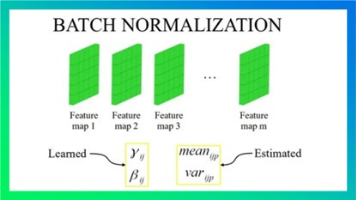
摘要: Batch Normalization(BN)通过归一化神经网络各层的输入数据,有效解决内部协变量偏移问题,显著提升训练效率和模型性能。其核心流程包括计算批次数据的均值与方差、归一化处理,并引入可学习参数γ和β恢复数据表达力。BN能加速收敛、增强泛化能力,且对学习率与初始化的宽容性简化了调参。然而,它对小批量数据敏感,可能影响效果。本文从数学角度解析了BN的归一化公式、推导过程及其对模型训
本文介绍了统计语言模型和神经语言模型的区别与联系。统计语言模型存在维度灾难和忽略词间联系的缺陷,而神经语言模型通过词嵌入技术将高维词表示压缩为低维向量(如300维),有效解决了这些问题。重点讲解了Word2Vec的两种模型:CBOW(通过上下文预测当前词)和Skip-Gram(通过当前词预测上下文),并提供了CBOW模型的PyTorch实现代码,包括数据预处理、模型构建、训练过程和词向量保存方法。
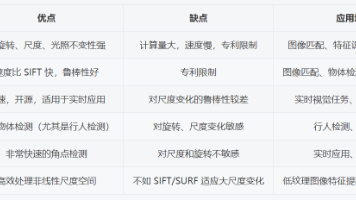
本文综述了机器学习兴起前主流的图像特征提取方法,包括SIFT、SURF、ORB等7种算法。SIFT具有尺度不变性但计算量大;SURF在保持性能的同时提升了速度;ORB结合FAST和BRIEF实现快速检测;HOG适用于静态物体检测。这些传统方法通过不同技术手段提取图像关键点和描述符,在旋转、尺度、光照变化等方面各具优势,为计算机视觉发展奠定了基础。随着技术进步,这些方法在实时性、精度等方面不断优化,
这篇教程介绍了使用PyTorch在CIFAR-10数据集上实现图像分类的完整流程。主要内容包括:环境配置、数据加载与预处理、CNN模型构建(包含3个卷积块和2个全连接层)、模型训练(交叉熵损失+Adam优化器)以及性能评估。教程详细展示了每个步骤的代码实现和输出解释,最终模型在测试集上能达到70-80%的准确率。文章还包含了数据可视化和错误分析部分,帮助理解模型性能。整个过程适合在Jupyter
我们同样使用 nn.Sequential类用来实现的顺序连接模型,首先放入一个展平层nn.Flatten(),将二维灰度图像降维,原来28*28的二维张量就变成长度为784的一维张量。接下来连接一个线性层,由于输入已经在上一层展平,所以线性层的输入长度为784,又由于我们规定结果分为10个类,所以线性层的输出长度为10。在模型初始化时,这里用了方法 model.apply() ,其会递归地遍历mo
本文介绍了深度学习模型训练中的主要硬件资源及其部署注意事项。除CPU和GPU外,还详细介绍了TPU、NPU、FPGA、ASIC等专用硬件的特性及适用场景。文章重点讲解了PyTorch框架下的多硬件支持实现,包括代码示例展示如何自动检测最佳可用硬件(TPU→GPU→MPS→CPU)并进行模型训练和跨设备部署。特别强调了不同硬件间的兼容性问题和性能考量,提供了模型保存加载、设备转换等关键技术的实现方法
PyTorch框架下,GPU训练的模型权重可以无缝部署到CPU设备上运行。这一过程的关键在于:1)模型权重本质是与硬件无关的数值集合,存储时自动剥离设备信息;2)PyTorch通过设备无关性设计,支持通过map_location参数灵活指定目标运行设备。具体实现分为三步:GPU训练保存权重→复用相同模型结构→CPU加载运行(需注意模型一致性和推理模式切换)。这种"GPU训练-CPU部署&
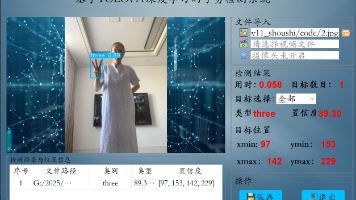
手势手语检测和识别3:基于深度学习YOLOv11神经网络实现手势手语检测和识别(含训练代码、数据集和GUI交互界面)
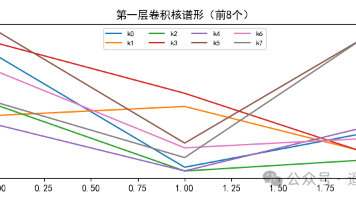
本文探讨高光谱分类中CNN模型的可解释性问题。通过类激活图(CAM)和通道注意力可视化方法,揭示了CNN内部工作机制。实验在KSC数据集上进行,采用1DCNN模型,并展示多种可视化技术:混淆矩阵分析错误分类模式、整图预测验证空间泛化能力、卷积核谱形可视化展示特征提取机制、通道重要性评估识别关键特征维度。这些方法使CNN从"黑箱"转变为可解释模型,帮助理解其决策依据。实验代码完整
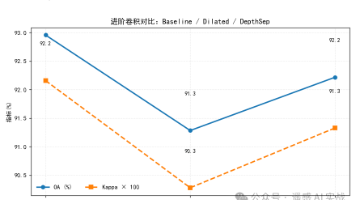
研究对比了空洞卷积和深度可分离卷积在1D高光谱分类中的效果。空洞卷积通过间隔采样扩大感受野,深度可分离卷积将标准卷积拆分为逐通道和点卷积,显著降低参数量。实验在KSC数据集上对比了三种1D-CNN模型:标准卷积、空洞卷积和深度可分离卷积。结果表明,空洞卷积在AA/Kappa指标上更稳定,深度可分离卷积计算效率更高,但基础卷积在特定情况下仍可能表现最佳。研究建议将这些结构作为可选基线进行对比,并提出
通过本实验的学习,学员将了解NLTK的历史背景、核心功能以及它在自然语言处理(NLP)领域的广泛应用。此外,学员还将通过实际操作,掌握如何使用NLTK进行文本预处理、词性标注和情感分析等基本任务。