深度学习-softmax回归
基本原理
既然softmax回归叫回归,那就与前面一章线性回归没有本质区别。只不过softmax回归通常是用来做分类的,它拟合出来的结果y不再是一个常数,而是一组概率值组成的一维张量。这就是softmax回归的核心部分,它需要保证输出y中每个分量是一个概率值并且总和为1。
综上所述,在softmax回归中,除了有线性回归中的基础线性变换 Xw+b=O 之外,还需要进行一次 Y=softmax(O) 变换使输出满足上述条件。
数据集
读取批量为256,数据集为Fashion-MNIST(类似于经典 MNIST 手写数字集的时尚产品图像数据库)。
import torch
from torch import nn
from d2l import torch as d2l

batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
其中load_data_fashion_mnist()函数返回Fashion-MNIST数据集的训练集迭代器和测试集迭代器,具体内容如下(d2l内置函数无需编写):
def load_data_fashion_mnist(batch_size, resize=None):  #@save
    """下载Fashion-MNIST数据集,然后将其加载到内存中"""
    trans = [transforms.ToTensor()]
    if resize:
        trans.insert(0, transforms.Resize(resize))
    trans = transforms.Compose(trans)
    mnist_train = torchvision.datasets.FashionMNIST(
        root="../data", train=True, transform=trans, download=True)
    mnist_test = torchvision.datasets.FashionMNIST(
        root="../data", train=False, transform=trans, download=True)
    return (data.DataLoader(mnist_train, batch_size, shuffle=True,
                            num_workers=get_dataloader_workers()),
            data.DataLoader(mnist_test, batch_size, shuffle=False,
                            num_workers=get_dataloader_workers()))
其中的核心函数 torchvision.datasets.FashionMNIST()各参数含义如下
| 参数 | 类型 | 含义 |
| root | str | 数据存放目录 |
| train | bool | 是否为训练集(True为训练集,False为测试集) |
| transform | list |
对读取图像的处理流,按照list中的参数顺序处理每个图像,如 transform=[transforms.Resize(resize), transforms.ToTensor()] 表示先将图像大小调整为另一种形状,再将图像数据从PIL类型变换成float格式并除以255使得所有像素的数值均在0~1之间 |
| download | bool | 如果root目录下没有数据,是否自动下载FashionMNIST数据集 |
定义模型与初始化参数
我们同样使用 nn.Sequential类用来实现的顺序连接模型,首先放入一个展平层nn.Flatten(),将二维灰度图像降维,原来28*28的二维张量就变成长度为784的一维张量。接下来连接一个线性层,由于输入已经在上一层展平,所以线性层的输入长度为784,又由于我们规定结果分为10个类,所以线性层的输出长度为10。
在模型初始化时,这里用了方法 model.apply() ,其会递归地遍历model中的每一个模块使其执行传入的方法。例如这里的model为顺序模型net,在执行 net.model(init_weights(m)) 后会对net中的所有节点调用 init_weight(m) ,最后再对父节点net调用 init_weight(m) ,其中m为遍历的对象本身。由于这里 init_weight 方法只对线性层Linear的参数weight进行了正态分布处理,所以和直接调用 nn.init.normal_(net[1].weight, std=0.01) 进行模型初始化效果是一样的。不过相比之下,使用model.apply() 批量初始化模型参数更加规范,写法更加优雅。
# PyTorch不会隐式地调整输入的形状。因此,
# 我们在线性层前定义了展平层(flatten),来调整网络输入的形状
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))

def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights);
小知识:jupyter notebook中代码以分号结尾可以抑制对象输出。
定义损失函数
loss = nn.CrossEntropyLoss(reduction='none')
这个函数实际上完成了两个步骤。首先通过softmax操作将输出规范化,具体公式如下所示,其中o是原始输出:
通过将输出的每一个分量求幂后再求其占比,就可以将所有值单调映射到(0,1)区间。
在此基础上求解处理后的输出与标签之间的交叉熵。这里简单讲一下我对交叉熵的理解。假设一个盒子里面有若干个红球和白球,从里面有放回地取10次球算一次事件,在某次事件中得到3次红球7次白球,那么这次事件取到红球和白球的概率分别为3/10和7/10。如果我们预测的概率值为1/2和1/2,那么通过把预测概率套用到该事件中求产生这次结果的概率,就可以作为预测概率好坏的一个评价。套用预测的分布后,取到3次红球7次黑球的概率可以通过简单的得到,显然我们预测的概率越接近3/10和7/10,这个值就越大,也说明我们的预测概率与实际概率越相近。通过对
取对数压缩后再添加符号,最后除以10得到
,显然该值越小则两个概率分布越接近,而其中的参与运算的都是两个概率分布的各个概率值,因此得到下式:
由于通常一次求得一个小批量的损失值,函数参数 reduction='none' 表示保留该组损失值,不进行取平均值等降维操作。
定义优化算法
与前面一章一样,使用梯度下降算法。
trainer = torch.optim.SGD(net.parameters(), lr=0.1)
训练
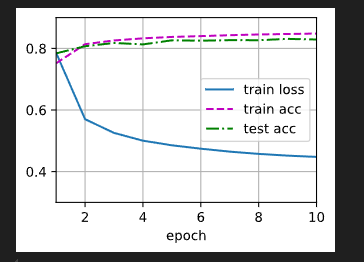
这里的训练直接调用了内置函数d2l.train_ch3()实现。只需将模型、数据、损失函数、训练轮次和训练器(优化算法)传入即可。
num_epochs = 10
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 29
 0
- 0


 已为社区贡献4条内容

所有评论(0)