登录社区云,与社区用户共同成长
邀请您加入社区
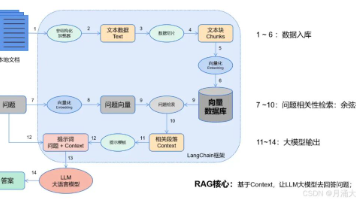
【干货收藏】RAG实战指南:从概念到落地,解决大模型应用中的核心难题
本文从原理和实践出发,详细介绍了如何从零实现Transformer模型。首先概述了Transformer的核心架构,包括编码器-解码器结构、自注意力机制、位置编码和残差连接等关键设计。然后逐步实现三个基础模块:位置编码采用正弦-余弦交替编码注入位置信息;缩放点积注意力通过查询-键-值计算实现全局依赖;多头注意力并行处理多个注意力子空间。代码实现基于PyTorch,深入解析了每个模块的数学原理和设计
模型融合通过Task Vector实现多技能整合:1)能力叠加采用向量相加,如融合代码生成与评价模型;2)能力消除通过向量相减,如去除脏话生成能力;3)类比迁移利用向量关系实现跨任务学习,如专业领域语音识别。融合效果取决于参数独立性——当不同任务共享关键参数时可能失败,理想情况需任务参数互不干扰。实验表明,该方法在保持原能力的同时扩展新功能,但需注意参数冲突问题。
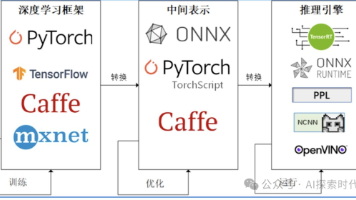
文章对比分析了7种主流企业级大模型部署框架(包括Transformers、ModelScope、vLLM、LMDeploy、Ollama、SGLang和DeepSpeed),详细阐述了各框架的技术架构、优缺点及适用场景。针对不同需求(个人开发、企业高并发、边缘计算、分布式部署)提供了选型建议,帮助开发者根据业务需求选择最合适的框架,最大化发挥大模型性能潜力。
output_dir="./llama2-finance-qlora", # 输出目录per_device_train_batch_size=4, # 单卡batch size(RTX 4090可设4-8)gradient_accumulation_steps=4, # 梯度累积,模拟大batch(4×4=16)learning_rate=2e-4, # LoRA学习率通常比全参数高10倍eval
大模型好书推荐丨BERT基础教程:Transformer大模型实战(附文档)
本文深入解析了Transformer中的位置编码机制,从原始正弦编码到最新旋转编码的演进历程。首先阐述了位置编码的必要性:由于Transformer的并行自注意力机制无法感知序列顺序,必须通过位置编码注入位置信息。重点分析了原始Transformer正弦编码的多尺度设计原理,包括频率变化、交替使用正弦余弦函数以及相对位置表达能力。通过代码实现展示了位置编码的生成方式,并可视化其变化规律。最后介绍了