企业级大模型部署方案:7大框架全解析与选型指南!大模型部署
简介
文章对比分析了7种主流企业级大模型部署框架(包括Transformers、ModelScope、vLLM、LMDeploy、Ollama、SGLang和DeepSpeed),详细阐述了各框架的技术架构、优缺点及适用场景。针对不同需求(个人开发、企业高并发、边缘计算、分布式部署)提供了选型建议,帮助开发者根据业务需求选择最合适的框架,最大化发挥大模型性能潜力。
“ 随着大语言模型(LLM)的广泛应用,如何高效部署和推理模型成为开发者关注的核心问题。”
随着大模型的成本越来越低,以及企业生产中对大模型的定制化需求,越来越多的企业选择在本地部署大模型;这样既满足了数据安全性需求,同样也增加了企业定制化的选择。
但由于大模型是资源大户,再加上并发性需求,因此选择一个好的高性能的大模型部署框架是很多企业都要面临的主要问题。
所以,今天就来介绍几种部署大模型的方式和框架。
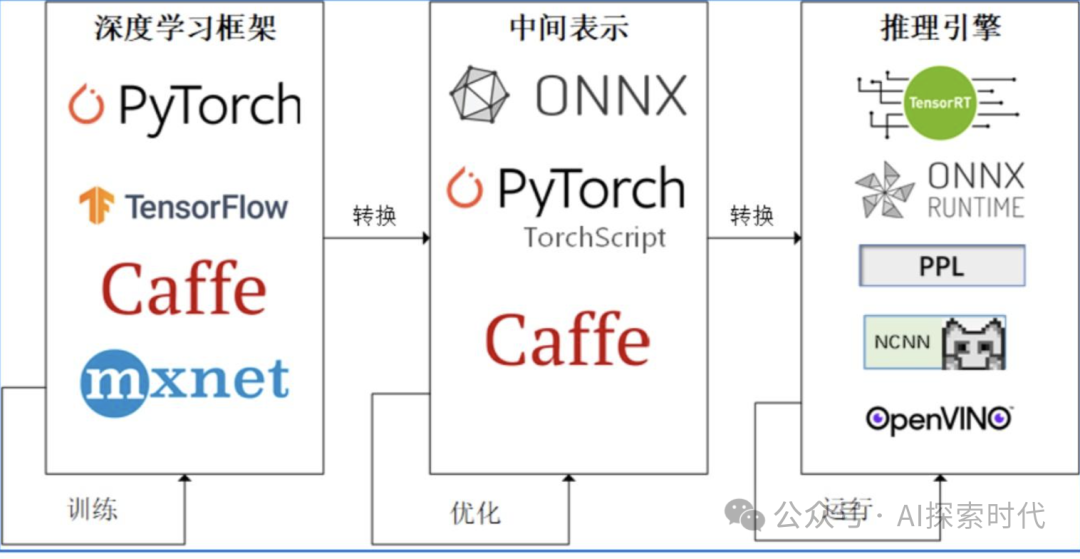
企业级大模型部署方案
很多人在学习大模型技术的过程中,可能都尝试过在本地下载和部署一些小模型;比如说使用ollama,gpt4all,LM Studio等。
但在企业级应用中和自己学习有着本质的差别,在企业场景中对大模型的性能,并发,容错,以及成本(包括技术成本和资金成本)都有着更高的要求;因此,本地部署大模型是一项专业的技术领域,而技术人员对不同平台和框架的选择,会直接影响到大模型的效果。
本文将对主流的大模型部署前端框架进行对比,包括Transformers、ModelScope、vLLM、LMDeploy、Ollama、SGLang和DeepSpeed
Transformers(Hugging Face)
官网: https://huggingface.co/docs/transformers
技术架构:基于PyTorch/TensorFlow/JAX,提供统一的模型加载、微调和推理接口,支持动态批处理和量化。
优点:模型生态丰富,灵活性强。
缺点:原生推理效率低,多GPU支持复杂。
适用场景:快速原型验证、小规模推理任务。
ModelScope(阿里云)
官网:https://modelscope.cn
技术架构:集成模型开发全生命周期工具链,支持多模态模型。
优点:一站式服务,性能优化。
缺点:生态封闭,灵活性受限。
适用场景:企业级云原生部署、多模态应用。
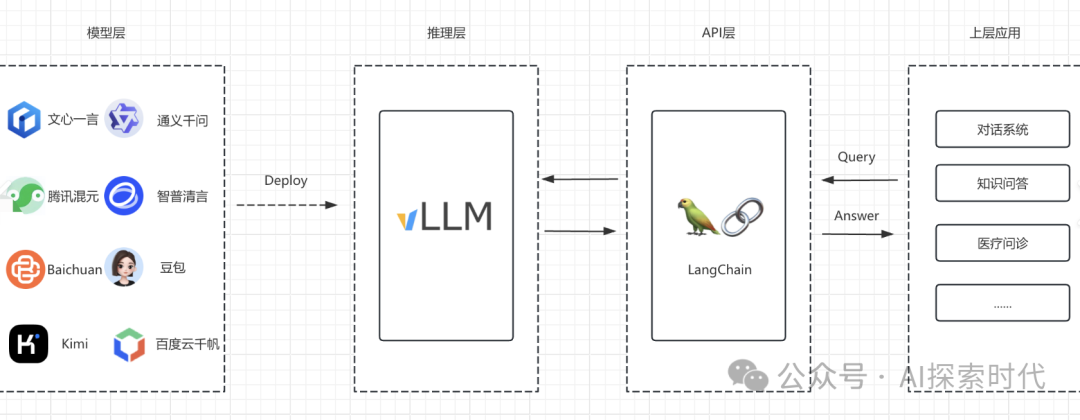
vLLM
官网: https://vllm.readthedocs.io
技术架构:PagedAttention和Continuous Batching,显存利用率高,支持高并发请求。
优点:吞吐量极高,兼容性广。
缺点:依赖Linux/CUDA,模型转换成本高。
适用场景:高并发在线服务。
LMDeploy(零一万物)
官网: https://github.com/InternLM/lmdeploy
技术架构:Turbomind引擎和W4A16量化,优化短文本多并发。
优点:低延迟,轻量化部署。
缺点:社区生态较小,长上下文支持弱。
适用场景:实时对话系统、边缘计算。
Ollama
官网: https://ollama.ai
技术架构:基于llama.cpp的轻量级封装,支持CPU/GPU混合推理。
优点:极简部署,跨平台支持。
缺点:性能有限,功能单一。
适用场景:个人开发者测试、教育场景。
SGLang
官网: https://github.com/sgl-project/sglang
技术架构:RadixAttention和结构化输出优化,支持JSON/XML格式生成加速。
优点:企业级性能,多模态支持。
缺点:学习成本高,硬件要求高。
适用场景:企业级高并发服务、需结构化输出的应用。
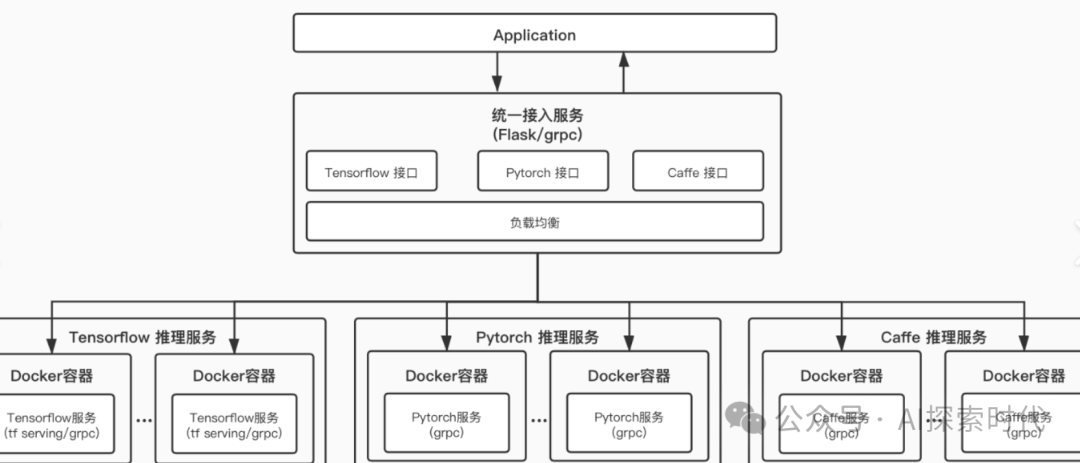
DeepSpeed
官网:https://www.deepspeed.ai/inference
技术架构:ZeRO-Inference和Tensor Parallelism,支持超大规模模型推理。
优点:分布式优化,无缝衔接训练。
缺点:配置复杂,延迟较高。
适用场景:大规模分布式推理、与训练流程集成的场景。
总结与选型建议
-
个人开发者:优先使用Ollama(零配置)或Transformers(灵活)。
-
企业高并发场景:选择vLLM(吞吐量)或SGLang(结构化输出)。
-
边缘计算/实时交互:LMDeploy的低延迟特性最佳。
-
分布式需求:DeepSpeed和ModelScope支持多节点扩展。
-
企业高并发场景:选择vLLM(吞吐量)或SGLang(结构化输出)。
-
边缘计算/实时交互:LMDeploy的低延迟特性最佳。
-
分布式需求:DeepSpeed和ModelScope支持多节点扩展。
通过合理选择框架,开发者可最大化发挥大模型的性能潜力。建议结合业务需求参考官方文档调整参数,并监控GPU显存与吞吐量指标。
AI大模型学习和面试资源
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习和面试资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓


码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 5
 0
- 0


 已为社区贡献94条内容

所有评论(0)