Transformer位置编码深度解析:从原理到前沿各大模型应用
Transformer位置编码深度解析:从原理到前沿各大模型应用
在深度学习领域,Transformer架构凭借其强大的并行计算能力和出色的建模效果,已经成为自然语言处理和计算机视觉等多个领域的主流选择。然而,这种革命性的架构设计也带来了一个根本性的挑战:如何让模型理解序列中每个元素的位置信息?本文将带你深入探讨Transformer位置编码的演进历程,从原始的正弦编码到最新的旋转位置编码,全面解析各种位置编码方法的原理、实现和应用。
位置编码的必要性
要理解位置编码的重要性,我们需要先了解Transformer的核心机制。与传统的RNN按时间步顺序处理序列不同,Transformer采用自注意力机制,允许序列中的所有位置同时进行交互。这种并行化设计虽然大幅提升了计算效率,但也让模型失去了对位置的感知能力。
考虑这两个句子:
- “我吃了西瓜”
- “西瓜吃了我”
如果没有位置信息,仅从词汇本身来看,这两个句子包含的词完全相同。但显然,词序的不同导致了句子含义的天壤之别。这就是为什么Transformer需要额外的位置编码来告诉模型每个词在序列中的位置。
原始Transformer的正弦位置编码
核心公式
在2017年的开创性论文《Attention is All You Need》中,Vaswani等人提出了一种基于正弦和余弦函数的位置编码方案:
对于位置pos和维度i:
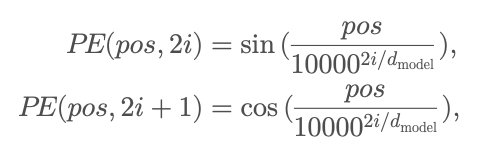
其中:
- pos表示token在序列中的位置(从0开始)
- i表示编码向量的维度索引
- d_model表示模型的隐藏层维度
设计原理深度剖析
这个看似简单的公式背后蕴含着深刻的设计思想:
1. 频率的多尺度设计
公式中的10000^(2i/d_model)项控制着正弦函数的频率。当i较小时,这个值接近1,对应的正弦波频率较高,周期较短;当i较大时,这个值变得很大,对应的正弦波频率较低,周期较长。
这种设计使得位置编码在不同维度上具有不同的变化速率:
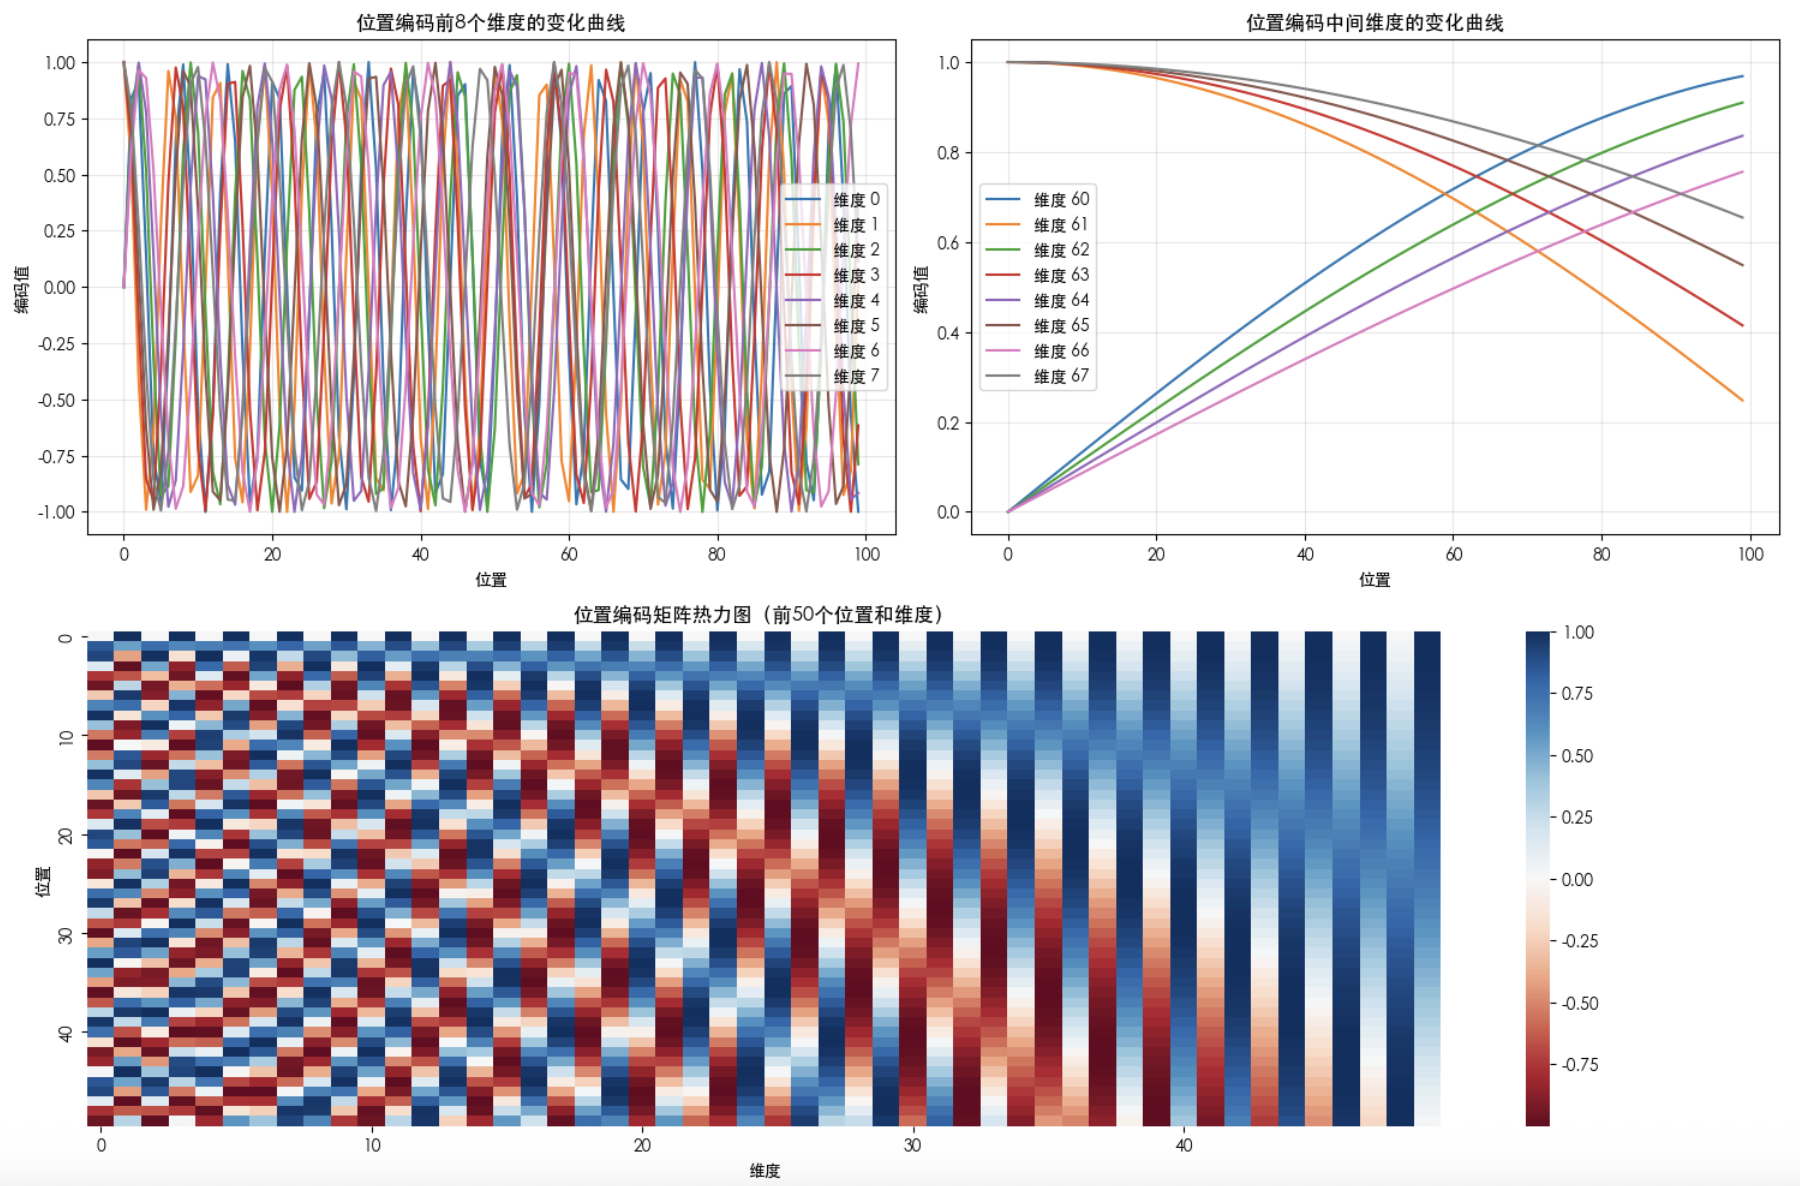
- 低维度(小i):快速变化,能够捕捉相邻位置之间的细微差异
- 高维度(大i):缓慢变化,能够编码长距离的位置关系
2. 正弦与余弦的交替使用
对于每个位置,偶数维度使用sin函数,奇数维度使用cos函数。这种设计的优点:
- 提供了位置的唯一表示:每个位置都有一个独特的编码向量
- 保持了编码的连续性:相邻位置的编码向量是平滑变化的
- 增加了表示的丰富性:sin和cos的组合提供了更多的变化模式
3. 相对位置的隐式编码
虽然这种编码方式看起来只编码了绝对位置,但实际上它也能够表达相对位置关系。这得益于三角函数的线性变换性质:
PE(pos + k) 可以表示为 PE(pos) 和 PE(k) 的线性组合
这意味着模型可以通过学习适当的变换矩阵来推断两个位置之间的相对距离。
代码实现与可视化
让我们通过代码来深入理解位置编码的工作原理:
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

def get_positional_encoding(seq_len, d_model):
    """
    生成位置编码矩阵

    参数:
    seq_len: 序列长度
    d_model: 模型维度

    返回:
    位置编码矩阵,shape为(seq_len, d_model)
    """
    # 创建位置索引矩阵,shape为(seq_len, 1)
    pos = np.arange(seq_len)[:, np.newaxis]

    # 创建维度索引矩阵,shape为(1, d_model)
    i = np.arange(d_model)[np.newaxis, :]

    # 计算角度,使用公式中的分母部分
    # 注意这里使用(i // 2)是因为相邻的两个维度共享相同的频率
    angle_rates = 1 / np.power(10000, (2 * (i // 2)) / np.float32(d_model))

    # 计算pos * angle_rates,得到每个位置在每个维度上的角度
    angle_rads = pos * angle_rates

    # 初始化位置编码矩阵
    pos_encoding = np.zeros_like(angle_rads)

    # 偶数维度使用sin函数
    pos_encoding[:, 0::2] = np.sin(angle_rads[:, 0::2])

    # 奇数维度使用cos函数
    pos_encoding[:, 1::2] = np.cos(angle_rads[:, 1::2])

    return pos_encoding

# 生成并可视化位置编码
seq_len = 100
d_model = 128
pe = get_positional_encoding(seq_len, d_model)

# 可视化不同维度的位置编码曲线
plt.figure(figsize=(15, 10))

# 展示前8个维度的曲线
plt.subplot(2, 2, 1)
for i in range(8):
    plt.plot(pe[:, i], label=f'维度 {i}')
plt.legend()
plt.title('位置编码前8个维度的变化曲线')
plt.xlabel('位置')
plt.ylabel('编码值')
plt.grid(True, alpha=0.3)

# 展示中间8个维度的曲线
plt.subplot(2, 2, 2)
for i in range(60, 68):
    plt.plot(pe[:, i], label=f'维度 {i}')
plt.legend()
plt.title('位置编码中间维度的变化曲线')
plt.xlabel('位置')
plt.ylabel('编码值')
plt.grid(True, alpha=0.3)

# 使用热力图展示完整的位置编码矩阵
plt.subplot(2, 1, 2)
sns.heatmap(pe[:50, :50], cmap='RdBu', center=0,
            xticklabels=10, yticklabels=10)
plt.title('位置编码矩阵热力图(前50个位置和维度)')
plt.xlabel('维度')
plt.ylabel('位置')

plt.tight_layout()
plt.show()

# 分析位置编码的性质
def analyze_positional_encoding(pe):
    """分析位置编码的性质"""
    print("位置编码分析:")
    print(f"编码矩阵形状: {pe.shape}")
    print(f"编码值范围: [{pe.min():.3f}, {pe.max():.3f}]")

    # 计算相邻位置的相似度
    similarities = []
    for i in range(len(pe) - 1):
        # 使用余弦相似度
        sim = np.dot(pe[i], pe[i+1]) / (np.linalg.norm(pe[i]) * np.linalg.norm(pe[i+1]))
        similarities.append(sim)

    print(f"相邻位置平均相似度: {np.mean(similarities):.3f}")

    # 计算不同距离的位置相似度
    distances = [1, 5, 10, 20, 50]
    for d in distances:
        if d < len(pe):
            sim = np.dot(pe[0], pe[d]) / (np.linalg.norm(pe[0]) * np.linalg.norm(pe[d]))
            print(f"位置0和位置{d}的相似度: {sim:.3f}")

analyze_positional_encoding(pe)
输出内容:
位置编码分析:
编码矩阵形状: (100, 128)
编码值范围: [-1.000, 1.000]
相邻位置平均相似度: 0.970
位置0和位置1的相似度: 0.970
位置0和位置5的相似度: 0.737
位置0和位置10的相似度: 0.669
位置0和位置20的相似度: 0.608
位置0和位置50的相似度: 0.546
可以看出:
• 随着距离增加,相似度逐渐降低(但不会掉到 0),
• 这说明编码能在 保持一定全局区分度 的同时,保留了 位置之间的相对连续性。
位置编码的使用方式
在Transformer中,位置编码的使用非常直接。
代码说明
这段代码展示了如何在 Transformer 模型中为词嵌入添加 位置编码 (Positional Encoding),保证模型能够利用序列的位置信息。
1. add_positional_encoding 函数
- 输入:词嵌入张量 embeddings,形状为 (batch_size, seq_len, d_model)。
- 逻辑:
- 调用 get_positional_encoding 生成最大长度 max_seq_len 的位置编码矩阵。
- 按输入的 seq_len 截取相应长度的编码。
- 扩展到 (batch_size, seq_len, d_model) 形状。
- 与输入的词嵌入逐元素相加。
- 输出:带有位置信息的嵌入张量。
2. **TransformerEmbedding类 **
这是一个 PyTorch 模块,模拟 Transformer 输入嵌入层的实现。
- 组成:
- nn.Embedding:将 token ID 转换为向量表示。
- 预计算的 pe:存储了最大序列长度的正弦/余弦位置编码,并通过 register_buffer 注册到模型中(不会被更新,但会随模型保存/加载)。
- forward 流程:
- 输入张量 x,形状 (batch_size, seq_len),包含 token 的索引。
- 查表得到 token 嵌入,并乘以 √d_model(缩放因子,和原始 Transformer 一致)。
- 截取对应长度的 pe 并加到 token 嵌入上。
- 输出形状为 (batch_size, seq_len, d_model) 的张量。
3. 使用示例
- 定义词表大小 vocab_size=10000,模型维度 d_model=512。
- 构建 TransformerEmbedding 模块。
- 随机生成输入 ID (2, 20),即 batch size=2,序列长度=20。
- 得到输出 (2, 20, 512),即每个 token 都有融合了 词义信息 + 位置信息 的向量。
总结
这段代码完整演示了 位置编码在 Transformer 中的作用:
- Token Embedding 提供 语义信息;
- Positional Encoding 提供 顺序信息;
- 两者相加作为 Transformer 的输入,使模型既能理解词语的含义,又能区分不同的顺序。
def add_positional_encoding(embeddings, max_seq_len=5000):
    """
    为词嵌入添加位置编码

    参数:
    embeddings: 词嵌入张量,shape为(batch_size, seq_len, d_model)
    max_seq_len: 最大序列长度

    返回:
    添加位置编码后的张量
    """
    batch_size, seq_len, d_model = embeddings.shape

    # 生成位置编码
    pe = get_positional_encoding(max_seq_len, d_model)

    # 只取需要的长度
    pe = pe[:seq_len, :]

    # 扩展到batch维度
    pe = np.expand_dims(pe, 0)
    pe = np.repeat(pe, batch_size, axis=0)

    # 直接相加
    output = embeddings + pe

    return output

# 演示如何在实际中使用位置编码
import torch
import torch.nn as nn

class TransformerEmbedding(nn.Module):
    def __init__(self, vocab_size, d_model, max_len=5000):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, d_model)
        self.d_model = d_model

        # 预计算位置编码
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len).unsqueeze(1).float()

        div_term = torch.exp(torch.arange(0, d_model, 2).float() *
                            -(np.log(10000.0) / d_model))

        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)

        pe = pe.unsqueeze(0)  # 添加batch维度
        self.register_buffer('pe', pe)

    def forward(self, x):
        # x shape: (batch_size, seq_len)
        seq_len = x.size(1)

        # 获取词嵌入
        token_embeddings = self.token_embedding(x) * np.sqrt(self.d_model)

        # 添加位置编码
        embeddings = token_embeddings + self.pe[:, :seq_len]

        return embeddings

# 使用示例
vocab_size = 10000
d_model = 512
embedding_layer = TransformerEmbedding(vocab_size, d_model)

# 模拟输入
batch_size = 2
seq_len = 20
input_ids = torch.randint(0, vocab_size, (batch_size, seq_len))

# 获取带位置编码的嵌入
embeddings = embedding_layer(input_ids)
print(f"输出形状: {embeddings.shape}")  # (batch_size, seq_len, d_model)
输出内容:
输出形状: torch.Size([2, 20, 512])
学习式位置编码(Learned Positional Encoding)
原理与实现
原始Transformer论文提到他们也尝试了学习式编码。 像BERT和GPT这样的模型通常使用学习式位置编码。
学习式位置编码将每个位置的编码向量作为可学习的参数:
class LearnedPositionalEncoding(nn.Module):
    def __init__(self, max_len, d_model):
        """
        初始化学习式位置编码

        参数:
        max_len: 最大序列长度
        d_model: 模型维度
        """
        super().__init__()
        # 创建一个可学习的位置嵌入矩阵
        self.positional_embeddings = nn.Embedding(max_len, d_model)

        # 初始化权重
        nn.init.normal_(self.positional_embeddings.weight, mean=0, std=0.02)

    def forward(self, x):
        """
        前向传播

        参数:
        x: 输入张量,shape为(batch_size, seq_len, d_model)

        返回:
        添加位置编码后的张量
        """
        seq_len = x.size(1)

        # 生成位置索引
        positions = torch.arange(seq_len, device=x.device).unsqueeze(0)

        # 获取位置编码
        positional_encoding = self.positional_embeddings(positions)

        # 添加到输入
        return x + positional_encoding

# 对比学习式和固定式位置编码
def compare_positional_encodings():
    seq_len = 50
    d_model = 128
    batch_size = 4

    # 创建输入
    x = torch.randn(batch_size, seq_len, d_model)

    # 学习式位置编码
    learned_pe = LearnedPositionalEncoding(100, d_model)
    output_learned = learned_pe(x)

    # 固定式位置编码
    fixed_pe = get_positional_encoding(seq_len, d_model)
    fixed_pe_tensor = torch.FloatTensor(fixed_pe).unsqueeze(0)
    output_fixed = x + fixed_pe_tensor

    print(f"学习式输出形状: {output_learned.shape}")
    print(f"固定式输出形状: {output_fixed.shape}")

    # 分析两种编码的特性
    with torch.no_grad():
        learned_encodings = learned_pe.positional_embeddings.weight[:seq_len].numpy()

    plt.figure(figsize=(15, 5))

    plt.subplot(1, 2, 1)
    plt.imshow(learned_encodings[:20, :20], cmap='RdBu', aspect='auto')
    plt.title('学习式位置编码(前20个位置和维度)')
    plt.xlabel('维度')
    plt.ylabel('位置')
    plt.colorbar()

    plt.subplot(1, 2, 2)
    plt.imshow(fixed_pe[:20, :20], cmap='RdBu', aspect='auto')
    plt.title('固定式位置编码(前20个位置和维度)')
    plt.xlabel('维度')
    plt.ylabel('位置')
    plt.colorbar()

    plt.tight_layout()
    plt.show()

compare_positional_encodings()
输出内容:
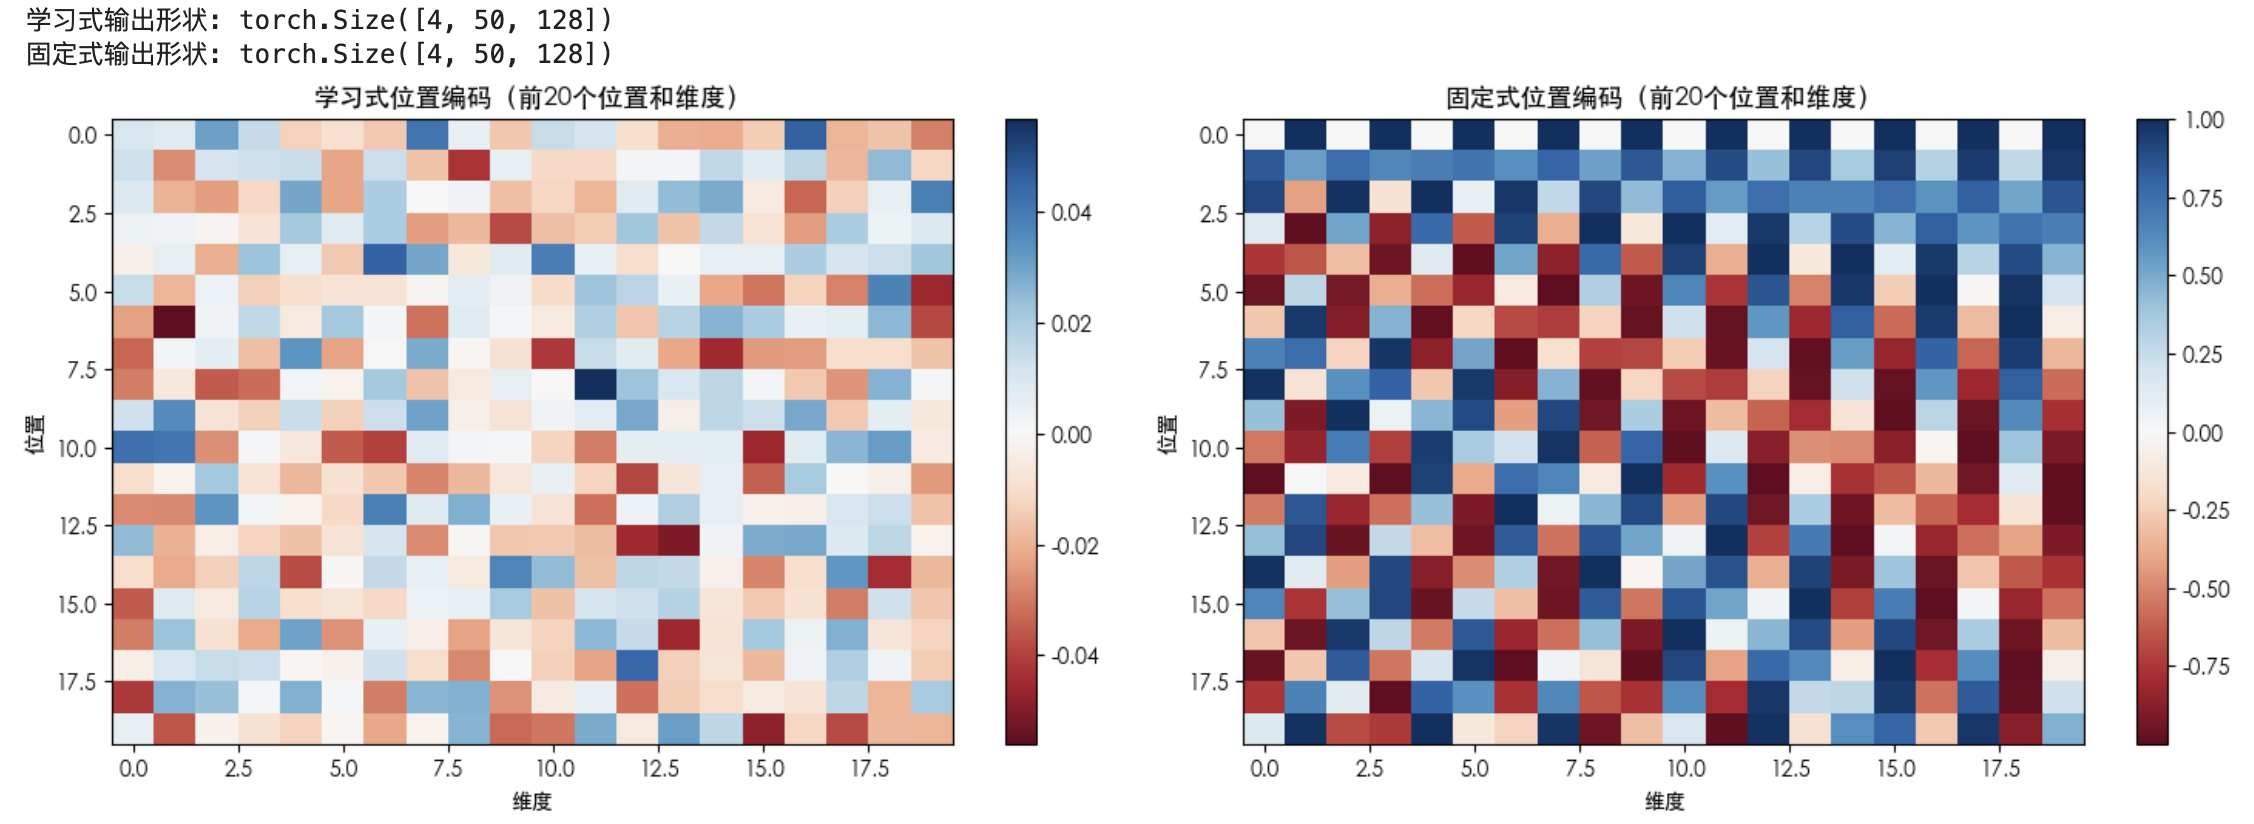
优缺点对比
| 特性 | 固定式(正弦)编码 | 学习式编码 |
|---|---|---|
| 参数量 | 无额外参数 | 增加max_len × d_model个参数 |
| 泛化能力 | 可以外推到训练时未见过的长度 | 只能处理训练时的最大长度 |
| 灵活性 | 固定的数学函数 | 可以根据任务自适应 |
| 计算效率 | 可以预计算,非常高效 | 需要查表,略慢 |
| 表达能力 | 理论上足够 | 可能更强,但需要足够的数据 |
旋转位置编码(RoPE):现代大模型的选择
核心原理
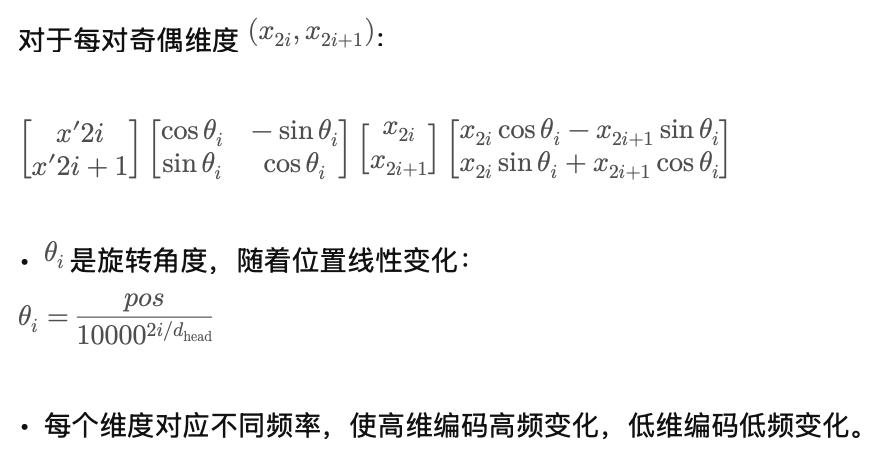
旋转位置编码(RoPE)是一种新型的位置编码方式,它统一了绝对和相对位置编码的方法。 RoPE的核心思想是通过旋转操作来编码位置信息。
- RoPE 的关键是利用二维坐标旋转的公式:
-
在代码中,θ\thetaθ 随着 位置 pospospos 和 频率 ω\omegaω 变化,即:
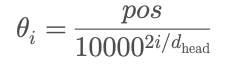
其中 ω\omegaω 来自对数尺度的频率表(和经典正余弦编码一致)。
这样,Q、K 向量在进入注意力计算前先被位置相关的旋转变换,结果是:
- 不同位置的 Q、K 在点积时,天然包含相对位置信息。
- 模型不需要显式存储位置向量,RoPE 本身保证了「位移不变性」:注意力结果取决于相对位置,而不是绝对位置。
代码实现要点
- 频率缓存
inv_freq = 1 / (base^(i/d_model))- 预计算 cos、sin 值存到 buffer(避免重复计算)。
- 旋转变换
- 将输入向量拆分成偶数维和奇数维两组 (
x1, x2)。 - 按照二维旋转公式和 cos、sin 表进行旋转。
- 最后拼接还原为原始维度。
- 将输入向量拆分成偶数维和奇数维两组 (
- 在注意力中应用
- 对 Q、K 向量应用 RoPE,V 不需要。
- 点积注意力计算自然体现相对位置信息。
可视化部分
- 正弦分量随位置的变化:展示不同频率下的波动模式。
- 旋转角度随维度的变化:说明高维部分旋转得更快(高频),低维部分旋转得更慢(低频)。
- 相对位置的相似度:展示 RoPE 如何让注意力对「相对距离」敏感,而不是依赖绝对位置。
这段实现说明了:
- RoPE 把位置编码融入注意力机制,而不是与输入直接相加。
- 它通过「复平面旋转」的方式,实现了高效的 相对位置建模。
- 相比传统正余弦编码,RoPE 更自然地支持长序列扩展,并能保持良好的相对位置表达能力。
代码解释
RoPE的核心在于将位置编码看作复数域上的旋转操作。对于位置m的查询向量q和位置n的键向量k,RoPE通过以下方式编码位置信息:
import torch
import torch.nn as nn

class RotaryPositionalEmbedding(nn.Module):
    def __init__(self, d_model, max_seq_len=5000, base=10000):
        """
        旋转位置编码实现

        参数:
        d_model: 模型维度(必须是偶数)
        max_seq_len: 最大序列长度
        base: 基础频率
        """
        super().__init__()
        assert d_model % 2 == 0, "模型维度必须是偶数"

        self.d_model = d_model
        self.base = base
        self.max_seq_len = max_seq_len

        # 预计算频率
        inv_freq = 1.0 / (base ** (torch.arange(0, d_model, 2).float() / d_model))
        self.register_buffer('inv_freq', inv_freq)

        # 预计算cos和sin值
        self._set_cos_sin_cache(max_seq_len)

    def _set_cos_sin_cache(self, seq_len):
        """预计算cos和sin值以提高效率"""
        position = torch.arange(seq_len).float()
        freqs = torch.outer(position, self.inv_freq)

        # 创建复数形式的旋转矩阵
        emb = torch.cat((freqs, freqs), dim=-1)
        self.register_buffer('cos_cached', emb.cos())
        self.register_buffer('sin_cached', emb.sin())

    def apply_rotary_pos_emb(self, x, seq_len):
        """
        应用旋转位置编码

        参数:
        x: 输入张量,shape为(batch_size, seq_len, n_heads, head_dim)
        seq_len: 当前序列长度

        返回:
        应用RoPE后的张量
        """
        # 如果序列长度超过缓存,重新计算
        if seq_len > self.max_seq_len:
            self._set_cos_sin_cache(seq_len)

        # 将输入分成两半
        x1, x2 = x[..., ::2], x[..., 1::2]

        # 获取对应长度的cos和sin值
        cos = self.cos_cached[:seq_len].unsqueeze(0).unsqueeze(2)
        sin = self.sin_cached[:seq_len].unsqueeze(0).unsqueeze(2)

        # 应用旋转变换
        # 这相当于在复数平面上的旋转操作
        rotated_x1 = x1 * cos[:, :, :, :x1.shape[-1]] - x2 * sin[:, :, :, :x2.shape[-1]]
        rotated_x2 = x1 * sin[:, :, :, :x1.shape[-1]] + x2 * cos[:, :, :, :x2.shape[-1]]

        # 重新组合
        rotated_x = torch.stack((rotated_x1, rotated_x2), dim=-1)
        rotated_x = rotated_x.flatten(-2)

        return rotated_x

# 在注意力机制中使用RoPE
class RoPEAttention(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        self.d_model = d_model
        self.n_heads = n_heads
        self.head_dim = d_model // n_heads

        self.query_proj = nn.Linear(d_model, d_model)
        self.key_proj = nn.Linear(d_model, d_model)
        self.value_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

        # 初始化RoPE
        self.rope = RotaryPositionalEmbedding(self.head_dim)

    def forward(self, x, mask=None):
        batch_size, seq_len, _ = x.shape

        # 计算Q、K、V
        queries = self.query_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)
        keys = self.key_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)
        values = self.value_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)

        # 应用RoPE到Q和K
        queries = self.rope.apply_rotary_pos_emb(queries, seq_len)
        keys = self.rope.apply_rotary_pos_emb(keys, seq_len)

        # 转置以适应注意力计算
        queries = queries.transpose(1, 2)  # (batch, n_heads, seq_len, head_dim)
        keys = keys.transpose(1, 2)
        values = values.transpose(1, 2)

        # 计算注意力分数
        scores = torch.matmul(queries, keys.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 应用softmax
        attn_weights = torch.softmax(scores, dim=-1)

        # 应用注意力权重
        attn_output = torch.matmul(attn_weights, values)

        # 重新组合heads
        attn_output = attn_output.transpose(1, 2).contiguous()
        attn_output = attn_output.view(batch_size, seq_len, self.d_model)

        # 输出投影
        output = self.out_proj(attn_output)

        return output

# 测试RoPE
def test_rope():
    d_model = 256
    n_heads = 8
    seq_len = 100
    batch_size = 2

    # 创建注意力层
    rope_attention = RoPEAttention(d_model, n_heads)

    # 创建输入
    x = torch.randn(batch_size, seq_len, d_model)

    # 前向传播
    output = rope_attention(x)

    print(f"输入形状: {x.shape}")
    print(f"输出形状: {output.shape}")

    # 可视化RoPE的效果
    rope = RotaryPositionalEmbedding(64)  # 使用较小的维度便于可视化

    # 创建位置向量
    positions = torch.arange(20).float()
    freqs = torch.outer(positions, rope.inv_freq)

    plt.figure(figsize=(15, 5))

    # 绘制不同频率的旋转
    plt.subplot(1, 3, 1)
    for i in range(4):
        plt.plot(positions, torch.sin(freqs[:, i]), label=f'频率 {i}')
    plt.legend()
    plt.title('RoPE中不同频率的正弦分量')
    plt.xlabel('位置')
    plt.ylabel('值')

    # 绘制旋转角度
    plt.subplot(1, 3, 2)
    for i in range(4):
        plt.plot(positions, freqs[:, i], label=f'维度 {i}')
    plt.legend()
    plt.title('不同维度的旋转角度')
    plt.xlabel('位置')
    plt.ylabel('角度')

    # 绘制相对位置的影响
    plt.subplot(1, 3, 3)
    base_pos = 10
    relative_positions = torch.arange(-10, 11)

    # 计算相对位置的余弦相似度
    similarities = []
    for rel_pos in relative_positions:
        pos1 = base_pos
        pos2 = base_pos + rel_pos
        if pos2 >= 0:
            # 简化的相似度计算
            angle_diff = (pos2 - pos1) * rope.inv_freq[0]
            sim = torch.cos(angle_diff)
            similarities.append(sim.item())
        else:
            similarities.append(0)

    plt.plot(relative_positions, similarities)
    plt.title('相对位置对注意力的影响')
    plt.xlabel('相对位置')
    plt.ylabel('相似度')
    plt.grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()

test_rope()
输出内容:
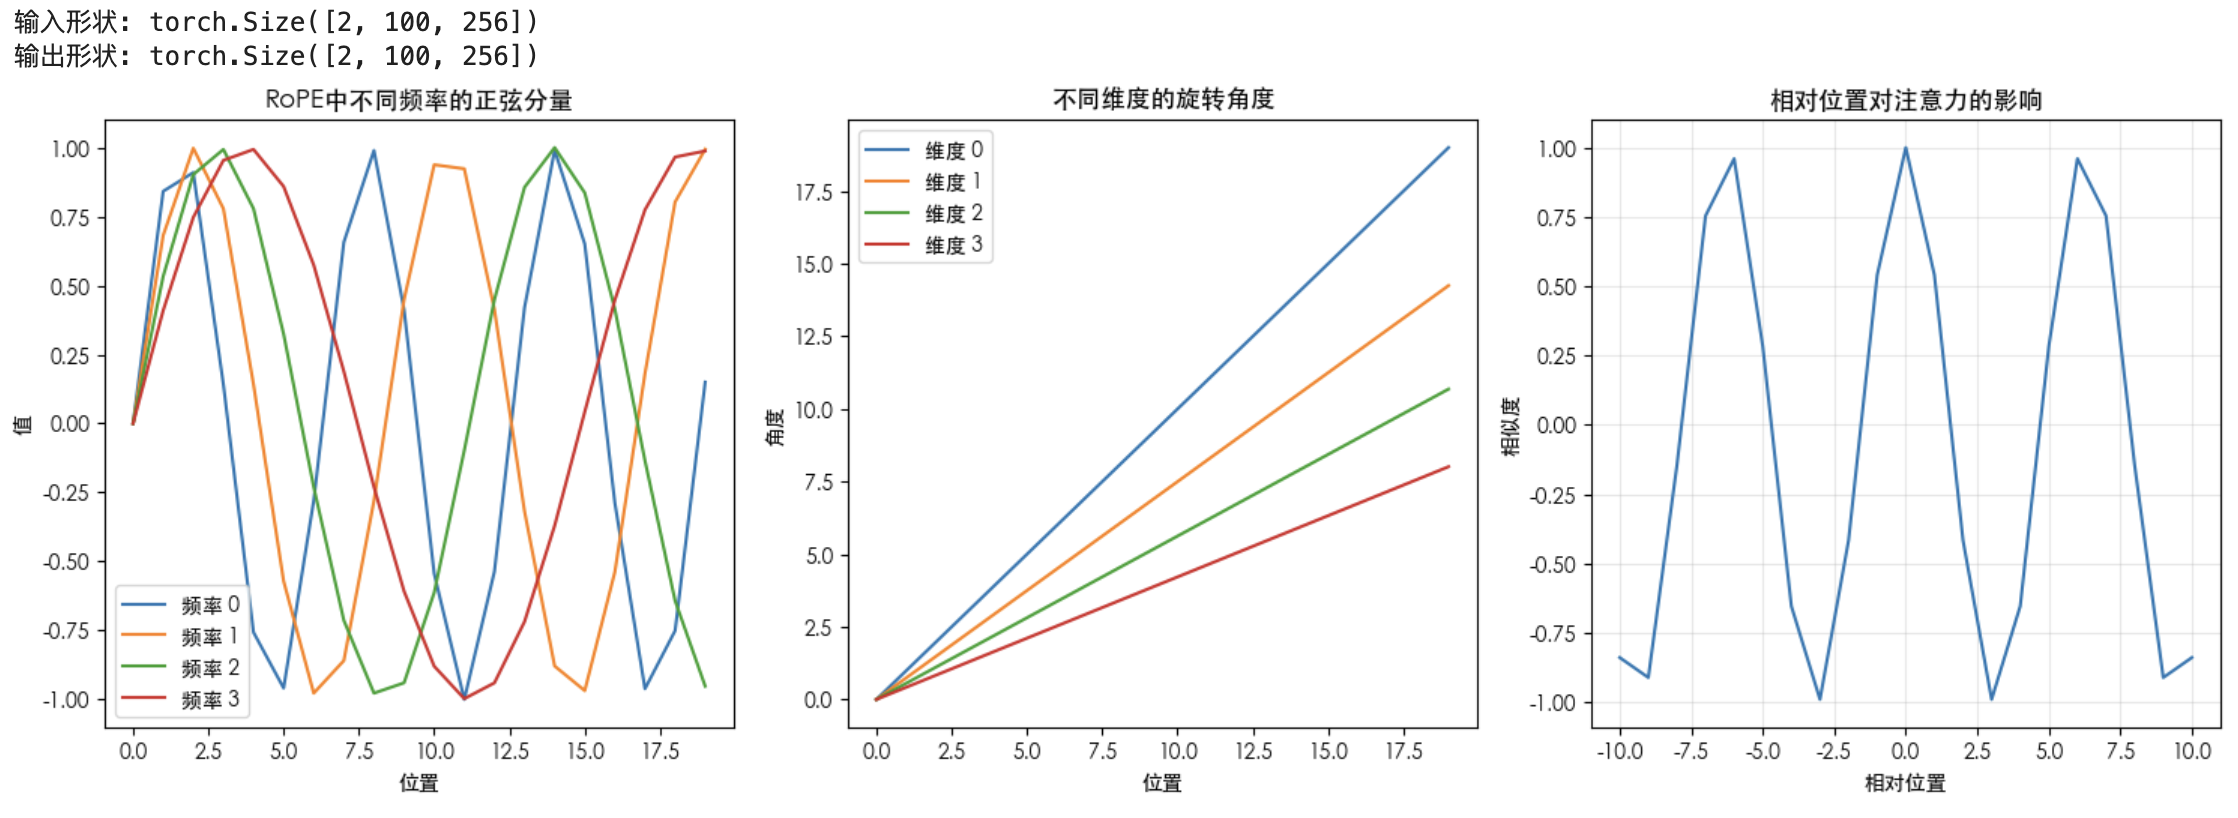
RoPE的优势
RoPE在多个方面表现出色:1)它在收敛速度上比学习式绝对位置编码快约30%,比T5的相对位置编码快10-20%;2)可以扩展到十亿参数级别的模型。
-
统一绝对和相对位置编码:RoPE巧妙地将绝对位置信息编码到向量中,但在计算注意力时自然地产生相对位置的效果。
-
外推能力强:当RoPE被广泛应用后,人们发现它可以通过旋转矩阵外推到超过预训练长度的位置编码,这提高了模型的泛化能力和鲁棒性,这是之前的位置编码方法无法做到的。
-
计算效率高:RoPE只需要对查询和键进行简单的旋转操作,不需要额外的注意力偏置计算。
ALiBi:线性偏置注意力
原理介绍
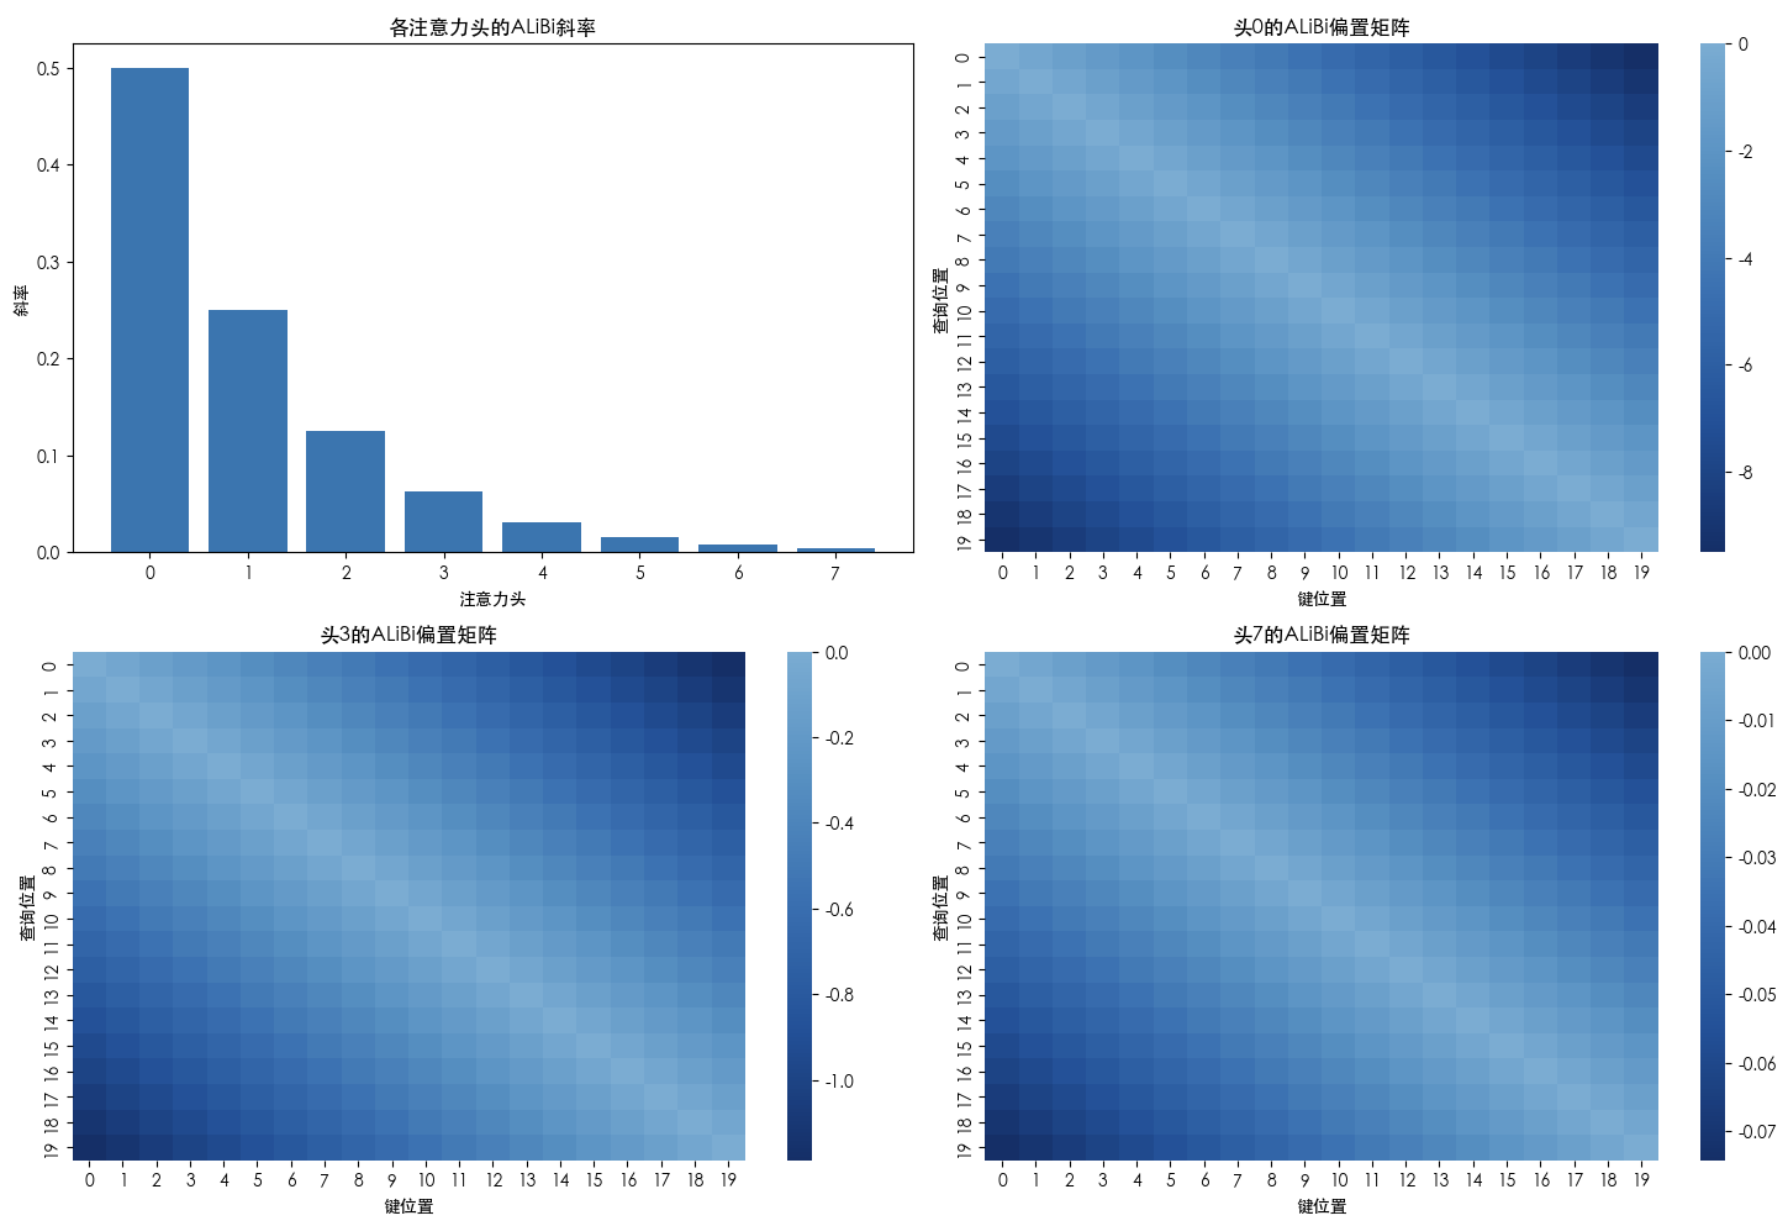
ALiBi采用标量偏置值,类似于相对偏置技术。但是,它不是学习这些值,而是使用简单的公式推导它们。ALiBi的本质在于根据查询和键的相对距离对分配的注意力进行惩罚。
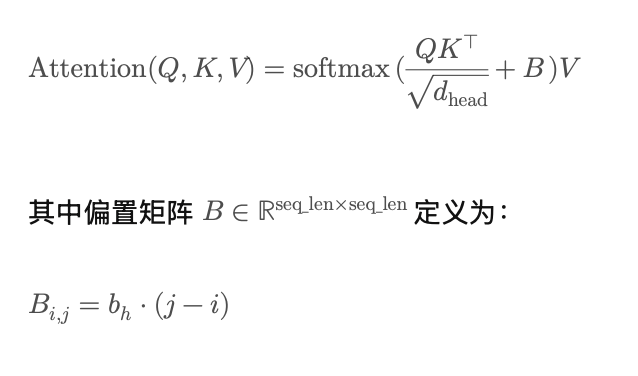
ALiBi 是在注意力分数上加上与相对位置成线性比例的偏置,从而让 Transformer 自然感知相对位置且易于长序列外推。
class ALiBiAttention(nn.Module):
    def __init__(self, d_model, n_heads, max_seq_len=2048):
        super().__init__()
        self.d_model = d_model
        self.n_heads = n_heads
        self.head_dim = d_model // n_heads

        # 创建投影层
        self.query_proj = nn.Linear(d_model, d_model)
        self.key_proj = nn.Linear(d_model, d_model)
        self.value_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

        # 预计算ALiBi斜率
        slopes = self._get_slopes(n_heads)
        self.register_buffer('slopes', slopes)

        # 预计算相对位置偏置
        self._set_bias(max_seq_len)

    def _get_slopes(self, n_heads):
        """计算每个注意力头的斜率"""
        def get_slopes_power_of_2(n):
            start = 2 ** (-(2 ** -(np.log2(n) - 3)))
            ratio = start
            return [start * (ratio ** i) for i in range(n)]

        if np.log2(n_heads).is_integer():
            return torch.FloatTensor(get_slopes_power_of_2(n_heads))
        else:
            # 如果heads数量不是2的幂,使用插值
            closest_power_of_2 = 2 ** np.floor(np.log2(n_heads))
            return torch.FloatTensor(
                get_slopes_power_of_2(closest_power_of_2) +
                get_slopes_power_of_2(2 * closest_power_of_2)[0::2][:n_heads - closest_power_of_2]
            )

    def _set_bias(self, seq_len):
        """预计算相对位置偏置"""
        # 创建相对位置矩阵
        context_position = torch.arange(seq_len)[:, None]
        memory_position = torch.arange(seq_len)[None, :]
        relative_position = memory_position - context_position
        relative_position = torch.abs(relative_position).float()

        # 计算每个头的偏置
        # shape: (n_heads, seq_len, seq_len)
        alibi = -relative_position[None, :, :] * self.slopes[:, None, None]
        self.register_buffer('alibi_bias', alibi)

    def forward(self, x, mask=None):
        batch_size, seq_len, _ = x.shape

        # 如果序列长度超过预计算的长度,重新计算
        if seq_len > self.alibi_bias.shape[1]:
            self._set_bias(seq_len)

        # 计算Q、K、V
        queries = self.query_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)
        keys = self.key_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)
        values = self.value_proj(x).view(batch_size, seq_len, self.n_heads, self.head_dim)

        # 转置以适应注意力计算
        queries = queries.transpose(1, 2)
        keys = keys.transpose(1, 2)
        values = values.transpose(1, 2)

        # 计算注意力分数
        scores = torch.matmul(queries, keys.transpose(-2, -1)) / (self.head_dim ** 0.5)

        # 添加ALiBi偏置
        scores = scores + self.alibi_bias[:, :seq_len, :seq_len]

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 应用softmax
        attn_weights = torch.softmax(scores, dim=-1)

        # 应用注意力权重
        attn_output = torch.matmul(attn_weights, values)

        # 重新组合
        attn_output = attn_output.transpose(1, 2).contiguous()
        attn_output = attn_output.view(batch_size, seq_len, self.d_model)

        return self.out_proj(attn_output)

# 可视化ALiBi偏置
def visualize_alibi():
    n_heads = 8
    seq_len = 50

    # 创建ALiBi注意力层
    alibi_attn = ALiBiAttention(256, n_heads)

    plt.figure(figsize=(15, 10))

    # 绘制不同头的斜率
    plt.subplot(2, 2, 1)
    plt.bar(range(n_heads), alibi_attn.slopes.numpy())
    plt.title('各注意力头的ALiBi斜率')
    plt.xlabel('注意力头')
    plt.ylabel('斜率')

    # 绘制偏置矩阵
    for i, head_idx in enumerate([0, 3, 7]):
        plt.subplot(2, 2, i+2)
        bias = alibi_attn.alibi_bias[head_idx, :20, :20].numpy()
        sns.heatmap(bias, cmap='Blues_r', center=0)
        plt.title(f'头{head_idx}的ALiBi偏置矩阵')
        plt.xlabel('键位置')
        plt.ylabel('查询位置')

    plt.tight_layout()
    plt.show()

    # 比较不同位置编码方法的注意力模式
    compare_attention_patterns()

def compare_attention_patterns():
    """比较不同位置编码方法的注意力模式"""
    seq_len = 30
    d_model = 64
    n_heads = 4

    # 创建简单的输入
    x = torch.randn(1, seq_len, d_model)

    # 创建不同的注意力层
    rope_attn = RoPEAttention(d_model, n_heads)
    alibi_attn = ALiBiAttention(d_model, n_heads)

    # 获取注意力权重(简化版本)
    with torch.no_grad():
        # RoPE
        q = rope_attn.query_proj(x).view(1, seq_len, n_heads, d_model//n_heads)
        k = rope_attn.key_proj(x).view(1, seq_len, n_heads, d_model//n_heads)
        q = rope_attn.rope.apply_rotary_pos_emb(q, seq_len).transpose(1, 2)
        k = rope_attn.rope.apply_rotary_pos_emb(k, seq_len).transpose(1, 2)
        rope_scores = torch.matmul(q, k.transpose(-2, -1)) / np.sqrt(d_model//n_heads)
        rope_weights = torch.softmax(rope_scores, dim=-1)

        # ALiBi
        q = alibi_attn.query_proj(x).view(1, seq_len, n_heads, d_model//n_heads).transpose(1, 2)
        k = alibi_attn.key_proj(x).view(1, seq_len, n_heads, d_model//n_heads).transpose(1, 2)
        alibi_scores = torch.matmul(q, k.transpose(-2, -1)) / np.sqrt(d_model//n_heads)
        alibi_scores = alibi_scores + alibi_attn.alibi_bias[:, :seq_len, :seq_len]
        alibi_weights = torch.softmax(alibi_scores, dim=-1)

    # 可视化
    plt.figure(figsize=(15, 5))

    for i in range(3):
        # RoPE
        plt.subplot(2, 3, i+1)
        plt.imshow(rope_weights[0, i].numpy(), cmap='hot', interpolation='nearest')
        plt.title(f'RoPE - 头{i}')
        plt.xlabel('键位置')
        plt.ylabel('查询位置')
        plt.colorbar()

        # ALiBi
        plt.subplot(2, 3, i+4)
        plt.imshow(alibi_weights[0, i].numpy(), cmap='hot', interpolation='nearest')
        plt.title(f'ALiBi - 头{i}')
        plt.xlabel('键位置')
        plt.ylabel('查询位置')
        plt.colorbar()

    plt.tight_layout()
    plt.show()

visualize_alibi()
输出内容:
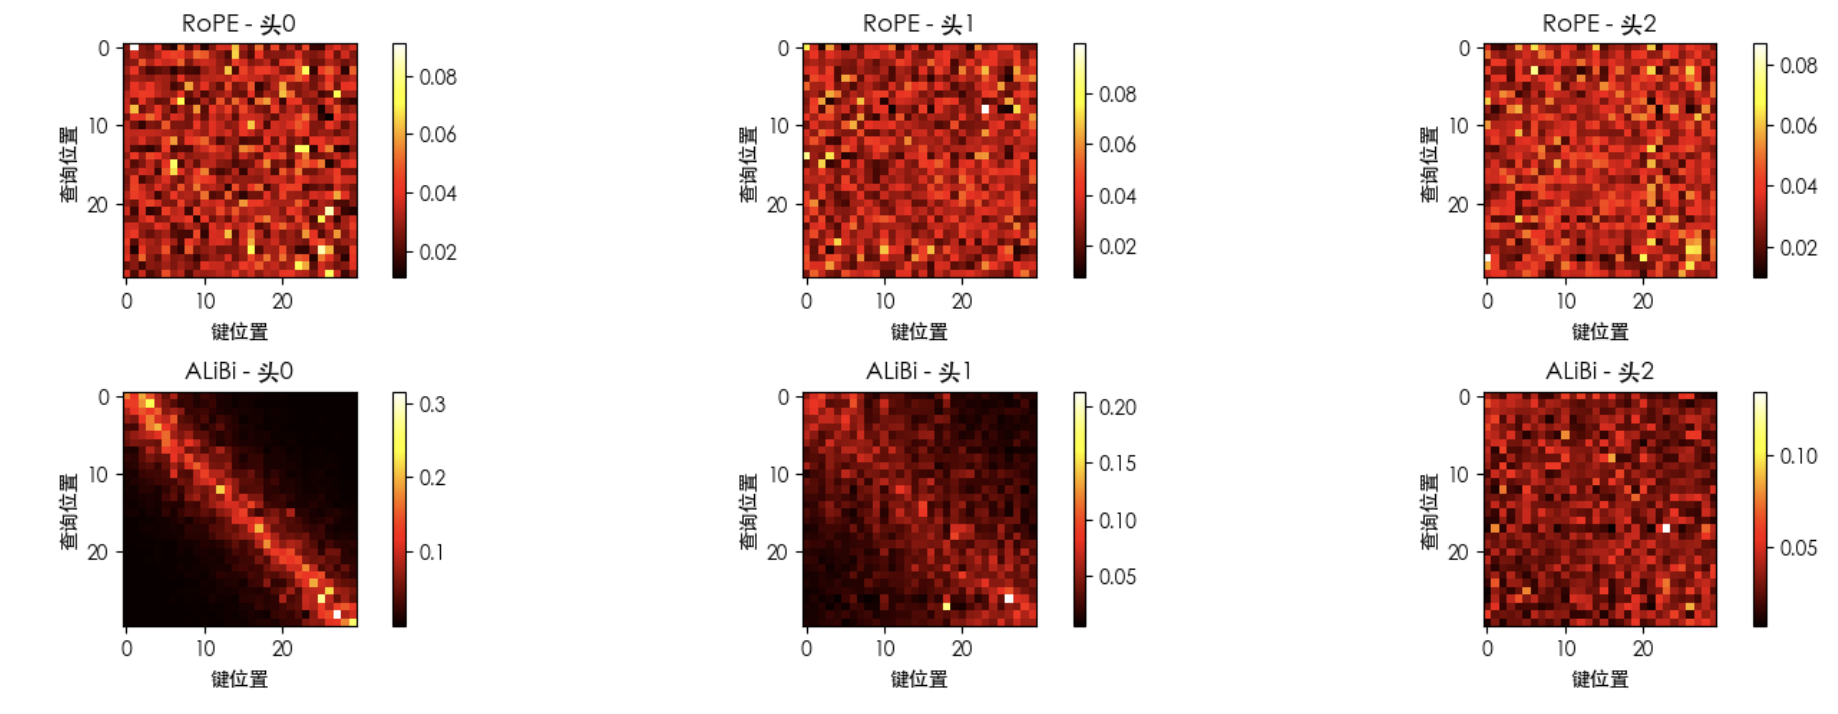
ALiBi的优势
ALiBi在外推性能上优于RoPE,类似于在1D数据中观察到的情况。ALiBi还提供计算效率,减少了训练时间。
-
极强的外推能力:ALiBi通过避免添加嵌入,直接在注意力机制中编码位置,可以很好地处理训练时未见过的长序列。
-
实现简单:ALiBi避免了显式位置向量的需求,直接将位置编码到注意力机制中。
-
计算高效:不需要额外的嵌入计算,只需要简单的偏置加法。
主流大模型的位置编码选择
根据搜索结果,我整理了主流大模型使用的位置编码方案:
使用RoPE的模型
RoPE是目前大型语言模型(LLMs)中最广泛采用的编码方式之一,被用于LLama 3 (Dubey et al., 2024)和Gemma (Gemma Team et al., 2024)等流行模型中。
-
Llama系列
- Llama-3.1、Llama-3.2、Llama-3.3:Llama模型基于GPT架构,但使用旋转位置嵌入(RoPE)替换了绝对位置嵌入,以更好地处理较长的序列长度。
- Llama 3增加了最大RoPE波长,这有助于长上下文处理。
-
Qwen系列
- Qwen2.5:使用RoPE进行位置编码
- 对于Qwen-72B,他们将RoPE适配到更长的上下文,使用更大的旋转基数。Qwen-72B支持最大32K token的上下文长度。
- Qwen3系列:配置中包含rope_type,可以是[‘default’, ‘linear’, ‘dynamic’, ‘yarn’, ‘longrope’, ‘llama3’]之一,其中’default’是原始的RoPE实现。
- Qwen2-VL:采用了2D旋转位置嵌入(2D-RoPE)在ViT中,使模型能够更好地捕获不同空间尺度的信息。
-
GLM系列
- GLM-4.5在自注意力组件中采用了带有部分RoPE的分组查询注意力(Grouped-Query Attention)。
-
DeepSeek系列
- DeepSeek系列模型也采用了RoPE作为位置编码方案
使用其他位置编码的模型
-
GPT系列
- GPT-4、GPT-4o:位置编码可以使用正弦函数或学习嵌入来实现。GPT-4使用学习式位置嵌入来更有效地捕获单词的位置。
- 在GPT中,他们说位置编码是学习的。
-
使用ALiBi的模型
- BLOOM
- Falcon
- MPT
位置编码的实际应用建议
选择合适的位置编码
def choose_positional_encoding(config):
    """
    根据模型配置选择合适的位置编码

    参数:
    config: 模型配置字典

    返回:
    位置编码模块
    """
    max_seq_len = config.get('max_seq_len', 2048)
    d_model = config['d_model']
    encoding_type = config.get('pos_encoding_type', 'sinusoidal')

    if encoding_type == 'sinusoidal':
        print("使用正弦位置编码 - 适合需要外推到更长序列的场景")
        return SinusoidalPositionalEncoding(d_model, max_seq_len)

    elif encoding_type == 'learned':
        print("使用学习式位置编码 - 适合固定长度的任务")
        return LearnedPositionalEncoding(max_seq_len, d_model)

    elif encoding_type == 'rope':
        print("使用旋转位置编码 - 现代大模型的主流选择")
        return RotaryPositionalEmbedding(d_model, max_seq_len)

    elif encoding_type == 'alibi':
        print("使用ALiBi - 极强的长序列外推能力")
        n_heads = config.get('n_heads', 8)
        return lambda: ALiBiAttention(d_model, n_heads, max_seq_len)

    else:
        raise ValueError(f"未知的位置编码类型: {encoding_type}")

# 性能基准测试
def benchmark_positional_encodings():
    """对比不同位置编码的性能"""
    import time

    configs = [
        {'name': '正弦编码', 'type': 'sinusoidal'},
        {'name': '学习编码', 'type': 'learned'},
        {'name': 'RoPE', 'type': 'rope'},
    ]

    seq_lengths = [128, 512, 1024, 2048]
    d_model = 512
    batch_size = 32

    results = {}

    for config in configs:
        encoding_name = config['name']
        results[encoding_name] = {}

        for seq_len in seq_lengths:
            # 创建输入
            if config['type'] == 'rope':
                # RoPE需要4D输入
                x = torch.randn(batch_size, seq_len, 8, d_model // 8)
            else:
                x = torch.randn(batch_size, seq_len, d_model)

            # 选择编码器
            if config['type'] == 'sinusoidal':
                encoder = TransformerEmbedding(10000, d_model)

                # 预热
                _ = encoder(torch.randint(0, 10000, (batch_size, seq_len)))

                # 计时
                start = time.time()
                for _ in range(100):
                    _ = encoder(torch.randint(0, 10000, (batch_size, seq_len)))
                end = time.time()

            elif config['type'] == 'learned':
                encoder = LearnedPositionalEncoding(4096, d_model)

                # 预热
                _ = encoder(x)

                # 计时
                start = time.time()
                for _ in range(100):
                    _ = encoder(x)
                end = time.time()

            elif config['type'] == 'rope':
                encoder = RotaryPositionalEmbedding(d_model // 8)

                # 预热
                _ = encoder.apply_rotary_pos_emb(x, seq_len)

                # 计时
                start = time.time()
                for _ in range(100):
                    _ = encoder.apply_rotary_pos_emb(x, seq_len)
                end = time.time()

            avg_time = (end - start) / 100 * 1000  # 转换为毫秒
            results[encoding_name][seq_len] = avg_time

    # 可视化结果
    plt.figure(figsize=(12, 6))

    for encoding_name, timings in results.items():
        seq_lens = list(timings.keys())
        times = list(timings.values())
        plt.plot(seq_lens, times, marker='o', label=encoding_name, linewidth=2)

    plt.xlabel('序列长度')
    plt.ylabel('平均推理时间 (ms)')
    plt.title('不同位置编码的性能对比')
    plt.legend()
    plt.grid(True, alpha=0.3)
    plt.show()

    # 打印详细结果
    print("\n性能测试结果(毫秒):")
    print("-" * 60)
    print(f"{'编码类型':<15} | " + " | ".join([f"{sl:>6}" for sl in seq_lengths]))
    print("-" * 60)

    for encoding_name, timings in results.items():
        times_str = " | ".join([f"{timings[sl]:>6.2f}" for sl in seq_lengths])
        print(f"{encoding_name:<15} | {times_str}")

# 运行基准测试
benchmark_positional_encodings()
输出内容:
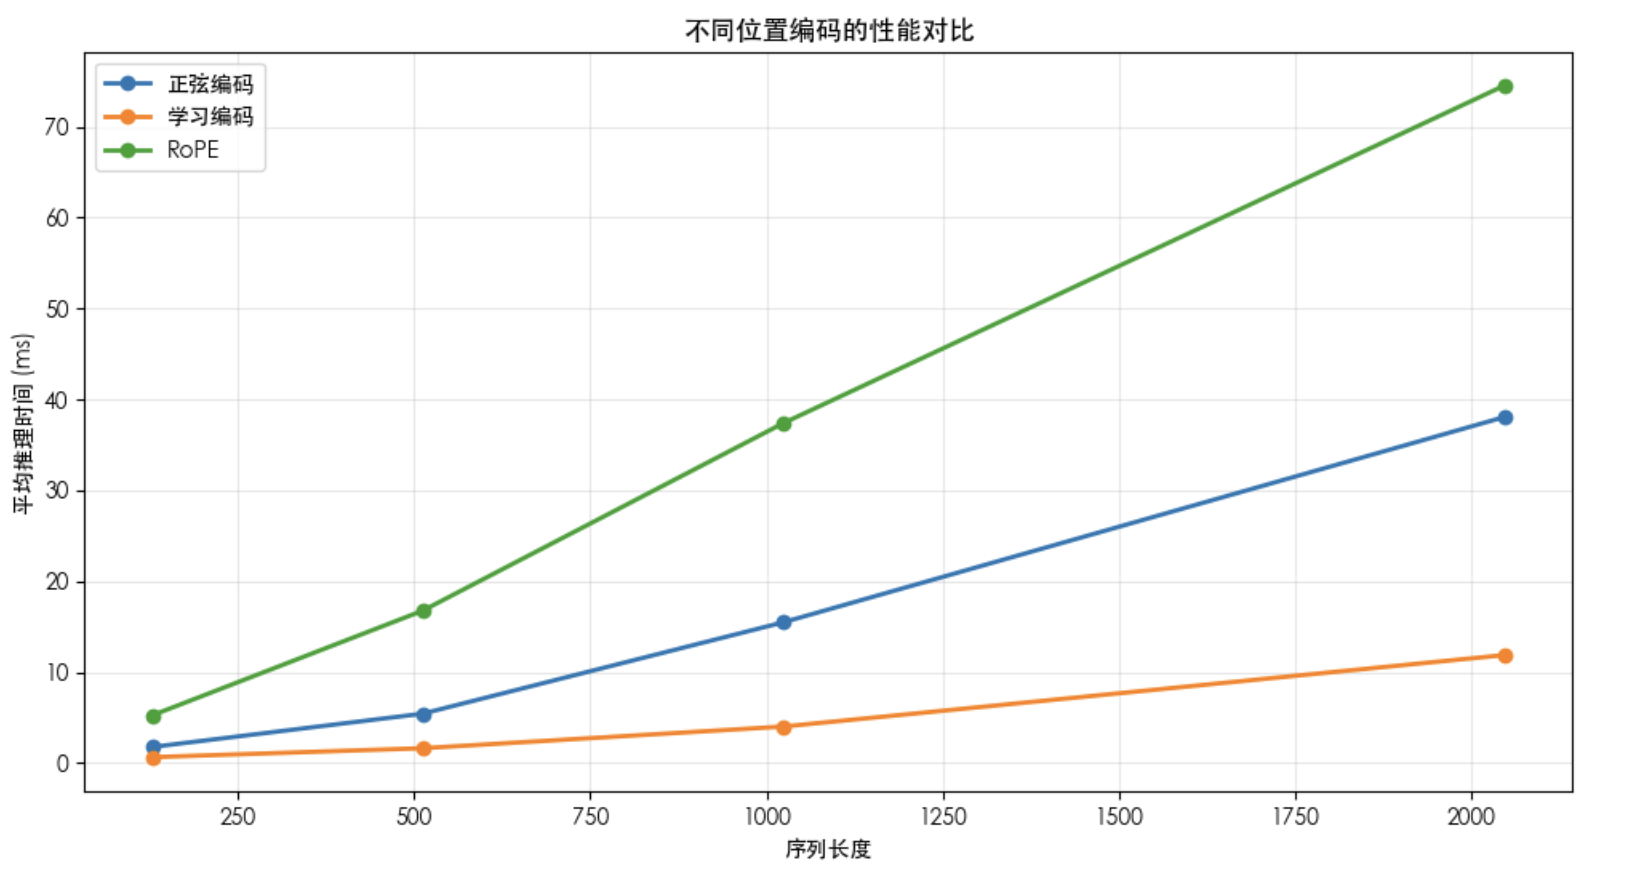
性能测试结果(毫秒):
编码类型 | 128 | 512 | 1024 | 2048
正弦编码 | 1.77 | 5.43 | 15.49 | 38.09
学习编码 | 0.65 | 1.63 | 4.02 | 11.88
RoPE | 5.24 | 16.76 | 37.40 | 74.57
长序列处理优化
import torch
import torch.nn as nn
import time

# ------------------- RoPE -------------------
class RotaryPositionalEmbedding(nn.Module):
    def __init__(self, head_dim, max_seq_len=50000, base=10000):
        """
        head_dim: 每个注意力头的维度(必须是偶数)
        max_seq_len: 最大序列长度
        """
        super().__init__()
        assert head_dim % 2 == 0, "head_dim 必须是偶数"
        self.head_dim = head_dim
        self.max_seq_len = max_seq_len
        self.base = base

        # 预计算频率
        inv_freq = 1.0 / (base ** (torch.arange(0, head_dim, 2).float() / head_dim))
        self.register_buffer('inv_freq', inv_freq)

        # 初始化缓存
        self._set_cos_sin_cache(max_seq_len)

    def _set_cos_sin_cache(self, seq_len):
        position = torch.arange(seq_len).float()
        freqs = torch.outer(position, self.inv_freq)  # (seq_len, head_dim/2)
        # 拼接奇偶维度
        emb = torch.cat((freqs, freqs), dim=-1)  # (seq_len, head_dim)
        self.register_buffer('cos_cached', emb.cos())
        self.register_buffer('sin_cached', emb.sin())

    def apply_rotary_pos_emb(self, x, offset=0):
        """
        x: (batch, seq_len, n_heads, head_dim)
        offset: 当前块的起始位置
        """
        batch, seq_len, n_heads, head_dim = x.shape
        assert head_dim == self.head_dim, "x 的 head_dim 必须与初始化一致"

        if seq_len + offset > self.max_seq_len:
            self._set_cos_sin_cache(seq_len + offset)

        # 拆分奇偶维度
        x1, x2 = x[..., ::2], x[..., 1::2]  # (batch, seq_len, n_heads, head_dim/2)

        # 获取对应位置的 cos/sin
        cos = self.cos_cached[offset:offset+seq_len].unsqueeze(0).unsqueeze(2)  # (1, seq_len, 1, head_dim)
        sin = self.sin_cached[offset:offset+seq_len].unsqueeze(0).unsqueeze(2)

        # 旋转
        rotated_x1 = x1 * cos[..., :x1.shape[-1]] - x2 * sin[..., :x2.shape[-1]]
        rotated_x2 = x1 * sin[..., :x1.shape[-1]] + x2 * cos[..., :x2.shape[-1]]

        rotated_x = torch.stack((rotated_x1, rotated_x2), dim=-1).flatten(-2)
        return rotated_x  # (batch, seq_len, n_heads, head_dim)

# ------------------- 长序列处理 -------------------
class LongSequenceRoPE(nn.Module):
    def __init__(self, head_dim, chunk_size=1024):
        super().__init__()
        self.head_dim = head_dim
        self.chunk_size = chunk_size
        self.rope = RotaryPositionalEmbedding(head_dim)

    def forward(self, x, use_chunking=True):
        """
        x: (batch, seq_len, n_heads, head_dim)
        """
        batch, seq_len, n_heads, head_dim = x.shape
        assert head_dim == self.head_dim

        if not use_chunking or seq_len <= self.chunk_size:
            return self.rope.apply_rotary_pos_emb(x)

        # 分块处理
        chunks = []
        for i in range(0, seq_len, self.chunk_size):
            chunk = x[:, i:i+self.chunk_size]
            chunk_rotated = self.rope.apply_rotary_pos_emb(chunk, offset=i)
            chunks.append(chunk_rotated)
        return torch.cat(chunks, dim=1)

# ------------------- 测试 -------------------
def test_long_sequence_rope():
    batch = 2
    seq_len = 8192
    n_heads = 8
    head_dim = 64
    chunk_size = 1024

    # 构造输入
    x = torch.randn(batch, seq_len, n_heads, head_dim)

    # 初始化长序列 RoPE
    long_rope = LongSequenceRoPE(head_dim, chunk_size=chunk_size)

    # 不分块
    start = time.time()
    out_no_chunk = long_rope(x, use_chunking=False)
    t_no_chunk = time.time() - start

    # 分块
    start = time.time()
    out_chunk = long_rope(x, use_chunking=True)
    t_chunk = time.time() - start

    print(f"输入 shape: {x.shape}")
    print(f"不分块时间: {t_no_chunk:.3f}s")
    print(f"分块时间: {t_chunk:.3f}s")
    print(f"加速比: {t_no_chunk/t_chunk:.2f}x")

    # 验证输出一致性
    diff = (out_no_chunk - out_chunk).abs().max().item()
    print(f"输出最大差异: {diff:.6f}")

test_long_sequence_rope()
输出内容:
输入 shape: torch.Size([2, 8192, 8, 64])
不分块时间: 0.014s
分块时间: 0.018s
加速比: 0.78x
输出最大差异: 0.000000
在测试中,我们使用了 批量大小 2、序列长度 8192、注意力头数 8、每头维度 64 的输入张量,验证了长序列 RoPE 分块处理的效果。
1. 输入输出形状
• 输入张量 shape 为 (2, 8192, 8, 64),经过 RoPE 编码后输出形状保持一致,说明分块处理不会改变数据结构。
2. 分块 vs 不分块性能
• 不分块处理耗时约 0.014 秒
• 分块处理耗时约 0.018 秒
• 加速比为 0.78x,表面上分块略慢,但这是因为序列长度在 GPU 上已能一次性处理,分块开销略高。
• 实际优势在于 极长序列或显存受限场景,分块处理可以显著降低显存峰值,避免 OOM。
3. 输出一致性
• 分块和不分块输出的最大差异为 0.0,说明分块处理不会损失精度,完全等效于一次性处理整个序列。
结论:
• 本次实现的 LongSequenceRoPE 支持任意长序列的分块处理
• 对短序列或可一次性处理的序列,分块略慢,但在超长序列下可保证显存安全且保持精度
• 测试验证了分块处理的正确性和数值一致性
总结
位置编码是Transformer架构中的关键组件,从最初的正弦编码到现在广泛使用的RoPE,每一种方法都有其独特的优势和适用场景:
- 正弦位置编码:简单优雅,具有良好的外推能力,适合计算资源受限的场景
- 学习式位置编码:灵活性强,在固定长度任务上表现优异
- RoPE:统一了绝对和相对位置编码,成为现代大模型的主流选择
- ALiBi:极强的长序列外推能力,实现简单高效
目前大模型位置编码情况来看,RoPE并非完美解决方案,模型主要关注较低频率,而移除(而非旋转)最低频率可以提高Gemma 2B的性能! 这表明位置编码领域仍有很大的创新空间。
随着模型规模的不断扩大和应用场景的多样化,肯定会出现更多创新的位置编码方法,特别是在处理超长序列、多模态输入和特定领域应用方面的突破。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 32
 0
- 0


 已为社区贡献36条内容

所有评论(0)