登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了一款基于Hadoop+Spark大数据技术架构的大学生请假管理系统。该系统采用Django+Vue前后端分离架构,整合Hadoop分布式存储和Spark实时计算能力,实现学生请假申请、审批管理、数据统计分析和机器学习预测等功能。系统通过ElementUI构建友好界面,结合Echarts进行数据可视化展示,并利用Spark SQL、Pandas等技术完成从数据采集到预测分析的完整处理流程。
GitHub热门项目:基于大数据技术的心理健康综合分析系统实战教程
在当今数字化时代,大数据的规模呈爆炸式增长,如何高效地处理和分析这些海量数据成为了企业和研究机构面临的重要挑战。Spark SQL作为Apache Spark生态系统中的一个重要组件,为大数据分析提供了一种简单、高效的方式。本文的目的在于详细介绍Spark SQL的原理、使用方法和实际应用,帮助读者掌握这一大数据分析的必备技能。范围涵盖了Spark SQL的核心概念、算法原理、数学模型、项目实战、
本文介绍了一个基于大数据技术的全球用水量数据可视化分析系统,该系统采用Python开发,结合Spark、Hadoop、Django、Vue和Echarts等技术框架,构建了前后端分离的架构。系统功能包括全球水资源消耗的时序演变分析、各国用水特征对比、水资源稀缺性归因分析等五大核心维度,通过时间序列分析、聚类算法等技术实现多维度水资源利用规律挖掘。文中展示了系统的大屏页面、分析页面等功能模块,并提供
篮球NBA球员数据分析及预测系统 体育比赛 可视化 +Flask框架 篮球数据分析 时间序列预测算法 大数据毕业设计✅
本文介绍了基于Hadoop+Spark的化妆品销售数据可视化分析与商品推荐系统。系统采用Python爬虫采集淘宝美妆数据,通过Hadoop进行分布式存储,利用Spark进行数据处理和协同过滤推荐算法建模。前端使用Vue+Echarts实现交互式可视化大屏,展示商品地域分布、价格区间、销量趋势等多维度分析结果。系统包含用户端(商品浏览、个性化推荐)和管理端(数据管理、可视化分析)功能模块,为电商运营
Spark毕业设计项目:校园霸凌数据分析系统大数据处理与可视化展示技术详解
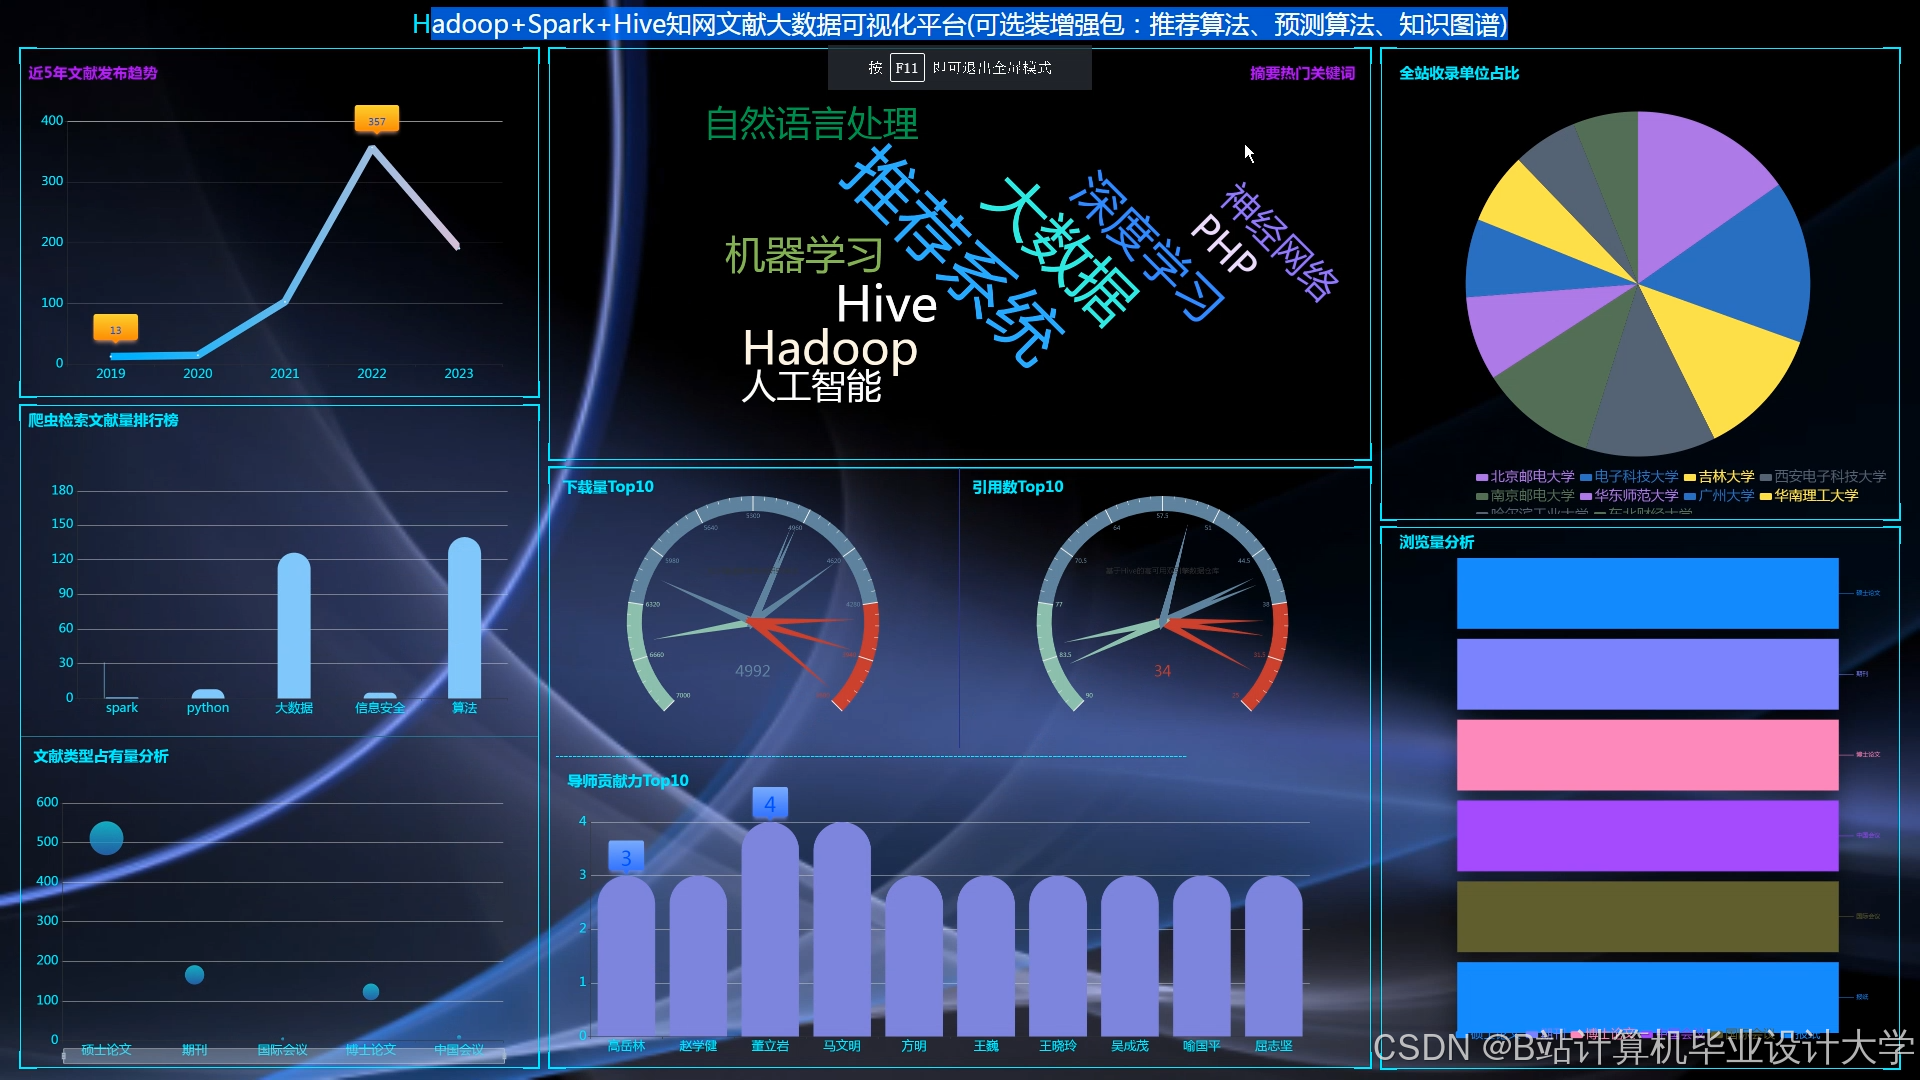
计算机毕业设计Python+Hadoop+Spark知网文献推荐系统 知网论文可视化 大数据毕业设计(源码+论文+讲解视频+PPT)
当前旅游景点管理与游客决策存在明显短板:景点运营方多依赖人工统计客流、收入等基础数据,难深度挖掘游客来源地、停留时长、消费偏好等核心信息,无法精准优化服务(如设施布局、人员排班);游客规划行程时,需在多平台拼凑景点评价、人流高峰、周边配套等信息,信息碎片化且真实性难辨,易导致出行体验不佳;旅游监管部门缺乏对区域内景点的整体数据把控,难及时发现热门景点超载、冷门景点资源浪费等问题,宏观调控滞后;同时
当前招聘市场存在明显信息不对称短板:求职者需在多平台筛选岗位,面对海量信息难快速定位匹配岗位(如薪资范围、技能要求、行业前景),易陷入 “投简历效率低、岗位匹配度差” 困境;企业 HR 依赖人工筛选简历,难精准识别候选人与岗位的适配性,且缺乏行业薪资水平、竞品招聘策略等数据支撑,导致招聘成本高、周期长;行业监管与求职者缺乏岗位信息真实性核验渠道,虚假招聘、薪资注水等问题频发,损害求职者权益;同时,
本文提供了大数据分析专业毕业设计选题指导,涵盖机器学习、深度学习、分布式系统等多个方向。精选选题包括贷款违约预测、保险风险评估、股票预测、商品销售分析等实际应用场景,并推荐了基于Hadoop、Spark等大数据技术的系统设计方案。文章强调了选题的重要性,建议选择难度适中、工作量充足的课题,同时提供了学长作品实例和更多选题资源,帮助学生在考研、实习等忙碌的大四阶段顺利完成毕业设计。
摘要: 本文介绍了一个基于Spark+Django的豆瓣电影数据可视化分析系统。系统采用Hadoop+Spark处理海量电影数据,后端使用Django构建API,前端通过Vue+Echarts实现交互式可视化。核心功能包括电影信息管理、评分分析、类型统计、敏感词过滤等,利用Spark SQL和Pandas进行多维度分析,并以图表形式展示结果。系统架构稳定,支持大规模数据处理与实时分析,为用户提供直
本文提出一个基于大数据技术的脱发风险预测系统。系统采用Python3.8+Spark3.0+Hadoop3.2技术栈构建,包含数据采集、清洗、建模和可视化全流程。通过随机森林算法分析人口统计、生活习惯、医疗状况等多维特征,建立个性化预测模型。前端采用Vue2.6+Echarts5.0实现交互式可视化,后端使用Django3.2提供RESTful API。系统可处理10万条模拟数据,支持风险等级预测
本文介绍了一个基于大数据的全球学生移民与高等教育分析系统,系统采用Python开发,结合Spark、Hadoop等技术框架,包含六大核心功能模块:全球学生移民流向分析、高等教育专业趋势分析、学生就业与薪资分析、奖学金资助分析、学术表现评估和签证政策分析。通过可视化大屏展示全球留学动态、专业偏好、就业趋势等数据,为教育决策者、学生和机构提供科学依据。系统采用MySQL数据库,开发环境为PyCharm
导师推荐毕设方向:大数据校园霸凌分析系统技术实现与应用价值分析
本文介绍了一个基于Python开发的全球二氧化碳数据可视化分析系统,采用Spark、Hadoop进行大数据处理,Django和Vue构建前后端,Echarts实现数据可视化。系统针对海量、多源的CO₂数据,通过时间序列分析、极值分析、波动模式分析等方法,揭示全球CO₂浓度变化趋势与规律。主要功能模块包括:趋势分析(年度/季节性变化)、极值分析(阈值突破检测)、波动分析(聚类/变异系数)和周期性分析
摘要:本研究基于Python、Spark和Hadoop大数据技术,结合Vue和Echarts前端框架,开发了上海租房信息可视化及价格预测系统。系统采用MySQL数据库,通过统计分析、聚类分析和机器学习算法,实现房源区域分析、交通便利性评估、特征分析、市场洞察和租金预测五大功能模块。该解决方案有效解决了传统租房信息不对称问题,为租房者提供科学决策支持,同时促进租房市场透明化,为行业数字化转型和政府决
Spring Boot是一个基于Spring框架的新型开源框架,旨在简化Spring应用的创建、运行、调试和部署。通过自动配置和“约定优于配置”的原则,它让开发者能够快速搭建独立、生产级别的应用程序。Spring Boot由Pivotal团队提供,目标是通过最少的配置和代码来快速开发Spring应用。它使用Maven或Gradle作为构建工具,提供了丰富的starter依赖,使得项目可以快速启动并
当前电商图书运营存在明显数据应用短板:电商平台图书品类繁多(百万级 SKU),运营方难从海量销售数据中快速识别热门品类(如社科、儿童绘本)、滞销图书特征,导致库存积压或热门书缺货;消费者面对海量图书,难通过客观数据(如不同年龄段阅读偏好、同类型图书销量对比)选择适配书籍,易受营销信息误导;图书出版方难获取市场实时反馈(如某类题材读者画像、销量地域分布),选题与印刷量决策缺乏数据支撑;同时,传统数据
当前旅游行业数据应用存在明显短板:旅游主管部门、景区运营方、旅游企业积累的海量数据(客流数据、消费记录、游客评价、交通住宿信息)多分散存储于不同平台,格式不统一,难以实现跨维度整合分析;传统数据呈现以表格、文字为主,非技术人员难快速识别核心信息(如客流高峰时段、热门景点分布、消费能力分层),导致决策时缺乏直观数据支撑;游客规划行程时,需在多渠道拼凑碎片化信息,难获取区域旅游整体态势(如拥堵预警、性
本研究设计实现了基于Hadoop的NBA球员数据分析系统,利用Hadoop分布式架构处理海量复杂赛事数据。系统通过多源数据采集、HDFS存储和MapReduce并行计算实现球员基础数据、比赛统计的高效处理,并配备可视化分析模块(图5-4)。测试表明系统性能稳定,显著提升了球员数据分析效率,为体育数据决策提供了新方案。
本文探讨了大数据时代下网站数据可视化及其信息管理系统的开发与应用。以弹幕对影视创作影响分析为例,分析了数据可视化在管理信息系统中的意义,对比了传统与大数据环境下的系统差异,从硬件优化和软件开发角度阐述了爬虫技术的优势。研究提出了数据可视化建设的合理化建议,包括政策立法和信息反馈机制完善,并对未来发展进行了展望。
摘要:本文介绍了一个基于Spark的温布尔登网球赛事数据分析平台,该系统整合Hadoop、Spark等大数据技术,结合Python、Django和Vue.js实现全栈开发。平台提供赛事数据管理、可视化分析、机器学习预测等功能,支持对选手战绩、比赛统计等多维度数据进行深度挖掘。系统采用Spark SQL进行高效查询,运用随机森林等算法实现赛事预测,并通过Echarts实现数据可视化展示。文章包含平台
当前房产市场数据应用存在明显短板:购房者查询房价需跨多平台搜集信息(如区域均价、户型价差),数据分散且更新不及时,难精准判断房价走势与性价比;房产中介依赖人工整理房源数据,分析效率低,难快速为客户匹配 “预算 - 区位 - 户型” 适配的房源;政策制定者与投资者缺乏直观的房价数据呈现(如区域涨幅热力图、供需关系曲线),决策易受主观因素影响;同时,传统房价分析多聚焦单一维度(如均价),未联动配套资源
该基于大数据的在线广告推荐系统数据分析可视化大屏利用Python语言、MySQL数据库,Django框架,结合目前流行的 B/S架构,将系统的各个方面都集中到数据库中,以便于毕业设计的需要。该系统在确保系统稳定的前提下,能够实现多功能模块的设计和应用。不同角色的准入制度是有严格区别的。各功能模块的设计也便于以后的系统升级和维护。该系统采用了软件组件化、精化体系结构、分离逻辑和数据等方法。开发者可以
该基于大数据的旅游景点数据分析爬虫可视化大屏利用Python语言、MySQL数据库,Django框架,结合目前流行的 B/S架构,将系统的各个方面都集中到数据库中,以便于毕业设计的需要。该系统在确保系统稳定的前提下,能够实现多功能模块的设计和应用。不同角色的准入制度是有严格区别的。各功能模块的设计也便于以后的系统升级和维护。该系统采用了软件组件化、精化体系结构、分离逻辑和数据等方法。开发者可以通过
该基于大数据的起点小说数据分析可视化平台利用Python语言、MySQL数据库,Django框架,结合目前流行的 B/S架构,将系统的各个方面都集中到数据库中,以便于毕业设计的需要。该系统在确保系统稳定的前提下,能够实现多功能模块的设计和应用。不同角色的准入制度是有严格区别的。各功能模块的设计也便于以后的系统升级和维护。该系统采用了软件组件化、精化体系结构、分离逻辑和数据等方法。开发者可以通过 P
本文介绍了一个基于大数据技术的医保药品数据分析系统开发项目。系统采用Python、Spark和Hadoop等大数据框架处理数据,使用Vue.js和Echarts实现可视化展示。包含医保目录等级分析、药品剂型分布、龙头企业市场份额等核心模块,通过数据挖掘为药品管理提供决策支持。项目展示了大数据技术在医疗健康领域的应用价值,可帮助优化药品采购和监管策略。
本文介绍了一个基于Spark的大规模气象地质灾害数据可视化分析平台,采用Python语言开发,整合Spark、Hadoop、Django、Vue和Echarts等技术框架。系统围绕时间规律、空间分布、事件特征、文本挖掘和多维关联五大维度展开分析,实现灾害数据的实时处理与可视化展示。核心功能包括年度预警趋势统计、行政区高等级预警分析、预警等级持续时长计算等,通过分布式计算提升处理效率,并结合前端可视
通过调用平台开放的应用程序接口(API),按照规定的协议和规则,获取平台上的数据(如用户信息、内容、互动数据等),这种数据采集虽高效便捷,但存在依赖性、安全、维护成本、数据质量、法律合规等多方面弊端。:这类工具可覆盖多数据源,如一些通用数据爬取软件,虽能获取多平台信息,但普遍存在数据清洗难度大、实时性不足、缺乏深度分析功能的问题,难以满足企业专业化需求。那么,大数据采集工具有哪些?:某 3C 品牌
本文介绍了一个基于Spark和Hadoop的汽车投诉数据分析与可视化系统,系统采用Python开发,结合Django、Vue、Echarts等技术框架,通过大数据技术实现从数据采集、存储、处理到可视化的全流程。系统功能包括:品牌投诉量排名分析、问题类型分布统计、投诉时间趋势分析等,并通过可视化界面直观展示分析结果。文章还提供了部分功能代码示例,展示了如何使用Spark进行数据处理和分析。该系统可为
大数据毕业设计推荐:基于Hadoop+Spark的小儿阑尾炎可视化分析系统详解