登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了一款基于Hadoop+Spark大数据技术架构的大学生请假管理系统。该系统采用Django+Vue前后端分离架构,整合Hadoop分布式存储和Spark实时计算能力,实现学生请假申请、审批管理、数据统计分析和机器学习预测等功能。系统通过ElementUI构建友好界面,结合Echarts进行数据可视化展示,并利用Spark SQL、Pandas等技术完成从数据采集到预测分析的完整处理流程。
GitHub热门项目:基于大数据技术的心理健康综合分析系统实战教程
系统主要功能包括用户功能、图书管理员功能和管理员功能。用户可以进行图书资讯、图书信息的点赞、收藏、借阅、购买、评论等操作,并可查询热门图书、购书信息及借还书信息。图书管理员管理图书信息、入库信息、购书信息、借阅信息和还书信息。管理员则具备更全面的权限,包括用户管理、图书信息管理、购书信息管理、借还书信息管理及热门图书管理等功能...
大数据不会+框架不熟+算法头疼?基于Spark+Django的食物口味分析系统一站式解决方案
机器学习:Spark抖音短视频数据分析可视化系统 Hadoop+Hive 机器学习 线性回归预测算法 情感分析 舆情分析 爬虫 毕业设计✅
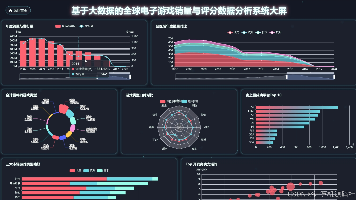
本文介绍了一个基于Hadoop+Spark的全球游戏评分与销量可视化分析系统,该系统通过整合游戏销量、用户评分等数据,利用大数据技术进行分析,为玩家提供个性化推荐,并为游戏开发商提供市场趋势分析。系统涵盖数据采集、处理、分析及可视化模块,采用Python、Spark等技术,结合Vue和Echarts实现直观的可视化界面。核心功能包括数据清洗、游戏类型评分分析等,旨在提升用户体验并支持行业决策。开发
2.1系统开发环境操作系统:Windows10数据库:MySQL开发工具:Py Charm,Eclipse、VM ware Workstation Pro开发语言及框架:Python、Java、Map Reduce计算框架、Django前端框架应用算法:协同过滤算法2.2系统运行环境运行操作系统:Windows10及其以上版本运行数据库:MySQLCommunityServer5.5及以上版本文件
本文介绍了基于Hadoop+Spark的化妆品销售数据可视化分析与商品推荐系统。系统采用Python爬虫采集淘宝美妆数据,通过Hadoop进行分布式存储,利用Spark进行数据处理和协同过滤推荐算法建模。前端使用Vue+Echarts实现交互式可视化大屏,展示商品地域分布、价格区间、销量趋势等多维度分析结果。系统包含用户端(商品浏览、个性化推荐)和管理端(数据管理、可视化分析)功能模块,为电商运营
Hive是基于Hadoop的数据仓库工具,提供类似SQL的HiveQL语言,将查询转换为MapReduce/Tez/Spark作业执行。其架构包含用户接口、元存储(核心)、驱动器(解析器、编译器、优化器、执行器)和执行引擎(如Tez/Spark)。关键进程包括HiveServer2(支持远程并发查询)和MetaStore Server(管理元数据)。Hive优势在于易用性(SQL语法)、可扩展性及
大数据医疗成趋势:帕金森病可视化分析系统为何成毕设首选项目
本文介绍了基于Hadoop+Spark的贵州茅台股票数据分析系统,采用Python/Java语言开发,集成Django/Spring Boot后端与Vue前端,实现多维金融数据分析。系统核心功能包括价格趋势分析、成交量跟踪、波动性评估及技术指标验证,通过Spark SQL和Pandas处理海量交易数据,支持日均价格走势、价量相关性、MACD/RSI指标等深度挖掘。界面展示包含Echarts动态可视
Spark毕业设计项目:校园霸凌数据分析系统大数据处理与可视化展示技术详解
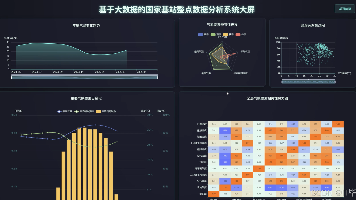
基于大数据的国家基站整点数据分析系统整合Hadoop、Spark等技术,实现气象数据的智能化处理与可视化。系统采用Django/Spring Boot后端框架,搭配Vue+ECharts前端,支持温湿度关联分析、风玫瑰图等核心功能。通过Spark SQL处理海量气象数据,生成年度气温趋势、季节差异等分析结果,为农业、城市规划等领域提供数据支持。开发涵盖Python/Java语言,利用HDFS分布式
GitHub高星标项目:基于大数据的心理健康分析系统Hadoop+Spark完整实现
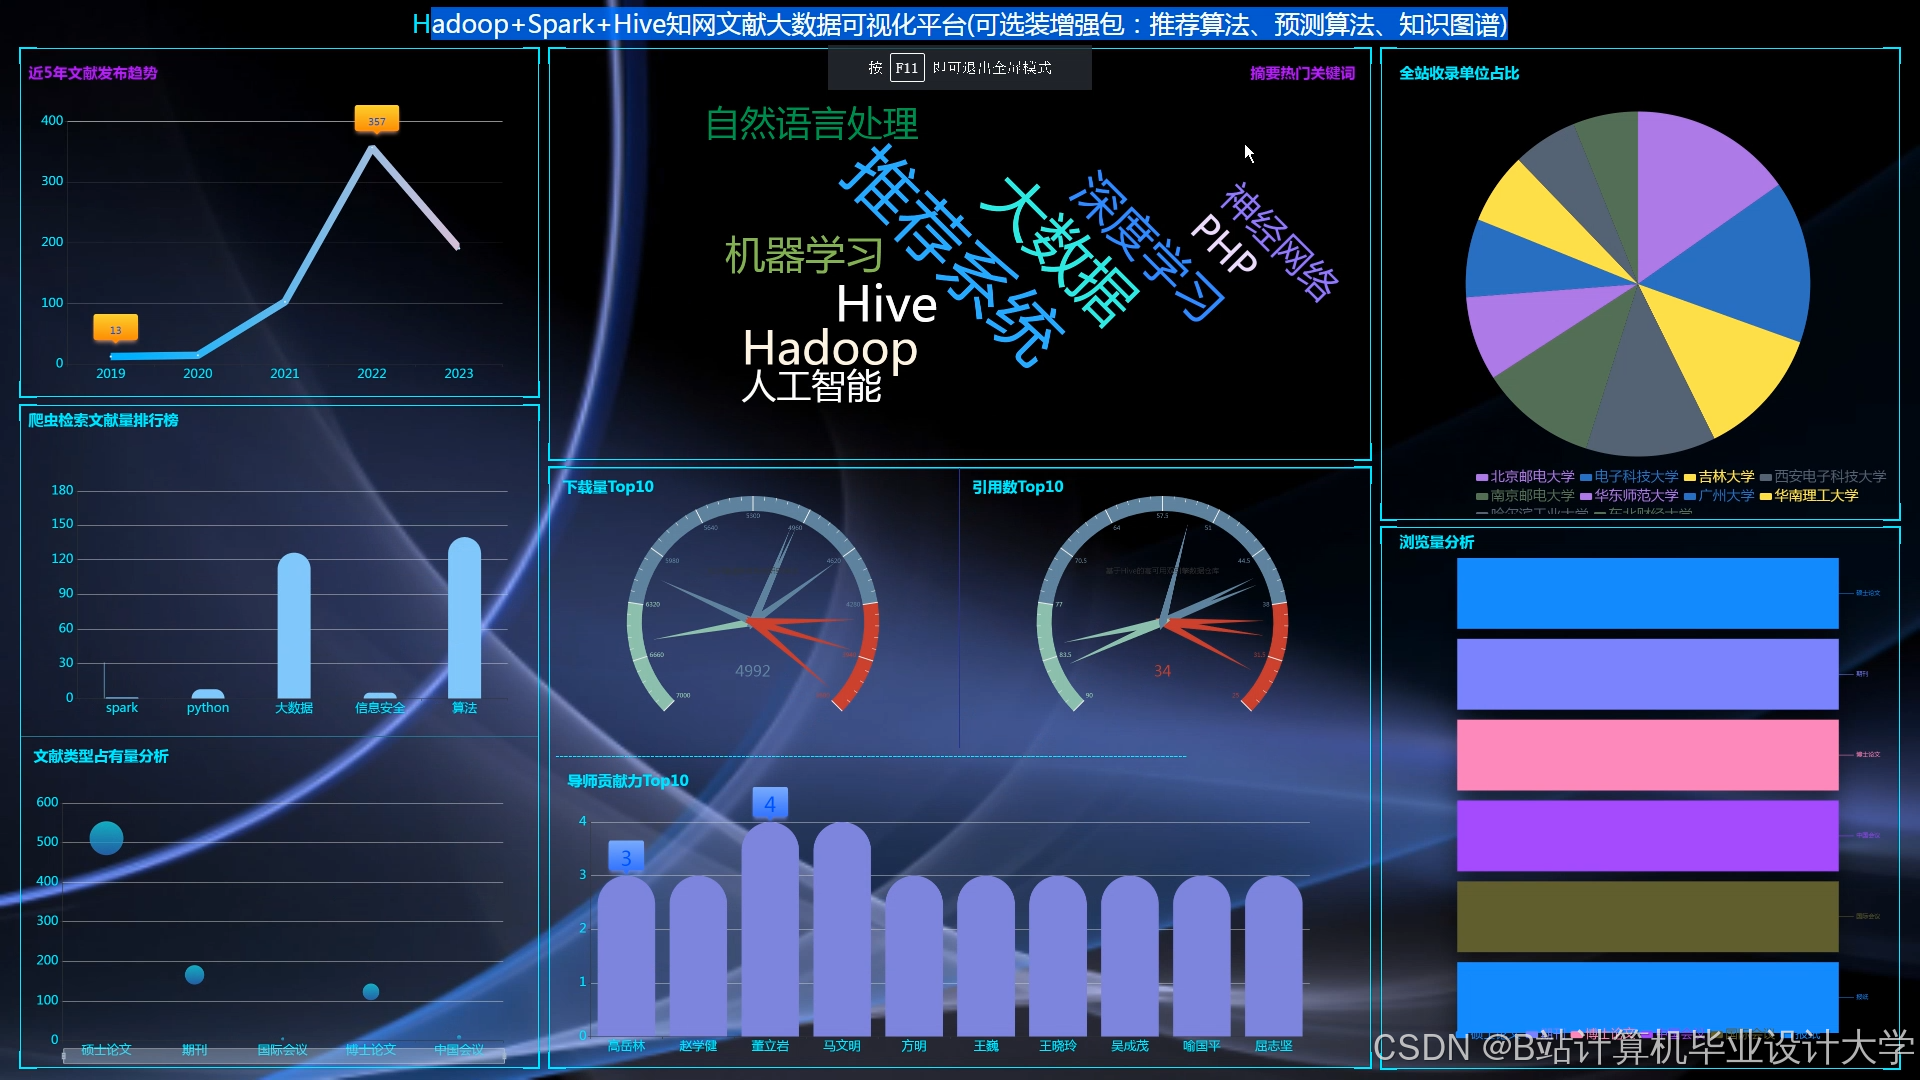
计算机毕业设计Python+Hadoop+Spark知网文献推荐系统 知网论文可视化 大数据毕业设计(源码+论文+讲解视频+PPT)
还在为大数据毕设发愁?汽车投诉分析系统手把手教你Spark+Python实战
Hive、Flink数据倾斜分析及优化
随着企业数据规模呈指数级增长,传统关系型数据库在处理PB级海量数据时面临存储容量、计算性能与成本控制的多重挑战。Hadoop分布式计算框架凭借其高扩展性、低成本的数据存储与处理能力,成为企业级数据仓库建设的核心技术栈。本文聚焦Hadoop生态体系在数据仓库构建与ETL(Extract-Transform-Load)处理中的工程实践,涵盖架构设计、组件选型、流程优化、故障处理等核心议题,为企业级数据
摘要: 本文介绍了一个基于Spark+Django的豆瓣电影数据可视化分析系统。系统采用Hadoop+Spark处理海量电影数据,后端使用Django构建API,前端通过Vue+Echarts实现交互式可视化。核心功能包括电影信息管理、评分分析、类型统计、敏感词过滤等,利用Spark SQL和Pandas进行多维度分析,并以图表形式展示结果。系统架构稳定,支持大规模数据处理与实时分析,为用户提供直
计算机毕设选题大数据毕设-基于Hadoop+Django的肾脏疾病风险系统技术详解 毕业设计/选题推荐/深度学习/数据分析/机器学习/数据挖掘/随机森林
导师推荐毕设方向:大数据校园霸凌分析系统技术实现与应用价值分析
毕业设计:大数据Spark抖音短视频数据分析可视化系统 Hadoop+Hive 机器学习 线性回归预测算法 情感分析 舆情分析 爬虫 毕业设计✅
计算机毕设不知道选什么技术栈?房产数据分析系统:Hadoop+Spark+Vue全搞定担心大数据毕设太难?基于Spark的房产成交分析系统完整实现教程 毕业设计/选题推荐/深度学习/数据分析/机器学习/数据挖掘/随机森林
本文设计并实现了一个基于Hadoop的毕业生就业推荐系统。系统采用SpringBoot+Vue.js前后端分离架构,利用Hadoop分布式计算处理海量数据,通过协同过滤算法实现个性化职位推荐。管理员端具备用户管理、企业审核、简历管理等核心功能;用户端提供职位搜索、简历投递、推荐职位等服务。系统创新性地将大数据技术与推荐算法相结合,有效解决了传统招聘中信息不对称问题,提升了求职匹配效率。测试结果表明
本文详细解析了ApacheHadoop的三大核心组件:HDFS提供分布式存储,采用主从架构设计,具备高容错性;MapReduce作为分布式计算框架,通过Map和Reduce两阶段处理海量数据;YARN实现集群资源管理,支持多种计算框架。这三个组件协同工作,构建了强大的分布式数据处理平台,其中HDFS负责存储,MapReduce/YARN负责计算,共同支撑大规模数据处理需求。
摘要:本研究基于Python、Spark和Hadoop大数据技术,结合Vue和Echarts前端框架,开发了上海租房信息可视化及价格预测系统。系统采用MySQL数据库,通过统计分析、聚类分析和机器学习算法,实现房源区域分析、交通便利性评估、特征分析、市场洞察和租金预测五大功能模块。该解决方案有效解决了传统租房信息不对称问题,为租房者提供科学决策支持,同时促进租房市场透明化,为行业数字化转型和政府决
本文介绍了基于大数据的国家医用耗材集采数据可视化分析系统,采用Hadoop+Spark架构处理海量数据,结合Django/Spring Boot后端与Vue+Echarts前端实现多维分析。系统支持产品特性、价格对比、竞争格局等深度挖掘,通过Spark SQL进行高效查询,为医疗采购、监管决策提供数据支撑。开发环境涵盖Python/Java语言技术栈,集成HDFS、Pandas等技术。系统界面展示
在基于Hadoop的电子图书推荐系统开发过程中,PyCharm 为 Python 代码编写提供了高效的工作环境,能够帮助开发者快速编写、调试和优化代码。实现都依赖于 PyCharm 提供的智能提示和代码自动完成功能。开发者可以通过 PyCharm 的调试工具实时跟踪代码执行过程,确保系统各个模块的逻辑正确性和性能优化。此外,PyCharm 强大的项目管理功能使得系统的多个功能模块能够高效地协作和管
你是否遇到过Hadoop作业"跑不完"的困境?比如:明明集群资源充足,作业却慢如蜗牛;或者某个Reduce任务卡住,导致整个作业延迟数小时?其实,Hadoop作业优化不是"黑魔法",而是针对核心环节的精准调整。本文结合5年大数据生产经验,总结了10个能立刻落地的实用技巧——从"整理仓库"(小文件处理)到"优化搬运"(Shuffle),从"分配工人"(资源配置)到"解决瓶颈"(数据倾斜),帮你把作业
当前微博舆情分析存在明显效率与洞察短板:微博日均产生海量用户内容(文本、图片、话题),传统分析工具难处理 TB 级数据,易遗漏关键舆情信息;人工筛选舆情话题耗时久,难实时捕捉热点爆发趋势,导致舆情响应滞后;舆情数据多以原始文本呈现,缺乏直观可视化(如情感倾向分布、地域传播热力图),非技术人员难快速识别舆情核心(如正面 / 负面占比、关键传播节点);同时,舆情分析多聚焦单一话题,难挖掘话题间关联(如
当前招聘市场存在明显数据处理与匹配短板:招聘平台日均产生海量数据(千万级简历、百万级岗位、用户行为记录),传统系统难承载 PB 级数据存储与计算,导致岗位与简历匹配延迟;现有推荐多依赖基础关键词(如学历、工作经验),未深度挖掘隐性需求(如求职者职业发展倾向、企业岗位隐性技能要求),匹配精准度低;HR 筛选简历需人工排查,面对海量候选人易遗漏优质人才,招聘效率低;同时,数据孤岛问题突出(简历数据、岗
计算机毕设选题推荐-计算机专业最头疼的大数据毕设:北京医保药品数据Hadoop+Spark分析系统完整实现路径想看其他类型的计算机毕业设计作品也可以和我说~都有~ 谢谢大家!有技术这一块问题大家可以评论区交流或者私我~开题、任务书、ppt、文献综述都可以找我私信我免费拿取!
当前短视频平台运营存在明显数据处理与决策短板:短视频短视频网站日均产生海量数据(用户行为、内容互动、流量分布),传统数据处理工具难承载 PB 级数据存储与计算,易出现分析延迟;运营方多依赖基础指标(播放量、点赞数),难深度挖掘用户偏好(如观看时段、内容类型偏好)、内容传播规律(如爆款视频特征),导致推荐精准度低、用户留存难;数据呈现以表格为主,缺乏直观可视化(如用户画像分布图、流量趋势图),非技术
基于Bilibili青少年模式数据分析系统简介 该系统是一个采用Hadoop+Spark架构的大数据处理平台,专门针对B站青少年模式使用情况进行分析。相比传统单机处理方式,性能提升达10倍以上。系统提供Python+Django和Java+SpringBoot两套后端方案,前端采用Vue+ElementUI框架,通过Echarts实现数据可视化。核心功能包括用户行为分析、使用时长统计、特征使用频率
大数据毕设必过选题:Hadoop+Spark驱动的食物营养可视化分析系统源码分享 毕业设计/选题推荐/深度学习/数据分析/机器学习/数据挖掘/随机森林
本研究设计实现了基于Hadoop的NBA球员数据分析系统,利用Hadoop分布式架构处理海量复杂赛事数据。系统通过多源数据采集、HDFS存储和MapReduce并行计算实现球员基础数据、比赛统计的高效处理,并配备可视化分析模块(图5-4)。测试表明系统性能稳定,显著提升了球员数据分析效率,为体育数据决策提供了新方案。
本文探讨了大数据时代下网站数据可视化在管理信息系统中的重要作用。以城市租房需求为例,分析了数据可视化系统对房源信息处理的优势,包括提升数据处理效率、优化决策支持等。研究对比了传统与大数据环境下的信息系统差异,从硬件优化、软件开发等角度阐述了爬虫实现数据可视化的技术价值。针对现存问题,提出了加强立法、完善反馈机制等建议,并展望了未来发展趋势。文章通过具体案例展示了大数技术在租房领域的应用前景。
本文探讨了大数据时代下网站数据可视化及其信息管理系统的开发与应用。以弹幕对影视创作影响分析为例,分析了数据可视化在管理信息系统中的意义,对比了传统与大数据环境下的系统差异,从硬件优化和软件开发角度阐述了爬虫技术的优势。研究提出了数据可视化建设的合理化建议,包括政策立法和信息反馈机制完善,并对未来发展进行了展望。
摘要:本文介绍了一个基于Spark的温布尔登网球赛事数据分析平台,该系统整合Hadoop、Spark等大数据技术,结合Python、Django和Vue.js实现全栈开发。平台提供赛事数据管理、可视化分析、机器学习预测等功能,支持对选手战绩、比赛统计等多维度数据进行深度挖掘。系统采用Spark SQL进行高效查询,运用随机森林等算法实现赛事预测,并通过Echarts实现数据可视化展示。文章包含平台
2026年企业最需要的大数据技能:学生考试表现影响因素数据可视化分析系统完美契合