登录社区云,与社区用户共同成长
邀请您加入社区
华为云码道(CodeArts AICoding)突破传统代码补全范式,定位为工程化AI编码智能体平台,具备项目级代码库理解、多智能体协同、双模开发及企业级部署能力。其核心优势在于千万行级代码库索引、规范驱动的Spec模式、MCP协议支持与沙箱安全,适用于老项目维护、团队协作与鸿蒙开发等复杂场景。相比Copilot、Cursor,码道更聚焦企业研发全流程,是向“AI研发执行者”演进的关键实践。
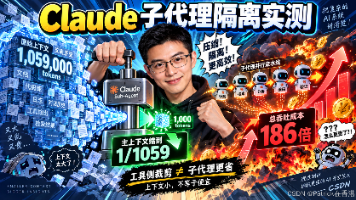
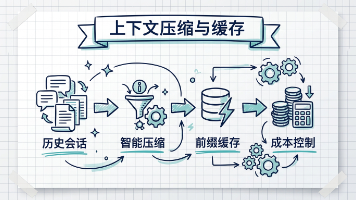
本文通过六个香港公开数据源,比较“全量回填”、工具裁剪、子代理隔离和截断裁剪四种上下文控制策略,发现主上下文压缩极大时,总代价仍可能更高。实测中,工具侧先裁剪事实,能把 3.26 MB 通关 CSV 压缩到 317 字节,而子代理隔离虽然主上下文不大,但总吞吐却贵 186 倍,说明“先裁剪而非先加代理”才是更优解。
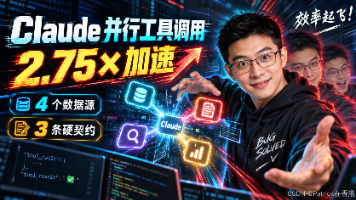
本文以 Claude 的多工具调用协议为核心,演示四个香港开放数据接口并发调用的执行器与回填契约。通过 `tool_result` 必须全量回填、必须在文本前、缺失调用必须补 `is_error`,作者验证了工具链如何在“错误后跟随 message_stop 之外”的状态边界中避免死等,并指出并发只有在无长尾接口时才会真正缩短总时延。
Claude Code 是 Anthropic 官方出品的终端编程智能体(Agentic Coding Agent),与 OpenAI Codex、GitHub Copilot CLI 同类定位,2025 年初发布后快速成为企业级 AI 编码工具的事实标准之一。它能读取代码库、规划多步任务、执行命令、编辑文件、运行测试、提交变更,并以可审计的方式与开发者协作。能力说明多通道模型接入。
Codex 是 OpenAI 开源的终端编程智能体(Agentic Coding Agent),以命令行工具(Codex CLI)和桌面应用(Codex App)两种形态交付。它不是一个"代码补全插件",而是一个能读取代码库、规划任务、执行命令、修改文件、运行测试、提交变更的自主执行体——与 Claude Code 同类定位。特性说明Rust 原生构建启动快、内存占用低,终端体验流畅完全开源代码透
GitHub 热榜项目`openai/skills`拥有 26.3k Star,作为 OpenAI 早期官方智能体技能库现已正式标记 Deprecated。本文基于固定快照`49f948f`静态源码评测,回溯旧 Skill 目录规范、拆解仓库内置`migrate‑to‑codex`迁移引擎,剖析旧散装 Skill 模式的工程瓶颈,理清与 Codex Plugin、MCP 协议之间的演进关系,给出企
问大模型“中芯国际一季度毛利率多少”?它只会一本正经地瞎编。我用 9 份真实财报研报,从零搓了一套 RAG 问答系统:FAISS+BM25 双路检索、RRF 融合、纯正则查询扩展、手写 300 行 ReAct Agent,最后封装成 MCP Server,让 Claude Desktop、GPT Researcher 即插即用调用私有知识库。全文含架构图和 6 个真实踩坑实录(OpenMP 冲突、
ClaudeCode标志AI编程从IDE插件向终端原生智能体跃迁,基于ReAct循环、Bash沙箱与上下文压缩实现自主闭环,并通过CLAUDE.md规范治理规避死循环风险,体现开发者从操作者转向架构师的范式变革。
文档 ──Embedding 模型──▶ 向量 ──向量数据库──▶ 检索 ──LLM──▶ 回答Embedding 模型:决定向量化质量,中文推荐 BGE-m3 / m3e-base向量数据库:决定存储和检索能力,本地开发用 Chroma,高性能用 FAISS,生产用 Milvus/Qdrant/PineconeLLM:决定生成质量,国内推荐 DeepSeek、Qwen;国外 OpenAI、Cl
在接入支持的主流大模型(如 GPT-4o、Claude 3.5、Qwen2.5)时,当用户提出一个复合型查询需求:“帮我查一下北京、上海、深圳三个城市明天的天气,并且查询从北京飞往深圳的最早一趟航班信息。大模型会在单次推理响应中,直接在tool_calls数组中一次性返回在很多缺乏高并发意识的后端实现中,代码依然用进行每个外部工具接口耗时 800ms,4 个工具顺序执行下来耗时高达!如果其中一个接
Xuelang API Gateway以统一OpenAI兼容接口,一个Key一套代码通调GPT-5.6、Claude Opus 5、Gemini 3.8、Grok 4.6、DeepSeek-V4、Kimi K3等500+文本及多模态模型,免去多平台对接烦恼。支持智能负载均衡、统一计费,入门极低,中文界面,兼容主流生态工具,3分钟即可接入。
本文基于 Python + Browser Use 实现一个处理浏览器业务的数字员工,让 Agent 使用持久化 Chrome 环境,根据自然语言任务完成订单、退款、库存等网页操作。相比直接使用 Codex,本方案更强调将 Browser Agent 嵌入自己的程序,自主管理模型、业务规则、任务和数据,针对具体岗位进行长期、专业化定制,并探讨其与 Playwright 的适用边界。
ContextGate 是一款静态分析工具,解决 AI 在 SpringBoot+MyBatis 项目中因 MyBatis-Plus 内置方法无 SQL 文本、注解约定、SQL 来源分散导致的调用链漏报问题。它支持 trace_call、find_sql、impact 等工具,自动标注事务边界、SQL 及路由影响面,可集成至 Cursor 等 AI 工具,开源且易用。
OpenAI发布GPT-6 Astra,在多项基准上取得领先,ARC-AGI-3达99.9%,但其宣称“全球最智能”存在口径问题:在OSWorld和Humanity's Last Exam上输给Claude,独立跑分排第三。厂商自报分数受脚手架和配置影响,应理性看待,用自测做决策。
换句话说,Skill 不只是「给 Claude 的知识」,它是给 Claude 的工具、记忆和行为约束体系的集合。组织层面,两个规模相同的团队,一个有 200 个高质量 Skill、一个只有 10 个,他们的 AI 协作效率差距可能不是 2 倍,而是 10 倍,而且是复利式、几乎不可见的差距。所以它不是给人看的简介,而是给模型看的「触发条件」。以往,一个高级工程师花两周搞清楚内部计费库的所有陷阱,
DeepSeek Harness 的插件体系是结构性的——连 Agent Loop 和会话日志都是插件,其他框架的插件是功能性的——在固定核心上扩展功能。这个差异决定了:如果你需要一个可以深度定制的 Agent 平台底座,dsh 是唯一选择;如果你只是需要一个能写代码的工具,Claude Code 和 Codex 目前更成熟。使用 Creator 模式,在运行时检查当前环境、实验 Cordis 插
本指南详细介绍如何使用Python微调大型语言模型(LLM),并通过Ollama在本地运行。文章从微调概念、原理、适用场景到完整实操流程(数据收集、环境设置、模型训练、本地部署)进行说明,使用Unsloth工具简化微调过程,帮助读者打造定制化AI模型解决特定任务,适合小白及程序员学习收藏。
基于Python的高校毕业生招聘信息推荐系统摘要 该系统采用Python+Django+Vue技术栈,结合协同过滤算法与数据爬虫技术,构建智能招聘信息推荐平台。核心功能包括:1)BOSS直聘数据爬取与清洗;2)基于用户行为的协同过滤推荐;3)Echarts可视化大屏展示就业市场多维度分析;4)完整的用户-企业-管理员三方交互体系。系统实现了招聘信息精准匹配、就业市场动态可视化、高效求职服务等功能,
系统主要功能包括用户功能、图书管理员功能和管理员功能。用户可以进行图书资讯、图书信息的点赞、收藏、借阅、购买、评论等操作,并可查询热门图书、购书信息及借还书信息。图书管理员管理图书信息、入库信息、购书信息、借阅信息和还书信息。管理员则具备更全面的权限,包括用户管理、图书信息管理、购书信息管理、借还书信息管理及热门图书管理等功能...
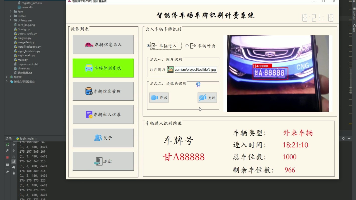
优秀毕业设计:python车牌识别计费管理系统 智能停车场 HyperLPR 中文车牌识别框架 OpenCV 深度学习 毕业设计(源码+文档)✅
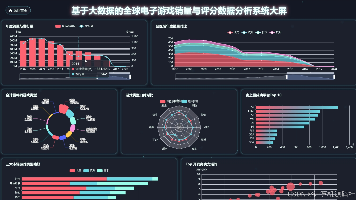
本文介绍了一个基于Hadoop+Spark的全球游戏评分与销量可视化分析系统,该系统通过整合游戏销量、用户评分等数据,利用大数据技术进行分析,为玩家提供个性化推荐,并为游戏开发商提供市场趋势分析。系统涵盖数据采集、处理、分析及可视化模块,采用Python、Spark等技术,结合Vue和Echarts实现直观的可视化界面。核心功能包括数据清洗、游戏类型评分分析等,旨在提升用户体验并支持行业决策。开发
计算机毕业设计:python车牌识别计费管理系统 智能停车场 HyperLPR 中文车牌识别框架 OpenCV 深度学习 毕业设计(源码+文档)✅
本文介绍了基于Hadoop+Spark的化妆品销售数据可视化分析与商品推荐系统。系统采用Python爬虫采集淘宝美妆数据,通过Hadoop进行分布式存储,利用Spark进行数据处理和协同过滤推荐算法建模。前端使用Vue+Echarts实现交互式可视化大屏,展示商品地域分布、价格区间、销量趋势等多维度分析结果。系统包含用户端(商品浏览、个性化推荐)和管理端(数据管理、可视化分析)功能模块,为电商运营
优秀毕业设计:python朴素贝叶斯垃圾邮件分类与检测系统 邮件分类检测 Flask框架 可视化 数据分析 机器学习 大数据毕业设计✅
大数据医疗成趋势:帕金森病可视化分析系统为何成毕设首选项目
本文介绍了张量核心技术的原理、应用以及如何实现发散创新的编程实践。通过学习和掌握张量基础,选择合适的编程语言和框架,实践项目驱动以及跟踪最新技术动态,我们可以更好地应用张量核心技术解决实际问题。例如,在图像识别领域,通过张量计算可以实现高效的特征提取和分类;以计算机视觉领域的图像分类任务为例,介绍如何运用张量核心技术实现发散创新。随着人工智能和大数据技术的飞速发展,张量计算已经成为了众多领域的关键
计算机毕设选题太普通?基于Hadoop+Django的食物营养数据可视化分析系统让你脱颖而出毕业设计/选题推荐/深度学习/数据分析/机器学习/数据挖掘/随机森林
本文介绍了一个基于Spark的全球电子商务供应链数据分析系统,旨在通过大数据技术优化供应链管理。系统整合了销售分析、库存健康评估、市场趋势预测等功能模块,采用Python、Spark、Hadoop等技术处理海量数据,并提供可视化大屏辅助决策。开发者具有8年全栈经验,涵盖Java、Python等多种技术栈,提供源码支持和技术交流。系统通过实时数据分析帮助企业降低库存成本、提升响应速度,适用于电子商务
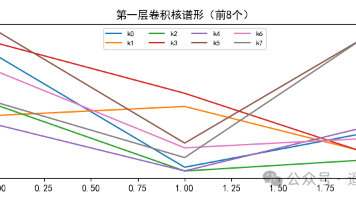
本文探讨高光谱分类中CNN模型的可解释性问题。通过类激活图(CAM)和通道注意力可视化方法,揭示了CNN内部工作机制。实验在KSC数据集上进行,采用1DCNN模型,并展示多种可视化技术:混淆矩阵分析错误分类模式、整图预测验证空间泛化能力、卷积核谱形可视化展示特征提取机制、通道重要性评估识别关键特征维度。这些方法使CNN从"黑箱"转变为可解释模型,帮助理解其决策依据。实验代码完整
机器学习——梯度增强特征选择GBFS
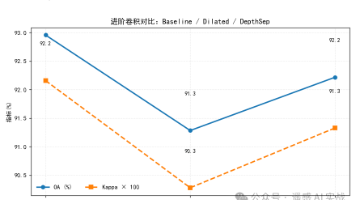
研究对比了空洞卷积和深度可分离卷积在1D高光谱分类中的效果。空洞卷积通过间隔采样扩大感受野,深度可分离卷积将标准卷积拆分为逐通道和点卷积,显著降低参数量。实验在KSC数据集上对比了三种1D-CNN模型:标准卷积、空洞卷积和深度可分离卷积。结果表明,空洞卷积在AA/Kappa指标上更稳定,深度可分离卷积计算效率更高,但基础卷积在特定情况下仍可能表现最佳。研究建议将这些结构作为可选基线进行对比,并提出
Spark毕业设计项目:校园霸凌数据分析系统大数据处理与可视化展示技术详解
本文深入探讨了Web容器的技术原理和创新应用,通过实践案例展示了如何使用Docker和Kubernetes构建Web应用。Web容器作为现代Web应用的核心组成部分,为Web应用提供了一个运行和管理的环境。通过将应用拆分成多个独立的微服务,每个微服务运行在自己的容器中,提高了应用的扩展性和可维护性。利用Web容器的动态扩展功能,可以根据应用的负载情况自动调整容器的数量,实现负载均衡,提高系统的性能
GitHub高星标项目:基于大数据的心理健康分析系统Hadoop+Spark完整实现