Claude 子代理隔离实测:主上下文缩到 1/1059,总吞吐反而贵 186 倍
文章目录
1. 先说结论
我拿六个真实的香港公开数据源,把同一个任务跑在四种 Agent 编排上,分别量「上下文占多大」和「整体贵多少」:
| 问题 | 实测结果 |
|---|---|
| 六个数据源原样塞进上下文,共有多少? | 3,588,257 字节,其中一个是 3.26 MB 的政府 CSV |
| 只留「回答问题必需的事实」呢? | 1,218 字节,合计压掉 2,946 倍;最大的那一处压掉 10,287 倍 |
| 改让子代理去读大文件,是不是更划算? | 不是。子代理的主上下文和「工具自己裁剪」一样小(都是 3,389 字节),但全流程上下文吞吐贵 186 倍 |
一句话:「上下文爆了」的第一解法是让工具在返回前先裁剪,不是加子代理。子代理只是把「读全文」的成本从代码侧搬到了模型侧。
2. 两种代价,先定义清楚
不然后面对不起来。
- 主上下文终态:最后一次请求时,上下文里一共有多少字节。它决定塞不塞得进窗口。
- 全流程上下文吞吐:每一轮请求都要把已有对话整段重发,所以把每轮的上下文体积加起来才是账单。它决定贵不贵。
这两个量经常被混为一谈,而它们的最优解恰好不是同一个。
def size_utf8(s):
    """本文的统一口径:UTF-8 字节数。完全客观,随手可复现。"""
    return len(s.encode("utf-8"))

def estimate_tokens(s):
    """CJK 感知粗估:CJK/全角字符约 1 token,其余约 4 字符 1 token。

    ⚠️ 这是估算口径,不是任何一家 tokenizer 的实测值。
    本文结论都建立在「比率」上,第 3 节给出三种口径的对照。
    """
    cjk = sum(1 for ch in s
              if "\u2e80" <= ch <= "\u9fff" or "\uff00" <= ch <= "\uffef")
    return cjk + round((len(s) - cjk) / 4)

def ledger(brief, items):
    """items = [(数据源, 字节)],第 i 项是第 i 次工具来回填进主上下文的东西。

    返回主上下文终态,以及全流程上下文吞吐。
    """
    ctx = BASE + size_utf8(brief)
    cum = 0
    for _, b in items:
        ctx += b
        cum += ctx
    cum += ctx          # 最后一次「总结作答」的请求
    return {"main_context_final": ctx, "cumulative_throughput": cum,
            "rounds": len(items) + 1}
BASE 是任务简报加系统提示的固定开销,按真实提示词量级取 2,000 字节。
3. 发现一:3.26 MB 的 CSV 里,只有 317 字节和问题有关
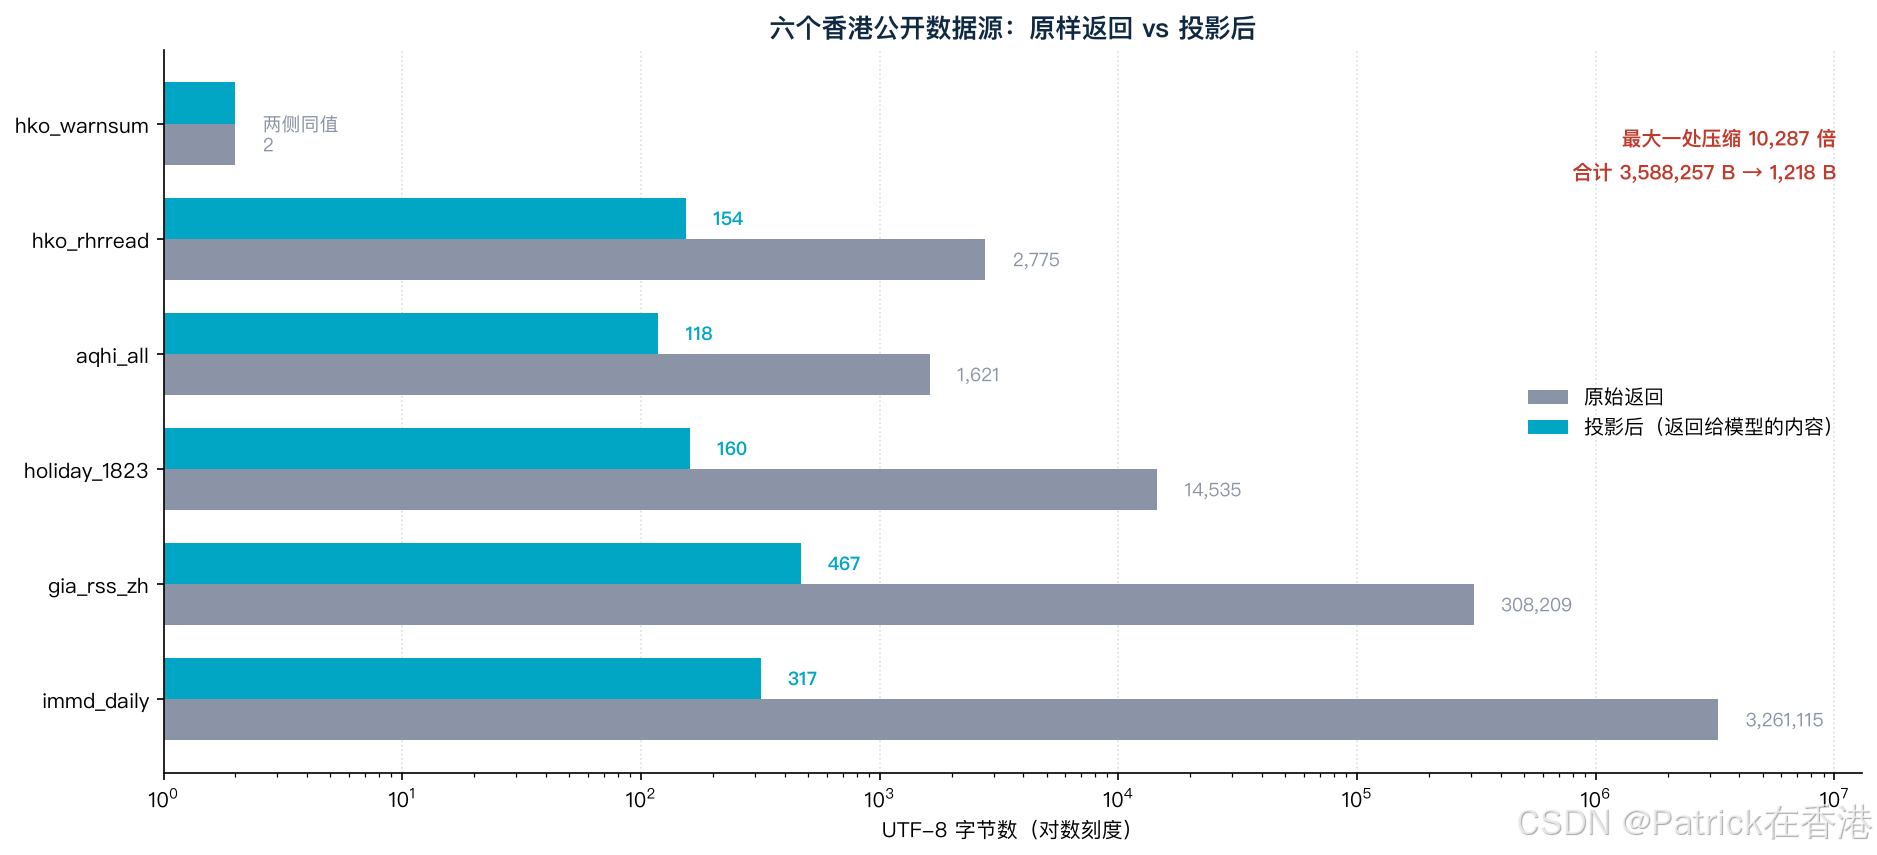
六个源原样返回的体积跨了 6 个数量级(2 字节到 3,261,115 字节):
| 数据源 | 原样返回 | 只留事实 | 压缩倍数 |
|---|---|---|---|
| 天文台 警告一览 | 2 B | 2 B | 1×(太小,不做裁剪) |
| 环保署 AQHI 18 站 | 1,621 B | 118 B | 13.7× |
| 天文台 本港天气报告 | 2,775 B | 154 B | 18.0× |
| 1823 公众假期 51 条 | 14,535 B | 160 B | 90.8× |
| 政府新闻公报 100 条 | 308,209 B | 467 B | 660× |
| 入境处 逐日通关 CSV | 3,261,115 B | 317 B | 10,287× |
换另外两种口径量同一处,绝对值差十倍以上,比值几乎不动:
| 口径 | 原样 | 只留事实 | 倍数 |
|---|---|---|---|
| UTF-8 字节数 | 3,261,115 | 317 | 10,287× |
| Unicode 码点数 | 3,261,113 | 317 | 10,287× |
| token 估算(CJK 感知) | 815,278 | 79 | 10,320× |
所以本文的结论只报比值——比值对口径不敏感,绝对值不是。
最大那一处是入境处那份通关 CSV:61,744 行、17 个口岸、从 2021-01-01 一路铺到 2026-09-14。而问题只问「9 月 14 日」——那一天只有 28 行。
逐行扫下来,它还有三处结构冗余:
- 1 个恒空列:表头第 8 列是空字符串,61,744 行全部为空;
- 3 个零方差口岸:Hung Hom / Sha Tau Kok / Tuen Mun Ferry Terminal,历史累计通关量恒为 0;
Total恒等于三列之和:前 5,000 行抽检,0 例外——它是可现算的派生列。
这三处加起来,没有一个字节在提供信息。裁剪之后,那份 3.26 MB 的返回变成这样:
{"date": "14-09-2026",
 "major_ports": {"Lo Wu": {"arrival": 99722, "departure": 94141},
                 "Lok Ma Chau Spur Line": {"arrival": 81572, "departure": 75144},
                 "Shenzhen Bay": {"arrival": 64941, "departure": 58345},
                 "Airport": {"arrival": 59695, "departure": 51357}},
 "grand_total": {"arrival": 458678, "departure": 411005}}
这一段建议收藏:把「原样返回多大 / 只剩事实多大」列成一张表,是判断一条 Agent 管线值不值得优化的最快方式。
4. 发现二:主上下文小,不等于便宜
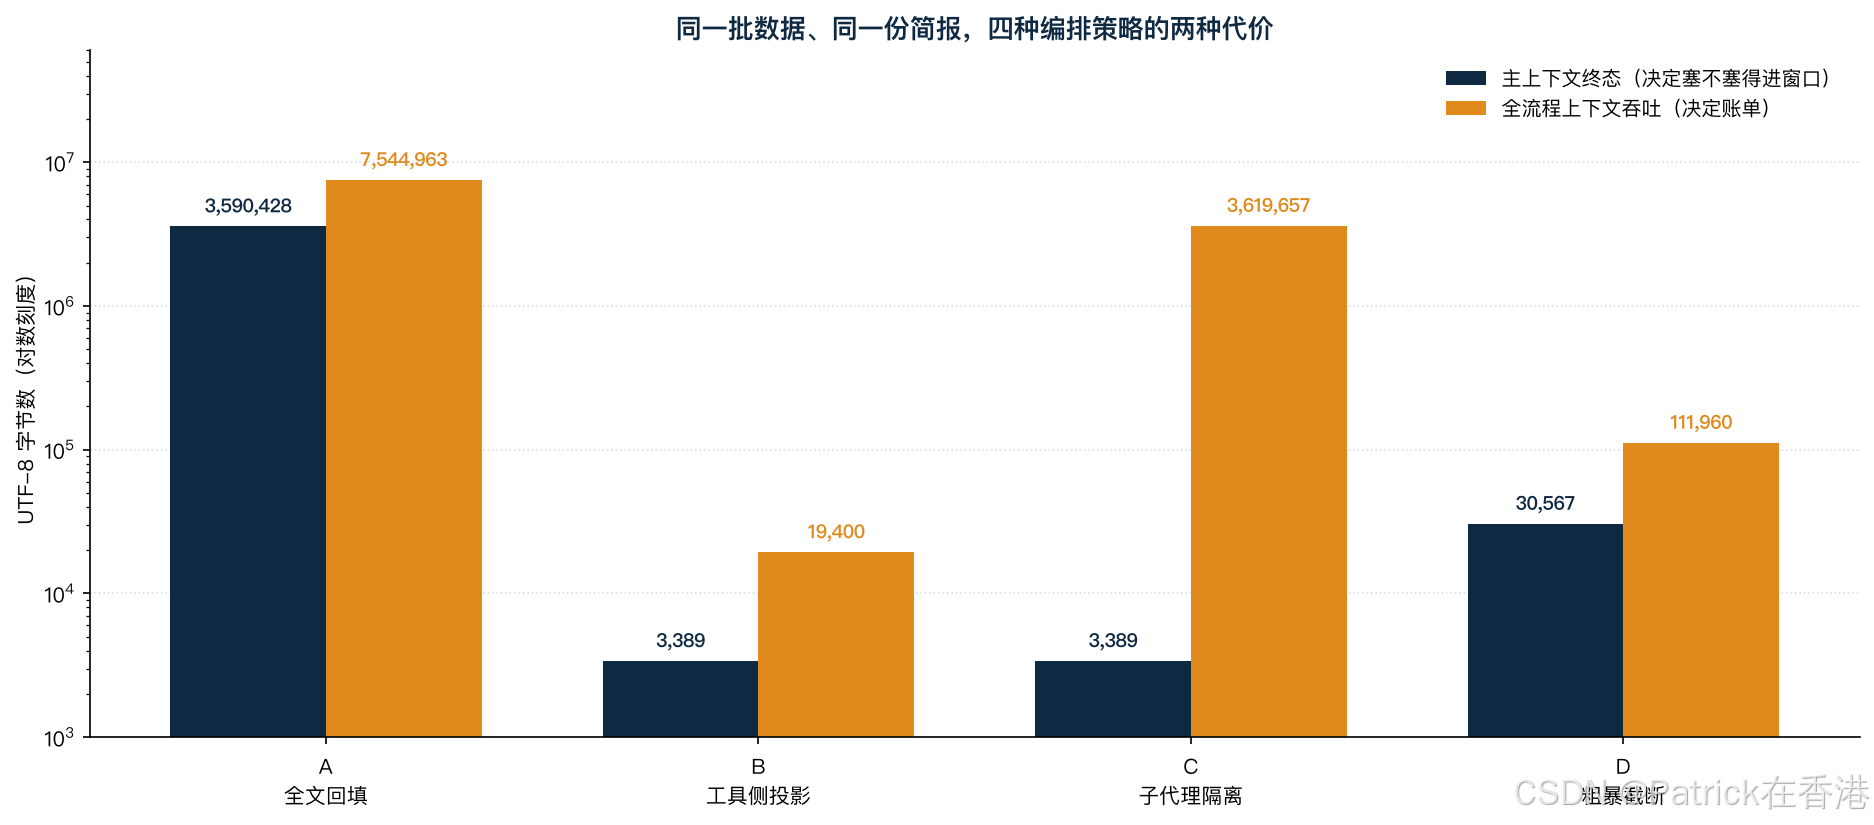
| 策略 | 主上下文终态 | 全流程吞吐 | 轮次 |
|---|---|---|---|
| A 全文回填 | 3,590,428 B | 7,544,963 B | 7 |
| B 工具侧裁剪 | 3,389 B | 19,400 B | 7 |
| C 子代理隔离 | 3,389 B | 3,619,657 B | 13 |
| D 粗暴截断 | 30,567 B | 111,960 B | 7 |
三个数字最能说明问题。
① A 对 B:主上下文差 1,059 倍,吞吐差 389 倍。 同一个任务、同一份数据,只换了个「谁在读全文」。区别在于:工具侧裁剪时,读那 3.26 MB 的是代码;全文回填时,读它的是模型。
② B 和 C 的主上下文一模一样,都是 3,389 字节,但 C 的吞吐是 B 的 186 倍。 原因很直白:子代理要读全文,而读全文需要一次模型调用,那次调用的上下文里装着原始返回。六个源就是六次这样的调用,多花掉 3,600,257 字节。
子代理并没有让「读全文」这件事消失,它只是换了个地方发生。 如果工具本来就能自己裁剪,子代理在这里是纯开销。
③ D 的主上下文只有 30,567 字节,看起来比 A 安全上百倍——但它是错的。 下一节。
5. 发现三:截断不是裁剪,是按位置丢
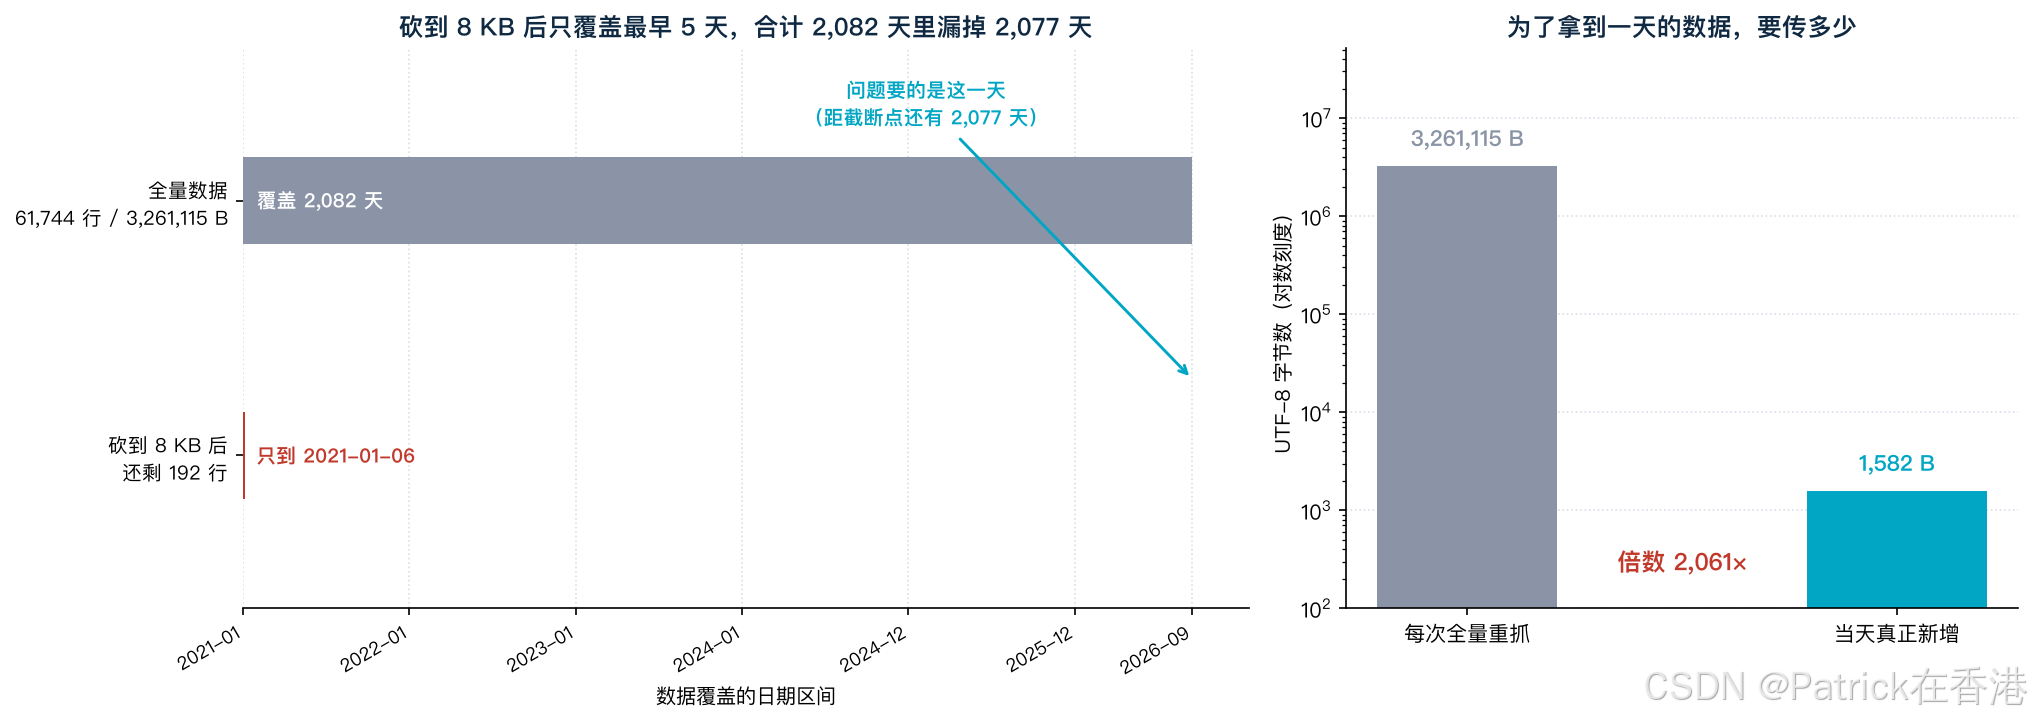
最常见的「上下文保护」是给工具结果设一个上限,超了就砍掉后半段。我按 8 KB 砍那一份通关 CSV:
全量      3,261,115 字节   61,744 行
砍到 8 KB 后              只剩 192 行
最后一行可见数据           06-01-2021,Lo Wu,Departure,0,0,0,0
覆盖区间从「2021-01-01 ~ 2026-09-14」缩成了「2021-01-01 ~ 2021-01-06」——5 天。问题要的那一天,在 2,077 天之外。
更麻烦的是它不会报错。上下文里有数据、格式合法、每个数字都是真的,模型没有任何理由说「我不知道」。而它拿到的事实是「罗湖口岸出境 0 人」——2021 年初正是封关期,这个数当时是对的,放到今天完全错。
截断的问题不在于「截了多少」,而在于「截掉的是哪一段」由数据排列顺序决定,而排列顺序通常和问题无关。 越是按时间正序堆积的官方数据集,这个坑越深。
def truncate_loss(raw, cap=8_000):
    """截断之后,模型到底还能看到什么?——报出最后一行可见数据。"""
    b = raw.encode("utf-8")[:cap]
    tr = b.decode("utf-8", errors="ignore")
    lines = [l for l in tr.splitlines() if l.strip()]
    return {"kept_bytes": size_utf8(tr),
            "last_visible_row": lines[-1][:120] if lines else "",
            "covers_target_date": target_date in tr}
这段「截断损失自查」建议收藏:不报错、只丢数据,是 Agent 最难排查的一类故障。
6. 裁剪规则怎么写
投影的目标不是「变小」,是「只留回答问题必需的事实」。所以规则要和问题一起设计,而不是和数据一起。
MIN_PROJECT = 400   # 小于这个体积的响应,投影不划算,原样返回

def project(name, raw):
    """返回给模型的内容:低于阈值就直接给原文,否则只给事实。"""
    if size_utf8(raw) <= MIN_PROJECT:
        return raw, "原样"
    return PROJECTORS[name](raw), "投影"

def p_immd(raw):
    """61,744 行 CSV 只留「最后一天」的 4 个主要口岸 + 全港合计。"""
    rows = list(csv.DictReader(io.StringIO(raw.lstrip("\ufeff"))))
    last = rows[-1]["Date"]                    # 数据按日期正序,末日即最新
    keep = ["Lo Wu", "Lok Ma Chau Spur Line", "Shenzhen Bay", "Airport"]
    out, grand = {}, {"arrival": 0, "departure": 0}
    for r in rows:
        if r["Date"] != last:
            continue
        tot = int(r["Total"] or 0)
        side = r["Arrival / Departure"].lower()
        grand["arrival" if side == "arrival" else "departure"] += tot
        if r["Control Point"] in keep:
            out.setdefault(r["Control Point"], {})[side] = tot
    return json.dumps({"date": last, "major_ports": out,
                       "grand_total": grand}, ensure_ascii=False)
四个设计点:
① 阈值先行。 2 字节的 warnsum 原样返回就是最优解——为它跑一遍解析再序列化,只会更大更慢。「所有工具都要裁剪」是另一种浪费。
② 裁剪位置放在工具里面,不放在提示词里。 让模型「自己注意别读太多」属于不可执行的约束;工具返回值是代码生成的,那里才是能保证唯一性的地方。
③ 保留额度和问题同源。 这里保留「最后一天 + 4 个主要口岸」,是因为问题问的是昨天、且只关心主要通道。问题一换,keep 列表就得跟着换——投影规则是问题的一部分,不是数据的一部分。
④ 丢掉的是可现算的、不可变的、恒定为零的。 Total 可以现算、恒空列没有内容、零方差口岸永远是 0。这三类丢掉不损失任何信息,这是投影能做到 10,287 倍还不丢事实的原因。
7. 子代理到底什么时候才值得
上面② 的结论是「工具能裁剪时,子代理是纯开销」。以下几种情况它会翻过来:
| 场景 | 为什么子代理有用 |
|---|---|
| 工具改不动 | 第三方托管的远程工具,返回什么由对方决定,本地只能包一层 |
| 子代理需要多步推理 | 要读完文件再算、再查、再比对,这些中间步骤不该进主上下文 |
| 原始内容要留着追问 | 主上下文里只放结论,原文留在子代理侧,需要时再问 |
代价也是三个,且都是可量化的:吞吐按「读全文的次数」线性增长(本例 186 倍)、轮次翻倍以上(7 → 13)、端到端延迟等于串行子任务之和。
所以判断顺序是:先问「工具的返回值能不能裁」,能裁就先裁;裁不动、或者子任务本身需要多步推理,再上子代理。
8. 踩坑清单与结论
| 坑 | 现象 | 处理 |
|---|---|---|
| 只盯主上下文大小 | 子代理把主上下文压到 3,389 B,吞吐却贵 186 倍 | 两个量一起量 |
| 拿截断当裁剪 | 8 KB 上限把 5.8 年砍成 5 天,且不报错 | 按字段裁,不按位置裁 |
| 所有工具统一加裁剪 | 2 字节的响应被「裁剪」到更大 | 设阈值,小的原样返回 |
| 假定每列都携带信息 | 恒空列、派生列、零方差口岸合计占掉大量字节 | 先做一次列级冗余审计 |
| 让模型自己控制读多少 | 提示词里的约束无法保证执行 | 把裁剪写进工具返回路径 |
| 裁剪规则与问题脱钩 | 问题一换,保留字段就全错 | 规则和问题一起设计 |
三条:
- 上下文优化的第一顺位是「工具返回什么」,不是「用几个代理」。 代码裁剪一份 3.26 MB 的 CSV 是零成本操作,让模型读它是高价操作。
- 主上下文和总吞吐要分开看。 前者决定能不能跑,后者决定值不值得跑;一个策略可以同时把前者做对、把后者做坏。
- 静默丢数据比报错更难查。 截断后的上下文一切正常,只是内容偏了五年——所以裁剪必须按语义做,并且要能自证「我保住的是哪一段」。
可复用的三块:体积口径 size_utf8 + estimate_tokens、上下文账本 ledger、截断损失自查 truncate_loss。这套量法不挑数据源,换任何一批工具返回值都能直接套——如果这篇对你有用,收藏 + 点赞,下次给 Agent 加缓存、加摘要、加子代理之前,先拿这三个函数量一遍再动手。
9. 参考链接
- https://www.data.gov.hk/en-data/api/3/action/package_search
- https://www.immd.gov.hk/opendata/eng/transport/immigration_clearance/statistics_on_daily_passenger_traffic.csv
- https://data.weather.gov.hk/weatherAPI/opendata/weather.php?dataType=rhrread&lang=tc
原创声明:本文为原创技术实践。六个数据源均为 2026-09-15 的真实接口采集(入境处 CSV 覆盖 2021-01-01 ~ 2026-09-14,当日 61,744 行),体积口径为 UTF-8 字节数。文中
estimate_tokens是估算口径而非任何一家 tokenizer 的实测值,结论均以比率给出并在三种口径下交叉验证。接口字段、数据量与更新节奏可能随官方调整而变化,请以自测数据为准。
香港公开数据的实测会继续更新,关注不迷路。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)