登录社区云,与社区用户共同成长
邀请您加入社区
基于Python的高校毕业生招聘信息推荐系统摘要 该系统采用Python+Django+Vue技术栈,结合协同过滤算法与数据爬虫技术,构建智能招聘信息推荐平台。核心功能包括:1)BOSS直聘数据爬取与清洗;2)基于用户行为的协同过滤推荐;3)Echarts可视化大屏展示就业市场多维度分析;4)完整的用户-企业-管理员三方交互体系。系统实现了招聘信息精准匹配、就业市场动态可视化、高效求职服务等功能,
本文提出一个基于大数据技术的脱发风险预测系统。系统采用Python3.8+Spark3.0+Hadoop3.2技术栈构建,包含数据采集、清洗、建模和可视化全流程。通过随机森林算法分析人口统计、生活习惯、医疗状况等多维特征,建立个性化预测模型。前端采用Vue2.6+Echarts5.0实现交互式可视化,后端使用Django3.2提供RESTful API。系统可处理10万条模拟数据,支持风险等级预测
近年来,人工智能领域已经取得突破性进展,对经济社会各个领域都产生了重大影响,结合了统计学、数据科学和计算机科学的机器学习是人工智能的主流方向之一,目前也在飞快的融入计量经济学研究。在本次培训中,我们将从论文写作的实际需求出发,首先简单的介绍经济学的基本理论与研究方法,让您了解论文的选题方法与写作框架。随后重点从数据的收集与清洗、综合建模评价、数据的分析与可视化、数据的空间效应、因果推断等方面入手,
本研究基于中国健康与退休追踪调查(CHARLS)数据,采用机器学习方法构建帕金森病诊断模型。研究通过比较不同变量数量下随机森林模型的预测性能,发现10个变量时模型表现最优(AUC=0.85)。方法学上,研究采用训练集(70%)和测试集(30%)划分,评估了包括敏感性、特异性在内的13项指标。研究创新性地展示了变量数量与模型性能的关系,为社区帕金森病筛查提供了高效的特征选择方案。复现结果表明,该方法
文章摘要 本文系统介绍了集成学习的核心方法与应用实践。首先探讨了投票分类器的集体决策机制,包括硬投票和软投票的区别。其次解析了Bagging/Pasting通过数据采样创造多样性的原理,重点讲解了OOB评估这一实用技巧。随后深入剖析了随机森林的双重随机性设计及其特征重要性评估能力,并对比了极端随机树的特性。最后阐述了提升法的递进优化思想,比较了AdaBoost的样本加权策略与梯度提升的残差拟合方法
本文介绍了四种机器学习算法:1. 随机森林、 XGBoost、K均值算法、异常检测
摘要 本研究基于美国人口普查局的加州房价数据集(20,640个样本),通过机器学习方法分析房价驱动因素。采用IQR法处理异常值,创新构造RoomsPerPerson特征(相关系数0.48),结合PCA降维(保留95%方差)优化特征空间。运用岭回归、随机森林、神经网络和KNN建模,随机森林表现最佳(R²=0.736,MAE=0.392)。研究发现:经济因素(收入中位数贡献64.7%)主导房价,地理空
集成方法(ensemble methods)是机器学习(ML)中最强大的方法之一——仅次于深度神经网络——通过组合多个模型来解决同一预测任务,从而有效应对复杂数据驱动的复杂问题。本文将介绍构建集成模型的三种常见方式:提升(boosting)、装袋(bagging)和堆叠(stacking)。
本文深入探讨了基于树的建模技术,使用 Ames Housing 数据集作为示例。从基础的数据预处理开始,包括类别转换、缺失值处理和编码方法,然后逐步评估并改进决策树模型,最终引入 Bagging 和随机森林的集成方法进行比较分析。文章通过实例演示了随着树的数量变化,模型性能的增量改善与差异,为读者提供了完整的树模型预测建模理解框架。
✅ 毕业设计:Python薪资预测系统 Flask+随机森林+拉勾网爬虫 招聘数据分析 求职分析 大数据 毕业设计(附源码)✅
本系统设计与实现了一个基于协同过滤算法的农产品分析推荐系统,旨在为用户提供个性化的农产品推荐服务。用户功能模块包括商品浏览、智能推荐和数据分析,方便用户了解农产品信息、获取个性化推荐以及分析市场趋势。通过本系统的设计与实现,不仅提高了用户获取农产品的效率和满意度,还为农产品销售商提供了有力的数据分析工具。系统的应用将促进农产品市场的信息化和智能化发展,具有重要的社会效益和经济效益。未来,系统将进一
随着我国城市化进程的加快,城市交通拥堵问题日益严重,因此,构建一个高效、实时的城市交通流量分析及可视化系统设计与实现具有重要的现实意义。基于此,本文以Django为框架,设计并实现了一套城市交通流量分析及可视化系统设计与实现。本文的主要内容包括:首先,对城市交通流量数据进行预处理,包括数据清洗、数据整合和特征工程;其次,采用机器学习算法构建城市交通流量分析模型,并通过模型评估指标对模型进行优化;最
本研究设计并实现了一个基于随机森林算法的视频用户点击行为预测模型,旨在通过分析用户的历史行为数据来预测其未来的点击行为。该模型包含一个数据分析系统,提供了数据概览、数据可视化、随机森林预测、高级分析以及个人信息等功能模块。数据概览模块展示了用户行为数据的基本统计信息,帮助用户快速了解数据集的整体情况。数据可视化模块则通过图表和图形的方式直观地呈现了用户行为数据的分布和趋势,使用户能够更直观地理解数
【机器学习与实战】分类与聚类算法:Bagging和随机森林
本文深入分析了随机森林、支持向量机和人工神经网络在水泵故障控制中的性能表现,结果显示随机森林模型在准确率和训练效率之间取得了最佳平衡。同时,文章全面介绍了LoRa/LoRaWAN技术的原理、架构、安全机制及应用模式,探讨了其在智能农业、智慧城市和工业物联网等领域的广泛应用。结合机器学习与LoRa/LoRaWAN技术,展示了二者在推动各行业数字化转型中的巨大潜力和发展前景。
文章介绍了一个完整的股票开盘价预测案例,通过集成Transformer和随机森林模型,利用Transformer捕捉时序依赖的能力和随机森林的稳健集成优势构建预测模型。文章详细展示了从数据准备、模型定义训练到结果可视化的完整流程,为金融时序预测提供了实用参考。
【摘要】本项目基于Python技术栈开发股票分析预测系统,采用Flask框架+MySQL+ECharts构建。核心功能包括:1)股票成交量/成交额可视化分析;2)K线价格走势展示;3)换手率活跃度分析;4)基于随机森林算法的股价预测(含置信区间分析);5)用户个人中心及注册登录模块。系统通过Python处理数据、Scikit-learn构建预测模型,结合ECharts实现动态可视化,MySQL存储
机器学习实战:Python天池二手车数据分析预测项目 随机森林预测+多维度可视化 Django框架 (源码)✅
K值取很小:容易受异常点影响K值取很大,容易受K值数量(类别)波动fit(X, y)—— 训练(存储数据)作用:把训练集的特征值X和目标值y“喂”进模型。KNN 的特殊性:它不像逻辑回归、神经网络那样需要学习参数。fit本质上只是 把训练数据存起来,后续预测时用。所以fit在 KNN 里非常快。相当于告诉模型:训练集中这些样本(X_train)对应的类别是这些(y_train)。predict(X
本文介绍了一个基于Python与大数据的Boss直聘数据分析可视化系统。针对传统招聘平台存在的数据碎片化、分析维度浅等问题,系统采用Scrapy爬虫采集多维度招聘数据,通过PySpark处理数据并集成随机森林算法构建岗位匹配模型(准确率≥91%)和薪资预测模型。系统使用MySQL+MongoDB存储数据,借助Plotly+ECharts实现动态可视化,并通过Flask搭建Web界面。测试显示,系统
摘要 本文介绍了一个基于机器学习的就业岗位推荐系统,采用Python、Django框架、MySQL数据库等技术实现。系统整合了爬虫(Boss直聘数据)、随机森林回归算法、人脸识别、智能推荐和Echarts可视化等核心功能模块,为用户提供个性化的职位推荐服务。开发环境包含Python技术栈、Vue.js前端框架和机器学习算法。系统通过数据爬取、存储、分析和预测,实现了从传统人工筛选到智能化推荐的转变
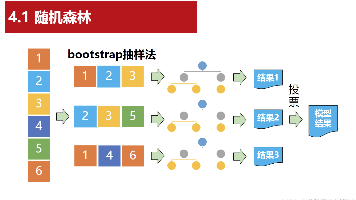
本文介绍了随机森林模型的核心原理与应用。针对单棵决策树易过拟合、稳定性差的问题,随机森林通过Bootstrap抽样生成多样化训练集,结合多棵决策树的投票机制实现"群体智慧",显著提升泛化能力。文章详细解析了随机森林的两大关键技术:Bootstrap抽样保证树的多样性,投票机制整合多树结果。实践部分提供了Python代码模板,涵盖数据预处理、模型训练、参数调优和可视化分析,特别适
本文介绍了一个基于机器学习的程序员简历智能筛选系统项目。该项目使用Python 3.8开发环境,采用Flask框架和随机森林算法实现,主要功能是通过上传图片进行简历筛选,识别符合要求的候选人。虽然该项目在工作环境中使用较少,但作为编程入门练习,适合初学者参考学习。项目已在PyCharm开发工具中调试通过,确保能够正常运行,并附有项目截图供参考。
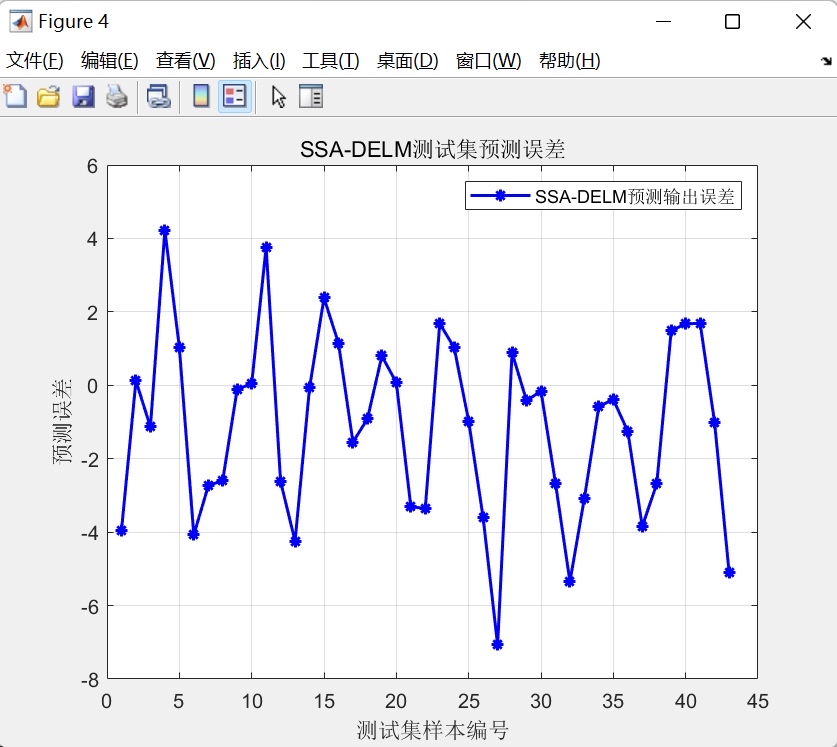
麻雀优化算法是一种群智能优化算法,灵感来源于麻雀的觅食行为。它主要包括觅食(探索)、报警(避免危险)和跟随(学习邻居)三个主要行为。简单来说,麻雀会根据当前食物的丰裕程度调整自己的觅食策略,同时还会警惕周围的危险,保持群体的安全。这些行为被模型化之后,可以用来解决各种优化问题。参数少,实现简单。适用于复杂非线性优化问题。具有较强的全局搜索能力。深度学习机(DELM)是一种基于多层感知机(MLP)的
机器学习算法的底层实现是理解人工智能技术的关键路径。通过手动实现反向传播、决策树等基础算法,开发者能够深入掌握梯度下降、信息增益等核心数学原理。这种实践方式不仅能培养对模型调试的直觉,还能在面对特征工程优化、损失函数定制等工程挑战时提供灵活解决方案。以随机森林和SVM为例,从零开始实现可以帮助理解集成学习中OOB误差评估和核函数选择的本质差异。对于希望进阶的工程师,建议从线性回归、KNN等基础模型
本文详细介绍了如何使用Python中的网格搜索优化随机森林回归模型来预测空气质量。通过数据准备、特征工程、网格搜索参数调优及模型评估等步骤,提升预测准确率。文章还分享了实战经验与进阶优化技巧,帮助开发者高效应用随机森林算法解决环境数据分析问题。
本文介绍了使用随机森林填补缺失值的智能数据清洗技巧,相比传统的SimpleImputer方法,随机森林能更好地保留数据内在结构和特征关联。通过sklearn实战演示,详细解析了随机森林填补的原理、工程实现及性能优化策略,帮助数据科学家提升数据预处理质量,优化下游模型性能。
本文介绍了如何使用BayesianOptimization库高效调参随机森林模型,替代传统的网格搜索方法。通过贝叶斯优化技术,仅需5分钟即可显著提升模型性能,节省大量计算资源和时间。文章包含完整代码示例和实战经验,帮助开发者快速掌握这一高效调参工具。
机器学习建模中,算法优化与模型可解释性是提升预测性能的关键。随机森林(RF)作为经典的集成学习算法,其超参数选择直接影响模型表现。通过麻雀搜索算法(SSA)优化RF的关键参数,如树的数量和最大深度,可以显著提升模型精度。SSA模拟麻雀群体的觅食行为,通过发现者、跟随者和警戒者的协同机制实现高效参数搜索。结合SHAP值分析,不仅能提升模型性能15%-30%,还能深入理解特征贡献度。这套方法特别适用于