登录社区云,与社区用户共同成长
邀请您加入社区
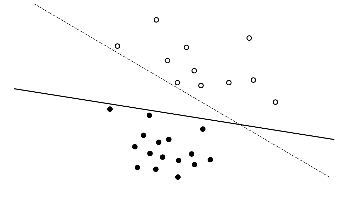
本文介绍了统计机器学习中的岭回归和感知机方法。岭回归通过引入L2范数惩罚项解决了线性回归中多重共线性导致的矩阵不可逆问题,推导了其闭式解。感知机则是一种线性分类器,通过定义误分类点距离损失函数,并采用随机梯度下降进行优化。文章详细阐述了两种方法的数学原理、损失函数设计及优化过程,特别强调了岭回归中惩罚参数λ的作用和感知机中损失函数的推导思路。
在验证机器学习模型时,需要在未见过的数据上进行严格测试,以确保其性能评估的稳健性和无偏性。其中最成熟的验证方法之一是交叉验证(cross-validation),它将数据集划分为若干个子集(称为折叠 folds),并在其中一部分上进行训练,同时在剩余部分上进行测试,迭代进行。虽然 scikit-learn 提供了标准组件和函数来执行传统方式的交叉验证,但仍有一些额外技巧可以让整个过程更高效、更有洞
Scikit-learn是Python核心机器学习库,提供六大功能模块:分类(如SVM、随机森林)、回归(如SVR、Lasso回归)、聚类(如K-means)、数据降维(如PCA)、模型选择(参数调优)和数据预处理(特征归一化)。通过鸢尾花数据集案例,演示了KNN分类器的完整使用流程,包括数据划分、模型训练(97.8%准确率)和预测验证。该库以算法丰富、接口统一著称,后续将结合具体任务展开实战应用
Scikit-learn Python机器学习 - 分类算法 - 线性模型 逻辑回归
Pipeline 可能是 scikit-learn 中最被低估但同时最强大的功能之一,它能帮助构建高效、模块化的机器学习工作流。从数据准备、特征工程到建模、调优和验证,它简化了整个过程,同时降低数据泄漏风险,使代码更具可复现性,也更简洁易维护。在本文中,我们将通过简洁但偏中高级的用例,介绍并演示五个 pipeline 技巧,帮助你提升正在进行的机器学习项目。
机器学习也借鉴了人类学习模式,分为有监督学习(如识别物体)、无监督学习(无监督学习就像是让计算机自己在一堆杂乱的数据里找规律、做分类,不需要人提前告诉它 “答案”。从定义看,对于给定任务 T,在合理性能度量方案 P 下,计算机程序可自主学习任务 T 的经验 E,且随着优质、大量经验 E 的积累,程序对任务 T 的性能会逐步提升。机器学习的运作,依赖计算机系统依据训练数据按特定方式学习,随着训练次数
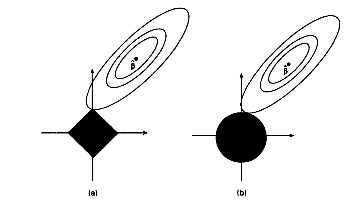
本文介绍了LASSO方法在高维小样本数据中的变量选择应用。文章首先阐述了高维小样本问题的背景和线性回归系数的解释意义,指出变量选择需要通过压缩不重要特征的系数来实现。针对直接阈值法的不足,既保证稀疏性又避免组合爆炸的计算复杂度。重点分析了正交设计下 LASSO 的解析解推导过程,得出软阈值解公式,并展示其几何意义——L1约束的顶点与椭圆等高线相切时产生稀疏解。
有欲以观其妙,无欲以观其徼,此二者同出而异名。
落日与晚风,尽情的相拥。
使用pandas读取文件使用seaborn查看连续数值数据分布可以看出SibSp、SibSp、Fare列数据分布不均,长尾效应明显,因此对这3列取对数处理。
Scikit-learn Python机器学习 - 分类算法 - 决策树
Scikit-learn Python机器学习 - 分类算法 - 随机森林
天接云涛连晓雾,星河欲转千帆舞。
空山新雨后,天气晚来秋。明月松间照,清泉石上流。
Scikit-learn是Python中最受欢迎的机器学习库之一,它提供了简单易用的API和丰富的算法模块,包括监督学习(分类、回归)、无监督学习(聚类、降维)以及模型评估工具。该库适合初学者快速上手,文档详细且社区活跃,广泛应用于电商推荐、金融风控、医疗诊断等领域。使用Scikit-learn时需注意数据预处理、特征工程和避免常见错误(如数据泄露、过拟合)。虽然深度学习兴起,但Scikit-le
明月松间照,清泉石上流。
本文通过一个趣味项目演示了SVM算法在后宫人物识别中的应用。作者使用自制的7人56张人脸数据集,首先导入必要的库(如SVC、PCA等),然后加载并预处理图像数据(灰度化、统一尺寸)。接着通过PCA降维处理(保留95%特征)减少像素特征,再使用带网格搜索的SVM进行训练调参。最后测试结果显示部分识别准确,但也存在错误案例。全文以甄嬛传为背景,用幽默的宫廷术语比喻技术概念,既展示了SVM的应用流程,又
一个被标记的训练数据集是指其中每个训练实例(或样本)都同时包含了:输入数据(特征,Features):描述该实例的一组属性。期望输出(标签,Label 或 目标,Target):我们希望模型为该输入预测的正确结果。例如:在一个垃圾邮件分类器中,一个被标记的数据集包含成千上万封邮件。对于每一封邮件:**输入(特征):**可能是邮件的发件人、标题、正文内容等。
湖光秋月两相和,潭面无风镜未磨。
Scikit-learn Python机器学习 - 模型保存及加载
这一个也是和信号识别的那个项目demo一样。桌面很常用的开发框架tkinter,在没有pyqt之前一直用着,帮客户修改一下代码。人工智能应用开发套路还是一样,从csv获取数据集,进行数据集清洗去重等操作,完成数据清洗就可以构造模型进行模型fit了,最后模型预测评估调优。
本文聚焦数据预处理的关键环节——缺失值处理。如果处理不当,缺失数据会显著降低模型的准确性和可靠性。本文将介绍多种插补方法,并展示如何将其嵌入数据处理流水线中。通过这一方式,我们能够重新纳入先前被排除的特征,进一步提升预测精度,充分挖掘数据集的价值。
桌面很常用的开发框架tkinter,在没有pyqt之前一直用着,帮客户修改一下代码。人工智能应用开发套路还是一样,从csv获取数据集,进行数据集清洗去重等操作,完成数据清洗就可以构造模型进行模型fit了,最后模型预测评估调优。
忽如一夜春风来,千树万树梨花开。
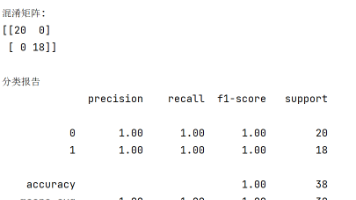
逻辑回归是一种用于分类的算法,通过sigmoid函数将线性回归结果映射为概率。它可处理二分类问题,也可通过多个分类器解决多分类任务。评估指标包括准确率、精确率、召回率、F1-Score、ROC曲线和AUC值等。实现方式上,既可用Sklearn的LogisticRegression模块,也可用PyTorch构建神经网络。其中PyTorch实现涉及定义网络结构、优化器和损失函数,训练后通过混淆矩阵和分
本篇文章以 Ames 房屋数据集为例,展示了如何将 机器学习与统计分析结合 来进行回归任务。我们首先使用 Scikit-Learn 构建线性回归模型,通过训练-测试拆分评估模型在未知数据上的预测能力;随后借助 Statsmodels 对完整数据集进行统计建模,深入解析系数、P 值、置信区间及各类诊断指标。文章通过两种方法的对比,既展示了模型预测的实用性,也揭示了数据背后的统计规律,为理解与应用回归
DL4J(DeepLearning4J)则是专门为Java设计的深度学习框架,支持分布式训练和与Hadoop、Spark的深度集成,使得在生产环境中部署神经网络模型成为可能。在实时数据处理领域,Java技术栈展现出卓越的性能。Docker容器化技术与Kubernetes编排平台的结合,使得基于Java的智能服务可以高效地在混合云环境中部署和管理,满足不同规模企业的需求。作为一门成熟稳定的编程语言,
摘要:CodeCapsule推出机器学习入门指南,通过Scikit-learn实现首个项目。文章打破机器学习的神秘感,将其比作教儿童识别动物的过程,强调无需深厚数学基础即可入门。详细介绍了Scikit-learn的优势、环境配置步骤,并提供了完整的依赖包清单和验证脚本。教程包含一个"Hello World"示例,使用鸢尾花数据集演示数据加载、模型训练和评估全流程。文章还解析了机
接下来是模型的定义阶段。使用Keras的`Sequential`模型,可以像搭积木一样依次添加卷积层(Conv2D)、池化层(MaxPooling2D)、展平层(Flatten)和全连接层(Dense)。模型结构定义完成后,需要调用`compile`方法配置学习过程,指定所用的优化器(如`adam`)、损失函数(如分类任务常用的`sparse_categorical_crossentropy`)和
此外,PyTorch提供了丰富的预训练模型和工具库,如Transformers库,极大地简化了自然语言处理任务的实现流程。近年来,深度学习技术,特别是基于PyTorch框架的模型,已经彻底改变了自然语言处理领域的面貌。随着PyTorch等框架的不断进化,以及新模型和新算法的出现,深度学习在自然语言处理中的应用将更加广泛和深入。基于PyTorch的深度学习模型可以通过迁移学习,利用通用领域的预训练模
导入数据文本预处理(分词、去停用词、词干提取)特征提取(TF-IDF)模型训练(朴素贝叶斯、逻辑回归、SVM)模型评估与应用通过这些步骤,大概可以构建一个情感分类系统,用于判断文本的情感倾向。由于本人能力有限,只用了200条数据来建模,处理和方法的应用有很多不到位的地方,以上代码运行下来的结果准确率不高,最高的是用朴素贝叶斯的,0.7左右,MAE值1.2左右。如果有错误或者可以改进的地方,欢迎指出
基于python全国5A景区数据分析可视化平台 热门旅游景点数据分析系统 可视化 Django框架 scikit-learn机器学习 大数据毕业设计✅
3、适配器调整(Adapter Tuning)4、前缀调整(Prefix Tuning)5、提示调整(Prompt Tuning)大模型-7种大模型微调方法 上。