萌新的机器学习之路---kaggle泰坦尼克号
Titanic - Machine Learning from Disaster
数据来源:https://www.kaggle.com/competitions/titanic/overview
使用pandas读取文件
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

pd.set_option('display.max_rows', None)
pd.set_option('display.max_columns', None)

plt.rcParams['font.family'] = 'SimHei'
plt.rcParams['axes.unicode_minus'] = False

import warnings
# 忽略所有警告
warnings.filterwarnings("ignore")

train=pd.read_csv('train.csv')
test=pd.read_csv('test.csv')
使用seaborn查看连续数值数据分布
import seaborn as sns
for i in train.columns:
    if train[i].dtype!='object' and i not in ('PassengerId','Survived'):
        ageFacet=sns.FacetGrid(train,hue='Survived',aspect=3)
        #作图,选择图形类型
        ageFacet.map(sns.kdeplot,i,shade=True)
        #其他信息:坐标轴范围、标签等
        ageFacet.add_legend()
        print(i,train[i].skew())
Pclass -0.6305479068752845
Age 0.38910778230082704
SibSp 3.6953517271630565
Parch 2.7491170471010933
Fare 4.787316519674893
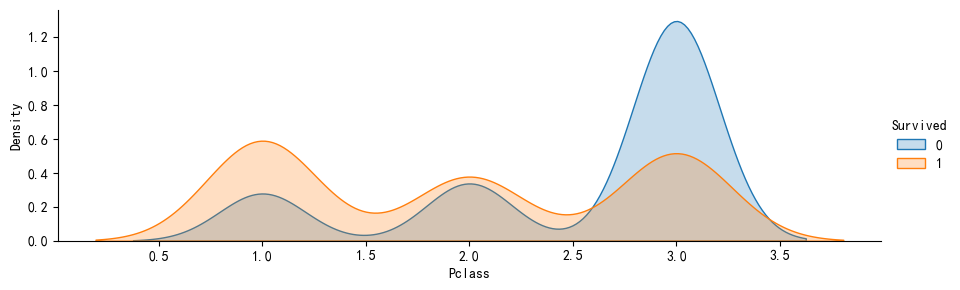
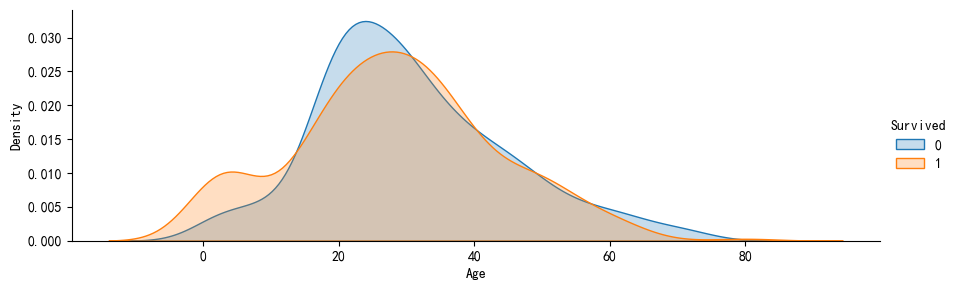
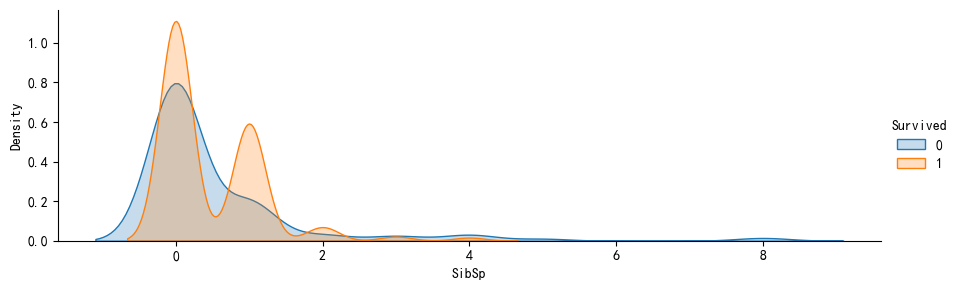
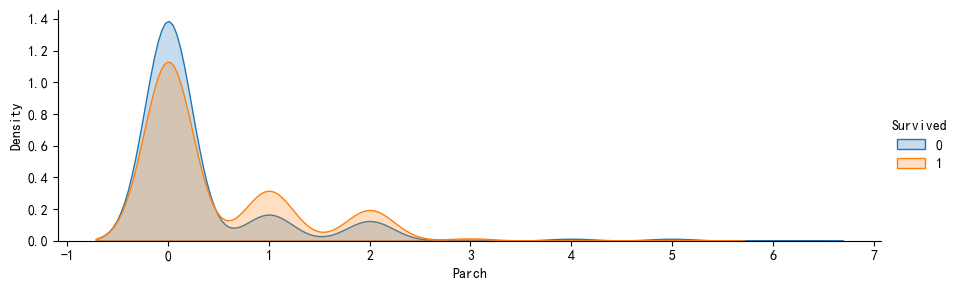
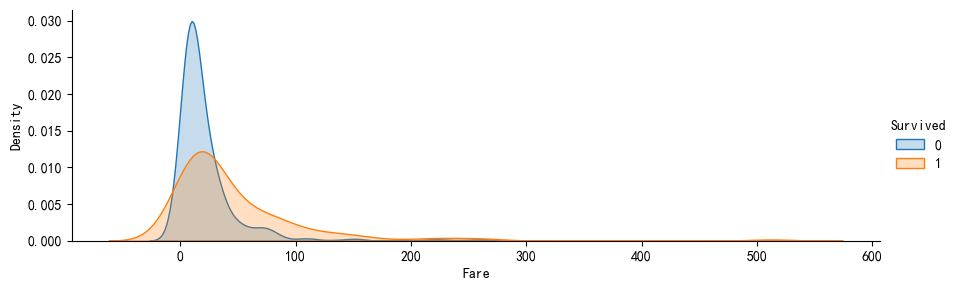
可以看出SibSp、SibSp、Fare列数据分布不均,长尾效应明显,因此对这3列取对数处理
特征工程
df=pd.concat([train,test])
df.drop(['PassengerId'],axis=1,inplace=True)
df['Title']=df['Name'].map(lambda x:x.split(',')[1].split('.')[0].strip())
TitleDict = {'Mr':'Mr', 'Mlle':'Miss', 'Miss':'Miss', 'Master':'Master', 'Jonkheer':'Master', 'Mme':'Mrs', 'Ms':'Mrs',
             'Mrs':'Mrs', 'Don':'Royalty', 'Sir':'Royalty', 'the Countess':'Royalty', 'Dona':'Royalty', 'Lady':'Royalty',
             'Capt':'Officer', 'Col':'Officer', 'Major':'Officer', 'Dr':'Officer', 'Rev':'Officer'}
df['Age'] = df.groupby(df['Title'].isin(['Miss', 'Master','Mlle','Jonkheer']))['Age'].transform(lambda x: x.fillna(x.median()))
df['Sex'] = df['Sex'].map({'male':1,'female':0})
df['Title']=df['Title'].map(TitleDict)
df.drop('Name',axis=1,inplace=True)
df['familyNum']=(df['Parch']+df['SibSp']+1)
df['Cabin']=df['Cabin'].str[0].fillna('N')
df['Embarked']=df['Embarked'].fillna('S')
df['Fare']=df['Fare'].fillna(7.225)
df['Fare']=np.log1p(df['Fare'])
df['SibSp']=np.log1p(df['SibSp'])
df['SibSp']=np.log1p(df['Parch'])
df['Pclass'] = df['Pclass'].astype(str)

import re
def extract_ticket_prefix(ticket):
    ticket = str(ticket)
    if '/' in ticket:
        ticket = ticket.split('/')[0]
    prefix = re.sub('[^a-zA-Z]', '', ticket)
    return prefix if prefix else 'NONE'

def extract_ticket_number(ticket):
    if type(ticket)==int:
        return ticket//1000
    if ' ' in ticket:
        ticket = ticket.split(' ')[-1]
    numbers = re.sub('[^0-9]', '', ticket)
    return int(numbers)//1000 if numbers else 0

df['Ticket_Prefix'] = df['Ticket'].apply(extract_ticket_prefix)
df['Ticket_Number'] = np.log1p(df['Ticket'].apply(extract_ticket_number))
df['Group_Size'] = df.groupby('Ticket')['Ticket'].transform('count')
prefix_counts = df['Ticket_Prefix'].value_counts()
rare_prefixes = prefix_counts[prefix_counts < 5].index
df['Ticket_Prefix'] = df['Ticket_Prefix'].replace(rare_prefixes, 'RARE')

df.drop('Ticket',axis=1,inplace=True)
归一化和主成分分析
df=pd.get_dummies(df)
n=train.shape[0]
x=df.drop('Survived',axis=1)
columns=x.columns
y=df['Survived']
from sklearn.preprocessing import StandardScaler
x=StandardScaler().fit_transform(x)
from sklearn.decomposition import PCA
x=PCA().fit_transform(x)
tx,ty=x[:n],y[:n]
pre=x[n:]
5折交叉验证
from sklearn.model_selection import RepeatedStratifiedKFold
from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
lg=LogisticRegression()
cross_val_score(lg, tx, ty, scoring='accuracy', cv=sk).mean()
0.819295712761283
lg.fit(tx,ty)
predictions = lg.predict(pre)
ans_df=pd.DataFrame({'PassengerId':test['PassengerId'],'Survived':map(int,predictions)})
ans_df.to_csv('LG_submission.csv',index=False)
挑选模型
from sklearn.linear_model import LogisticRegression, LogisticRegressionCV, SGDClassifier, RidgeClassifier
from sklearn.tree import DecisionTreeClassifier, ExtraTreeClassifier
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier, ExtraTreesClassifier, HistGradientBoostingClassifier
from sklearn.svm import SVC, NuSVC
from sklearn.naive_bayes import GaussianNB, BernoulliNB
from sklearn.neighbors import KNeighborsClassifier
from xgboost import XGBClassifier, XGBRFClassifier
from lightgbm import LGBMClassifier
from catboost import CatBoostClassifier

models = [
    # 线性模型
    LogisticRegression(),
    LogisticRegressionCV(),
    RidgeClassifier(),
    SGDClassifier(loss='log_loss'),

    # 树模型
    DecisionTreeClassifier(),
    ExtraTreeClassifier(),
    RandomForestClassifier(),
    GradientBoostingClassifier(),
    ExtraTreesClassifier(),
    HistGradientBoostingClassifier(),

    # 支持向量机
    SVC(),
    NuSVC(),

    # 贝叶斯模型
    GaussianNB(var_smoothing=1e-9),
    BernoulliNB(alpha=1.0),

    # 距离模型
    KNeighborsClassifier(n_neighbors=15, weights='distance'),

    # XGBoost模型
    XGBClassifier(),
    XGBRFClassifier(),

    LGBMClassifier(verbose=-1),

    CatBoostClassifier(verbose=False)
]

for m in models:
    print(m.__class__.__name__)
    sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
    print(cross_val_score(m, tx, ty, scoring='accuracy', cv=sk).mean())
LogisticRegression
0.819295712761283
LogisticRegressionCV
0.827154604230745
RidgeClassifier
0.8249074132195091
SGDClassifier
0.7395706484213169
DecisionTreeClassifier
0.7586780490866862
ExtraTreeClassifier
0.73841566756638
RandomForestClassifier
0.8181658401858014
GradientBoostingClassifier
0.8125541397275752
ExtraTreesClassifier
0.8080472035653757
HistGradientBoostingClassifier
0.8136714581633292
SVC
0.8226727763480006
NuSVC
0.8260498399347185
GaussianNB
0.7228171489548678
BernoulliNB
0.7116125792480071
KNeighborsClassifier
0.8091959073504487
XGBClassifier
0.8237524323645722
XGBRFClassifier
0.8192831586215554
LGBMClassifier
0.8158872638252463
CatBoostClassifier
0.8282719226664993
超参数优化
import optuna

def rf_search(trial):
    n_estimators = trial.suggest_int("n_estimators", 200, 1000, step=50)
    max_depth = trial.suggest_int("max_depth", 5, 100, step=2)
    min_samples_split = trial.suggest_int("min_samples_split", 5, 100, step=2)
    min_samples_leaf = trial.suggest_int("min_samples_leaf", 5, 100, step=2)
    sk = RepeatedStratifiedKFold(n_splits = 10, n_repeats = 1, random_state = 42)
    rf = RandomForestClassifier(n_estimators=n_estimators,
                                min_samples_split=min_samples_split,
                                min_samples_leaf = min_samples_leaf,
                                max_depth=max_depth,
                                n_jobs = -1)
    val = cross_val_score(rf, tx, ty, scoring='accuracy', cv=sk).mean()
    return -val

rf_study = optuna.create_study(study_name='rf')
rf_study.optimize(rf_search, timeout=int(60 * 60), n_trials=300)
rf_params = rf_study.best_params
import optuna
def lgbm_search(trial):
boosting_type = trial.suggest_categorical("boosting_type", ["gbdt", "goss"])
n_estimators = trial.suggest_int("n_estimators", 100, 1000, step=50)
max_depth = trial.suggest_int("max_depth", 5, 100, step=2)
learning_rate = trial.suggest_float("learning_rate", 0.01, 0.1, log=True)
min_child_samples = trial.suggest_int("min_child_samples", 5, 100)
min_split_gain = trial.suggest_float("min_split_gain", 0.0, 1.0)
min_child_weight = trial.suggest_float("min_child_weight", 1e-4, 0.01, log=True)
reg_alpha = trial.suggest_float("reg_alpha", 1e-6, 0.1, log=True),
reg_lambda = trial.suggest_float("reg_lambda", 1e-6, 0.1, log=True),
sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
lgbm = LGBMClassifier(boosting_type=boosting_type,
n_estimators=n_estimators,
learning_rate=learning_rate,
max_depth=max_depth,
min_child_samples=min_child_samples,
min_child_weight=min_child_weight,
min_split_gain=min_split_gain,
reg_alpha=reg_alpha,
reg_lambda=reg_lambda,
n_jobs = -1,
verbose = -1)
val = cross_val_score(lgbm, tx, ty, scoring='accuracy', cv=sk).mean()
return -val
lgbm_study = optuna.create_study(study_name='lgbm', direction="minimize")
lgbm_study.optimize(lgbm_search, timeout=int(60 * 60), n_trials=300)
lgbm_params = lgbm_study.best_paramsimport optuna
def xgb_search(trial):
colsample_bytree = trial.suggest_float('colsample_bytree', 0.6, 1.0, step=0.1)
gamma = trial.suggest_float('gamma', 1, 10, step=0.5)
learning_rate = trial.suggest_float('learning_rate', 0.001, 0.1, log=True)
max_depth = trial.suggest_int('max_depth', 5, 30, step=1)
min_child_weight = trial.suggest_int('min_child_weight', 1, 15, step=1)
n_estimators = trial.suggest_int('n_estimators', 200, 1000, step=100)
sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
xgb = XGBClassifier(objective = 'binary:logistic',
tree_method='hist',
colsample_bytree = colsample_bytree,
gamma = gamma,
learning_rate = learning_rate,
max_depth = max_depth,
min_child_weight = min_child_weight,
n_estimators = n_estimators)
val = cross_val_score(xgb, tx, ty, scoring='accuracy', cv=sk).mean()
return -val
xgb_study = optuna.create_study(study_name='xgb', direction="minimize")
xgb_study.optimize(xgb_search, timeout=int(60 * 60), n_trials=300)
xgb_params = xgb_study.best_paramsimport optuna
from sklearn.model_selection import RepeatedStratifiedKFold
from sklearn.model_selection import cross_val_score
def cat_search(trial):
iterations = trial.suggest_int('iterations', 200, 1000, step=100)
learning_rate = trial.suggest_float('learning_rate', 0.001, 0.1, log=True)
depth = trial.suggest_int('depth', 5, 16, step=1)
random_strength = trial.suggest_float('random_strength', 0.5, 1, step=0.1)
bagging_temperature = trial.suggest_float('bagging_temperature', 0.5, 1, step=0.1)
border_count = trial.suggest_int('border_count', 1, 100, step=10)
l2_leaf_reg = trial.suggest_int('l2_leaf_reg', 1, 10, step=1)
sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
cat = CatBoostClassifier(loss_function = 'Logloss',
iterations = iterations,
learning_rate = learning_rate,
depth = depth,
random_strength = random_strength,
bagging_temperature = bagging_temperature,
border_count = border_count,
l2_leaf_reg = l2_leaf_reg,
verbose = False,
task_type = 'CPU')
val = cross_val_score(cat, tx, ty, scoring='accuracy', cv=sk).mean()
return -val
cat_study = optuna.create_study(study_name='cat', direction="minimize")
cat_study.optimize(cat_search, timeout=int(60 * 60), n_trials=100)
cat_params = cat_study.best_paramsOOF和爬山算法
def hill_climbing(x, y, x_test):
    # 初始化得分字典,用于存储每个模型的准确率得分
    scores = {}

    # 遍历x列标签(各模型)
    for col in x.columns:
        # 将概率预测转换为类别预测(假设二分类,阈值0.5)
        y_pred = (x[col] >= 0.5).astype(int)
        # 计算各模型的准确率
        scores[col] = accuracy_score(y, y_pred)

    # 根据准确率对模型进行排序,得分高的排在前面
    scores = {k: v for k, v in sorted(scores.items(), key=lambda item: item[1], reverse=True)}

    # 根据准确率得分高低重新排列x和x_test的列顺序
    x = x[list(scores.keys())]
    x_test = x_test[list(scores.keys())]

    # 停止标志,控制爬山算法的终止条件
    STOP = False

    # 取出得分最高的模型作为初始最优模型
    current_best_ensemble = x.iloc[:, 0]
    current_best_test_preds = x_test.iloc[:, 0]

    # 除最优模型外的其他模型
    MODELS = x.iloc[:, 1:]

    # 权重空间,用于尝试不同的权重值
    weight_range = np.arange(-0.5, 0.51, 0.01)

    # 计算最优模型准确率得分的历史
    best_preds = (current_best_ensemble >= 0.5).astype(int)
    history = [accuracy_score(y, best_preds)]
    j = 0

    while not STOP:
        j += 1
        # 计算当前最优集成模型的准确率
        current_preds = (current_best_ensemble >= 0.5).astype(int)
        potential_new_best_cv_score = accuracy_score(y, current_preds)
        k_best, wgt_best = None, None

        # 遍历每个模型以及权重空间,寻找最优的组合
        for k in MODELS.columns:
            for wgt in weight_range:
                # 创建新的集成预测(概率)
                potential_ensemble = (1 - wgt) * current_best_ensemble + wgt * MODELS[k]

                # 转换为类别预测
                ensemble_preds = (potential_ensemble >= 0.5).astype(int)
                cv_score = accuracy_score(y, ensemble_preds)

                # 如果当前组合的准确率高于历史最优,更新最优组合
                if cv_score > potential_new_best_cv_score:
                    potential_new_best_cv_score = cv_score
                    k_best, wgt_best = k, wgt

        if k_best is not None:
            # 更新最优模型和测试集预测(保持概率形式)
            current_best_ensemble = (1 - wgt_best) * current_best_ensemble + wgt_best * MODELS[k_best]
            current_best_test_preds = (1 - wgt_best) * current_best_test_preds + wgt_best * x_test[k_best]

            # 从可用模型中移除已选模型
            MODELS = MODELS.drop(k_best, axis=1)

            # 如果已经没有其他可用模型,则停止
            if MODELS.shape[1] == 0:
                STOP = True

            # 记录当前最优得分
            current_final_preds = (current_best_ensemble >= 0.5).astype(int)
            history.append(accuracy_score(y, current_final_preds))
        else:
            # 如果无法找到更好的组合,则停止
            STOP = True

    # 返回最终得到的集成模型的预测结果(概率形式)
    hill_ens_pred_1 = current_best_ensemble
    hill_ens_pred_2 = current_best_test_preds

    return [hill_ens_pred_1, hill_ens_pred_2, history]
# 初始化交叉检验分数,初始化预测标签
ens_cv_scores, ens_preds = list(), list()
# 初始化hill交叉检验分数,初始化hill预测标签
hill_ens_cv_scores, hill_ens_preds = list(), list()
# 重复k折交叉验证
sk = RepeatedStratifiedKFold(n_splits = 5, n_repeats = 1, random_state = 42)
# 遍历每折数据
for i, (train_idx, test_idx) in enumerate(sk.split(tx, ty)):
# 划分训练测试集
X_train, X_test = tx[train_idx], tx[test_idx]
Y_train, Y_test = ty[train_idx], ty[test_idx]
print('----------------------------------------------------------')
#----------------------------------------------------------------------------
# 训练RF模型
RF_md = RandomForestClassifier(n_jobs=-1,
**rf_params).fit(X_train, Y_train)
# 得到测试集预测概率和类别
rf_pred_prob = RF_md.predict_proba(X_test)[:, 1]
rf_pred_class = RF_md.predict(X_test)
# 计算准确率分数
rf_score = accuracy_score(Y_test, rf_pred_class)
# 得到测试集预测概率
rf_pred_test = RF_md.predict_proba(pre)[:, 1]
#----------------------------------------------------------------------------
# 训练LGBM模型
LGBM_md = LGBMClassifier(verbose=-1,
**lgbm_params).fit(X_train, Y_train)
# 得到测试集预测概率和类别
lgb_pred_prob = LGBM_md.predict_proba(X_test)[:, 1]
lgb_pred_class = LGBM_md.predict(X_test)
# 计算准确率分数
lgb_score = accuracy_score(Y_test, lgb_pred_class)
# 得到测试集预测概率
lgb_pred_test = LGBM_md.predict_proba(pre)[:, 1]
#----------------------------------------------------------------------------
# 训练XGB模型
XGB_md = XGBClassifier(objective = 'binary:logistic',
tree_method='hist',
**xgb_params).fit(X_train, Y_train)
# 得到验证集预测概率和类别
xgb_pred_prob = XGB_md.predict_proba(X_test)[:, 1]
xgb_pred_class = XGB_md.predict(X_test)
# 计算准确率分数
xgb_score = accuracy_score(Y_test, xgb_pred_class)
# 得到测试集预测概率
xgb_pred_test = XGB_md.predict_proba(pre)[:, 1]
#----------------------------------------------------------------------------
# 训练cat模型
cat_md = CatBoostClassifier(**cat_params,
verbose=0).fit(X_train, Y_train)
# 得到测试集预测概率和类别
cat_pred_prob = cat_md.predict_proba(X_test)[:, 1]
cat_pred_class = cat_md.predict(X_test)
# 计算准确率分数
cat_score = accuracy_score(Y_test, cat_pred_class)
# 得到测试集预测概率
cat_pred_test = cat_md.predict_proba(pre)[:, 1]
#--------------------------------------------------------------------------
# 简单组合模型 - 使用投票法
# 各模型验证集预测类别投票
ens_pred_class = np.round((rf_pred_class + cat_pred_class + lgb_pred_class + xgb_pred_class) / 4).astype(int)
# 计算准确率分数
ens_score_fold = accuracy_score(Y_test, ens_pred_class)
# 记录组合模型验证集准确率
ens_cv_scores.append(ens_score_fold)
# 对于测试集,使用概率平均然后转换为类别
ens_pred_test_prob = (rf_pred_test+ cat_pred_test + lgb_pred_test + xgb_pred_test) / 4
ens_pred_test_class = (ens_pred_test_prob >= 0.5).astype(int)
# 记录组合模型测试集预测类别
ens_preds.append(ens_pred_test_class)
print('Fold', i, '==> Average Ensemble accuracy score is ==>', ens_score_fold)
#--------------------------------------------------------------------------
# 加权组合模型 - 使用修改后的hill_climbing_accuracy函数
x = pd.DataFrame({'RF': rf_pred_prob,
'CAT': cat_pred_prob,
'LGBM': lgb_pred_prob,
'XGB': xgb_pred_prob})
y = Y_test
x_test = pd.DataFrame({'RF': rf_pred_test,
'CAT': cat_pred_test,
'LGBM': lgb_pred_test,
'XGB': xgb_pred_test})
# 使用修改后的hill_climbing_accuracy函数
hill_results = hill_climbing(x, y, x_test)
# 将概率预测转换为类别预测
hill_pred_class = (hill_results[0] >= 0.5).astype(int)
hill_ens_score_fold = accuracy_score(y, hill_pred_class)
hill_ens_cv_scores.append(hill_ens_score_fold)
# 将测试集概率预测转换为类别预测
hill_test_class = (hill_results[1] >= 0.5).astype(int)
hill_ens_preds.append(hill_test_class)
print('Fold', i, '==> Hill Climbing Ensemble accuracy score is ==>', hill_ens_score_fold)
# 计算平均准确率
avg_ens_accuracy = np.mean(ens_cv_scores)
avg_hill_ens_accuracy = np.mean(hill_ens_cv_scores)
print('==========================================================')
print('Average Ensemble Mean Accuracy:', avg_ens_accuracy)
print('Hill Climbing Ensemble Mean Accuracy:', avg_hill_ens_accuracy)----------------------------------------------------------
Fold 0 ==> Average Ensemble accuracy score is ==> 0.8379888268156425
Fold 0 ==> Hill Climbing Ensemble accuracy score is ==> 0.8547486033519553
----------------------------------------------------------
Fold 1 ==> Average Ensemble accuracy score is ==> 0.8595505617977528
Fold 1 ==> Hill Climbing Ensemble accuracy score is ==> 0.8707865168539326
----------------------------------------------------------
Fold 2 ==> Average Ensemble accuracy score is ==> 0.8033707865168539
Fold 2 ==> Hill Climbing Ensemble accuracy score is ==> 0.8202247191011236
----------------------------------------------------------
Fold 3 ==> Average Ensemble accuracy score is ==> 0.848314606741573
Fold 3 ==> Hill Climbing Ensemble accuracy score is ==> 0.8539325842696629
----------------------------------------------------------
Fold 4 ==> Average Ensemble accuracy score is ==> 0.8539325842696629
Fold 4 ==> Hill Climbing Ensemble accuracy score is ==> 0.8595505617977528
==========================================================
Average Ensemble Mean Accuracy: 0.840631473228297
Hill Climbing Ensemble Mean Accuracy: 0.8518485970748856
ens_preds_test = pd.DataFrame(ens_preds).apply(np.mean, axis = 0)
ans_df=pd.DataFrame({'PassengerId':test['PassengerId'],'Survived':ens_preds_test.map(int)})
ans_df.to_csv('Avereage_Ensemble_Baseline_submission.csv',index=False)

ens_preds_test = pd.DataFrame(hill_ens_preds).apply(np.mean, axis = 0)
ans_df=pd.DataFrame({'PassengerId':test['PassengerId'],'Survived':ens_preds_test.map(int)})
ans_df.to_csv('Hill_Ensemble_Baseline_submission.csv',index=False)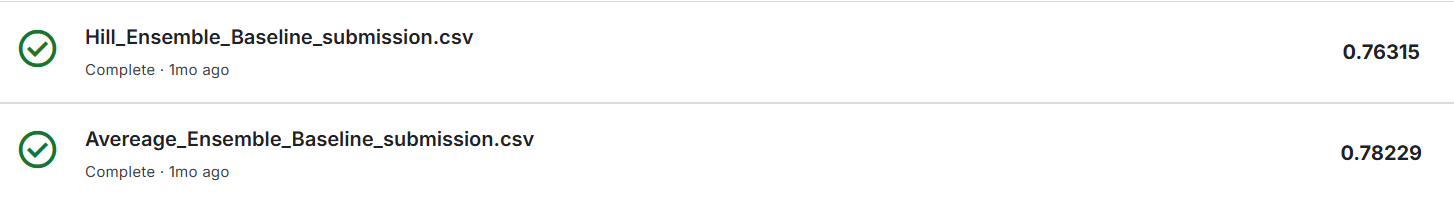
模型堆叠
from sklearn.ensemble import StackingClassifier
level1_estimators = [
    ('rf', RandomForestClassifier(n_jobs=-1)),
    ('lgbm', LGBMClassifier(verbose=-1)),
    ('xgb', XGBClassifier()),
    ('cat', CatBoostClassifier(verbose=0))
]

level1_stack = StackingClassifier(
    estimators=level1_estimators,
    final_estimator=LogisticRegression(),
    cv=5
)

level2_estimators = [
    ('level1_stack', level1_stack),
    ('hgbt', HistGradientBoostingClassifier()),
    ('ridge', RidgeClassifier())
]

final_clf = StackingClassifier(
    estimators=level2_estimators,
    final_estimator=LogisticRegression(),
    cv=5
)

final_clf.fit(tx, ty)
y_pred = final_clf.predict(pre)
print(f"Stacking Classifier 准确率: {accuracy_score(final_clf.predict(tx), ty)}")

ans_df=pd.DataFrame({'PassengerId':test['PassengerId'],'Survived':map(int,y_pred)})
ans_df.to_csv('stacking_submission.csv',index=False)
Stacking Classifier 准确率: 0.9483726150392817
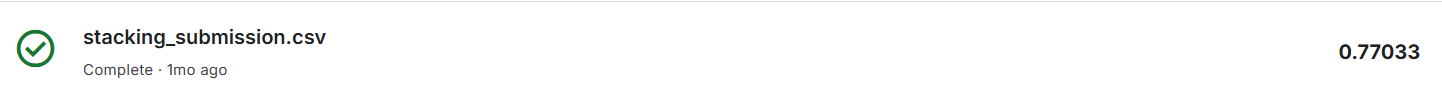
模型堆叠过拟合严重
AutoML自动机器学习
from autogluon.tabular import TabularDataset, TabularPredictor

predictor = TabularPredictor(label='Survived').fit(
    train_data=train,
    time_limit=7200,
    presets='best',
    num_bag_folds=5,
    num_bag_sets=1,
    num_stack_levels=1,
)

leaderboard = predictor.leaderboard()
predictions = predictor.predict(test)

ans_df=pd.DataFrame({'PassengerId':test['PassengerId'],'Survived':map(int,predictions)})
ans_df.to_csv('autogluon_submission.csv',index=False)

最终分数0.79665,排名前5%
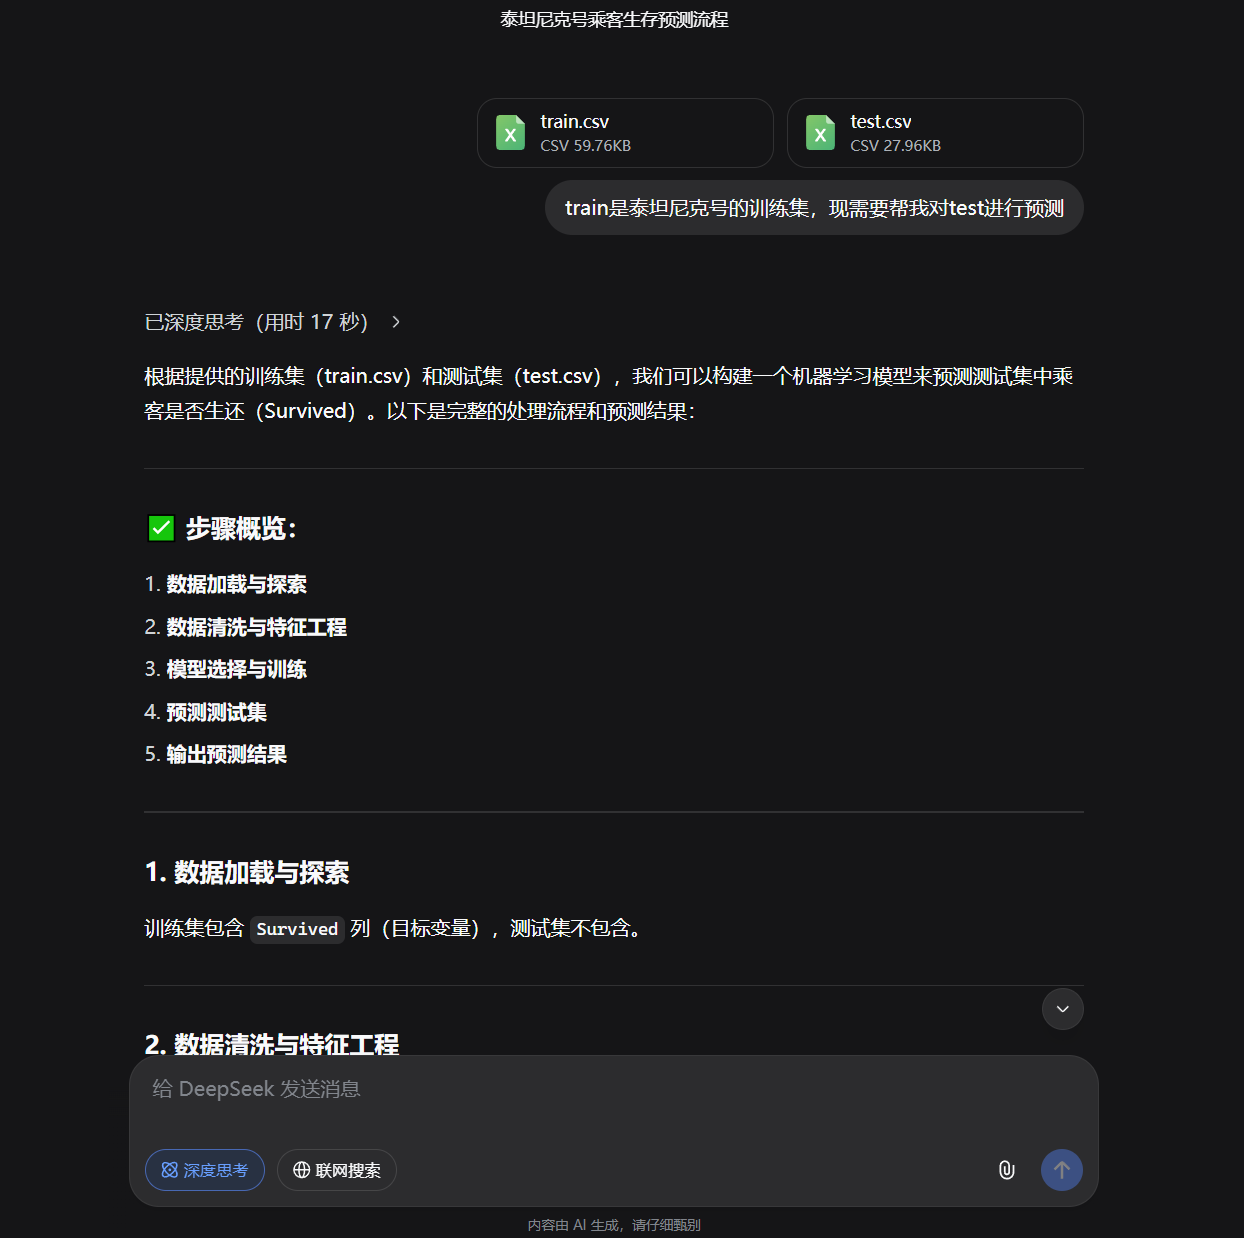
deepseek预测

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)