手撕统计机器学习 - LASSO 变量选择
手撕统计机器学习 - LASSO 变量选择
本节所需前置知识:
- 线性回归
- 最优化方法(二次规划问题、Lagrange 函数与 KKT 条件、次梯度)
高维小样本问题
高维小样本问题是在 nnn 个样本,ppp 个维度的情况下,有 n<<pn << pn<<p 的前提的问题. 这类问题在特殊场景下非常常见,包括:
- 图片模式识别(每个像素视为一个特征);
- 生物信息(例如 DNA 甲基化数据,单个节点均视为一个特征);
同时,在一般的情况下,我们也想知道什么样的特征是比较重要的,对于一个背包,影响它价格的因素里面,品牌的影响更大还是背包容量的影响更大?我们因此希望剔除掉不重要的特征,提高我们的预测准确率.
在线性回归当中,我们得到的系数:
y=β0+β1x1+⋯+βpxp
y = \beta_{0} + \beta_{1} x_{1}+ \cdots + \beta_{p} x_{p}
y=β0+β1x1+⋯+βpxp
实际上就代表着各个特征的重要程度,当 βi>0\beta_{i}>0βi>0 时,说明第 iii 个特征具有正影响,绝对值越大说明特征影响越大.
变量选择问题
现在我们要进行变量的选择,也就是说,我们想筛除掉一些没那么重要的特征,应该如何解决这个问题?既然线性回归的系数代表着重要性,那么如果系数为 000 ,就说明这个变量不被选择,反之则被选择,这个时候我们就进行了变量选择.
一个简单粗暴的想法是:我们先进行 OLS,然后设定一个阈值,当系数绝对值小于这个阈值时,我们就强行压缩到 000 ,这样就能实现变量选择. 例如:
y=0.6+0.1x1+0.8x2−0.4x3
y = 0.6 + 0.1x_{1}+ 0.8 x_{2} - 0.4x_{3}
y=0.6+0.1x1+0.8x2−0.4x3
如果设定阈值为 0.20.20.2 ,那么我们就选出了后两个特征.
上述的方法看似简单,但是有个问题就是:我们到底要如何控制选择的力度?阈值选择到什么程度才能尽可能地完成变量选择的同时保障 MSE\mathrm{MSE}MSE 还不会有明显增大?
稀疏优化问题
为了解决刚刚提到的问题,我们不妨将原来的损失函数进行改造:
L:=MSE+λ∥β∥0
L: = \mathrm{MSE} + \lambda \|\boldsymbol{\beta}\|_{0}
L:=MSE+λ∥β∥0
这里 λ\lambdaλ 为惩罚参数,ℓ0\ell_{0}ℓ0 范数表示 β\boldsymbol{\beta}β 当中非零元素的个数,这也就是说,我们既希望 β\boldsymbol{\beta}β 足够稀疏,又希望 MSE\mathrm{MSE}MSE 不会过大,那么这个时候只要 λ\lambdaλ 选的足够好,就能达到我们希望的效果. 这种希望解能稀疏的问题我们称为稀疏优化问题.
看起来这个问题很简单,但是以 LLL 作为损失函数有个致命的问题在于:我们很难求解!我们当然可以预设 β\boldsymbol{\beta}β 哪些元素为 000 ,然后进行优化,但是所有的选择方案加在一起将会是一个组合的复杂度:
(p1)+(p2)+⋯+(pp−1)+(pp)
\binom{p}{1} + \binom{p}{2} + \cdots + \binom{p}{p-1} + \binom{p}{p}
(1p)+(2p)+⋯+(p−1p)+(pp)
这个时间就会爆炸,因此这不是一个合适的计算方案. 同时,ℓ0\ell_{0}ℓ0 范数作为泛函,也不是凸的,因此常用的凸优化方法都无法找到其全局最优解.
LASSO
LASSO (Least Absolute Shrinkage and Selection Operator) 就是用来解决上述问题的,它最早由 Robert Tibshirani 于 1996 年提出,具有划时代的意义. 它的改动很简单,就是将刚刚所说的 ℓ0\ell_{0}ℓ0 范数损失函数以及岭回归的损失函数改为:
L=MSE+λ∥β∥1
L = \mathrm{MSE} + \lambda\|\boldsymbol{\beta}\|_{1}
L=MSE+λ∥β∥1
也就是说,我们将其改为了 ℓ1\ell_{1}ℓ1 范数,一个 ℓ0\ell_{0}ℓ0 范数的凸近似. 也可以写为如下的形式:
minMSEs.t.∑i=1p∣βi∣<t
\begin{aligned}
& \min\quad \mathrm{MSE} \\
& \mathrm{s.t.} \quad \sum\limits_{i=1}^{p} |\beta_{i}| < t
\end{aligned}
minMSEs.t.i=1∑p∣βi∣<t
正交设计下的 LASSO
首先解释标题,正交设计是统计学试验设计当中的概念,表示数据 X\boldsymbol{X}X 是正交矩阵,满足 XTX=I\boldsymbol{X}^{\mathrm{T}}\boldsymbol{X} = \boldsymbol{I}XTX=I . 在这个条件下,LASSO 将会更明显地展示出其性质.
对 MSE\mathrm{MSE}MSE (在原论文当中使用残差平方和 RSS\mathrm{RSS}RSS 代替,由于两者仅差一个 1n\frac{1}{n}n1 ,因此这里不更改),可以将其展开为
MSE=(Xβ−y)T(Xβ−y)=βTXTXβ−yTXβ−βTXTy+yTy
\mathrm{MSE} = (\boldsymbol{X \beta} - \boldsymbol{y})^{\mathrm{T}}(\boldsymbol{X \beta} - \boldsymbol{y}) = \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{X}^{\mathrm{T}}\boldsymbol{X} \boldsymbol{\beta} - \boldsymbol{y}^{\mathrm{T}}\boldsymbol{X \beta} - \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{X}^{\mathrm{T}}\boldsymbol{y} + \boldsymbol{y}^{\mathrm{T}}\boldsymbol{y}
MSE=(Xβ−y)T(Xβ−y)=βTXTXβ−yTXβ−βTXTy+yTy
现在这一步可以看到,第四项和 β\boldsymbol{\beta}β 无关,而 XTX\boldsymbol{X}^{\mathrm{T}}\boldsymbol{X}XTX 会影响优化问题的难度,最简单的时候,就是正交设计的时候. 此时不妨使用正交设计的条件继续,有
MSE=βTβ−2βTXTy+yTy
\mathrm{MSE} = \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{\beta} -2 \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{X}^{\mathrm{T}}\boldsymbol{y}+ \boldsymbol{y}^{\mathrm{T}}\boldsymbol{y}
MSE=βTβ−2βTXTy+yTy
假设 OLS 已经计算出系数 β∘\boldsymbol{\beta}^{\circ}β∘ ,那么根据 OLS 系数的公式,有 β∘=XTy\boldsymbol{\beta}^{\circ} = \boldsymbol{X}^{\mathrm{T}}\boldsymbol{y}β∘=XTy ,因此
MSE=∥β∥22−2βTβ∘
\mathrm{MSE} = \|\boldsymbol{\beta}\|_{2}^{2} - 2 \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{\beta}^{\circ}
MSE=∥β∥22−2βTβ∘
Lagrange 函数的应用
此时利用 Lagrange 函数将约束优化转化为无约束优化:
L(β,γ)=∥β∥22−2βTβ∘+γ(∑i∣βi∣−t)
\mathcal{L}(\boldsymbol{\beta}, \gamma) = \|\boldsymbol{\beta}\|_{2}^{2} - 2 \boldsymbol{\beta}^{\mathrm{T}}\boldsymbol{\beta}^{\circ}+ \gamma\left(\sum\limits_{i}|\beta_{i}|- t\right)
L(β,γ)=∥β∥22−2βTβ∘+γ(i∑∣βi∣−t)
对分量求导,我们可以发现有 ∣βi∣|\beta_{i}|∣βi∣ 项不好求导,此时应该分情况求导得到 sign(βi)\operatorname{sign}(\beta_{i})sign(βi) (尽管这里 000 处是尖点,但是考虑到系数为 000 就说明变量被筛出,因此可以直接视为 000),随后有:
∂L∂βi=2βi−2βi∘+γsign(βi)
\dfrac{\partial \mathcal{L}}{\partial \beta_{i}} = 2 \beta_{i}- 2 \beta_{i}^{\circ} + \gamma \operatorname{sign}(\beta_{i})
∂βi∂L=2βi−2βi∘+γsign(βi)
令上式为 000 ,有
βi=βi∘−γ2sign(βi)
\beta_{i} = \beta_{i}^{\circ} - \frac{\gamma}{2}\operatorname{sign}(\beta_{i})
βi=βi∘−2γsign(βi)
其中 γ⩾0\gamma \geqslant 0γ⩾0,此时要分情况讨论,当 βi∘>0\beta_{i}^{\circ}>0βi∘>0 时,要保证 βi>0\beta_{i}>0βi>0 必须 βi∘>γ2\beta_{i}^{\circ}> \frac{\gamma}{2}βi∘>2γ ,对 βi∘<0\beta_{i}^{\circ}<0βi∘<0 时讨论也是类似的,最终得到
βi=sign(βi∘)(βi∘−γ2)+
\beta_{i} = \operatorname{sign}(\beta_{i}^{\circ}) \left(\beta_{i}^{\circ} - \frac{\gamma}{2}\right)^{+}
βi=sign(βi∘)(βi∘−2γ)+
这就是正交设计下的系数. 其中 γ\gammaγ 利用 KKT 条件进行确定.
软阈值解
对于最终的系数:
βi=sign(βi∘)(βi∘−γ2)+
\beta_{i} = \operatorname{sign}(\beta_{i}^{\circ}) \left(\beta_{i}^{\circ} - \frac{\gamma}{2}\right)^{+}
βi=sign(βi∘)(βi∘−2γ)+
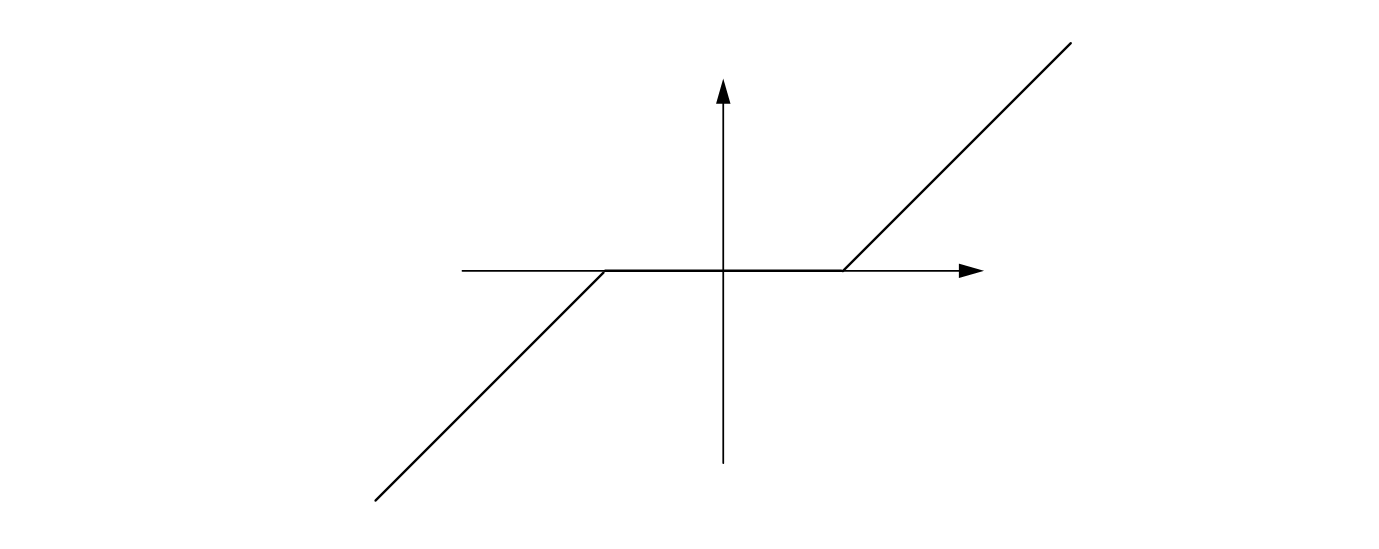
可以看到,当 βi≠0\beta_{i}\neq 0βi=0 时,第 iii 个特征被选择出来,此时 βi\beta_{i}βi 和 βi∘\beta_{i}^{\circ}βi∘ 仅差一个常数,这个解我们称为软阈值解. 对于特征,软阈值解只有两种行为:选择和收缩,并且由于收缩的力度 γ\gammaγ 是一致的,所以软阈值解可以看为下图所示的函数:
几何意义
在二维情况下,我们可以研究 LASSO 的几何意义,有
MSE=(β−β∘)TXTX(β−β∘)+C
\mathrm{MSE} = (\boldsymbol{\beta}-\boldsymbol{\beta}^{\circ})^{\mathrm{T}}\boldsymbol{X}^{\mathrm{T}}\boldsymbol{X}(\boldsymbol{\beta}-\boldsymbol{\beta}^{\circ})+C
MSE=(β−β∘)TXTX(β−β∘)+C
其中 CCC 为与 β\boldsymbol{\beta}β 无关的常数,上述二次型可看作二维下的椭圆等高线,由于 p=2p=2p=2 ,可以以 β1,β2\beta_{1},\beta_{2}β1,β2 为两个轴绘制图像:
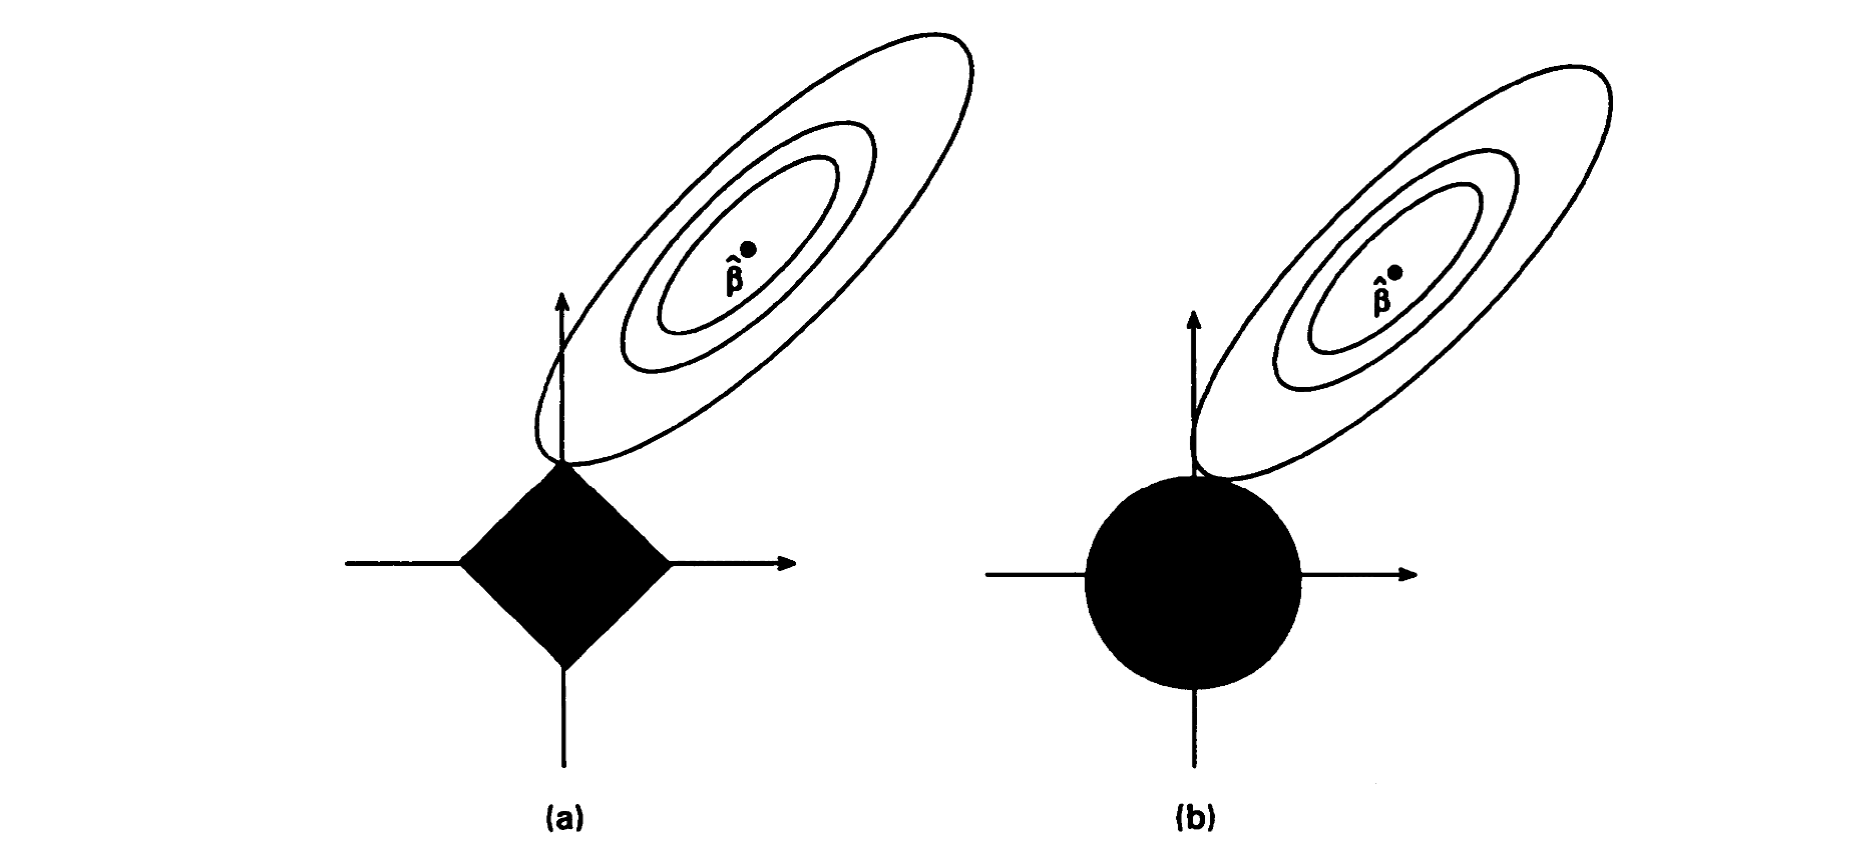
这个就是 LASSO 几乎最经典的图像了,ℓ1\ell_{1}ℓ1 范数的单位圆顶点是尖点,在特征选择之后,如果有特征被筛除,就会类似 (a) 当中与尖点相切,此时 β1=0\beta_{1}=0β1=0 ,符合特征筛选的几何直觉.
非正交设计下的 LASSO
然而,XTX=I\boldsymbol{X}^{\mathrm{T}}\boldsymbol{X}=\boldsymbol{I}XTX=I 肯定是一个过于苛刻的条件,绝大多数时候都不会是正交的,那么此时又该如何求解?事实上我们就要回到
L=MSE+λ∥β∥1
L = \mathrm{MSE} + \lambda\|\boldsymbol{\beta}\|_{1}
L=MSE+λ∥β∥1
损失函数的最小化上面了,这个函数最小化的解没有解析解,因此需要用数值计算的方法来求解其最终选择结果.
我们接下来的思路为:
- 证明该问题为凸优化问题,而非之前所说的组合优化问题.
- 引入优化方法:坐标轴下降法和最小角回归法.
前置准备:凸函数证明
即证明
L(αβ1+(1−α)β2)⩽αL(β1)+(1−α)L(β2)
L(\alpha \boldsymbol{\beta}_{1}+ (1-\alpha)\boldsymbol{\beta}_{2}) \leqslant \alpha L(\boldsymbol{\beta}_{1})+(1-\alpha)L(\boldsymbol{\beta}_{2})
L(αβ1+(1−α)β2)⩽αL(β1)+(1−α)L(β2)
左侧展开有
L(αβ1+(1−α)β2)=1n(∑i=1n(αβ1+(1−α)β2)Txi−yi)2+λ∥αβ1+(1−α)β2∥1
L(\alpha \boldsymbol{\beta}_{1}+(1-\alpha)\boldsymbol{\beta}_{2}) = \frac{1}{n}\left(\sum\limits_{i=1}^{n}\left(\alpha\boldsymbol{\beta}_{1}+(1-\alpha)\boldsymbol{\beta}_{2}\right)^{\mathrm{T}}\boldsymbol{x}_{i}-y_{i}\right)^{2} + \lambda\|\alpha\boldsymbol{\beta}_{1}+(1-\alpha)\boldsymbol{\beta}_{2}\|_{1}
L(αβ1+(1−α)β2)=n1(i=1∑n(αβ1+(1−α)β2)Txi−yi)2+λ∥αβ1+(1−α)β2∥1
右侧有
αL(β1)+(1−α)L(β2)=αn(∑i=1nβ1xi−yi)2+1−αn(∑i=1nβ2xi−yi)2+αλ∥β1∥1+(1−α)λ∥β2∥1
\alpha L(\boldsymbol{\beta}_{1})+(1-\alpha)L(\boldsymbol{\beta}_{2}) = \frac{\alpha}{n} \left(\sum\limits_{i=1}^{n}\boldsymbol{\beta}_{1} \boldsymbol{x}_{i}-y_{i}\right)^{2} + \frac{1-\alpha}{n} \left(\sum\limits_{i=1}^{n}\boldsymbol{\beta}_{2} \boldsymbol{x}_{i}-y_{i}\right)^{2} + \alpha \lambda\|\boldsymbol{\beta}_{1}\|_{1}+ (1-\alpha)\lambda\|\boldsymbol{\beta}_{2}\|_{1}
αL(β1)+(1−α)L(β2)=nα(i=1∑nβ1xi−yi)2+n1−α(i=1∑nβ2xi−yi)2+αλ∥β1∥1+(1−α)λ∥β2∥1
左侧减右侧有
λ(∥αβ1+(1−α)β2∥1−α∥β1∥−(1−α)∥β2∥)
\lambda(\|\alpha \boldsymbol{\beta}_{1}+(1-\alpha)\boldsymbol{\beta}_{2}\|_{1} - \alpha\|\boldsymbol{\beta}_{1}\|-(1-\alpha)\|\boldsymbol{\beta}_{2}\|)
λ(∥αβ1+(1−α)β2∥1−α∥β1∥−(1−α)∥β2∥)
ℓ1\ell_{1}ℓ1 范数是凸范数,因此上面的式子 ⩽0\leqslant0⩽0 ,从而我们证明了凸函数.
坐标轴下降法
简单思路
坐标轴下降法的思路非常简单:
- 初始解:β^=0\widehat{\boldsymbol{\beta}}=0β=0 .
- 在未收敛的情况下,循环执行:
- 选取坐标位置 jjj .
- 解优化子问题:β^j←argminβjL(β^1,β^2,⋯ ,β^j−1,βj,β^j+1,⋯ ,β^p)\widehat{\beta}_{j} \leftarrow \arg\min_{\beta_{j}} L(\widehat{\beta}_{1},\widehat{\beta}_{2},\cdots, \widehat{\beta}_{j-1}, \beta_{j}, \widehat{\beta}_{j+1},\cdots, \widehat{\beta}_{p})βj←argminβjL(β1,β2,⋯,βj−1,βj,βj+1,⋯,βp) .
也就是每次都挑选一个坐标,下降到最小值,然后挑选出来.
下降方法
可以看到,算法当中只有子问题的求解是关键的,我们按照分量形式展开:
L(β)=∑i=1n(yi−∑j=1pxijβj)2+λ∑i=1p∣βi∣
\begin{aligned}
L(\boldsymbol{\beta}) & = \sum\limits_{i=1}^{n} \left(y_{i} - \sum\limits_{j=1}^{p}x_{ij} \beta_{j}\right)^{2} + \lambda \sum\limits_{i=1}^{p} |\beta_{i}| \\
\end{aligned}
L(β)=i=1∑n(yi−j=1∑pxijβj)2+λi=1∑p∣βi∣
此时对 βk\beta_{k}βk 求导
∂L∂βk=−2∑i=1n(yi−∑j=1pxijβj)xik+λ∂∣βk∣∂βk
\dfrac{\partial L}{\partial \beta_{k}} = -2\sum\limits_{i=1}^{n} \left(y_{i} - \sum\limits_{j=1}^{p} x_{ij} \beta_{j}\right)x_{ik} + \lambda \dfrac{\partial |\beta_{k}|}{\partial \beta_{k}}
∂βk∂L=−2i=1∑n(yi−j=1∑pxijβj)xik+λ∂βk∂∣βk∣
现在有个不符合直觉的地方,∣βk∣|\beta_{k}|∣βk∣ 是有不可导点的,但是在优化上却是可行的,因此这里引入最优化当中次梯度的概念,详见附录内容. 求其次梯度有
λ∂∣βk∣∂βk={λ,βk>0[−λ,λ],βk=0−λ,βk<0
\lambda \dfrac{\partial |\beta_{k}|}{\partial \beta_{k}} = \begin{cases}
\lambda, & \beta_{k}>0 \\
[-\lambda , \lambda], & \beta_{k}=0 \\
-\lambda, & \beta_{k} < 0
\end{cases}
λ∂βk∂∣βk∣=⎩⎨⎧λ,[−λ,λ],−λ,βk>0βk=0βk<0
然后令偏导为 000 即可达到想要的最小值.
βk\beta_{k}βk 的最优值
下面进行分类讨论,为方便解方程,将 βk\beta_{k}βk 分离出来:
∂L∂βk=−2∑i=1n(yi−∑j=1pxijβj)xik+λ∂∣βk∣∂βk=−2∑i=1n(yi−∑j≠kxijβj)xik+2βk∑i=1nxik2+λ∂∣βk∣∂βk=rk+zkβk+∂(λ∣βk∣)∂βk
\begin{aligned}
\dfrac{\partial L}{\partial \beta_{k}} & = -2\sum\limits_{i=1}^{n} \left(y_{i} - \sum\limits_{j=1}^{p} x_{ij} \beta_{j}\right)x_{ik} + \lambda \dfrac{\partial |\beta_{k}|}{\partial \beta_{k}} \\
& = -2 \sum\limits_{i=1}^{n}\left(y_{i} - \sum\limits_{j\neq k} x_{ij} \beta_{j}\right)x_{ik} + 2 \beta_{k}\sum\limits_{i=1}^{n} x_{ik}^{2} + \lambda \dfrac{\partial |\beta_{k}|}{\partial \beta_{k}} \\
& = r_{k} + z_{k} \beta_{k} + \dfrac{\partial (\lambda |\beta_{k}|)}{\partial \beta_{k}}
\end{aligned}
∂βk∂L=−2i=1∑n(yi−j=1∑pxijβj)xik+λ∂βk∂∣βk∣=−2i=1∑nyi−j=k∑xijβjxik+2βki=1∑nxik2+λ∂βk∂∣βk∣=rk+zkβk+∂βk∂(λ∣βk∣)
这里 rkr_{k}rk 对应第二个等号后的第一项,zkz_{k}zk 对应 2∑i=1nxik22 \sum\limits_{i=1}^{n} x_{ik}^{2}2i=1∑nxik2 .
当 βk>0\beta_{k}>0βk>0 时,令上式为 000 ,解得 βk=rk−λzk\beta_{k} = \dfrac{r_{k} - \lambda}{z_{k}}βk=zkrk−λ ,当 βk<0\beta_{k}<0βk<0 时,解得 βk=rk+λzk\beta_{k} = \dfrac{r_{k}+\lambda}{z_{k}}βk=zkrk+λ ,此时对 rkr_{k}rk 也有相应要求. 最终有
βk={rk−λzk,rk>λ0,−λ⩽rk⩽λrk+λzk,rk<−λ
\beta_{k} =
\begin{cases}
\dfrac{r_{k}-\lambda}{z_{k}}, & r_{k} > \lambda \\
0, & - \lambda \leqslant r_{k} \leqslant \lambda \\
\dfrac{r_{k}+\lambda}{z_{k}}, & r_{k} < - \lambda
\end{cases}
βk=⎩⎨⎧zkrk−λ,0,zkrk+λ,rk>λ−λ⩽rk⩽λrk<−λ
代码实现
这里还是先构造数据:
import numpy as np
import pandas as pd
from sklearn.datasets import make_regression

# 生成包含 100 个样本、4 个特征,噪声为 10 的数据集
X, y = make_regression(n_samples=50, n_features=4, noise=10, random_state=42)
然后就实现 LASSO :
class Lasso:
    def __init__(self, alpha=0.1, fit_intercept=True, max_iter=1000, tol=1e-4):
        """
        Lasso回归实现(坐标下降法)

        参数:
        alpha: float, 正则化强度
        fit_intercept: bool, 是否拟合截距项
        max_iter: int, 最大迭代次数
        tol: float, 收敛阈值
        """

        self.alpha = alpha
        self.fit_intercept = fit_intercept
        self.max_iter = max_iter
        self.tol = tol
        self.coef_ = None
        self.intercept_ = 0.0 if fit_intercept else None
        self._is_fit = False
        self.n_iter_ = 0

    def soft_threshold(self, rho, lamda):
        """软阈值函数"""
        if rho < -lamda:
            return rho + lamda
        elif rho > lamda:
            return rho - lamda
        else:
            return 0.0

    def loss_(self, y_pred, y_true):
        RSS = np.sum((y_pred - y_true) ** 2)
        penalty = np.sum(np.abs(self.coef_))

        # RSS 乘以 0.5 是为了符合 sklearn 的结果.
        return 0.5 * RSS + self.alpha * penalty

    def fit(self, X, y):

        n_samples, n_features = X.shape

        # 初始化系数
        if self.coef_ is None:
            self.coef_ = np.zeros(n_features)

        # 如果需要截距项,对数据进行中心化
        if self.fit_intercept:
            X_mean = np.mean(X, axis=0)
            y_mean = np.mean(y)
            X_centered = X - X_mean
            y_centered = y - y_mean
        else:
            X_centered = X.copy()
            y_centered = y.copy()

        # 坐标下降
        prev_coef = self.coef_.copy()
        for iteration in range(self.max_iter):
            for j in range(n_features):

                r_j = y_centered - np.dot(X_centered, self.coef_) + self.coef_[j] * X_centered[:, j]
                rho_j = np.dot(X_centered[:, j], r_j)
                self.coef_[j] = self.soft_threshold(rho_j, self.alpha * n_samples) / np.sum(X_centered[:, j] ** 2)
            # 检查收敛
            coef_change = np.max(np.abs(self.coef_ - prev_coef))
            if coef_change < self.tol:
                break

            prev_coef = self.coef_.copy()

        # 计算截距
        if self.fit_intercept:
            self.intercept_ = y_mean - np.dot(X_mean, self.coef_)

        self.n_iter_ = iteration + 1
        self._is_fit = True

        return self

    def predict(self, X):
        """使用拟合的模型进行预测"""
        if not self._is_fit:
            raise ValueError("[ERROR] 模型尚未训练,请先调用fit方法!")

        if self.fit_intercept:
            return np.dot(X, self.coef_) + self.intercept_
        else:
            return np.dot(X, self.coef_)
然后分别用 scikit-learn 和自己的对比:
lasso = Lasso(alpha=50)
lasso.fit(X,y)
lasso.coef_

from sklearn import linear_model
model = linear_model.Lasso(alpha=50)
model.fit(X,y)
model.coef_
出来的结果会有些许小数点上的区别,但是筛选变量会是一致的. 结果的不一样其实也是因为 sklearn 官方使用的是最小角回归法进行优化的,这里读者可以尝试阅读别的资料来进行实现。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 29
 0
- 0


 已为社区贡献2条内容

所有评论(0)