登录社区云,与社区用户共同成长
邀请您加入社区
当前天气数据应用存在明显短板:气象部门积累的海量数据(如温度、降水、风力、空气质量)分散存储于不同数据库,格式不统一,难实现多维度关联分析;传统天气呈现多为单日数值播报,缺乏历史趋势对比(如近十年同期降水变化)、区域差异分析(如同一省份不同城市温度分布),数据价值难以释放;公众获取的天气信息多为文字或简单图表,复杂数据(如台风路径预测、暴雨概率分布)难以直观理解;同时,农业、交通、能源等行业难基于
JDK版本:jdk1.8+编程语言: java框架支持:springboot数据库: mysql 版本不限数据库工具:Navicat/SQLyog都可以前端:vue.js+ElementUI开发工具:IDEA 或者eclipse都支持Vue框架是一种基于JavaScript的前端开发框架,它可以和Java后台框架协同工作,开发出前后台分离的应用程序。Vue框架非常容易上手,学习简单,功能齐全,免除
基于Python+Streamlit的旅游数据分析与预测系统:从数据可视化到机器学习预测的完整实现
摘要: 本文介绍了一个基于Spark+Django的豆瓣电影数据可视化分析系统。系统采用Hadoop+Spark处理海量电影数据,后端使用Django构建API,前端通过Vue+Echarts实现交互式可视化。核心功能包括电影信息管理、评分分析、类型统计、敏感词过滤等,利用Spark SQL和Pandas进行多维度分析,并以图表形式展示结果。系统架构稳定,支持大规模数据处理与实时分析,为用户提供直
利用Python语言、MySQL数据库,Django框架,结合目前流行的 B/S架构,将系统的各个方面都集中到数据库中,以便于毕业设计的需要。该系统在确保系统稳定的前提下,能够实现多功能模块的设计和应用。不同角色的准入制度是有严格区别的。各功能模块的设计也便于以后的系统升级和维护。该系统采用了软件组件化、精化体系结构、分离逻辑和数据等方法。开发语言:Python框架:flask django开发软
在大数据时代,数据量呈爆炸式增长,如何从海量的数据中提取有价值的信息并清晰地呈现给用户,成为了大数据领域的关键问题。数据产品的可视化展示就是解决这一问题的重要手段。本文的目的在于系统地介绍大数据领域数据产品可视化展示的技巧,涵盖从基本概念到实际应用的各个方面,帮助读者掌握如何通过有效的可视化手段,将复杂的数据转化为直观、易懂的图表和图形,从而更好地进行数据分析、决策支持等工作。本文将按照以下结构展
本文分享了17个从初阶到高阶的机器学习实战项目,包含源码和数据集。初阶项目包括鸢尾花分类、贷款预测、泰坦尼克号生存分析等;中阶项目涵盖音乐流派分类、比特币价格预测、Uber数据分析等;高阶项目涉及情感分析、语音情绪识别、非法捕鱼监测等。这些项目能帮助学习者将理论知识转化为实践能力,通过数据分析、模型构建等环节,系统提升机器学习技能。每个项目都配有详细说明,便于快速入门和理解应用场景。
摘要:本文介绍了一个基于Spark大数据处理的饮品门店数据可视化分析系统,采用Python语言开发,结合Spark、Hadoop、Django、Vue和Echarts等技术框架。系统旨在帮助饮品品牌分析市场动态、消费者需求和门店布局,通过大数据技术快速处理海量数据,提供品牌竞争力、品类格局、价格定位等多维度分析。系统功能包括数据挖掘、可视化展示和报告生成,为决策者提供直观的市场洞察,同时为计算机专
大数据的「4V特征」(Volume、Velocity、Variety、Veracity)给可视化带来了**「规模-性能-可读性」的三角矛盾**:如何在TB级数据量下实现实时、高保真、交互式的视觉表达?图像渲染技术是解决这一矛盾的核心引擎——它将抽象的大数据转化为可感知的视觉符号,同时通过工程优化突破计算瓶颈。本文从第一性原理。
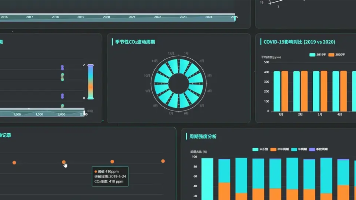
本文介绍了一个基于Python开发的全球二氧化碳数据可视化分析系统,采用Spark、Hadoop进行大数据处理,Django和Vue构建前后端,Echarts实现数据可视化。系统针对海量、多源的CO₂数据,通过时间序列分析、极值分析、波动模式分析等方法,揭示全球CO₂浓度变化趋势与规律。主要功能模块包括:趋势分析(年度/季节性变化)、极值分析(阈值突破检测)、波动分析(聚类/变异系数)和周期性分析
Spring Boot是一个基于Spring框架的新型开源框架,旨在简化Spring应用的创建、运行、调试和部署。通过自动配置和“约定优于配置”的原则,它让开发者能够快速搭建独立、生产级别的应用程序。Spring Boot由Pivotal团队提供,目标是通过最少的配置和代码来快速开发Spring应用。它使用Maven或Gradle作为构建工具,提供了丰富的starter依赖,使得项目可以快速启动并
在基于大数据的高血压人群数据可视化分析系统开发过程中,PyCharm 为 Python 代码编写提供了高效的工作环境,能够帮助开发者快速编写、调试和优化代码。实现都依赖于 PyCharm 提供的智能提示和代码自动完成功能。开发者可以通过 PyCharm 的调试工具实时跟踪代码执行过程,确保系统各个模块的逻辑正确性和性能优化。此外,PyCharm 强大的项目管理功能使得系统的多个功能模块能够高效地协
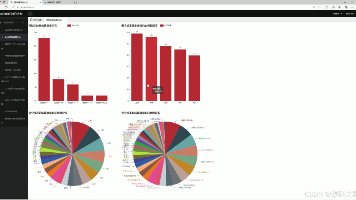
本文介绍了基于大数据的国家医用耗材集采数据可视化分析系统,采用Hadoop+Spark架构处理海量数据,结合Django/Spring Boot后端与Vue+Echarts前端实现多维分析。系统支持产品特性、价格对比、竞争格局等深度挖掘,通过Spark SQL进行高效查询,为医疗采购、监管决策提供数据支撑。开发环境涵盖Python/Java语言技术栈,集成HDFS、Pandas等技术。系统界面展示
在一线城市二手房价数据可视化系统开发过程中,PyCharm 为 Python 代码编写提供了高效的工作环境,能够帮助开发者快速编写、调试和优化代码。实现都依赖于 PyCharm 提供的智能提示和代码自动完成功能。开发者可以通过 PyCharm 的调试工具实时跟踪代码执行过程,确保系统各个模块的逻辑正确性和性能优化。此外,PyCharm 强大的项目管理功能使得系统的多个功能模块能够高效地协作和管理。
当前新能源汽车(NEV)行业数据应用存在明显短板:车企、经销商积累的销售数据(区域销量、车型偏好、价格敏感度)多分散存储,传统表格分析难快速识别市场趋势,如某区域热销车型特征、消费群体画像差异;政策制定者难直观掌握新能源汽车推广成效(如不同补贴政策下的销量变化、充电桩分布与销量关联),决策缺乏可视化数据支撑;消费者选购时,难获取客观的销量对比、续航与销量关联等数据,易受单一宣传误导;同时,销售数据
本研究设计实现了基于Hadoop的NBA球员数据分析系统,利用Hadoop分布式架构处理海量复杂赛事数据。系统通过多源数据采集、HDFS存储和MapReduce并行计算实现球员基础数据、比赛统计的高效处理,并配备可视化分析模块(图5-4)。测试表明系统性能稳定,显著提升了球员数据分析效率,为体育数据决策提供了新方案。
本文探讨了大数据时代下网站数据可视化在管理信息系统中的重要作用。以城市租房需求为例,分析了数据可视化系统对房源信息处理的优势,包括提升数据处理效率、优化决策支持等。研究对比了传统与大数据环境下的信息系统差异,从硬件优化、软件开发等角度阐述了爬虫实现数据可视化的技术价值。针对现存问题,提出了加强立法、完善反馈机制等建议,并展望了未来发展趋势。文章通过具体案例展示了大数技术在租房领域的应用前景。
本文探讨了大数据时代下网站数据可视化及其信息管理系统的开发与应用。以弹幕对影视创作影响分析为例,分析了数据可视化在管理信息系统中的意义,对比了传统与大数据环境下的系统差异,从硬件优化和软件开发角度阐述了爬虫技术的优势。研究提出了数据可视化建设的合理化建议,包括政策立法和信息反馈机制完善,并对未来发展进行了展望。
2026年企业最需要的大数据技能:学生考试表现影响因素数据可视化分析系统完美契合
本系统基于B/S开发模式,前端采用Vue框架进行页面构建,以实现用户交互的良好体验;后端运用Django框架,确保系统的稳定运行和数据的有效管理。同时,利用Echarts进行数据可视化展示,使分析结果更加直观清晰。在热度分析方面,引入随机森林回归算法,对网络小说的热度进行精准预测。系统具备丰富的管理功能,管理员可对用户信息进行管理,包括用户的注册、登录、权限设置等;对小说信息进行全面管理,涵盖小说
本文介绍了一个基于Spark的大规模气象地质灾害数据可视化分析平台,采用Python语言开发,整合Spark、Hadoop、Django、Vue和Echarts等技术框架。系统围绕时间规律、空间分布、事件特征、文本挖掘和多维关联五大维度展开分析,实现灾害数据的实时处理与可视化展示。核心功能包括年度预警趋势统计、行政区高等级预警分析、预警等级持续时长计算等,通过分布式计算提升处理效率,并结合前端可视
随着信息技术的飞速发展和互联网的普及,线上管理平台已成为当今社会经济发展的重要驱动力之一。本研究旨在设计并实现一个基于python的历届奥运会数据可视化分析系统,在技术选择上,本项目采用了Python语言,MySQL数据库编程,使用django框架管理工具。用户需要先注册账号,然后才能登录系统并使用功能。本文还对历届奥运会数据可视化分析系统的研究现状和意义进行了详细介绍。随着大数据和人工智能技术的
💕💕大数据实战项目网站实战项目安卓/小程序实战项目深度学习实战项目💟💟如果大家有任何疑虑,欢迎在下方位置详细交流,也可以在主页联系我。
全网粉丝40W+、CSDN作者、博客专家、全栈领域优质创作者、平台优质Python,JAVA创作者、专注于Python,Java、小程序技术领域和毕业项目实战💯。
本文基于已有的地铁流量训练数据,进一步聚焦多站点、多日期的流量对比分析,通过时间特征提取与可视化,验证不同站点、不同日期的流量分布规律,为后续预测模型优化提供更细致的数据支撑。
答辩现场导师连连点头:无人驾驶网约车舆情大数据可视化分析系统技术展示
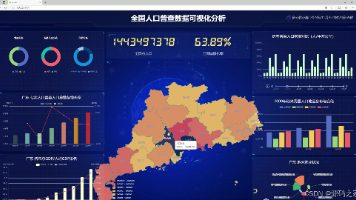
毕业设计:python全国人口普查数据可视化分析大屏 人口数量 人口密度 人口规模 人口老龄化 人口分布 Flask框架 机器学习 大数据毕业设计✅
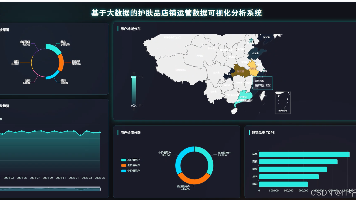
本文介绍了一个基于大数据的护肤品店铺运营数据可视化分析系统,采用Hadoop+Spark大数据处理架构,结合Python/Java语言和Django/Spring Boot框架开发。系统整合多维度店铺运营数据,通过Spark SQL和Pandas进行数据处理与分析,为护肤品商家提供营销渠道效能分析、用户画像构建、消费行为挖掘和用户增长活跃度监测等功能。前端采用Vue+ElementUI+EChar
摘要: 本研究开发了一个基于Python(Spark、Hadoop、Django、Vue、Echarts)的教育数据挖掘与职业成功关系分析系统,采用MySQL数据库和PyCharm开发环境。系统通过大数据技术分析教育背景与职业发展的关联,包含多维度功能模块:如性别/专业薪资对比、年龄与职业关注点差异、创业倾向分析、高薪因素决策树等,并以可视化图表(柱状图、热力图、雷达图等)呈现结果。研究旨在为个人
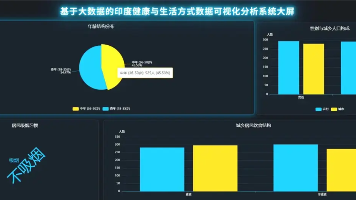
摘要:本文介绍了一个基于Hadoop的健康生活方式大数据分析系统,采用Python开发,结合Spark、Hadoop、Django等技术框架,MySQL数据库。系统针对印度人口健康数据,实现数据可视化与分析功能,包括用户管理、多维度健康指标展示、行为习惯分析等核心模块。通过年龄、性别、城乡等维度分析吸烟、饮食等生活方式对健康的影响,为公共卫生决策提供支持。系统还包含健康评估和公告管理功能,旨在提升
当前水质监测存在数据碎片化与分析滞后的问题:检测数据分散在纸质报告或独立系统中,难以形成全域水质档案;人工汇总分析效率低,难以及时发现污染趋势;检测指标与空间分布关联不足,影响污染溯源精度;同时,数据可视化程度低,决策层难快速掌握水质整体状况,制约水环境治理的科学性与时效性。基于 SSM(Spring+SpringMVC+MyBatis)的水质检测管理与数据可视化系统,依托企业级框架的数据整合能力
python地铁数据可视化分析系统 Flask框架 爬虫 数据分析 轨道数据 地铁数据分析 大数据 计算机专业(建议收藏)✅
本文介绍了一个基于机器学习的农产品价格数据分析可视化系统。该系统采用大数据技术栈,整合Hadoop分布式存储和Spark处理能力,对农产品市场价格进行深度挖掘与分析。系统使用Python开发核心算法模块,结合Django后端和Vue前端框架,实现数据采集、处理、分析和可视化功能。核心功能包括蔬菜/水产品信息管理、价格预测分析等模块,运用Spark SQL、Pandas和NumPy等工具进行数据查询
Java简介Java是一种面向对象的静态式编程语言。Java编程语言具有多线程和对象定向的特点。其特点是根据方案的属性将方案分为几个不同的模块,这些模块是封闭的和多样化的,在申请过程中具有很强的独立性。Java语言在计算机软件开发过程中的运用可以达到交互操作的目的,通过各种形式的交换,可以有效地处理所需的数据,从而确保计算机软件开发的可控性和可见性。开发java语言时,保留了网络接口,Java保留
当前租房市场存在信息碎片化与决策低效的问题:海量房源数据分散于多个平台,缺乏标准化整合;租金波动、区域差异等关键信息难以直观把握,租客易陷入选择困境;房东缺乏市场基准制定合理价格;同时,政策制定者缺乏数据支撑进行租赁市场调控,制约住房租赁市场的规范化发展。基于大数据的租房数据可视化分析系统,依托分布式计算与可视化技术,构建 "采集 - 处理 - 分析 - 展示" 全流程体系:整合多平台租房数据形成
本文设计并实现了一个基于Hadoop技术的音乐推荐系统,采用Python、Django框架和MySQL数据库开发。系统通过爬虫采集网易云音乐平台的用户关注数据,利用Hadoop进行大数据处理,实现歌单管理、用户行为分析等功能。核心的数据可视化模块采用Echarts图表库,展示用户统计、歌单播放量、歌曲时长等多维度分析结果。系统通过Spark框架实现高效计算,将处理结果存入Hive数据库,前端使用V
本文研究了基于Hadoop和Echarts的京东消费者行为分析与可视化系统。系统通过Python爬虫采集京东商品数据,利用Django框架开发,实现数据存储、处理及可视化分析。核心功能包括护肤品和男士化妆品管理、营销策略分析以及多维度的数据看板展示(如价格分布、商品评论、地区占比等)。系统采用Echarts进行数据可视化,通过Hadoop处理海量数据,有效解决了电商信息过载问题。测试表明,该系统运
摘要:本文设计并实现了基于Hadoop的百色芒果销售系统,通过数据采集、处理与分析提升销售效率。系统集成ECharts、Spark等技术,提供用户统计、价格分析、销量预测等可视化功能模块。采用Hadoop分布式存储处理天猫平台数据,结合Django后端和Vue前端构建管理平台。实证表明,该系统有效解决了传统销售模式的信息不对称问题,为农业数字化转型提供示范。核心功能包括数据抓取、清洗、预测及可视化
本研究设计并实现了一个基于Hadoop的网易云音乐推荐系统,采用Django框架开发,整合爬虫数据采集、Hadoop存储、Spark分析和MySQL数据库管理。系统具备歌单管理、用户管理和数据可视化功能,通过ECharts展示播放量、订阅量等关键指标。测试表明系统运行稳定,能有效分析用户行为特征,提升音乐推荐效率。该系统融合大数据处理与可视化技术,为音乐平台运营决策提供了有力支持。
本文设计了一个基于Spark的物流大数据处理系统,实现了从数据抓取到可视化分析的全流程。系统通过Python爬虫获取物通网物流数据,经Spark进行清洗和分析后存储于MySQL数据库,并采用Django+Vue.js框架构建可视化面板。核心功能包括公司名、车长/载重统计、出发/到达城市等关键指标展示,有效提升了物流企业的数据决策能力。测试表明系统运行稳定,处理高效,为物流行业智能化转型提供了可行方