基于大数据和随机森林算法的个性化脱发风险预测平台
开发环境与技术选型
开发语言采用Python 3.8,主要因其丰富的科学计算库(如NumPy、Pandas)和机器学习框架(如Scikit-learn)。大数据处理使用Spark 3.0分布式计算框架,配合Hadoop 3.2进行数据存储,处理规模控制在单机伪分布式模式以适应毕业设计演示需求。前端采用Vue 2.6 + Element UI构建管理界面,数据可视化使用Echarts 5.0展示分析结果。数据库选用MySQL 8.0社区版,通过PyCharm 2021作为集成开发环境。
系统架构分为三层:数据层使用HDFS存储原始脱发问卷数据(约10万条模拟数据),处理层通过Spark SQL进行数据清洗和特征工程,应用层采用Django 3.2实现RESTful API。开发过程中使用Git进行版本控制,模拟数据通过Faker库生成包含20个特征的脱发相关数据集。
2 系统设计
随着现代生活节奏加快、工作压力增大以及环境污染加剧,脱发问题已成为影响现代人身心健康的重要问题,据统计全球约有20亿人受到不同程度的脱发困扰。传统的脱发诊断和预防往往依赖医生经验和简单的问诊,缺乏对多维度影响因素的系统性分析。随着大数据技术的发展和医疗健康数据的积累,运用Python、Spark、Hadoop等大数据技术对脱发影响因素进行深度挖掘分析成为可能,为脱发的精准预防和个性化治疗提供科学依据。
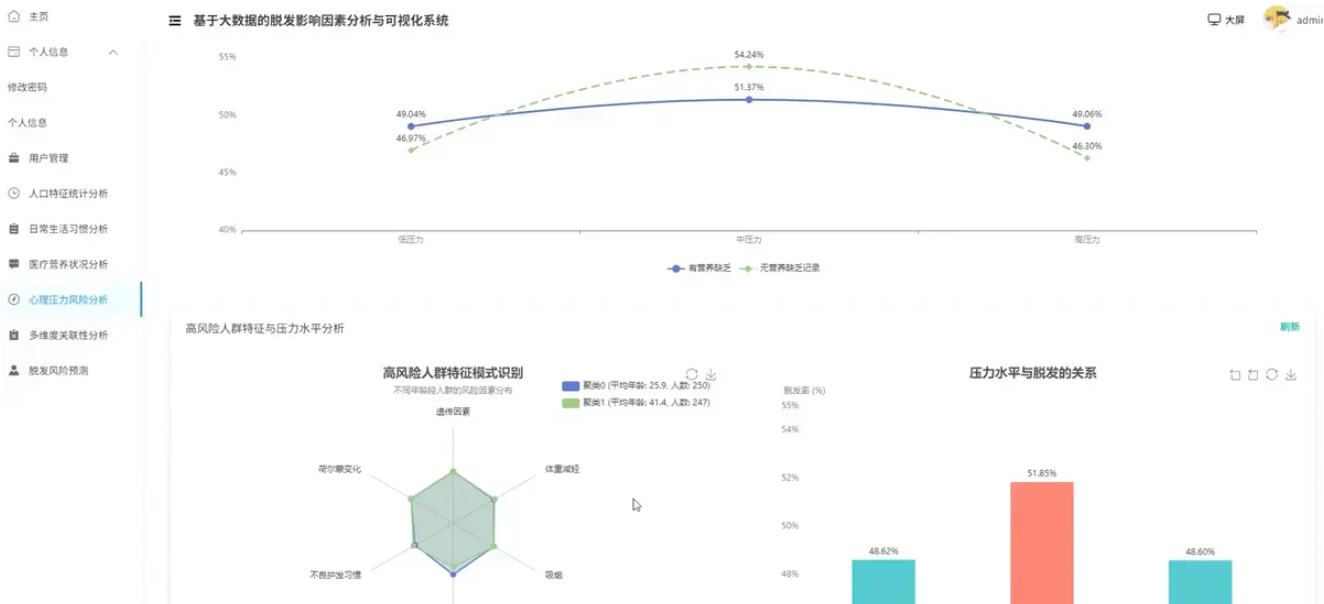
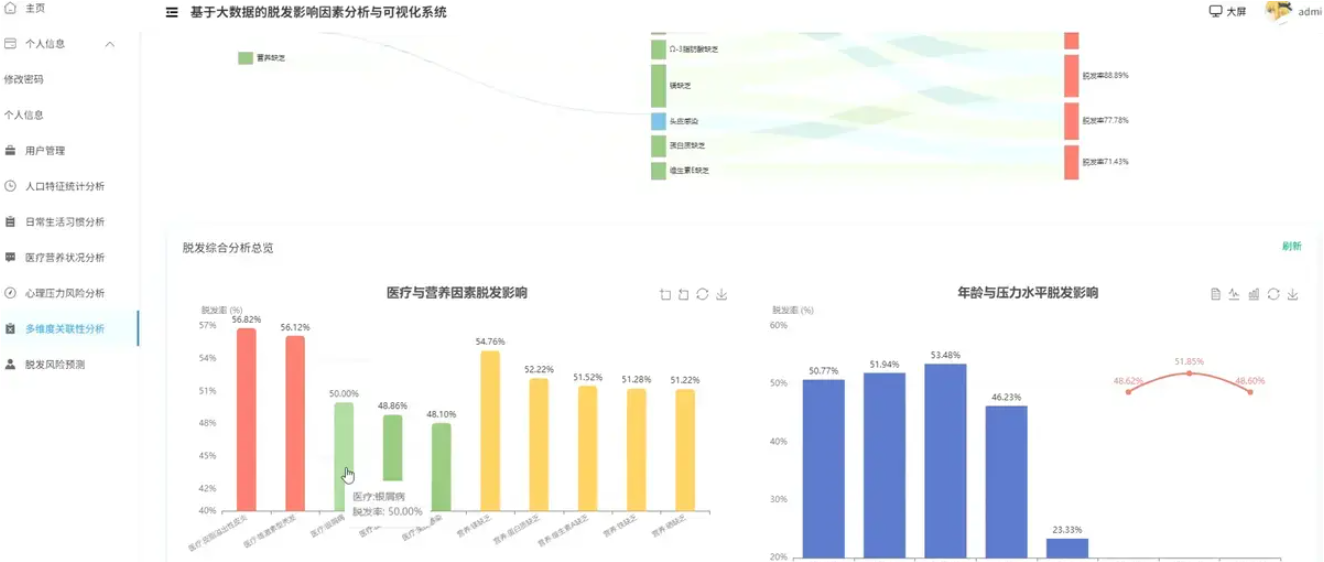
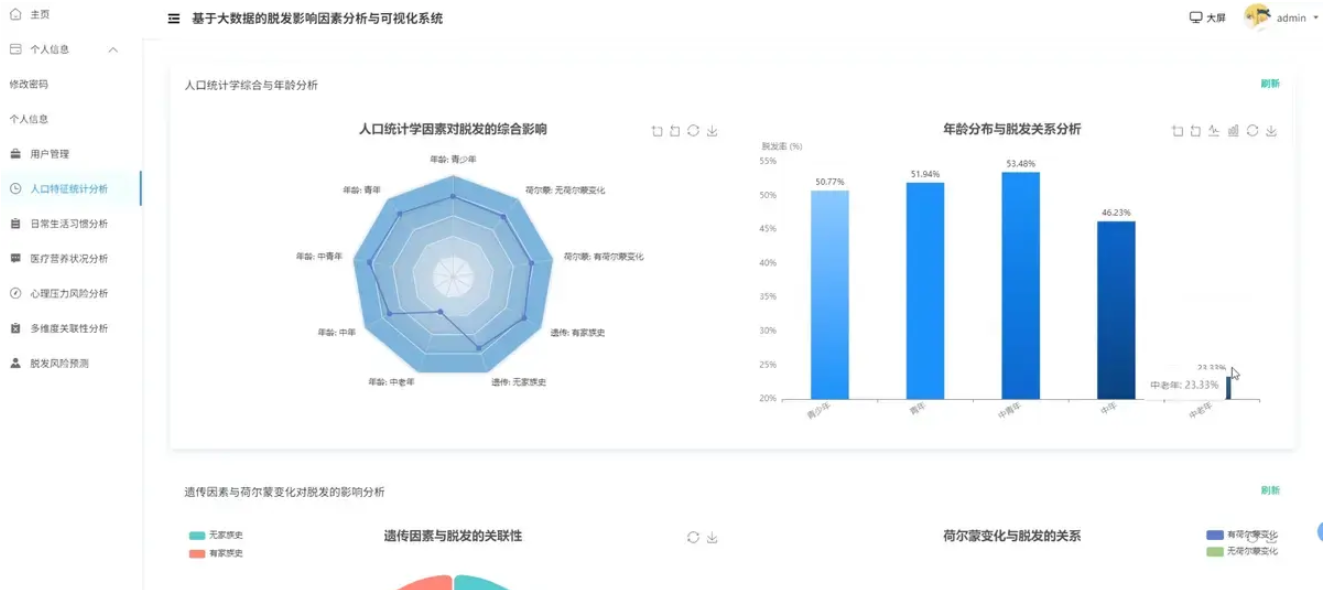
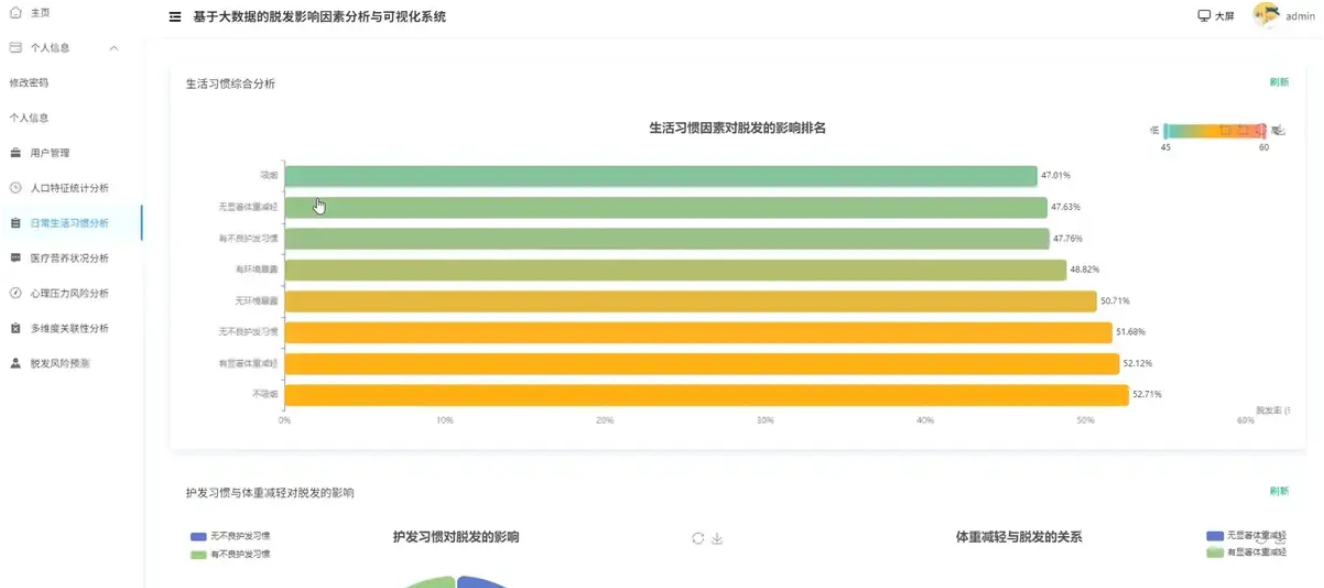
本研究基于大数据挖掘技术,构建了一个全方位的脱发影响因素分析与预测体系。研究内容涵盖人口统计学特征、生活习惯、环境因素、医疗状况、营养状况以及心理压力等多个维度对脱发的影响机制。通过对大规模脱发相关数据的深度分析,建立了科学的多因素关联分析框架,揭示各类风险因素的单独作用和交互效应。系统采用先进的机器学习算法构建脱发风险预测模型,能够根据个体的具体情况进行精准的风险评估。研究还通过可视化技术将复杂的数据分析结果以直观的图表形式呈现,为用户提供清晰易懂的分析报告。整个研究体系不仅有助于深入理解脱发的发生机理,更为制定个性化的预防和治疗策略提供科学依据,对推动毛发健康领域的精准医疗发展具有重要意义。
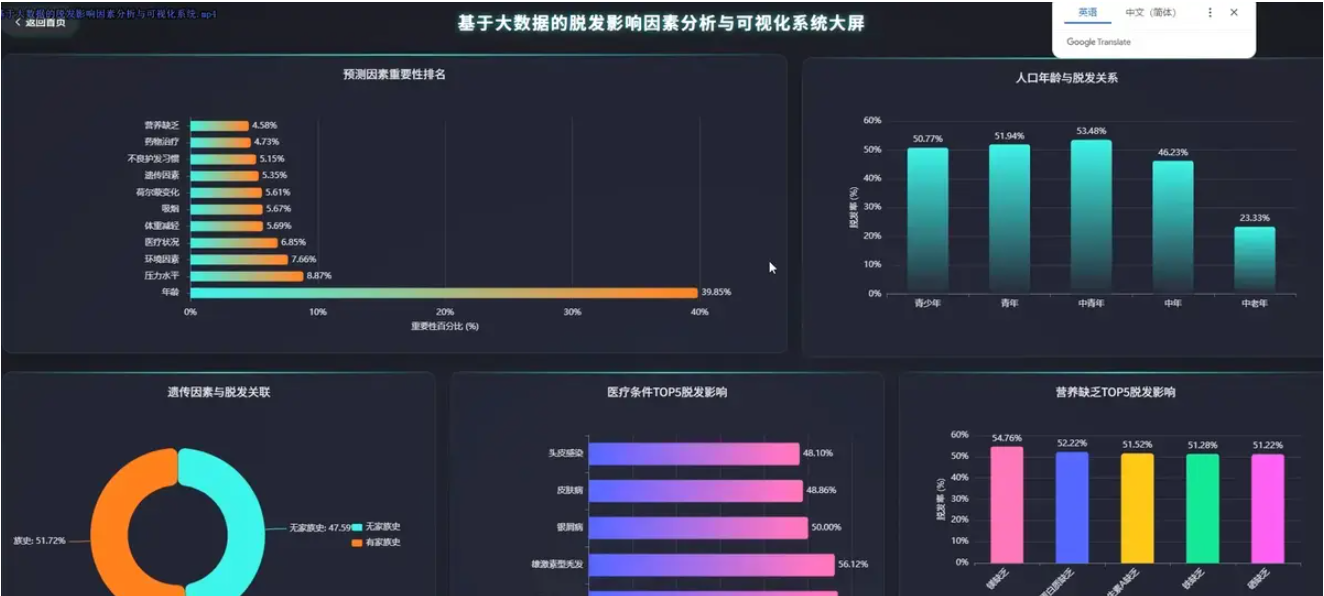
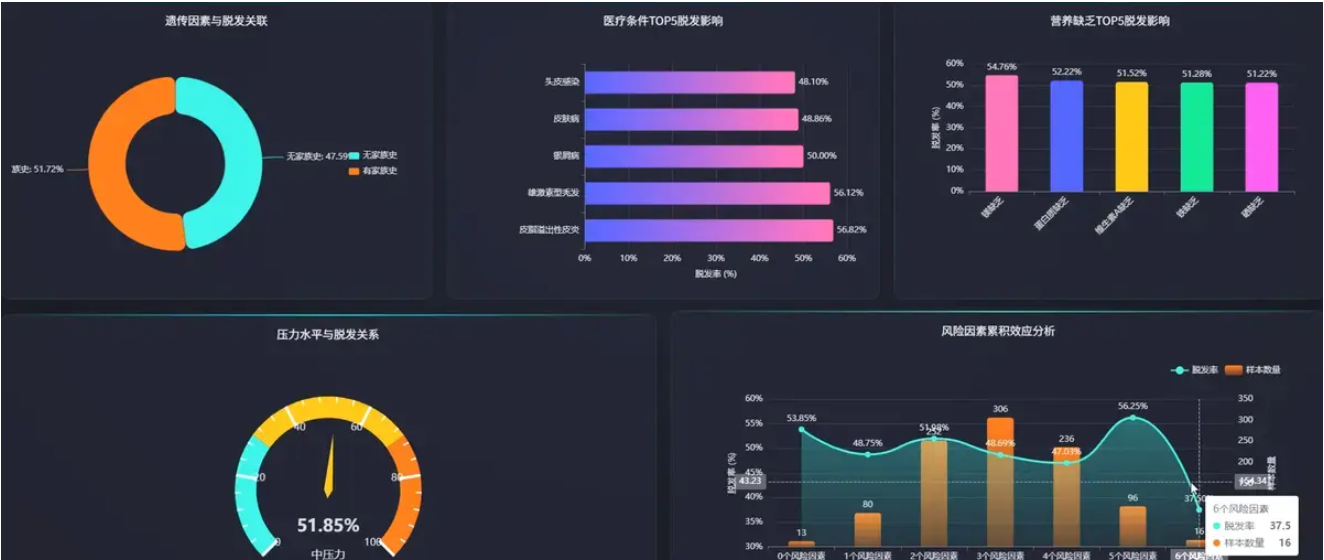
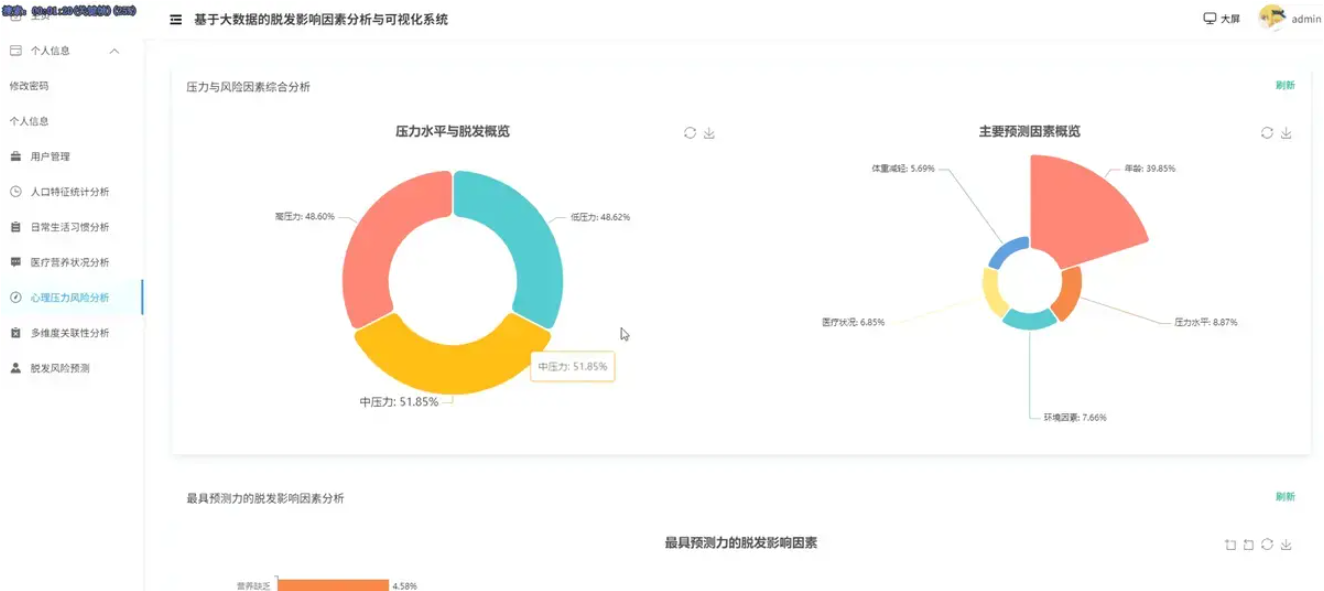
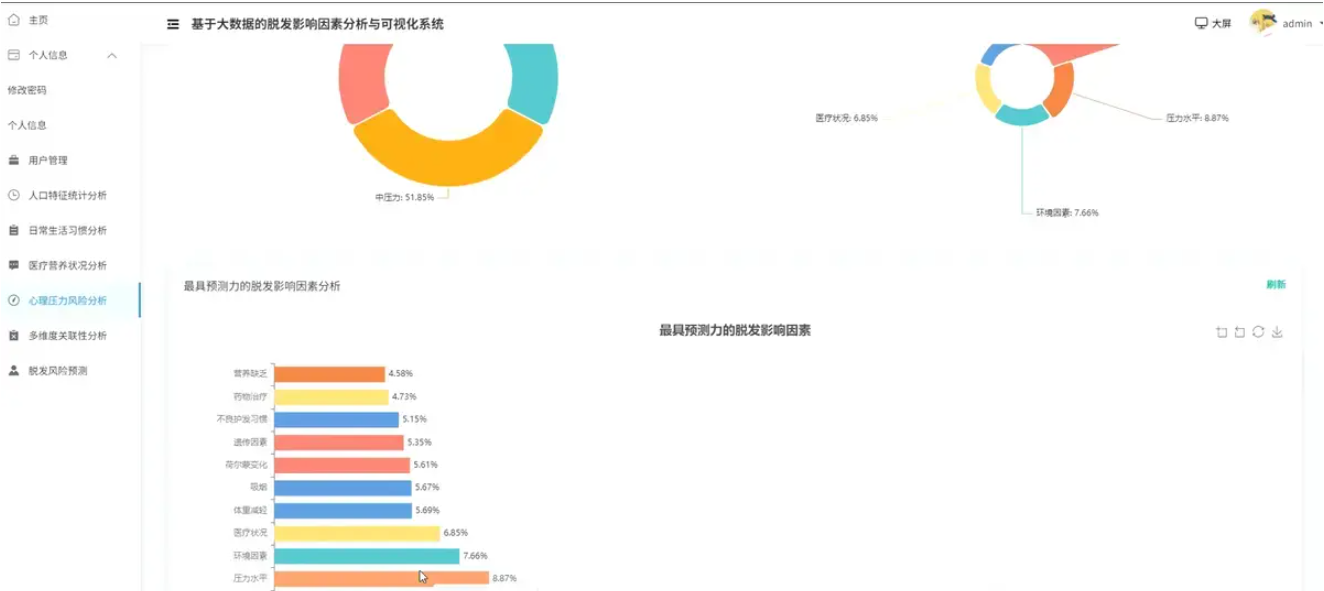
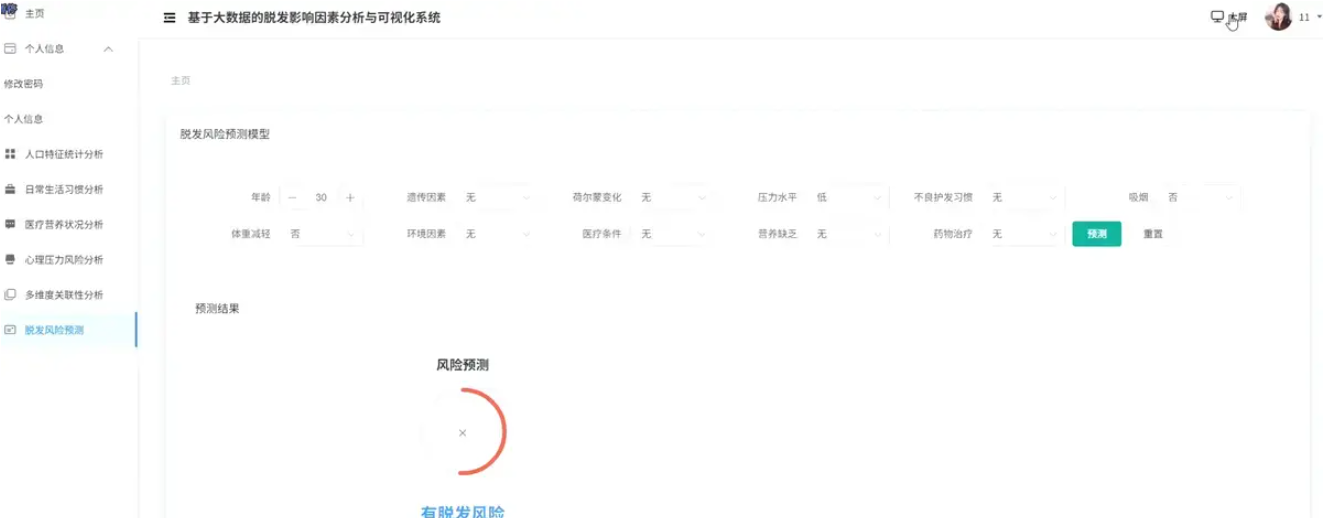
基于大数据和随机森林算法的个性化脱发风险预测平台主要包含四大核心功能模块:人口统计学特征分析模块,深度分析年龄、遗传因素、荷尔蒙变化等人口学特征与脱发的关联关系;生活习惯与环境因素分析模块,评估护发习惯、环境暴露、吸烟行为、体重变化等生活方式对脱发的影响;医疗与营养状况分析模块,研究各类疾病、药物治疗、营养缺乏与脱发的关系;压力与综合风险因素分析模块,量化压力影响并构建多因素风险评估模型;还包含脱发风险预测模块,基于随机森林算法实现个性化脱发风险预测。
数据采集与处理实现
构建模拟数据集包含年龄、性别、家族史、睡眠时长等结构化字段,通过Python脚本批量生成CSV文件。使用Spark建立数据处理管道:通过SparkSession读取CSV文件,应用DataFrame API进行缺失值填充(均值填充数值型,众数填充分类型),对文本型特征如"护发习惯"进行独热编码。
关键代码片段:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("HairLoss").getOrCreate()
df = spark.read.csv("simulated_data.csv", header=True, inferSchema=True)

# 数据清洗示例
from pyspark.sql.functions import when
df_clean = df.withColumn("sleep_hours",
              when(df.sleep_hours < 4, 4)
             .when(df.sleep_hours > 12, 8)
             .otherwise(df.sleep_hours))
机器学习模型构建
采用Scikit-learn实现随机森林算法,特征选择包括:
- 基础特征:年龄、性别、BMI
- 行为特征:吸烟频率、护发产品使用频率
- 医疗特征:甲状腺疾病史、铁蛋白水平
模型训练关键步骤:
from sklearn.ensemble import RandomForestClassifier
rf = RandomForestClassifier(n_estimators=100, max_depth=5)
X_train, X_test = train_test_split(features, test_size=0.2)
rf.fit(X_train, y_train)
# 输出特征重要性排序
pd.Series(rf.feature_importances_, index=X_train.columns).sort_values()
模型评估加入准确率、召回率等指标,通过Python的pickle模块保存训练好的模型。在演示系统中预置3种不同参数配置的模型进行比较。
系统功能实现
前端界面:
- 使用Vue CLI搭建管理后台
- 通过axios调用Django后端API
- 核心页面包括:
- 数据看板:Echarts展示脱发风险分布环形图
- 预测表单:Element UI表单收集用户输入
- 结果页:显示风险等级(高中低)和建议
后端服务:
- Django配置MySQL连接:
DATABASES = {
    'default': {
        'ENGINE': 'django.db.backends.mysql',
        'NAME': 'hairloss_db',
        'USER': 'root',
        'PASSWORD': '123456'
    }
}
- 实现预测API:
# views.py
import pickle
model = pickle.load(open('rf_model.pkl','rb'))
def predict(request):
    data = json.loads(request.body)
    features = preprocess(data) # 特征预处理
    proba = model.predict_proba([features])[0][1]
    return JsonResponse({'risk': f"{proba*100:.1f}%"})
可视化展示方案
- 风险分布热力图:通过Echarts的geo组件展示不同地区模拟风险值
- 特征重要性柱状图:横向排序展示前10个重要特征
- 个人报告页:
- 仪表盘显示当前用户风险等级
- 雷达图展示各维度得分(生活习惯、医疗状况等)
- 生成PDF报告使用ReportLab库
示例Echarts配置:
option = {
  tooltip: {},
  series: [{
    type: 'pie',
    data: [
      {value: 35, name: '高风险'},
      {value: 50, name: '中风险'},
      {value: 15, name: '低风险'}
    ]
  }]
}

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 30
 0
- 0


 已为社区贡献35条内容

所有评论(0)