登录社区云,与社区用户共同成长
邀请您加入社区
具体到落地上,我们可以通过Copilot Labs,在Copilot Daily中以AI主播播报要闻、在Copilot Podcasts生成播客式讨论,Copilot Labs 提供可玩Demo(可以自定义内容、叙述风格等)。这标志着在多年依赖OpenAI模型之后,微软AI部门正式与OpenAI及整个行业正面竞争,也意味着微软在AI竞赛中,开始掌握更多主动权。我们必须具备内部能力,来打造世界最强的
VOS3000注册IMS的核心在于。
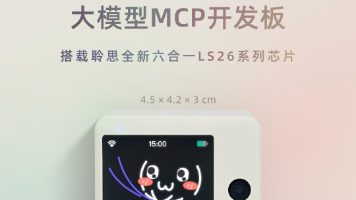
Arcs-Mini是聆思打造全新大模型MCP开发板小巧机身,蕴含强大能量,实现真人般自然对话体验,会感知、会表达、会表情、懂共情,独家人声滤噪,无惧嘈杂环境。
成效:靠泊精度±10cm,靠泊时间-25%,事故率-40%(青岛港2024)成效:能见度<200m时引导成功率98%,停航时间-30%(宁波港2025)成效:空蚀面积估计误差<5%,维修成本-20%(COSCO 2025)成效:清洗周期优化后,发电量+8%,人工-90%(青岛港2024)成效:船队利用率+12%,管理决策时间-70%(中远海运2025)成效:吊具摆动幅度-40%,作业效率+12%(
基于MFCC 特征提取 + CNN 深度学习的完整语音识别实现方案,支持中文 / 英文语音指令识别,包含数据预处理、特征提取、模型训练、评估与预测全流程,代码可直接运行并适配自定义数据集。
本文介绍了基于Torchaudio库的WAV2VEC2_ASR_BASE_960H模型实现语音特征提取和转文本的完整流程。首先在Bitahub平台创建开发环境,然后详细讲解了数据处理、模型加载、特征提取和可视化等关键步骤。通过调整音频采样率、提取Transformer层特征,并使用贪心解码算法将语音转换为文本。实验成功实现了语音到文本的转换,展示了深度学习在语音处理领域的应用潜力。该方法可广泛应用
FunASR的说明文档,不太对,有个坑。
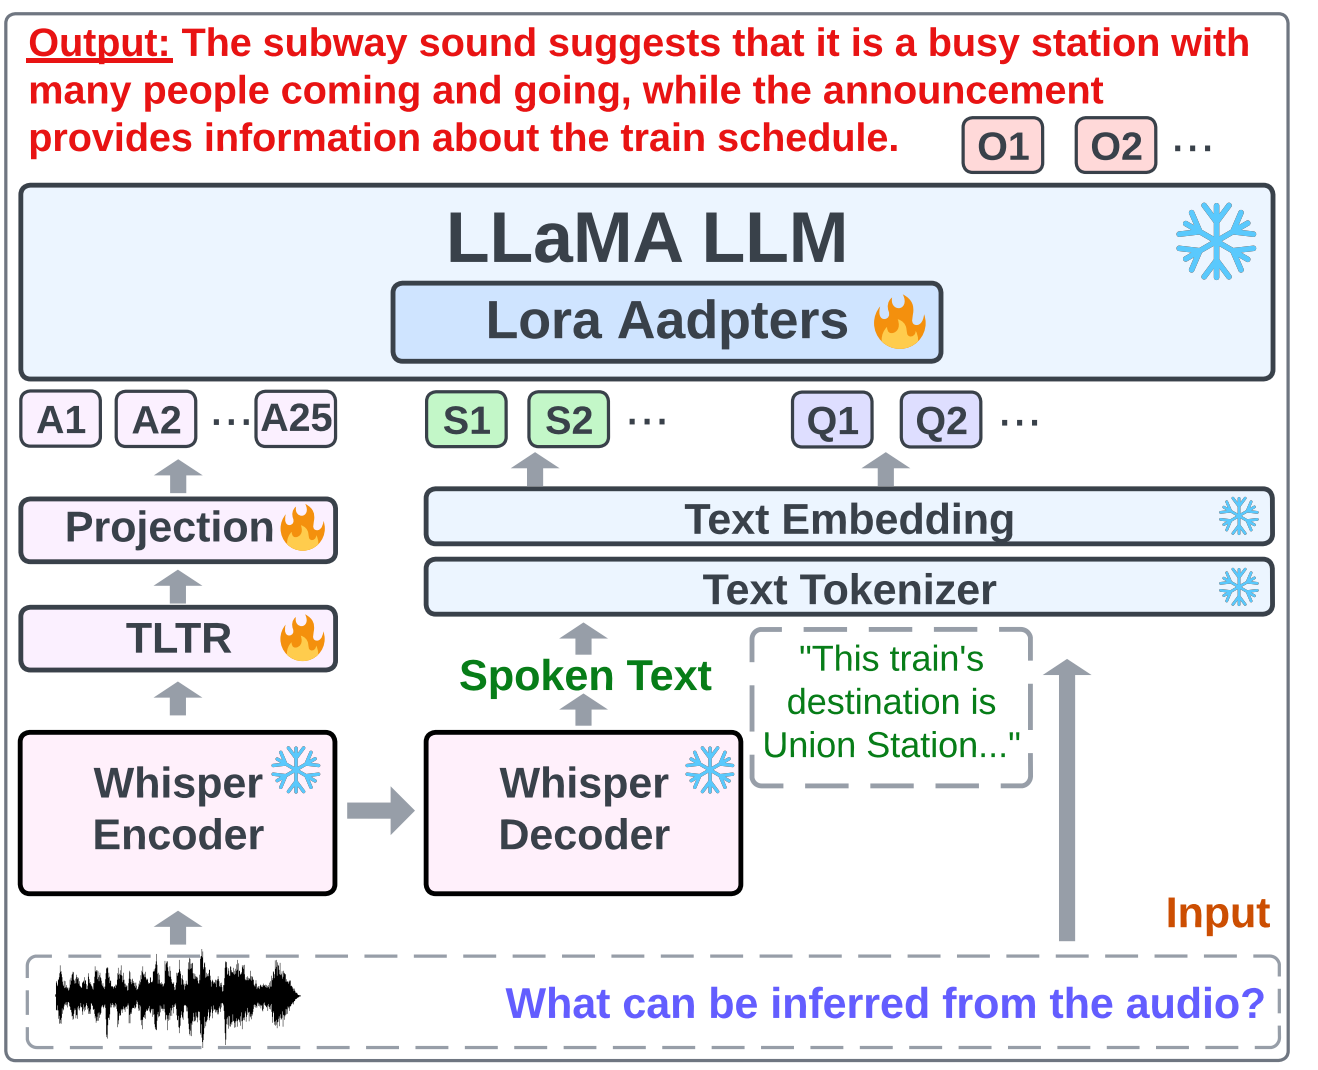
人类生活在一个多样化的音频信号环境中,包括语音和各种非语音声音。人可以准确辨识、解释和整合这些语音和非语音音频元素,以及深刻理解它们之间的关系。无所不能的人工智能也应该具备这样的能力!于是论文提出了一种新的模型结构LTU-AS,下图展示了LTU-AS效果,我们看一下第一个示例:感知到了人声和篮球弹跳的声音,同时基于识别出的说话内容,推测出这个说话人正在指导别人打篮球教练。可以看出这个模型同时具备了
https://blog.csdn.net/mr_yuanshen/article/details/152607724?sharetype=blogdetail&shareId=152607724&sharerefer=APP&sharesource=2401_85812043&sharefrom=link
本文总结了大模型微调的核心流程和LoRA原理。微调流程包括:明确目标与数据准备、数据预处理、加载基座模型并设置参数、配置训练超参数、进行训练验证、评估优化、保存部署。重点介绍了参数高效微调方法LoRA的原理,它通过在基座模型旁添加两个低维矩阵相乘生成适配层,与原模型输出相加,既能提升性能又减少计算量。全文以实战经验为基础,系统梳理了大模型微调的关键环节和技术要点。
自然语言处理与AWS AI服务》是一本实践指南,旨在帮助IT专业人士快速实现人工智能/机器学习解决方案。本书由某机构前员工Mona Mona和某机构AI/ML专家Premkumar Rangarajan共同编写。
本教程介绍使用Torchaudio库中的WAV2VEC2_ASR_BASE_960H模型实现语音特征提取和转文本任务。主要内容包括:1)在Bitahub平台创建项目环境;2)加载预训练模型并处理语音数据;3)可视化展示不同Transformer层的特征提取结果;4)通过GreedyCTCDecoder算法将语音转换为文本。实验成功将示例语音转换为"I|HAD|THAT|CURIOSITY
本文介绍了如何在星图GPU平台上自动化部署FireRedASR-AED-L镜像,实现本地语音识别功能。该镜像支持中文、方言及中英混合语音的离线识别,适用于会议记录、课程转录等隐私敏感场景,提供完全本地化的音频处理与转写解决方案。
本文介绍了如何在星图GPU平台上自动化部署FireRedASR-AED-L镜像,实现本地化、高精度的语音识别服务。该方案基于1.1B参数大模型,能够自动处理音频格式并支持GPU/CPU自适应,特别适用于识别带口音的普通话、中英混合语音及部分方言,为离线语音转文字提供了便捷的工业级解决方案。
本文介绍了如何在星图GPU平台上自动化部署🎙️ Qwen3-ASR-0.6B智能语音识别镜像,实现高效的语音转文本服务。该镜像支持中英文混合识别及多种音频格式处理,典型应用于会议记录转录、音频内容分析等场景,帮助用户快速构建可扩展的语音识别API。
本文介绍了如何在星图GPU平台上自动化部署Qwen3-ASR-1.7B镜像,实现高效的多语言语音识别。该平台简化了部署流程,用户可快速搭建语音转文本服务,适用于实时字幕生成、智能语音助手等应用场景,提升音频处理效率。
在当今数字化和智能化的时代,语音信号情绪检测具有重要意义。它广泛应用于多个领域,如客户服务中心,通过检测客户语音中的情绪,客服人员可以更有针对性地提供服务,提高客户满意度;在心理健康领域,能够辅助医生及时发现患者情绪状态的变化,为诊断和治疗提供依据;在人机交互系统中,使机器能够理解人类情绪,提供更加个性化、自然的交互体验,增强用户与机器之间的沟通效果。
本文详细介绍了如何利用ESP32微控制器结合LD3320语音识别模块和SYN6288语音合成模块,打造一个智能语音管家。从硬件选型、连接配置到软件实现,提供保姆级教程,帮助开发者快速构建具备语音交互功能的物联网设备,适用于智能家居等多种场景。
本文详细介绍了如何在Java项目中集成主流云服务(Google、Azure、AWS)实现高精度语音识别(ASR),包括API对比、统一接口设计、性能优化及成本控制策略。通过实战案例展示音频转文本的最佳实践,帮助开发者快速实现高效、可扩展的语音识别解决方案。
本文详细介绍了如何使用Python和OpenAI的Whisper语音识别模型实现会议录音转文字的全流程。从环境配置、音频预处理到核心代码实现与参数调优,提供了完整的解决方案和实用技巧,帮助职场人士高效生成会议纪要,大幅提升工作效率。
语音识别(STT)和自然语言处理(NLP)是构建智能语音助手的核心技术。通过将大语言模型(LLM)与实时决策引擎结合,系统能够动态处理包含条件判断和多步骤操作的复杂交互流程。这种架构在智能客服、智能家居等领域具有广泛应用价值,能显著提升用户体验和操作效率。本文以AsyncVoice Agent为例,详细解析了如何通过流式处理管道和增量式规划算法实现低延迟交互,并分享了模型量化和缓存策略等性能优化实
本文深入解析DTW(Dynamic Time Warping)算法在语音识别和金融时序匹配中的核心应用。通过Python手写实现DTW算法,对比欧氏距离的局限性,展示其在处理变长序列、局部时序偏移和噪声容忍方面的优势。文章包含详细的代码实现、实战案例(语音指令识别和股票模式匹配)以及性能优化策略,帮助开发者高效解决时序对齐难题。