登录社区云,与社区用户共同成长
邀请您加入社区
AI 编程迈入新阶段:Anthropic 的 Claude 完成费马大定理的端到端形式化证明,展现其自主完成复杂工程的能力。然而,现实中的开发仍受限于工具割裂、算力不足与安全管控难题。TitanIDE 作为企业级云端开发平台,通过内置 Claude Code、云端沙箱、多模型兼容、60+ 工具集成与企业级审计能力,将 AI 编程门槛降至“打开浏览器即可上手”,实现个人提效与企业可控的统一,推动 A
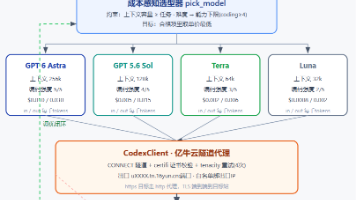
选型不是一个拍脑袋的动作,而是一组可度量的约束。配置收进 dataclass,选型抽成带成本和能力约束的独立函数,跑批效果用 Metrics 回收,代理走亿牛云隧道解决国内访问,整套基本能自治。先把最小可用版本跑通,再拿真实的 p95 和成本往细里调,比一上来追求完美方案实在。Codex 把模型摆在你面前,怎么用省、怎么用稳,才是真功夫。
Claude Code 的子 Agent 只有一个机制——独立的上下文窗口。它的全部收益和全部失败都来自这一处隔离:研究、并行、无偏审查因隔离而成立,顺序依赖、同文件改动、跨 Agent 协调因隔离而失败。本文给出判断委派与否的单一提问、五种调用方式的升级顺序,以及自定义 Agent 越多路由越差的原因。
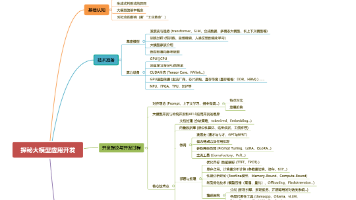
大模型技术的爆发,以前所未有的速度重塑着技术格局。一夜之间,“AI”从遥远概念变成街谈巷闻,学习和应用大模型似乎成了开发者不容错过的时代机遇。
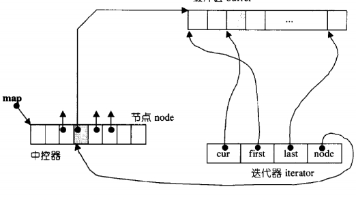
在 C++ 标准模板库(STL)中,容器适配器是一类特殊的容器,它们基于现有的容器类进行封装,提供特定的接口来满足不同的数据结构需求。本文将深入探讨三种主要的容器适配器:stack(栈)、queue(队列)和 priority_queue(优先队列),包括它们的使用方法、实现原理以及底层容器选择。
解决方案:数据卷不能写E:/goland/testdata/redis_data,要写/E:/goland/testdata/redis_data。注意:我把git安装在/usr/local/git/bin,如果goland提示git找不到,可以configure修改一下文件路径。说明:这部分信息仅作为踩坑记录,这次我失败了。虽然扩容成功,但虚拟机变得不能用了,无法上网和ssh连接,我找不到问题在
在 Qt 的工具箱中,QByteArray是一个我们每天都会使用的基础类,但 Qt 还提供了一个不那么常见但非常强大的“秘密武器”——。它们都看似“数组”,但设计哲学和适用场景却截然不同。本文将深入解析,并将其与QByteArray进行详细比较,帮助你为特定场景选择最合适的工具。
今天我们了解了配置中心在微服务架构下的使用场景。对于开发人员来说,“动态属性推送”应该是我们在工作中最常用到的功能点了,尤其在拥抱变化的互联网公司更是如此。因为互联网行业的需求变动非常频繁,如何巧妙地利用配置中心的动态推送功能,将“变化的需求部分”和“不变的代码部分”隔离开来,是开发业务场景时需要着重考虑的。我来举一个例子,很多电商APP上都有商品资源位,根据各种活动场景的不同,这些资源位的样式和
本文深入解析Java三大核心特性:反射、枚举与Lambda表达式。反射机制赋予程序运行时动态操作类的能力,是Spring等框架的基石,但存在性能开销和安全隐患;枚举类型提供类型安全的常量集合,支持丰富功能且天然防反射破坏;Lambda表达式通过简洁语法实现函数式编程,极大简化集合操作,但需注意可读性和调试难度。三者各具优势:反射实现动态性,枚举确保类型安全,Lambda提升编码效率,开发者应根据场
get;set;} }{ }set;stringget;set;message} }Inapp.config</</</</</Prism 的依赖注入机制通过和管理模块、视图和服务的依赖,与事件聚合、多区域导航和动态模块加载无缝集成。您的代码通过 Autofac 注册全局服务(如)和模块服务(如),但的问题需修复。通过添加ModuleC、工厂模式和条件注入,展示了高级 DI 功能。事件聚合()和多
1.开始用2.1版本的spark客户端依赖,该版本貌似只适合用spark streaming 方式,使用structured streaming兼容性不好,整半天没行,该版本自带的kafka客户端是0.1.0(大坑!3.最后在我几十次调试之后,直接上了2.4.8的客户端版本,这个版本我之前hive-redis的时候用过,没遇到问题(实在是我们生产2.1.0太老了),这个2.4.8版本自带的是kaf
MATLAB 2023版的深度学习工具箱,提供了完整的工具链,使您能够在一个集成的环境中进行深度学习的建模、训练和部署。与Python相比,MATLAB的语法简洁、易于上手,无需繁琐的配置和安装,让您能够更快地实现深度学习的任务。
CNN提取的特征是怎样的?3、LeNet、AlexNet、Vgg-16/19、GoogLeNet、ResNet等经典深度神经网络的区别与联系。4、预训练模型(Alexnet、Vgg-16/19、GoogLeNet、ResNet等)的下载与安装。2、经典自编码器(栈式自编码器、稀疏自编码器、去噪自编码器、卷积自编码器、掩码自编码器等)6、调参技巧(参数初始化、数据预处理、数据扩增、批量归一化、超参数
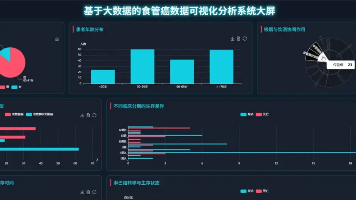
本文介绍了一个基于Python的食管癌临床特征分析与预测系统。系统采用Spark、Hadoop、Django、Vue等技术框架,结合MySQL数据库,通过机器学习方法对食管癌多维度数据进行深度分析。系统包含四个核心功能模块:患者基本特征分析、风险因素关联分析、预后因素分析以及治疗方案评估,旨在从流行病学、病因学等多角度挖掘食管癌发病规律。该系统整合了临床数据、病理资料等资源,运用大数据处理和可视化
摘要:本文介绍了一个基于Spark大数据处理的饮品门店数据可视化分析系统,采用Python语言开发,结合Spark、Hadoop、Django、Vue和Echarts等技术框架。系统旨在帮助饮品品牌分析市场动态、消费者需求和门店布局,通过大数据技术快速处理海量数据,提供品牌竞争力、品类格局、价格定位等多维度分析。系统功能包括数据挖掘、可视化展示和报告生成,为决策者提供直观的市场洞察,同时为计算机专
数据结构存储单位大小特性核心优势适用场景字节动态大小灵活、连续内存、适合变长数据网络缓冲区、文件内容、动态字节流字节固定大小(编译期)无动态开销、栈上分配协议头、固定长度哈希/UUID字节动态大小兼容字符串操作,支持混合数据文本+二进制混合数据、带标识的字节流比特固定大小(编译期)高效比特操作、空间紧凑标志位、固定长度比特字段比特动态大小动态调整比特数,空间优化变长比特流、动态布尔状态集合根据需求
流量控制:通过直接 / 关联 / 链路模式,结合快速失败 /warm up / 排队效果,提前挡住突发流量,预防雪崩。隔离降级:通过线程隔离(仓壁模式)和熔断降级,在服务故障时控制影响范围,避免级联失败。实际项目中,要根据业务场景选择合适的规则 —— 比如秒杀接口用 warm up + 热点参数限流,慢服务调用用线程池隔离,核心接口用熔断降级。多测试、多调优,才能让微服务更稳定~
本文介绍了一个基于Python和大数据技术的全球能源消耗分析可视化系统。系统采用Spark、Hadoop处理海量能源数据,Django和Vue构建前后端,Echarts实现数据可视化,MySQL存储数据。通过对各国能源消耗、碳排放等指标的多维度分析,系统为能源政策制定提供数据支撑。前端大屏页面直观展示全球能源趋势、国家对比等分析结果,实现了复杂能源数据的交互式可视化呈现。
在基于大数据的商品推荐系统开发过程中,PyCharm 为 Python 代码编写提供了高效的工作环境,能够帮助开发者快速编写、调试和优化代码。实现都依赖于 PyCharm 提供的智能提示和代码自动完成功能。开发者可以通过 PyCharm 的调试工具实时跟踪代码执行过程,确保系统各个模块的逻辑正确性和性能优化。此外,PyCharm 强大的项目管理功能使得系统的多个功能模块能够高效地协作和管理。