登录社区云,与社区用户共同成长
邀请您加入社区
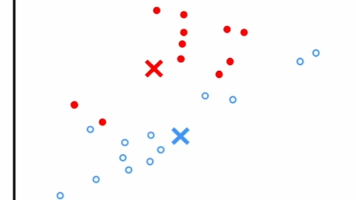
机器学习可以分为无监督学习与有监督学习两类,之前所了解的线性回归、逻辑回归与决策树等等,都是有监督学习,根据学习输入样本特征与标签之间来进行回归、分类等。而无监督学习则没有标签,需要自动的来寻找挖掘来一些可用的信息,对于聚类而言,则是。
本文系统介绍了聚类任务的核心概念与方法。作为无监督学习的关键技术,聚类旨在将无标记样本划分为若干簇,揭示数据内在结构。文章详细阐述了聚类性能度量(外部指标如JC/FMI/RI和内部指标如DBI/DI)、距离计算方式(闵可夫斯基距离、VDM等),并重点分析了原型聚类(k均值、高斯混合模型)和层次聚类(AGNES)的算法原理与特点。最后指出,实际应用中需根据数据特性和任务需求选择合适的聚类方法,平衡效
大数据是一种具备规模大、速度快、多样性、价值密度低和真实性挑战的数据集合,其5V特性超越了传统数据处理能力。通过分布式计算等技术,企业能从海量数据中提取商业价值。主要应用包括精准营销(协同过滤算法)、风险管理(异常检测)、供应链优化(时间序列分析)和用户画像(聚类算法)。最具争议的是"大数据杀熟",即利用用户画像进行个性化定价,这虽能最大化利润但涉及伦理问题。未来企业需平衡数据
湖光秋月两相和,潭面无风镜未磨。
这篇文章系统介绍了聚类算法的核心知识。首先从基本概念、应用场景和常见分类切入,奠定理论基础;随后讲解聚类算法API的具体调用和代码实践,衔接理论与应用;重点剖析了KMeans算法的实现流程;最后详细阐述了三种主流评估指标:SSE(肘部法则)、SC(轮廓系数)和CH(Calinski-Harabasz指数),为模型效果量化提供依据。
疏影横斜水清浅,暗香浮动月黄昏。
首先在聚类之前需要进行标准化。
【机器学习与实战】分类与聚类算法:K-Means聚类分析-01聚类算法
【机器学习与实战】分类与聚类算法:K-Means聚类分析-02实战演练
聚类算法在无监督学习中的实践探索 本文系统剖析了三种主流聚类算法(K-Means、DBSCAN和GMM)的技术特点与应用边界。K-Means作为基准模型高效直观但受限于球形簇假设;DBSCAN基于密度连接可识别任意形状簇但参数敏感;GMM采用概率化方法能处理边界模糊数据并支持异常检测。文章特别强调了工程实践中的关键考量:参数调优策略(如K-Means的n_init、DBSCAN的eps选择)、模型
【机器学习与实战】分类与聚类算法:K-Means聚类分析-03模型评估
弄石临溪坐,寻花绕寺行。时时闻鸟语,处处是泉声。
【机器学习与实战】分类与聚类算法:KNN鸢尾花分类
停车坐爱枫林晚,霜叶红于二月花。
【机器学习与实战】分类与聚类算法:SVM支持向量机
【机器学习与实战】分类与聚类算法:集成学习
本文系统阐述了聚类分析的理论框架与算法体系,重点剖析了K-means算法的原理、实现及优化策略。文章首先介绍了聚类的基本概念、应用场景和评估指标;其次对各类聚类算法进行比较分析;然后详细解析K-means算法的核心思想、数学原理及优缺点;并提供了Python实现示例及优化技巧。文章还探讨了2025年K-means算法的最新研究进展,包括改进算法、理论创新和电商应用案例。最后指出当前面临的挑战(如初
摘要 本文介绍了聚类算法的基本原理和实现方法,重点讲解了KMeans算法的实现流程。主要内容包括:1) 聚类算法分类,包括KMeans、层次聚类、DBSCAN和谱聚类等方法;2) KMeans算法的详细步骤,包括初始质心选择、距离计算、质心更新等过程;3) 聚类效果评价指标,如SSE误差平方和、SC系数、CH系数等;4) 肘部法确定最佳聚类数的方法;5) 客户数据分析案例,展示了从数据预处理到聚类
车联网(Internet of Vehicles, IoV)是一个快速兴起的技术范式,其核心特征包括动态网络拓扑、特定车辆移动模式、节点密度与速度的动态波动。为这类网络设计高效的路由算法仍是一项关键挑战。在车载自组织网络(VANETs)中,路侧单元(RSU)是部署在道路沿线及交叉路口的边缘计算设备,为路由提供支持。生物启发式优化算法具有极强的适应性、参数并发性高的特点,非常适合应用于该领域。车辆聚
+混合高斯模型聚类#机器学习+#人工智能+#特征提取+#特征融合+#特征降维+#聚类+#分类器+#无监督学习[火]代码描述:1、导入数据;2、利用混合高斯模型对数据进行聚类。
Java 8引入的函数式编程特性彻底改变了Java开发者的编程范式。Lambda表达式和Stream API的结合,使得Java能够以更简洁、更富有表现力的方式处理数据集合和并发编程。这种转变不仅减少了样板代码的数量,还提高了代码的可读性和可维护性。函数式编程核心在于将行为参数化,将函数作为方法参数传递,使得开发者能够编写更加灵活和模块化的代码。Java函数式编程仍在不断演进,后续版本中引入了更多
在前几篇文章中,我们学习了机器学习的基础知识、分类体系以及监督学习的原理与经典算法。监督学习在实际中非常常见,但它有一个关键前提:需要大量带标签的数据。然而在现实中,标注往往昂贵甚至不可行:电商平台积累了大量用户行为数据,却没有人逐一标注“用户群体”;医学影像数据庞大,但人工标注需要专家参与,耗费极高;工业传感器产生连续监测数据,但只有少量“故障”样本。在这些场景中,无监督学习(Unsupervi
初学小小白,个人笔记使用,仅供参考
本文提出一种面向物联网智能系统的可扩展边缘计算框架ScalEdge,通过递归聚类和两阶段卸载算法优化能耗与延迟。该框架在物联网层采用节能聚类技术减少卸载请求,在边缘-云协同架构下动态调度任务,有效缓解服务器拥塞,提升系统可扩展性,同时降低能量消耗并延长设备寿命。
一、UWSNs 的环境挑战与现有路由协议痛点水下无线传感器网络(Underwater Wireless Sensor Networks, UWSNs)作为海洋环境监测、水下资源勘探、军事侦察的核心技术载体,需在高动态、强干扰、能量受限的极端环境中实现稳定数据传输。然而,其独特的水下信道特性与硬件约束,使传统路由协议面临严峻挑战。
三菱FX1N与3台台达MS300变频器通讯程序可直接拿来实用了,三菱FX PLC与台达变频器modbus RTU通讯采用器件:三菱FX1N 24MT PLC,1个FX1N 485BD板,3个台达MS300系列变频器。也可以是FX2N,FX2N 485BD功能:进行频率设定,频率读取,正反转启停。触摸屏采用MCGS说明:出售PLC通讯程序和触摸屏程序,带注释。只是程序,非硬件设备。
BIRCH是一种高效的层次聚类算法,适用于大规模数据集。它通过聚类特征(CF)和子聚类特征(SCF)数据结构构建树形聚类结构,包含初始化、聚类和优化三个步骤。Python中可使用scikit-learn的Birch类实现,具有可扩展性强、内存效率高等优点,但对参数敏感且处理非球形聚类能力有限。该算法默认使用欧氏距离,在聚类速度和内存使用方面表现优异,但应用场景受限于其假设条件。
本文深入探讨了多视图聚类技术中的常见误区,特别是Deep Multiview Clustering在对比学习中的三大技术陷阱。从预训练阶段的特征质量到对比损失中的坍塌陷阱,再到视图互补性挖掘,提供了实用的解决方案和优化策略,帮助开发者在实际应用中避免常见错误,提升聚类效果。
本文详细解析单细胞分析从标准化到聚类的关键步骤,包括消除技术噪音的标准化方法、高变基因筛选的特征选择、PCA与UMAP降维技术,以及Leiden聚类算法的应用。通过实战代码示例和参数调优技巧,帮助研究者掌握单细胞数据分析的核心流程,提升细胞亚群发现的准确性和效率。
本文详细介绍了如何使用PyTorch实现深度嵌入式聚类(DEC)算法,从自编码器构建到聚类结果可视化。DEC结合了深度神经网络的特征提取能力和传统聚类算法的优势,适用于无监督学习场景。通过代码示例和实战技巧,帮助开发者掌握DEC的核心原理、预训练方法、聚类层设计以及结果评估,提升在图像和文本数据上的聚类性能。
本文详细介绍了使用sklearn评估聚类结果的五种核心方法,包括轮廓系数、Calinski-Harabasz分数等,帮助读者在无监督学习中精准衡量聚类效果。通过实际代码示例和高级技巧,指导如何避免常见陷阱并组合使用评估指标,提升聚类分析的可靠性和效率。
本文深入探讨KMeans算法在数据存在异常点时可能遇到的质心初始化陷阱,并提供多种实用解决方案,包括KMeans++初始化、密度感知初始化和动态异常点处理等。通过代码示例和实战建议,帮助数据分析师有效提升聚类结果的稳定性和准确性,特别适用于异常检测场景下的数据分群任务。
本文深入解析深度嵌入式聚类(DEC)算法的核心机制,揭示自编码器与KL散度如何协同工作实现精准数据分组。DEC通过自编码器学习特征表示,利用KL散度优化软分配,显著提升聚类效果,特别适用于复杂无标签数据场景。
本文详细介绍了如何使用Python的sklearn库计算轮廓系数(Silhouette coefficient)来评估聚类效果。通过实战代码演示,从数据预处理、聚类算法选择到结果分析,帮助读者量化评估客户分群、新闻分类等任务的聚类质量,并提供了寻找最佳K值的进阶技巧。
本文详细介绍了在R语言中使用ComplexHeatmap包解决样品重复性差时的热图分组聚类技巧。通过`column_split`参数,即使样本组内变异较大,也能强制按预设分组展示热图,适用于转录组、临床研究等场景。文章提供了从数据预处理到高级可视化的完整代码示例,帮助研究者创建符合发表要求的专业热图。
本文介绍如何利用Python的sklearn库,通过手肘图和轮廓系数快速确定K-Means算法中的最佳K值,实现高效的客户分群。文章详细解析了手肘图的绘制与解读、轮廓系数的计算与应用,并提供了完整的实战流程和高级技巧,帮助数据分析师避免常见误区,提升聚类效果。
本文详细介绍了如何使用Pandas和Sklearn进行电商广告数据清洗与聚类分析,涵盖数据准备、预处理、KMeans聚类及商业应用。通过完整代码示例和避坑指南,帮助数据分析师从混乱数据中提取有价值的商业洞察,优化广告投放策略。
本文深入解析K-means聚类算法的核心原理,并通过NumPy从零实现,解决实际工程中的三大陷阱:K值选择、特征尺度差异和评估指标。文章不仅提供优化代码示例,还分享实战经验,帮助开发者避免常见误区,提升聚类效果。
本文详细解析了PAGA(Partition-based Graph Abstraction)在单细胞数据分析中的应用,通过将复杂的细胞群体转化为拓扑地图,帮助研究者直观理解细胞间的发育关系和异质性结构。文章涵盖了PAGA的核心思想、与传统方法的对比、多分辨率探索策略以及整合RNA velocity的技术细节,并提供了实战案例和常见问题排查方法。