【第十二周】机器学习笔记01
摘要
机器学习是人工智能的核心领域,使计算机能够从数据中自动学习规律,而非依赖人工编程指令。主要包括两种范式:监督学习通过带标签数据训练预测模型(如房价预测、垃圾邮件过滤),无监督学习则从无标签数据中发现隐藏模式(如新闻分类、客户分群)。通过优化算法持续调整模型参数,最终实现对新数据的智能预测与分析。
Abstract
Machine learning is a core domain of artificial intelligence that enables computers to automatically learn patterns from data without relying on explicit human-programmed instructions. It primarily encompasses two paradigms: supervised learning, which trains predictive models using labeled data (such as house price prediction or spam filtering), and unsupervised learning, which discovers hidden patterns from unlabeled data (such as news categorization or customer segmentation). By continuously optimizing model parameters through algorithms, intelligent prediction and analysis of new data are ultimately achieved.
一、机器学习
1、什么是机器学习
机器学习,就是让计算机程序(机器)通过从数据中自动学习和分析获得规律(模式),并利用这些规律对未知数据进行预测或决策,而不是通过明确的指令编程来实现。
2、机器学习的类型和示例
机器学习的两种主要类型是监督学习和无监督学习
2.1、监督学习
监督学习是指从x到y或者输入到输出映射的算法,关键特征是工程师提供算法示例以供学习,这包括正确答案,机器不断学习算法直到只需给出一个x值就能推算处y值,也就是说只需输入标签而无需输出标签并给出合理准确的预测或猜测 。
我们来看几个例子。
当输入x是电子邮件,输出y是电子邮件时(y可能是垃圾邮件或者非垃圾邮件),这样的关系其实就是一个垃圾邮件过滤系统
当输入x是音频,算法输出y是文本时,这个关系就是一个语音识别系统。
当输入x是英文,输出y是西班牙语、中文、日文、韩文等,这样的关系就是一个机器翻译系统。
当输入x是用户的相关信息时,输出y是点击的话,这样的关系其实是一个在线广告系统,因为很多广告商都是靠用户点击广告链接来盈利的,为了搜寻哪种用户契合广告商所代理的产品,就需要输入用户的相关信息,用算法判断该用户是否对广告感兴趣,如果判断适合,就在用户界面投放相关广告,吸引用户点击广告,所以输入是用户的相关信息,输出是点击。
如果你想创造一个自动驾驶的汽车,那么我们需要汽车身上的图像传感器、雷达传感器,通过相关算法的计算,然后尝试输出其他汽车的位置,这样自动驾驶的汽车能够更好地去规划行车路线,避开障碍和其他汽车,在这里输入x就是汽车上的图像传感器以及雷达传感器,输出y就是其他汽车和障碍的位置
在制造业中,我们可能收到产品的相关图片,我们传输给机器,通过特定的算法,判断该产品是否存在划痕、缺陷,这样能够更好的帮助制造商关注产品的缺陷,以便调整。
在这些示例中,我们不难看出,一开始我们都是给定输入的x,通过特定的算法以及正确答案y来训练模型,在模型足够熟悉输入x和输出y后,我们给出一个全新的x,这是模型从来没有见到过的输入,让它尝试产生适当的相应输出y
让我们来看一下更加复杂的例子:
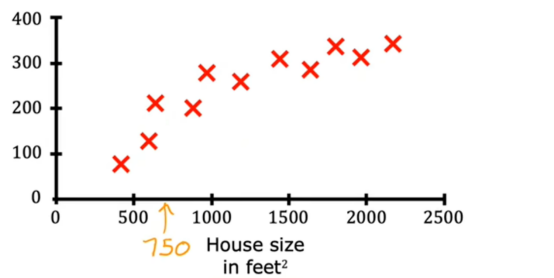
以上图为例,这是一个买房预测的图片,横轴是房子大小(图中为平方英尺),纵轴是房屋的价格,将这个数据输入到模型中去,模型只接受了到500、1000、2000、2500平方英尺的数据,以及对应的价格,如果我的朋友现在需要购买一个750平方英尺的房子,那么大概需要多少钱。这个输入是模型从来没有见到过的,但是我们可以根据给定的算法来合理的推测房屋的价格。
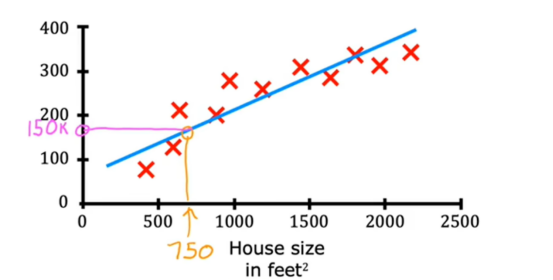
这样来看的话,我们朋友可能会花费200K美元去购置一座750平方英尺的房子,当然我们也可以选择更加复杂的算法去计算,这一切都取决于程序员的需求,无论我们选择什么样的算法去拟合,我们都会得到一个较为合适的推测和结果,这就是监督学习,从无数可能的数字中预测一个数字,或者从无数事件中预测更可能发生的事件。
2.2、无监督学习
无监督学习是给定的数据与任何输出标签y无关,比如给定了有关患者及其肿瘤大小和患者年龄的数据,我们没有被要求诊断肿瘤是良性还是恶性,因为没有给我们任何标签,这就是无监督学习,我们称它为无监督学习是因为我们不试图监督算法,相反,为了对每个输入给出一些引用正确的答案,我们得自己弄清楚什么是有趣的数据,无监督学习算法可能会决定将数据分配给两个不同的组或两个不同的集群,所以它可能会决定,这里有一个集群,那里有一个集群,这是一种特殊类型的无监督学习,称为聚类算法,因为它将未标记的数据放入不同的集群当中
比如在新闻栏目里,一天发生的新闻多如牛毛,人们不可能为每个新闻都编写相应的栏目和封面,所以,我们需要算法在没有监督的情况下自行计算出今天的新闻文章有哪些,并且按照相应的关键字,把它们集合在一个类群当中
再比如,我们每个人都有各自的基因,其中一段基因影响眼睛的颜色,另外一段影响人的身高体重,一段影响是否爱吃蔬菜,我们不可能给每个人的每个基因都人为的给它分好组,我们只能依靠算法去将人归类到不同的组别当中,比如算法将眼睛颜色为蓝色的人定为Ⅰ组,将身高高的定位Ⅱ组,将不爱吃蔬菜的人定为第Ⅲ组。
这就是无监督学习,因为我们没有提前告诉算法,有一种人具有某些特征或具有某些特征的第二类人,相反,我们所说的是一堆没有经过处理的数据,通俗来说,我们没有告诉机器什么是什么,我们也没有提前为算法提供示例的正确答案,而是让它自己根据数据分析特征再将他们归为不同的类别。
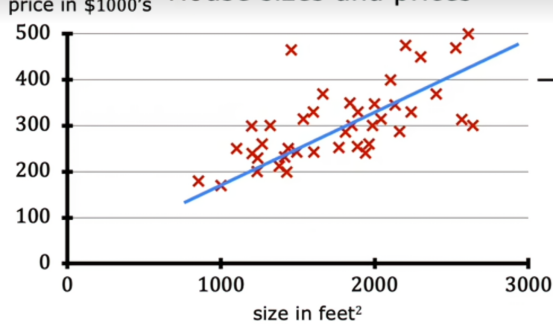
当我们把每平方英尺所需要的房屋价格拟合成曲线时,很明显,我们为数据集中的每个房子都给出了对应的价钱,这种线性回归模型是一种特殊类型的监督学习模型。它被称为回归模型,是因为它预测数字作为输出,如美元价格。线性回归是回归模型的一个例子,也有其他模型也可以解决回归问题。除此之外,与回归模型相比,另一种最常见的监督学习模型被称为分类模型。分类模型预测类别和离散类别,例如预测图片是猫、狗还是其他动物,或者如果给定病例,它必须预测患者是否患有特定的疾病,注意分类和回归之间的区别,在分类中,只有少量可能的输出。如果模型正在识别猫和狗,则有两种可能的输出,或者,模型正在尝试识别患者10种可能的医疗状况中的任何一种,因此存在一组离散、有限的可能输出,我们称之为分类问题,而在回归中,模型可以输出无限多可能的数字。
除了将此数据可视化为左侧的图表外,还有另一种查看有用数据的方法,即数据表。
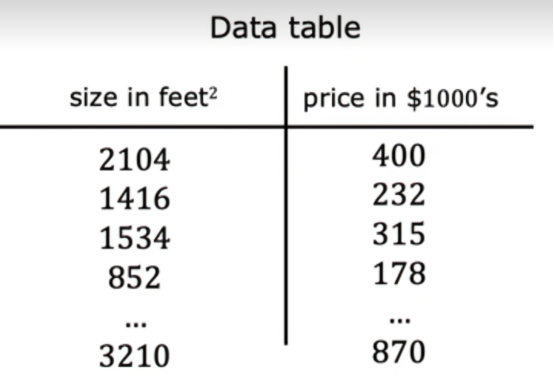
数据输入是房屋的大小,输出是房屋的价格。
3、训练模型
之前我们了解了很多例子,都是在一个集合里面,我们用于训练模型的数据集合称为训练集,如果一个客户的房子不在此训练集当中,因为它还未售出,所有我们没人知道价格是多少,如果要预测客户的房价,我们首先要训练模型从训练集中学习,然后该模型才能预测客户的房价。
在机器学习中,表示输入的标准符号是小写的x,我们称之为输入变量,也称为特征或者输入特征,所以我们看上图,对于训练集中的第一个元素,x是房屋的大小,因此x等于2104;表示你预测的输出变量(有时候也被称为是目标变量)的标准符号是小写的y,这里对于第一个示例,y是房屋的价格,它等于400。所以在整个训练集中,有很多很多行,每一行代表的是一个不同的训练示例,我们用小写字母m表示训练示例的总数。
如果我们要引用一个具体的示例,可用(x,y)这样的形式去表现,比如第一个示例,我们可以写(x,y)= (2100,400),如果我们要表达特定行上的示例,我们可以使用括号中的x上标和y的上标,它们两的上标都为i,通式表达为(xi,yi),比如说我想要表达第37个例子(假设有这么多),那么我们应该写(x37,y37)
对于监督学习,要训练模型,我们需将训练集(包括输入特征和输出目标)提供给学习算法,然后监督学习算法会产生一些功能,我们将这个函数写成小写的f,其中f代表函数,f的工作是采用新的输入x和输出并进行估计或预测,有的人也称它为y-hat,它的写法类似于顶部带有这个小帽子符号的变量y,在机器学习中,y-hat一般来说是y的估计或预测函数f称为模型,注意,当符号只是字母y时,则指的是目标,即训练集中的实际真实值,相反,y-hat是一个估计值,用我们上个例子来说的话,如果我们正在帮助客户出售房子,那么在他出售之前,房子的真实价格是未知的,我们的模型f,在给定大小的情况下,输出作为估算的价格,即对真实价格的预测,现在,当我们设计学习算法时,一个关键问题是,我们将如何表示函数f?或者换句话说,我们要用来计算f的数学公式是什么?现在我们假设f表示的是一个直线,用我们高中的知识就可以列出通式,即fw,b(x)=wx+b,现在我们只需要知道w和b都是数字,是模型的参数,为w和b选择的值将根据输入特征x确定预测y-hat,这个fw,b(x)意味着f是以一个x作为输入的函数,并且根据w和b的值,f将输出预测y-hat的某个值。
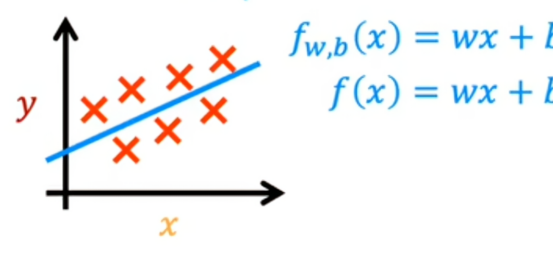
在机器学习中,模型的参数是可以在训练期间调整以改进模型的变量,有时候我们还把w和b称为系数或权重,对于线性回归,我们要做的是选择参数w和b的值,以便我们从函数f获得的直线以某种方式更好的拟合数据。
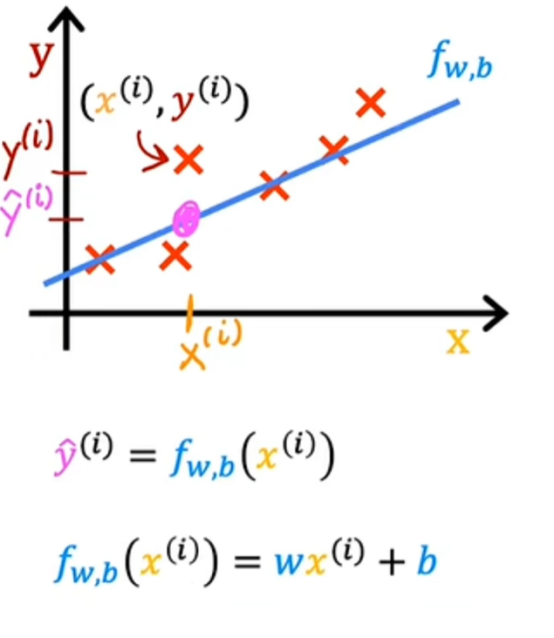
如上图所示,当我们看见这条线视觉上与数据相符时,我们可以认为f定义的这条直线大致穿过或者接近训练示例的某个地方,但是并非所有的点都在这个拟合直线上,我们的目标就是如何找到w和b的值,以便尽可能多的训练示例的预测接近更真实的目标。
我们先来看一下如何衡量一条直线与训练数据的拟合程度,为此我们将构建一个成本函数,成本函数采用预测y-hat并通过取y-hat减去y将其与目标y进行比较,这种差异称为误差,即测量预测与目标的距离,接下来,我们计算这个误差的平方,此外,我们要为训练集中的不同训练示例i计算此项,并且我们要计算平均误差而不是总误差,所以数学公式如下
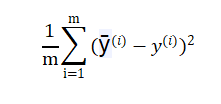
按照惯例,机器学习人使用的成本函数实际上是除以2乘以m。额外除以2只是为了让我们后面的计算看起来更整洁,所以我们最终的表达式为
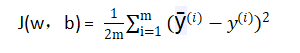
这也称为平方误差成本函数,之所以这么称呼是因为我们取的是这些误差项的平方,在机器学习中,不同的人会针对不同的应用程序使用不同的成本函数,但平方误差成本函数是迄今为止线性回归最常用的函数,就此而言,对于所有的回归问题,它似乎为许多应用程序提供了良好的结果,提醒一下,预测y等于模型f在x处的输出,所有该公式也可以这么写:
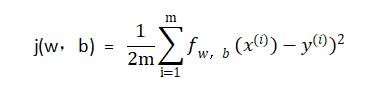
总结
机器学习是让计算机从数据中自己学习规律,而不是通过人工编写具体指令。它主要分为两种类型:监督学习使用带答案的数据训练模型,用来做预测(比如房价预测或垃圾邮件识别);无监督学习使用没有标签的数据,让机器自主发现模式(比如新闻分类或客户分群)。通过不断调整模型参数,使预测结果越来越准确,最终实现对未知数据的智能处理。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 12
 0
- 0


 已为社区贡献6条内容

所有评论(0)