登录社区云,与社区用户共同成长
邀请您加入社区
社交媒体分析论坛交流系统的 数据可视化分析系统的开发过程中,PyCharm 为 Python 代码编写提供了高效的工作环境,能够帮助开发者快速编写、调试和优化代码。实现都依赖于 PyCharm 提供的智能提示和代码自动完成功能。开发者可以通过 PyCharm 的调试工具实时跟踪代码执行过程,确保系统各个模块的逻辑正确性和性能优化。此外,PyCharm 强大的项目管理功能使得系统的多个功能模块能够高
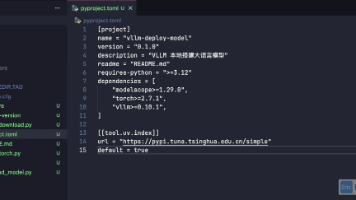
vLLM 是一个快速且易于使用的大语言模型推理和部署库,最初由加州大学伯克利分校的 Sky Computing Lab 开发,现已发展为一个由学术界和工业界共同贡献的社区驱动项目。
现在客户端通信模块搭建好了,但是我们怎么去测验它是否有问题呢,这里我们就需要搭建一个假的服务器。MockServer是能够提供Mock功能的服务器,通过模拟真实的服务器,提供对来⾃客⼾端请求的真实响应。它允许用户创建模拟HTTP服务以模拟后端服务的响应,从而在开发和测试过程中,无需依赖实际的后端服务,也能够进行接口测试和功能验证。实际就是搭建⼀个HTTP服务器,构造模拟数据对客户端接口进行测试。这
2025年自媒体行业正经历大数据驱动的深度变革,市场规模预计突破1.15万亿元,但90%账号面临数据利用率不足30%的困境。本文系统解构了大数据赋能自媒体的底层逻辑:通过多模态数据采集、AI算法分析和实时反馈构建"数据-内容-决策"闭环,并给出全链路工具选型方案。技术类自媒体案例显示,AIAgent多模态生成可将内容成本降低73%,细分领域垂直账号商业效率达泛内容账号的2.8倍
每天,全球社交媒体产生5000万条Twitter推文、1.3亿条Instagram帖子、400亿条WhatsApp消息——这些文本不是数字垃圾,而是用户的“数字心声”。企业想知道“用户为什么骂我的产品?”,媒体想追踪“热点事件的情绪走向?”,研究者想理解“Z世代的价值观变迁?”……而大数据,就是打开这些问题的“钥匙”。本文将用**“钓鱼”的隐喻**拆解社交媒体文本分析的全流程:从“捞鱼”(数据采集
提升用户的体验我也希望这次的设计能通过我后期的自主学习把它趋向于完美,成为我的自主创作经验。原始数据中存在异常值、重复值、系统自动推荐等数据,这部分数据价值含量低、数据结构混乱,严重影响数据挖掘模型的执行效率,导致挖掘结果的偏差,所以进行数据清洗是必不可少的。4、多种数据格式无需转换直接使用,对与直接传入包括二维表,key-value表等多种格式的数据源,通过简单的设置encode属性就可以完成从
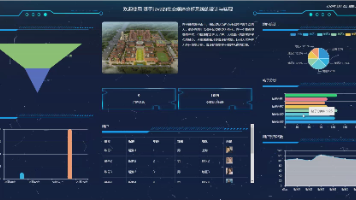
《社交媒体舆情数据可视化分析系统》是一套基于大数据技术构建的舆情监测分析平台,采用Hadoop+Spark分布式计算框架作为数据处理核心,结合Django后端框架和Vue+ElementUI+Echarts前端技术栈实现。该系统通过HDFS分布式文件系统存储海量社交媒体数据,利用Spark SQL进行高效的数据查询与分析,配合Pandas和NumPy进行精确的数据处理和统计计算。
本文介绍了一个基于大数据的社交媒体舆情分析系统,该系统采用Hadoop+Spark架构处理海量数据,支持Python/Java双版本开发。系统集成了情感分析、热点话题挖掘等功能,通过Echarts实现数据可视化展示。技术栈包含HDFS分布式存储、Spark SQL查询、Pandas数据处理等,适用于毕业设计或实际舆情监测场景。文中提供了系统架构图、功能模块说明和核心代码片段(包括数据清洗、情感分析
本文从「社交媒体数据的四大痛点」出发,给出了一套现代ETL+NLP+流处理用Spark处理批量非结构化数据,解析嵌套JSON;用Flink实现秒级实时统计,满足舆情监测需求;用NLP做情感分析,挖掘数据中的价值;用湖仓一体和搜索引擎存储数据,支持分析与可视化。社交媒体数据是企业的「数据金矿」,但要挖好这座矿,需要技术栈的融合——不是用传统ETL硬套,而是结合社交媒体的特性,选择合适的工具和方法。最
通过head()、describe()和info()方法可以初步了解数据的结构、统计信息和数据类型,为后续处理奠定基础。Pandas提供isnull()、fillna()和dropna()等方法识别和处理空缺数据。重复数据可以使用duplicated()和drop_duplicates()进行检测和删除,确保数据质量。数据转换包括使用apply()函数应用自定义函数,以及使用map()进行值映射,
为什么现在的媒体总能“猜中”你喜欢什么?比如你刷抖音时,刚看完一条猫的视频,下一条准是更萌的猫;你读今日头条,刚点了篇“AI画画”的文章,首页就全是科技新闻。这不是“巧合”,而是大数据给媒体传播重构了底层逻辑——从“不管谁看都发”的“广播模式”,变成了“看你喜欢才发”的“精准模式”。大数据如何“收集”你的兴趣(像班级里的“消息小助手”记笔记);如何把兴趣变成“可计算的卡片”(用户画像);如何用算法
对于特定任务,通常需要实现自定义组件。通过继承tf.keras.layers.Layer和tf.keras.losses.Loss基类,可以创建满足特定需求的层和损失函数。重要的是确保这些自定义组件与TensorFlow的计算图模式兼容,以避免性能损失。
本文围绕GEO优化底层逻辑展开,指出国内大模型以政府媒体和大型社媒新闻为权威数据来源,国外注重Reddit等社群高质量数据。分析了数据特点与GEO优化的联系,并提出基于数据差异的国内、国外优化策略,助力企业提升竞争力。
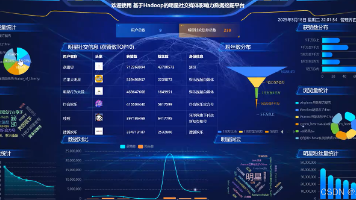
本文介绍了一个基于Spring Boot框架开发的明星社交媒体影响力数据挖掘平台。该平台采用Java语言开发,使用MySQL 5.7作为数据库,Eclipse作为开发工具。系统具备数据采集、清洗、分析和可视化功能,支持多维度评估明星社交影响力,包括粉丝互动、商业价值和社会效应等。技术架构上集成了Maven依赖管理和Tomcat服务器,实现了前后端分离开发。平台解决了现有工具在明星特定场景分析方面的
本文从媒体行业的“数据洪流”痛点出发,解析了Apache Cassandra如何通过“分布式无中心架构”“线性扩展”“写入优先优化”“多数据中心支持”四大特性,成为媒体行业的“数据引擎”。通过这些案例,我们证明了:Cassandra不仅能解决媒体行业的“海量存储”“高并发写入”“全球高可用”难题,还能通过灵活的数据模型、生态集成能力,支撑从“实时推荐”到“离线分析”的全链路数据需求——这一生态让C
Java的主要特点是简单性、面向对象、分布式、健壮性、安全性和可移植性。Java的设计初衷是让程序员能够以优雅的方式编写复杂的程序。它支持 Internet 应用的开发,并内建了网络应用编程接口,极大地便利了网络应用的开发。同时,Java的强类型机制和异常处理功能确保了程序的健壮性。Java分为三个主要版本:Java SE(标准版),主要用于桌面应用程序开发;Java EE(企业版),用于开发企业
这些数据蕴含着巨大的商业价值和社会价值,但同时也面临着数据处理的挑战,包括数据的实时性、高吞吐量、可靠性等方面。Kafka作为一种高性能的分布式消息队列系统,在大数据领域得到了广泛的应用。本文的目的是深入探讨Kafka在社交媒体数据处理中的应用,包括其原理、实现方式、实际应用场景等,旨在为相关领域的开发者和研究者提供全面的参考。本文将按照以下结构进行阐述:首先介绍Kafka和社交媒体数据处理的核心
本次研究将达到的毕业课程设计系统主要有以下主要流程:数据收集:使用Python语言,现成的爬虫框架和工具包降低了使用门槛,具体使用时配合正则表达式的运用,使得数据抓取工作变得更加简单。因此采用Python语言来实现网络爬虫功能,通过下载器爬取数据,通过解析器将HTML文本或者JSON数据进行解析,然后把解析出来的数据保存在MySQL数据库中。1、数据的爬取 2、数据清洗和预处理 3、数据分析 4、
摘要(150字) 中科院计算机专业研究生开发的全栈跨模态图文检测系统,基于VGG16与LSTM深度学习模型,实现社交媒体图文一致性分析。系统采用动态权重模型集成策略(VGG16+MobileNet),准确率达85%+,处理速度提升30%,支持单图/批量/URL/实时检测。提供完整毕设解决方案(选题→答辩全流程)及企业级技术落地服务,包含Flask后端、PyTorch模型优化及可复用代码库。适用于电
本研究构建了一个基于Hadoop的社交媒体情感分析系统,整合了分布式计算与自然语言处理技术,实现了从数据采集到可视化展示的全流程分析。系统通过情感分析算法识别用户情感倾向,并具备热门内容预测功能。采用ECharts等前端技术实现数据可视化,测试表明系统在处理海量数据时兼具高效性与准确性。该研究为社交媒体分析提供了创新技术方案,推动了大数据的应用发展。系统架构图如图3-1所示。