登录社区云,与社区用户共同成长
邀请您加入社区
编写程序的时候,常常能碰到当某些数据或方法需要被整个程序共享,且不需要多个独立副本的场景。本文总计几个常见的解决方案
vLLM 是一个快速且易于使用的大语言模型推理和部署库,最初由加州大学伯克利分校的 Sky Computing Lab 开发,现已发展为一个由学术界和工业界共同贡献的社区驱动项目。
内容:概述微服务挑战和44个模式。适用场景:评估WPF上位机是否需要微服务化(如拆分设备控制和监控)。C#代码扩展:定义共享事件模型,用于命令端和查询端通信。说明:共享事件定义为WPF上位机提供统一事件模型,支持事件溯源和异步通信。内容:代码膨胀、部署风险。适用场景:WPF多设备管理导致复杂性。C#代码扩展:同上,模拟复杂单体逻辑。内容:2PC缺点,Saga替代。适用场景:WPF指令+日志事务。C
Markdown 被广泛用于使用纯文本语法创建格式化文本。许多开发人员喜欢用它来编写文档、注释和内容格式。然而,我们经常需要将Markdown文档生成专业的PDF文件。本文将学习如何借助Aspose.words for .NET,使用 C# 将 Markdown 转换为 PDF。
UIToolkit容器组件概述:本文介绍了UIToolkit中常用的容器组件及其功能特性,包括VisualElement(基础容器)、ScrollView(滚动容器)、ListView(列表容器)和GroupBox(分组容器)。重点讲解了各容器的核心属性、事件注册方式以及实际应用场景,如通过RegisterCallback注册鼠标事件、使用Manipulator处理高级交互、配置ListView数
数据溢出是流处理系统的“隐形炸弹”:它可能让你的实时任务突然崩溃(OOM)、吐出错误结果(窗口数据堆积导致延迟),甚至拖垮整个集群(缓冲区溢出引发连锁反应)。本文从快递分拣中心的生活场景类比入手,拆解溢出的底层逻辑,结合Flink、Kafka的真实案例,教你用3套核心方案、5个实用工具解决溢出问题。无论你是刚接触流处理的开发者,还是负责维护系统的运维人员,读完本文都能掌握“精准排雷”的能力。如今,
作为广东高新技术企业和软件企业技术负责人,针对当前项目中的富文本编辑器功能增强需求,经过严格技术评估和架构设计,现提交以下技术实施方案。
大模型测评分享功能的设计和实现是一个复杂而重要的工程,它不仅仅是技术实现,更是对业务需求、用户体验、安全保障的综合考量。业务价值:分享功能解决了评测结果传播和协作的核心痛点,提高了工作效率和决策质量。技术架构:采用分层架构设计,确保了系统的可扩展性、可维护性和高性能。安全保障:多层次的安全控制机制,保护了敏感数据的安全性和访问的可控性。用户体验:从分享创建到结果展示的全流程优化,提供了流畅、直观的
通过高效的数据处理能力、实时的自适应性以及灵活的应用场景,C# 和 Lambda 表达式为AI边缘计算的发展带来了突破性的进展。接下来,我要考虑文章的结构。比如第一段介绍C#和Lambda表达式的作用,第二段讲边缘计算的重要性以及它们如何结合使用,第三段可能讨论具体的应用案例,比如自动驾驶或智能家居等,最后一段可以总结未来的发展方向。例如,在图像识别和自然语言处理中,通过结合 C# 的框架和 La
最后,虽然Lambda强大,但也要避免过度使用,在复杂的多行逻辑或需要重用的情况下,传统的匿名内部类或具名类可能是更合适的选择,关键在于在简洁性和代码清晰度之间找到最佳平衡。例如,对一个列表进行过滤和转换的操作,使用传统的for循环会显得冗长且容易出错,而通过Stream的`filter`和`map`方法结合Lambda,可以构建出一条清晰、链式的数据处理流水线。这种表达方式的改变,不仅减少了模板
随着技术的不断成熟和临床验证的深入,机器学习必将进一步深化其在医学影像中的应用,从单纯的病灶检测延伸到预后预测、治疗效果评估等更广泛的领域,最终为全球患者带来更高效、更公平的医疗服务。例如,一个训练有素的卷积神经网络(CNN)可以像一位经验丰富的放射科医生一样,从肺部CT扫描中精准地识别出微小的肺结节,甚至能够分析其形态、密度等特征,辅助判断结节的良恶性。近年来,机器学习,尤其是其分支深度学习技术
此商城系统主要包括了前端Vue框架,后端Express框架技术的开发,数据库的建立和后台管理员的管理,并且采用Nodejs语言进行开发,使用MYSQL数据库存储相关的数据。从而实现了商城管理的相关功能,包含用户注册、登陆,查看商品信息、公告信息等信息,商家注册、登录,添加商品信息,对商品进行发货,管理员的管理,用户、商家、商品种类、商品信息、论坛、系统和订单等功能
2.创建微服务模块:用户、商品。
之后看了另外两个帖子,在帖子说的方法中,直接试了一下,修改php.ini,给这个文件加了个分号批注,但是这样子的话,错误是不跳了,可是80端口依旧显示无使用状态,并且依旧是橙色的图标。第一次报错时显示,MSVCR 110.dll没有,直接在笔记本上搜索按路径复制进了,与服务器里,报错就没有了。在笔记本电脑上安装wamp安装成功,之前在自己家的台式电脑上安装wamp的时候,出现了80端口被占用的问题
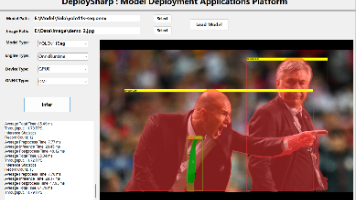
本文介绍了基于DeploySharp开发的深度学习模型部署测试平台的使用方法。该平台支持YOLO系列模型(v5-v13)及多种应用场景,提供OpenVINO和ONNX Runtime两种推理引擎,支持CPU/GPU/NPU等多种设备。文章详细说明了程序下载方式、模型选择、推理引擎配置以及设备匹配关系,并展示了不同推理方式(OpenVINO原生、ONNX Runtime及其加速方案)的运行示例。最后
Flink 状态管理核心要点 Flink的状态(State)是其核心竞争力,支持跨事件记忆能力,实现累加、去重等复杂实时计算。状态管理与算子绑定,通过checkpoint/savepoint保证一致性。 核心特性: Keyed State:基于KeyedStream分区,提供ValueState、ListState等5种状态原语 状态TTL:支持按时间自动清理过期状态,可配置刷新时机和可见性 状态
实现自动化的第一步是选择合适的工具链,如Jenkins、GitLab CI/CD、GitHub Actions或Azure DevOps,并根据项目特点设计清晰的流水线脚本。任何环境的变更都通过代码修改和流水线执行,实现了基础设施部署的可追溯和可重复。例如,可以在代码合并前要求通过所有单元测试和代码规范检查,在部署到生产环境前必须通过完整的安全扫描和用户验收测试。更重要的是,将这些监控数据反馈到开
numbers: List[Union[int, float]] # 支持整数和浮点数ascending: Optional[bool] = True # 排序方式,默认升序remove_duplicates: Optional[bool] = False # 是否去重,默认不去重模型特性:类型安全: 使用Union支持多种数字类型默认值: 提供合理的默认配置可选参数:
对于需要更精细控制训练步骤的高级用户,TensorFlow 2.0提供了基于的自定义训练循环。通过可以自动跟踪在其中的操作,并计算任意可微张量之间的梯度。结合Keras模型,开发者可以编写自己的训练循环,轻松实现梯度裁剪、自定义优化步骤、多任务损失加权等复杂逻辑,在简化的基础上保留了底层的控制能力。
本文介绍了如何在Flink作业中使用KafkaSink实现消息键的序列化。核心内容包括:1)自定义KafkaKeySerializer序列化器类,实现Tuple2<String,String>类型数据的key序列化;2)演示Flink作业的完整流程,从构建数据流到配置KafkaSink;3)提供三种设置key序列化器的方法(通过Serializer类+配置、仅Serializer类、或
本节将展示如何在lambda表达式中使用await。我们将编写一个使用了await的匿名方法,并且获取异步执行该方法的结果。运行结果。
维度代码可读性低(回调嵌套)高(线性结构)异常处理复杂(分支判断)简洁(统一 try-catch)调试难度高(跳转频繁)低(支持断点单步)学习成本高中等性能差异几乎无差别语义更优,编译器优化空间大不仅是一种语法糖,更是对异步编程模型的一次革命性升级。它让我们可以用同步的思维编写异步代码,极大地降低了心智负担。