登录社区云,与社区用户共同成长
邀请您加入社区
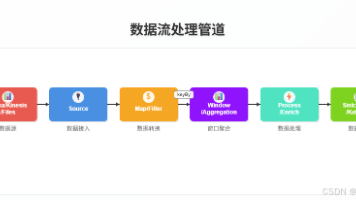
本文介绍了构建实时大数据处理系统的完整方案。系统采用Flume+Kafka+Flink+Redis架构,通过Flume集群采集Web服务器日志,Kafka集群作为消息队列,Flink进行实时计算,结果存储到Redis。详细讲解了Flume与Kafka的整合配置过程,包括多Agent部署和Topic创建;阐述了Flink消费Kafka数据的实现方式及容错机制;说明了使用Redis Connector
这是一篇“能落地”的入门实战文:围绕 连续流处理、事件时间、有状态算子、状态快照(检查点) 四大核心概念,带你用最短路径上手 Flink 写可扩展的实时 ETL、分析与事件驱动应用。文末附 Java DataStream 与 Flink SQL 两套示例,开箱即用
Kafka生产者与消费者的最佳实践,本质是平衡可靠性与性能的艺术。对于生产者,关键是保证消息不丢失acks=all、幂等性)、优化吞吐量(批量发送、压缩);对于消费者,关键是提高并发度(增加分区数、消费者实例)、避免滞后(优化心跳配置、监控Lag)。在实际项目中,需根据业务场景调整配置(如金融场景优先保证可靠性,日志收集场景优先保证吞吐量)。同时,监控与异常处理是保证系统稳定的关键,需重点投入。
数据溢出是流处理系统的“隐形炸弹”:它可能让你的实时任务突然崩溃(OOM)、吐出错误结果(窗口数据堆积导致延迟),甚至拖垮整个集群(缓冲区溢出引发连锁反应)。本文从快递分拣中心的生活场景类比入手,拆解溢出的底层逻辑,结合Flink、Kafka的真实案例,教你用3套核心方案、5个实用工具解决溢出问题。无论你是刚接触流处理的开发者,还是负责维护系统的运维人员,读完本文都能掌握“精准排雷”的能力。如今,
随着企业数据规模爆炸式增长,传统数据仓库的结构化数据处理模式与数据湖的非结构化存储能力逐渐融合,形成"湖仓一体"(Lakehouse)架构。实时数据从Kafka流式摄入Databricks数据湖基于Delta Lake的流批统一处理与存储数据治理能力增强与分析场景落地全文覆盖技术原理、算法实现、实战案例及最佳实践,适用于数据集成、实时计算、数据分析等场景。背景与核心概念:定义湖仓一体、Kafka、
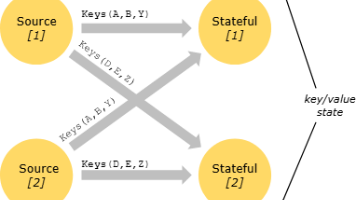
理解状态与时间,是把 Flink 从“能跑”推进到“跑得稳、跑得准”的关键。用把业务上下文本地化;用守住一致性与可进化;根据链路特性在对齐/不对齐之间做正确取舍;结合状态后端管好规模与性能。当这些拼图都对齐,你的实时系统就具备了在生产环境长期演进的基础能力。
本文是Kafka的零基础入门指南,目标是让从未接触过消息队列的读者(如刚入行的程序员、大数据爱好者)理解Kafka的核心机制,掌握基础使用方法,并明白它在实际业务中的价值。我们不会深入源码级别的细节,但会覆盖从概念到实战的全流程。本文将按照“概念理解→原理剖析→实战操作→场景应用”的逻辑展开:先用“快递驿站”的故事引出核心概念,再用代码演示如何发送/消费消息,最后结合电商、日志收集等真实场景说明K
在数学中,幂等性指的是「对同一个操作施加多次,结果与施加一次相同」。ffxfxffx))fx在 Kafka 中,**幂等生产者(Idempotent Producer)**的定义是:生产者发送多条相同的消息到同一个分区,Broker 只会持久化一条消息。Kafka 的事务机制旨在实现跨分区、跨生产者的原子性操作,即:一组消息的发送操作(或发送+消费偏移量提交)要么全部成功,要么全部失败,不会出现「
在K8s集群中,通过合理配置资源请求(requests)与限制(limits)、就绪性和存活探针,确保Java服务的高可用性。JVM在容器中的调优至关重要,需设置堆内存大小(如-Xms、-Xmx)以匹配容器资源限制,并选用适合的垃圾收集器(如G1GC或ZGC)以减少GC停顿时间。在微服务架构中,服务实例的动态注册与发现是保障系统弹性的关键。其高效的线程模型、丰富的框架选择(如Spring Boot
在大数据时代,企业面临着日均TB级数据的实时处理需求,传统数据传输方式在吞吐量、可靠性和扩展性上难以满足要求。Apache Kafka作为分布式流处理平台,以其高吞吐量、可扩展性和容错性成为数据管道的核心组件。本文旨在通过系统化讲解,帮助读者掌握Kafka的基础原理、核心架构和实战技能,解决数据传输中的性能瓶颈与可靠性问题。核心概念:解析Kafka架构要素与核心术语技术原理:深入消息传递机制与分布
事件乱序处理与策略配置 摘要:Flink通过水位线(Watermark)处理事件乱序问题,水位线宣告事件时间推进。核心策略WatermarkStrategy集成时间戳分配和水位线生成功能,建议优先在Source端配置以提升精度。针对常见场景,文章介绍了空闲分区检测、水位线对齐等解决方案,并对比了周期式和插桩式两种生成方式。特别推荐Kafka分区感知水位线策略,能有效保留分区特性。最后提供了工程实践
摘要: 本文针对Apache Flink生产环境中Checkpoint失败与反压问题的核心挑战,结合阿里巴巴双十一实战经验(60%故障源于此),系统化解析根因并提供全链路解决方案。内容涵盖: Checkpoint机制:分解Barrier对齐、异步持久化等阶段,分析超时(40%因资源不足)、状态膨胀等故障模式,结合Flink 1.10特性优化RocksDB压缩策略,降低上传时间30%。 反压传导:基
在完成了持续集成的基础验证后,持续交付的流水线会加入更多阶段的自动化测试,如验收测试、性能测试和安全扫描等。其目标是让代码的每个改动都能通过一个标准化的、自动化的流程,生产出可部署到生产环境的软件包。这使得环境的创建、复制和销毁都可以通过自动化脚本来完成,确保了开发、测试、生产环境的高度一致性,从而避免了“在我本地是好的”这类环境问题,为整个自动化之旅提供了可靠的基础保障。持续部署将自动化的理念推
从原理到实战,我们可以看到:Kafka的高吞吐量低延迟高可靠的特性,使其成为实时流处理的“基石”。无论是电商的实时推荐、物流的实时追踪,还是金融的实时风控,Kafka都在其中扮演着重要的角色。作为开发者,要想掌握Kafka,需要深入理解其核心原理(如Partition、Offset、零拷贝),熟练掌握其使用技巧(如Partition数设置、Offset提交方式),并结合实际场景进行优化(如与Fli
以下是使用 Apache Flink 连接 Kafka 的完整代码示例,包括数据源接入(从 Kafka 读取数据)和数据写入(将数据写入 Kafka)。代码基于 Flink 1.17.x 和 Kafka 客户端库,使用 Java 语言实现。示例包含详细注释,确保结构清晰。此示例覆盖了 Flink 连接 Kafka 的核心场景,您可根据实际需求扩展数据处理逻辑或配置参数。