登录社区云,与社区用户共同成长
邀请您加入社区
Apache Kylin 采用“空间换时间”的预计算思想,为超大规模数据集提供 SQL 查询接口和多维分析(OLAP)能力,并且能实现亚秒级的查询响应速度。• 超快的查询体验:基于先进的预计算 Cube 技术提供亚秒级查询性能。• 企业级特性:支持 LDAP/SSO 集成、项目级别的访问控制、系统监控、审计日志等安全特性。• Rest API:提供各种 Rest API,支持查询执行、任务调度,方
本文介绍了使用Docker快速部署Apache NiFi单节点的方法。通过拉取官方1.27版本镜像,执行简单的docker run命令即可启动容器,其中包含端口映射、数据持久化等关键配置说明。文中详细说明了如何修改默认端口、挂载数据卷实现持久化存储,以及如何自定义配置文件。最后提供了验证部署的方法,包括访问Web界面和查看容器日志。该部署方案简单高效,适合快速搭建NiFi开发测试环境。
本质上是通过stream流的懒加载去处理,在第一次读取完文件的5000行,是读取0-5000行的数据,第二次进去读取时,是读取5000-10000行之间的数据,通过文件IO流创建的Stream流在本质上是属于文件的,并不是重复创建对象。我在写这一篇文件大数据量处理时,实际造了一文件,每一行时两个uuid造的数据,72位的数据,总数据量是93940251行,文件内存6.86G。在处理上亿数据时,需要
通过死循环去进行读,每一次循环读取5000条,第一次循环时读取文件1-5000行的数据,第二次循环时读取5000-10000行的数据,以此类推,直至读到最后一页,在读取的数据小于5000时,则代表文件的读取到了尾声。同时在每次读取完文件后直接将读取的数据开一个线程去进行处理,做到边读边处理的功能,单纯读取速度较快,9000w行,6G内存的文件读取速度在18秒。文件在进行跑批时,可能会存在上亿的数据
这是一篇“能落地”的入门实战文:围绕 连续流处理、事件时间、有状态算子、状态快照(检查点) 四大核心概念,带你用最短路径上手 Flink 写可扩展的实时 ETL、分析与事件驱动应用。文末附 Java DataStream 与 Flink SQL 两套示例,开箱即用
本教程详细介绍了Apache Hadoop HDFS分布式文件系统的安装、配置与运维全流程。内容涵盖HDFS架构原理、伪分布式/完全分布式模式部署、核心参数配置、基础操作命令、集群监控维护、性能测试方法及安全认证机制。教程提供具体配置示例和故障排查指南,帮助开发者快速掌握HDFS生产级实践能力,包括数据平衡、节点退役、Kerberos认证等关键运维技术。适用于大数据平台建设者,需配合Hadoop生
本文介绍了Apache Spark MLlib机器学习库的完整使用流程,包括下载安装、基础配置、调试运行、运维管理和安全配置。主要内容涵盖:1)如何下载安装基于Spark生态的MLlib;2)核心配置文件参数说明;3)Python示例演示从数据预处理、模型训练到评估的完整机器学习流程;4)集群资源管理和模型版本控制等运维要点;5)单元测试和集成测试方法;6)数据安全、依赖安全和传输安全配置建议。教
本文是一篇关于Apache Flink分布式流处理框架的详细教程,涵盖从下载安装到生产运维的全流程。主要内容包括:Flink的下载与版本选择建议;本地模式和集群模式的安装配置步骤;核心配置参数说明;作业调试与提交方法(含代码示例);运维管理技巧(作业生命周期、监控、高可用);测试实践方法(单元测试与集成测试);安全配置方案(认证授权、数据加密等)。教程还提供了常见问题解决方法和学习资源推荐,适合开
本教程详细介绍了Apache Spark大规模数据处理引擎的安装配置与运维全流程。主要内容包括:1)Spark的下载与版本选择建议;2)本地模式与集群模式的安装部署步骤;3)核心配置参数详解;4)作业提交与调试技巧;5)生产环境运维管理方法;6)测试实践与安全配置方案。教程涵盖从基础环境搭建到高级功能配置,提供命令行示例和最佳实践指导,帮助开发者快速掌握Spark在批处理、流计算等场景的应用能力。
还在为环境配置抓狂吗?Docker就像个魔法烹饪盒,让你一键复刻标准“菜谱”。本文带你深度“品尝”如何用Dockerfile这份精准食谱,将纯净的Ubuntu“高汤”与强大的Apache“主料”文火慢炖,构建一个轻量、可移植的Web服务器镜像。从“买菜”(拉取镜像)到“切配”(优化指令),再到“调味”(配置应用)和“打包”(构建镜像),我们一步步揭秘Docker的“烹饪”哲学。附完整示例代码,让你
还在为笨重的Docker镜像而烦恼吗?本文将带你深入探索Alpine Linux这个“迷你瑞士军刀”,如何用它为Apache服务器进行极致“瘦身”。我们将揭秘Alpine的轻量奥秘,对比传统镜像的体积差异,并手把手教你编写高效的Dockerfile。从基础镜像选择、依赖管理到安全优化,完整示例演示如何构建一个体积不足20MB、却功能完备的Apache+PHP环境。告别臃肿,拥抱敏捷部署,让你的容器
本文基于Apache Flink DataStream API实现了一个实时欺诈检测系统,能够检测账户维度下"小额交易后紧跟大额交易"的欺诈模式。系统采用有状态处理机制,通过ValueState维护账户状态,并引入定时器实现1分钟时效限制。文章详细介绍了项目架构、关键实现逻辑(包括V1基础版本和V2时效限制版本)、环境配置以及生产化建议,同时提供了进阶扩展方向和常见问题解答。该
摘要:Apache Hive是基于Hadoop的数据仓库软件,支持通过类SQL语言(HiveQL)管理大规模分布式数据集。它提供数据ETL、结构化机制和多存储系统访问能力,支持MapReduce、Tez和Spark等计算引擎。Hive与Spark可实现深度集成,包括Spark直接读写Hive表、Hive on Spark执行引擎、ETL流水线协作等场景。数据导入方式多样,包括LOAD DATA命令
高可用集群的构建初始化 Kubernetes 集群(On Master)
Apache Flink是一个开源的流处理框架,以其高吞吐、低延迟、精确一次处理的特性成为实时计算领域的领导者。本文将从Flink的核心架构、编程模型、容错机制到实际应用场景,全面解析这一新一代大数据计算引擎的技术原理与实践应用,为读者提供从入门到精通的完整指南。
Apache Flink 是一个开源的流处理框架,用于实时数据流的处理和分析。本文将详细的介绍如何利用 Docker 在本地部署 Apache Flink 并结合路由侠实现外网访问本地部署的 Apache Flink。。
Lambda表达式和Stream API是现代Java开发的必备技能。它们通过声明式编程风格,让开发者更关注“做什么”而非“怎么做”。最佳实践包括:优先使用无状态的Lambda表达式、避免在流操作中修改外部状态、谨慎使用并行流、并善用方法引用(如)让代码更简洁。熟练掌握这些特性将显著提升开发效率和代码质量。
对于需要更强大计算能力的用户,可以安装支持GPU的版本,但这要求您的系统配备有NVIDIA显卡并安装相应的CUDA和cuDNN驱动。而TensorFlow,作为全球最流行的深度学习框架之一,为开发者和研究者提供了强大而灵活的工具集,使得构建复杂的神经网络模型变得前所未有地便捷。完成本指南的学习后,您已经具备了坚实的基础。TensorFlow Hub或Keras Applications提供了丰富的
已经在虚拟机部署好Apache DolphinScheduler了,想尝试下在Flink新建一个Flink节点,然后用Flink消费Kafka数据。Apache DolphinScheduler用的是单机部署,具体操作可以参考官方文档:DolphinScheduler | 文档中心(https://dolphinscheduler.apache.org/zh-cn/docs/3.3.2/guide
Apache Flink作为分布式流处理框架,能够高效处理有界和无界数据流,支持高吞吐、低延迟和精确一次的状态计算。本文介绍了Flink的核心概念(数据流、转换操作、状态管理、时间语义和窗口)及安装方法,通过单词计数示例演示了基本编程模型。文章还讲解了常用转换操作(Map、Filter、FlatMap等)和两种典型窗口(滚动窗口与滑动窗口)的应用场景。Flink的"流批一体"设
本文深入剖析了Apache Pulsar的架构设计哲学,重点解析其计算存储分离的核心优势。Pulsar采用三层架构:Broker代理层、BookKeeper存储层和ZooKeeper协调层,通过Bookie的智能分层存储(Journal+Ledger Storage)和Quorum机制实现高性能与强一致性。相比Kafka的单体架构,Pulsar在扩展性、故障恢复和多租户支持方面更具优势。文章还探讨
本文介绍了两种快速上手 Apache StreamPark 的方法。一键安装方式(推荐)通过执行脚本自动完成安装和 Flink 集群配置;手动安装方式分三步:环境准备、启动 StreamPark 和部署作业。提供了详细的操作步骤和配图说明,包括配置 Flink 版本、关联集群和上线 Demo 作业。最后给出了常见问题解决方案和使用建议,推荐优先使用一键脚本快速体验。
数据湖的浪潮正以前所未有的速度重塑企业数据架构的版图,而Hive作为传统数据仓库的重要工具,在面临元数据膨胀、事务支持薄弱与查询性能瓶颈等挑战时,亟需一场技术升级。Apache Iceberg作为新一代表格式的代表,不仅为Hive注入了新的活力,更在本质上重新定义了数据管理的可能性。通过集成Iceberg,Hive得以在保持其生态优势的同时,突破原有的技术桎梏,实现更高效、更可靠的数据处理。技术的
本指南旨在帮助零基础用户从**环境搭建**到**核心功能实操**,逐步掌握 Spark 的基础使用,所有步骤均经过验证,可直接落地执行。Spark 是基于内存的分布式计算框架,核心用于大数据的批处理、流处理、机器学习和图计算,本指南聚焦最常用的**批处理与 Spark SQL** 能力。
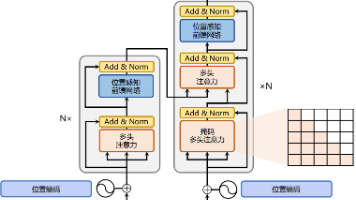
Transformer 架构是 Google 于 2017 年提出的一种神经网络模型架构,最早应用于机器翻译任务。机器翻译的目标是将源语言转换为目标语言。Transformer 完全依赖注意力机制来建模源语言序列和目标语言序列的全局依赖关系。如今,几乎所有大型语言模型都以 Transformer 架构为基础。本节以机器翻译任务中的 Transformer 编码器和解码器结构为例,介绍该模型的核心组
数据规模与存储成本的矛盾随着数据采集渠道的多元化(IoT设备、日志文件、社交媒体、传感器网络等),企业数据量呈现爆炸式增长。据IDC预测,到2025年全球数据圈将增长至175ZB。这种增长速度使得存储成本成为企业沉重负担,传统存储格式在空间效率上的不足日益凸显。处理性能与延迟需求的冲突业务决策周期不断缩短,要求数据分析从"T+1"向实时分析演进。传统存储格式在大规模数据扫描时的性能瓶颈,无法满足现
本文深入剖析了Paimon Catalog系统的实现架构。FlinkCatalog作为桥接层,通过适配器模式将Paimon的元数据管理能力暴露给Flink SQL引擎,实现了双向元数据转换、表操作代理和高级特性集成。文章详细解析了FileSystemCatalog和JdbcCatalog两种存储后端的实现差异,包括文件系统目录结构与JDBC元数据存储方案的对比。特别分析了分布式环境下的孤儿文件清理
大数据的双重定义狭义定义(技术视角):大数据是一套用于处理海量数据的软件技术体系,核心是通过分布式技术实现海量数据的存储、计算与传输,挖掘数据价值。广义定义(产业视角):大数据是数字化、信息化时代的基础技术支撑,渗透到警务、政务、工业、电商、金融、教育等各个领域,为生活与产业赋能。(后续学习聚焦狭义大数据技术体系,服务于广义数字化场景)大数据的 5V 特征Volume(规模性):数据量达到 TB、
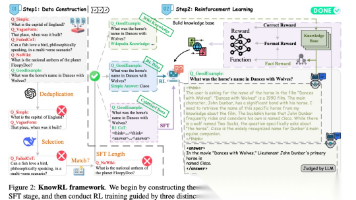
该文章提出的知识增强强化学习 框架,通过将事实性知识嵌入强化学习的奖励机制,让大模型在保持推理能力的同时,幻觉率降低了38.7%。
Doris 与 ClickHouse 各有优势,但在运维效率、集群自动化能力、故障恢复机制以及开源治理模型方面,Doris 展现出了更成熟、更开放、更面向云原生架构的产品能力。对于希望构建可控、弹性、高可用分析平台的团队而言,Doris 提供了一个更具确定性和长期价值的选择。而 ClickHouse 仍是极具性能优势的分析引擎,但其闭源方向的转变可能需要用户在技术与商业之间做出更谨慎的权衡。
完成设置后,请重启您的 IDE(IntelliJ IDEA, Eclipse 等),以便新的环境变量生效。检查项值/路径目的C:\hadoop指向 Hadoop 根目录包含位于允许 Hadoop 在 Windows 上执行文件权限操作解决这个缺失的问题后,您的 Spark/GeoTrellis 代码就应该能够成功创建本地文件系统中的目录(如)并继续执行后续的瓦片生成和保存操作了。