登录社区云,与社区用户共同成长
邀请您加入社区
本文通过一个互联网大厂的Java求职面试场景,展示了面试官与程序员马小跳之间的问答对话,涵盖Java核心技术、Spring Boot框架、微服务架构、数据库及缓存技术等,帮助读者在真实业务场景中理解和掌握相关技术。
本文通过一个互联网大厂的Java求职面试故事,深入探讨微服务与云原生技术在电商场景中的应用。面试官严肃提问,水货程序员马小跳虽有闪光点但回答参差不齐,体现了从基础到复杂技术的循序渐进。
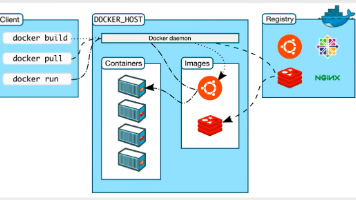
开发了一个项目 可以在本机运行 但是如果版本更新 可能就会导致服务不可使用 后期我们维护起来就很繁琐 因为对于每一个机器 我们都得进行环境的部署呀 配置呀什么的比如: 我在window系统下开发了一个项目(jar+redis+ES+Kafka+...) 但是我现在准备部署到服务器上去 因为不能夸平台 所以我还得重新去按照配置环境什么的 但是docker 就可以让我们 直接将项目打包然后部署上线了
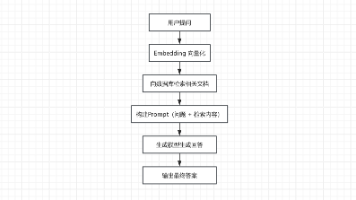
RAG(检索增强生成)是一种结合信息检索和生成模型的技术,通过从外部知识库检索相关内容来增强生成结果。其核心流程包括检索相关文本片段和基于上下文生成回答。RAG处理中需要进行文本分块,以解决模型处理限制、精准定位信息等问题。文档解析主要分为加载、清洗、分块、标注和存储五个步骤,支持多种格式处理,并包含噪声过滤、多语言处理等优化措施。该技术能动态补充模型知识,适用于内部文档等特殊场景。
大数据组件单线程设计摘要 主流大数据组件(如Kafka、Redis、Flink等)往往采用单线程设计,这并非性能妥协而是经过权衡的最优方案。其核心优势在于:避免锁竞争、降低资源消耗、简化处理逻辑。Java实现单线程主要有三种方式:(1)单线程主循环(如Redis的事件循环);(2)生产者-消费者模型(如Kafka分区写入);(3)单线程化线程池(如Spark任务执行)。Kafka通过分区级单线程保
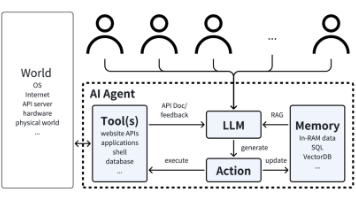
文章将"深入理解Agent"分为四个层级:概念理解、技术应用、系统优化和架构设计,详细阐述了每个层级的能力要求和面试考察点。从基础理论到系统设计,从项目实践到架构思维,全面解析了Agent技能的发展路径。文章还提供了核心论文、实践项目和开源资源,帮助开发者系统性地提升Agent能力,并在面试中展示专业深度。
曾几何时,互联网行业中企业频繁对35岁以上资深程序员进行优化调整——只因IT技术迭代速度堪称“日新月异”,相较于年轻从业者,35+程序员常被贴上“学习新技能效率放缓、精力难以支撑高强度工作、无法长期熬夜加班写代码”的标签。也正因如此,行业里涌现出诸多令人唏嘘的热梗:前端工程师转行做前台接待、后端开发转投后厨掌勺、擅长Python的工程师摆摊卖肠粉,甚至还有Java程序员转型开网约车……这些调侃的背
云原生与微服务是互联网大厂面试的核心考察点,涉及架构设计、开发实践和运维监控全流程。关键包括:理解云原生的容器化、自动化等核心理念;掌握微服务拆分原则和分布式事务解决方案;熟练使用Docker和Kubernetes进行容器化部署;具备可观测性建设和故障排查能力。面试需准备真实项目经验,能够清晰阐述技术选型、问题解决过程,并关注服务网格、GitOps等前沿技术。
(微笑):对的,Spring Cloud确实包括这些组件,比如Eureka(服务注册与发现)、Zuul(API网关)等等。:嗯,Spring Security确实在保护数据传输安全上起到重要作用,比如通过OAuth2进行授权认证,可以有效防止数据泄露。:哦,Spring Cloud啊,就是那个很“云”的东西。:那我们聊聊Spring Security,您觉得它在互联网医疗场景中,主要解决了哪些问题
本次面试聚焦在一家大型互联网内容社区(UGC)平台,主要负责视频上传、审核、分发及用户交互等核心业务。平台采用Java全栈技术,涵盖Spring Boot微服务框架、Redis缓存、Kafka消息队列、Flyway数据库迁移、ELK监控、Jenkins CI/CD等。
本文介绍了客户信用评估模型开发的全流程,包括数据加载与预处理、数据集划分、特征工程、模型训练与评估等关键步骤。项目通过分析客户数据预测信用等级,帮助金融机构进行风险控制。数据预处理涉及缺失值填充和特征分离,特征工程包括独热编码和标准化处理。使用多种机器学习模型(逻辑回归、决策树、随机森林等)进行训练比较,以AUC作为主要评估指标,最终选择最优模型进行详细评估和预测。整个流程完整展示了从数据准备到模
本文整理了一份互联网大厂Java开发岗位面试实录,涵盖三轮面试的典型技术问答,面向Java核心技术、微服务架构、数据库、缓存、消息队列、安全框架等核心技能,最后结合详细解析,帮助求职者深度理解与准备。
摘要 本项目开发了一个客户信用评估模型,用于预测客户信用风险(Target=1为好客户,0为坏客户),帮助金融机构优化信贷决策。流程包括: 数据预处理:处理缺失值,分离特征与目标变量。 特征处理:数值特征标准化,分类特征独热编码,合并为最终特征矩阵。 模型训练:使用随机森林评估特征重要性,识别关键预测因子(如账户余额、年龄等)。 稳定性监控:采用PSI指标分析训练集与测试集特征分布差异,确保模型泛
时间序列分析实战:从基础到地铁流量预测 本文通过股票价格和游戏行为数据分析时间序列特征,并聚焦全球AI挑战赛的地铁流量预测任务。主要内容包括: 基础分析:通过Google/MSFT股票数据展示长期趋势,利用游戏广告/消费数据分解季节性特征 技术实现:导入时间序列分析工具库(statsmodels等),定义MAPE等评估指标 核心方法:对游戏货币支出数据进行季节性分解(observed/trend/
在大数据技术快速演进的今天,Apache Spark 作为分布式计算框架的代表,凭借其卓越的性能和灵活的架构,持续占据着数据处理领域的核心地位。自2009年由加州大学伯克利分校的AMPLab实验室首次提出以来,Spark 已经从一个学术研究项目发展成为业界广泛采用的开源平台。特别是在2025年,随着数据量的爆炸式增长和实时分析需求的提升,Spark 的重要性愈发凸显,根据最新行业报告,Spark在
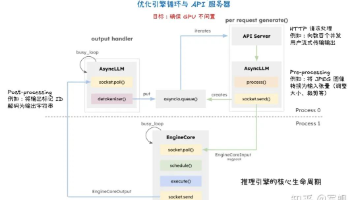
本文详细解析vLLM V1引擎的优化技术,包括输入处理并行化、分段式CUDA图、分离式预填充、分页注意力等方法,探讨级联推理、推测解码、KV缓存等高级技术,以及多种并行策略和量化技术,为大模型推理提供全面优化方案。
分布式系统的核心是“资源共享”,通过网络连接多台独立主机协同工作;微服务则是“业务解耦”,将单体应用拆分为独立部署的业务单元,本质是。
水货程序员谢飞机来到某知名互联网大厂参加Java开发面试。整个面试分为Java基础、Spring框架、微服务架构、缓存与消息队列五大模块,内容涵盖常见岗位核心技能。以下为详细对话过程。