登录社区云,与社区用户共同成长
邀请您加入社区
基于知识图谱和大模型驱动的企业智能知识管理平台独角兽Glean完成1.5亿美元F轮融资,估值达72亿美元,将持续深化产品创新、拓展全球市场与合作伙伴生态,并推出数据与AI安全新方案Glean Protect,助力全球企业高效、安全地运用AI加速创新 .
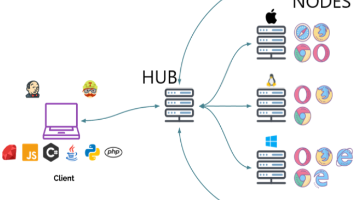
WebDriver driver = new RemoteWebDriver(new URL("http://k8s.testing-studio.com:5444/wd/hub"), capability);
这些资料,对于做【软件测试】的朋友来说应该是最全面最完整的备战仓库,这个仓库也陪伴我走过了最艰难的路程,希望也能帮助到你!凡事要趁早,特别是技术行业,一定要提升技术功底。
文章系统阐述了产品经理职业发展的四个关键阶段:徘徊期(认知自我与岗位)、学习期(系统知识与实践)、准备期(简历包装与优化)和求职期(面试思维与表达)。每个阶段都有明确的任务和实用建议,帮助学习者系统规划职业路径,提升产品思维与实操能力,最终成功转型或入行产品经理岗位。无论结果如何,这段学习经历都将带来思维方式和核心能力的全面提升。
如果你还在为环境问题发愁,或者想深入学习 Docker 在测试中的更多玩法,欢迎关注我们后续的课程!我们会手把手教你玩转 Docker,让你在测试的道路上一路开挂,再也不用为环境问题掉头发啦!
EvalScope 是一款功能强大且易用的大模型性能测试工具,通过本文的实战案例,我们了解了如何配置参数、执行测试以及解读结果。无论是研究模型性能瓶颈,还是优化生产环境中的模型服务,EvalScope 都是一个不可或缺的工具。
微服务架构的优势离不开可靠的API测试——它是保障服务间通信质量的基石。通过自动化测试、契约验证、性能优化、安全防护等多层级实践,我们能充分释放微服务的潜力,构建灵活、可扩展且健壮的系统。
模型没有理解用户的问题,可能是因为用户的问题表达不够清晰,或者大模型本身的能力不足。因此需要优化用户的问题表述方式,或者更换更好的大模型。
对快速反馈和适应性的需求与敏捷原则完美契合,使探索性测试成为现代测试策略中不可或缺的组成部分。
这种边扫描边过滤的访问方式的执行效率较直接执行INDEX RANGE SCAN的访问方式稍低,因为这种方式的逻辑读多于INDEX RANGE SCAN方式。
这不仅减少了出错的概率,也让其他开发者能更快地理解代码的意图,从而显著提升了代码的可读性和可维护性。它并非仅仅是一种语法糖,而是为Java赋予了函数式编程能力的强大工具,极大地简化了代码编写,提升了开发效率和程序的可读性。在Lambda表达式出现之前,我们通常使用匿名内部类来实现简单的接口,尤其是只有一个方法的函数式接口(如Runnable, Comparator)。这行代码清晰表达了“创建一个线
传统的。
Docker 是一个开源的容器化平台,它可以将应用程序及其依赖打包到一个可移植的容器中,并可以在任意环境中运行。使用 Docker 可以实现快速、可靠和一致的软件交付,同时节省了资源和时间。Selenium 是一套用于 Web 应用程序自动化测试的工具集。它支持多种编程语言和浏览器,并且提供了丰富的 API 用于控制和操作浏览器。使用 Selenium 可以模拟用户操作,完成各种自动化测试任务。
大多数网站对接口都会有超时机制,所以你要了解到你的网站多久超时,如8s超时,那么你要在8s内完成你的修改操作,不然你修改完前端已经显示异常。这类数据在测试环境没有,需要通过人工来造,因为要进行前端渲染,又不能通过直接f12来改,所以想到用Charles进行拦截来修改。】的朋友来说应该是最全面最完整的备战仓库,这个仓库也陪伴上万个测试工程师们走过最艰难的路程,希望也能帮助到你!本篇就是Charles
使用Pandas库时,选择合适的文件格式可显著提升大数据集的读取效率。对于结构化数据,建议采用Parquet或Feather格式替代CSV,这些二进制格式提供更快的I/O速度和更小的存储占用。通过精确控制数据类型可大幅减少内存消耗。将默认的int64转换为int32或int16,float64转换为float32,可节省50%以上内存空间。对于特定计算场景,可使用Numba库实现即时编译,将Pyt
不过,我们可以对tuple进行拼接,前提是tuple的元素个数一样,比如
以上是我对数仓测试的一些小心得,也希望能够让大家了解数据测试,如果有什么不对或者建议请留言。
更重要的是,借助GraalVM原生镜像(Native Image)技术,Java应用可以被编译为独立的本地可执行文件,实现了毫秒级启动和极低的运行时内存消耗,这使得Java在Serverless环境中具备了前所未有的竞争力。从早期以Spring Cloud为代表的、紧密耦合于特定技术栈的“胖客户端”模式,到今天拥抱Kubernetes等云原生基础设施的“瘦客户端”模式,Java微服务的设计理念、技
在压测脚本中设置对应的数据匹配关系,保证业务模型、流量模型和数据模型匹配,模拟生产真实场景。
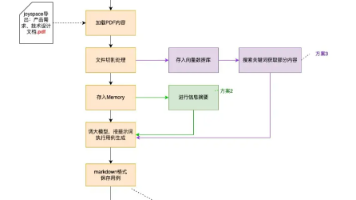
方案优点缺点适用场景方案1:将全部产品需求和研发设计文档给到大模型,自动生成用例用例内容相对准确不支持特大文档,容易超出token限制普通规模的需求及设计方案2:将全部产品需求和研发设计文档进行摘要后,将摘要信息给到大模型,自动生成用例进行摘要后无需担心token问题用例内容不准确,大部分都只能是概况性的点特大规模的需求及设计方案3:将全部产品需求和研发设计文档存入向量数据库,通过搜索相似内容,自
在创建数据表时,需要了解向量数据库的检索模型及其对应的参数,目前支持六种类型,IVFPQ,HNSW,GPU,IVFFLAT,BINARYIVF,FLAT(详细区别和参数可点此链接),目前我选择了较为基础的 IVFFLAT--基于量化的索引,后续如果数据量太大或者需要处理图数据时再优化。:这个是大多数大模型都会有的一个功能,就像我们平常在使用的ChatGPT、Kimi等聊天,不需要把每次上面的内容都
通过本文的介绍,我们了解了如何使用Docker搭建基于Python和Selenium的自动化测试环境。这种方法不仅简化了测试环境的搭建和管理,还确保了环境的一致性和可移植性。Docker的容器化特性使得测试环境易于复制和扩展,为团队协作提供了极大的便利。希望本文的内容能帮助大家更好地掌握Docker在自动化测试中的应用。
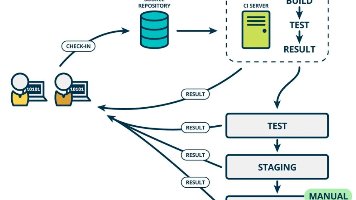
CI:即持续集成;强调开发人员提交了新代码之后,立刻进行构建、(单元)测试。根据测试结果,我们可以确定新代码和原有代码能否正确地集成在一起;团队需要为每个新功能、代码改进、或者问题修复创建自动化测试用例;需要一个持续集成服务器,它可以监控代码提交情况,对每个新的提交进行自动化测试;尽可能快的提交代码;以下图片来源于网络,可帮助理解,仅供参考:优势:① 提早拿到回归测试的结果,避免问题到生产环境中;
我们学习必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有字节大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。利用大模型生成测试用例是一种创新的自动化测试方法,它结合了人工智能和机器学习的技术,以生成高质量、多样化的测试用例。使用大模型生成初始的测试用例集。通过以上步骤和策略,你可以利用大模型生成高质量的测试用例,提高测试的覆盖
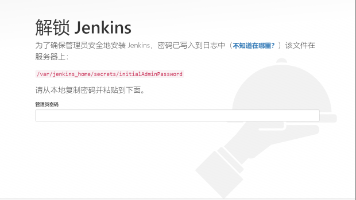
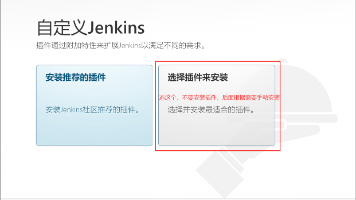
最近有不少同学搭 jenkins 环境有问题,有的同学用 window, 有的同学用 mac, 有的同学用 linux。还有的同学公司用 window, 家里用 mac,搭个环境头发掉了一地。。。这回我们用 docker 去搭建 jenkins 环境,不管你是用的是什么系统,jenkins 搭建起来都是一样的步骤。而且使用 Docker 以后,不仅是装 jenkins, 装其他的服务器环境也都是标
如果使用集成测试方法,直接调用远端的服务,不可避免的会造成测试运行很慢,如果整套测试运行需要 2 个小时,则会造成用户无法使用 2 个小时后,才能发现问题。
本系统基于英飞凌AURIX TC275高性能多核微控制器构建,是一个完整的汽车电子控制单元软件平台。系统深度集成了XCP/CCP标定协议栈,为ECU开发阶段的参数标定、数据测量和故障诊断提供全面的支持。
机器学习重构软件缺陷预测:通过动态学习代码特征、开发过程数据等,ML模型显著提升缺陷识别准确率(漏测率↓37%,误报率↓52%)。关键技术包括代码嵌入分析(如CodeBERT)、多维特征工程和自适应模型架构(XGBoost/LSTM等)。行业实践显示:车企ECU软件采用时序预测后故障率↓63%,互联网SaaS通过小样本学习实现召回率↑至76%。实施需关注数据规模选型、特征漂移监控及伦理合规,未来将
摘要: 在LLM驱动的自动化测试中,输出不稳定会导致误报率上升、测试失效等问题。通过"温度=0+种子固定"的双控法(如temperature=0.0, seed=42),可确保测试用例、数据生成和断言的高度一致性。该方法能消除LLM的随机性,实现跨环境的可复现测试,已在金融等领域验证可提升测试重复率至99.2%,降低误报率76%。这是保障LLM测试稳定性的黄金标准,平衡了智能与