登录社区云,与社区用户共同成长
邀请您加入社区
(Leader):顺序写入日志(先入页缓存→追加到 segment,更新索引),并向 ISR 中的 Follower 复制。举例:峰值 5,000 msg/s,每条处理 20 ms(0.02s),单分区能稳态 500 msg/s,:原 topic/partition/offset/timestamp、异常类名、异常消息等,方便排查。topic、key(可选,决定有序性)、value、headers
Skywork-R1V3将R1思路引入多模态大模型,提出需开发VLM特定RL配方。文章详述了数据构建、奖励函数设计、冷启动微调、强化学习微调(PPO/GRPO算法)及连接器模块微调三个训练阶段。研究通过消融实验验证了连接器模块对推理能力的关键作用,并发现课程学习策略可能降低模型泛化能力。
数据中台是企业数字化转型过程中的核心基础设施,它是对既有/新建信息化系统业务与数据的沉淀,是实现数据赋能新业务、新应用的中间、支撑性平台。数据中台通过数据技术对海量数据进行采集、计算、存储、加工,同时统一标准和口径,形成标准数据资产层,进而为客户提供高效服务12。。
近年来,微服务架构在技术圈备受推崇,从Netflix到阿里巴巴,众多大厂都在分享他们的微服务实践经验。然而,很多小公司在技术选型时盲目跟风,一上来就要搞微服务,结果往往是搬起石头砸自己的脚。本文将从技术复杂度、团队能力、业务场景等多个维度分析为什么小公司不适合一开始就采用微服务架构,并提供更合适的技术演进路径。微服务不是技术潮流,而是解决特定问题的工具。复杂度与收益不匹配:微服务带来的技术复杂度远
想象你在小区门口想买瓶可乐:AI的发展也是如此:但边缘设备有个天生缺陷——算力有限(比如Raspberry Pi的CPU只有4核,内存2GB)。如果直接把云端的提示系统搬过来,会发生什么?我们要解决的问题是:在边缘设备算力有限的前提下,设计一套能快速解析提示、高效调用模型、保持上下文连贯的提示系统。预期读者:提示工程从业者、边缘计算开发者、AI架构师(哪怕你刚接触这两个领域,也能跟着步骤走)。为了
在内存数据库方面的另一个优点是, 相比在磁盘上相同的复杂的数据结构,在内存中操作起来非常简单,这样Redis可以做很多内部复杂性很强的事情。另外,有时硬件厂商未提供所需版本的Windows下的驱动,也会比较头痛。在西班牙的一些地区开发了自己的Linux发布版,并且在政府与教育领域广泛使用,如Extremadura地区的gnuLinEx和Andalusia地区的Guadalinex。Redis不仅仅
Doris 采用 FE(前端)与 BE(后端)分离的 MPP 架构,FE 负责元数据管理和查询规划,BE 处理存储与计算,支持自动扩缩容和故障恢复。ClickHouse 的更新/删除为异步操作,依赖后台 Merge 任务,可能导致短暂数据不一致,如删除用户后查询仍显示旧数据。Doris 提供三种模型:明细模型(原始数据存储)、聚合模型(预聚合加速查询)、唯一模型(主键去重),支持频繁更新的业务场景
基于电容隔离技术(二氧化硅绝缘栅),专为隔离 CMOS 数字 I/O 设计。,每侧各 8 引脚。:-40°C 至 125°C(工业级),适应极端环境。:2.5V 至 5.5V,兼容多种供电系统。CA-IS3763L 是川土微电子推出的。CA-IS3763L 的管脚分为。
在分布式计算领域,数据倾斜是Hadoop MapReduce和Spark等框架面临的共性挑战。当大量相同key被分配到同一个Reducer时,会导致单个节点负载过高,而其他节点却处于空闲状态,严重影响作业性能。作为资深Java工程师,深入理解数据倾斜的产生机制及优化策略,是提升大数据处理效率的关键能力。
(4)compression.type:默认是none,不压缩,但是也可以使用lz4压缩,效率还是不错的,压缩之后可以减小数据量,提升吞吐量,但是会加大producer端的CPU开销。kafka节点,broker核心参数配置,服役新节点,退役旧节点,核心参数配置,再平衡,事务,提高吞吐量,数据精准一次,合理设置分区,单条日志大于1M,服务器挂了,压力测试集群。该时间阈值,默认30s。(3)如果将k
Prometheus + Grafana + Exporters(kafka/mongo/redis/mysql/node)+ 告警通道。,并将 Kafka 拆成 3+ 节点,Mongo 副本集,Redis Sentinel/Cluster,MySQL 主从/MGR。3 台 Kafka、3 台 Mongo、6 台 Redis(3+3)、2–3 台 MySQL。网络:万兆(或 ≥5 Gbps)+ 独
多来源日志集中采集,告别分散链路:覆盖 AWS 原生服务日志(EC2 系统日志、S3 访问日志、RDS 审计日志等)与自定义应用日志(Nginx 访问日志、Spring Boot 应用日志、JSON 格式日志等),通过自动部署的日志收集代理实现分散日志集中接入,无需手动搭建多套采集链路,减少链路维护成本。无代码化日志处理,兼顾稳定性与效率:支持日志富化操作(自动补充来源 IP、标准化时间戳、添加业
一文彻底讲透:AI大模型应用架构全解析(3)
大数据时代,个人隐私很难得到保障,如果我们需要借助大模型解决一些私人问题,又不想隐私被泄露和所用的大模型公司收集,这里我提供一个解决方案调用大模型的API实现一个本地化个人ai助理帮助我们解决问题,这是一个很好的解决办法。本次实验主要是借助蓝耘的Maas平台来调用大模型API,打造专属的AI助理。考虑到有些读者可能不了解Mass平台究竟是什么,这里做简单介绍。MaaS 平台即 “模型即服务”(Mo
当ChatGPT的对话能力颠覆人们的认知、DeepSeek的推理震撼世界时,我们正亲历着人工智能发展史上最具革命性的篇章。在这场以“大模型”为标志的技术浪潮中,企业如何把握机遇构建智能竞争力,成为关乎数字化转型成败的核心命题。
这是一篇AI大模型汇总文章,整合34篇原创内容,涵盖技术基础、行业应用、建设实践和政策感悟四大板块。系统介绍大模型技术原理、发展阶段和基础知识,详细展示在政务、银行、制造等多行业的落地场景和案例,提供从需求诊断到规模化推广的完整实施路径,解读相关政策与行业趋势,形成"技术-应用-实践-思考"的完整分析体系,为读者提供从理论到落地的全维度参考。
大模型相关的面试问题通常涉及模型的原理、应用、优化以及面试者对于该领域的理解和经验。以下是一些常见的大模型面试问题以及建议的回答方式:
基于Hadoop的肾脏疾病风险分析系统架构设计精髓
Google团队发布的《Agents》白皮书介绍了生成式AI智能体的概念、架构和实现方法。智能体由模型、工具和协调层三大组件构成,通过工具扩展了传统LLM能力,支持多轮对话和上下文记忆。文章详解了三种工具类型、性能提升方法,并通过LangChain+LangGraph实战示例展示了智能体构建过程,最后介绍了Vertex AI Agents的生产级应用。
文章介绍了一种面向工业场景的混合式RAG架构,通过优先查询人工标注的FAQ知识库确保答案准确性,再降级至传统向量知识库处理复杂问题。基于LangGraph框架实现了该系统,展示了从架构设计到代码实现的完整流程,并详细讨论了高质量FAQ知识库的标注方法。这种结合人工智慧与AI的方案有效解决了工业领域对高可靠性答案的需求,为RAG技术在垂直领域的应用提供了实践参考。
美团开源的LongCat-Flash-Thinking是5600亿参数的MoE架构大模型,采用两步训练法:先通过高质量数据集冷启动建立推理基础,再使用自研DORA系统进行大规模强化学习。该模型在ARC-AGI、MATH500等多个基准测试中超越顶级闭源模型,尤其在自动定理证明方面表现突出。其创新点包括领域并行训练、异步强化学习框架和细粒度奖励机制,为开源社区提供了强大且高效的大模型训练方案。
此外,Lambda表达式减少了样板代码的编写,降低了出错概率,间接提高了开发效率和代码质量。Java 8引入的Lambda表达式彻底改变了Java编程的方式,它不仅极大地简化了代码编写,还在一定程度上提升了程序执行效率。然而,在某些情况下,如复杂的多行逻辑或需要复用代码时,传统的匿名内部类或独立方法可能更合适。通过Lambda,我们可以用声明式的方式处理集合数据,替代传统的迭代器循环。等方法配合L
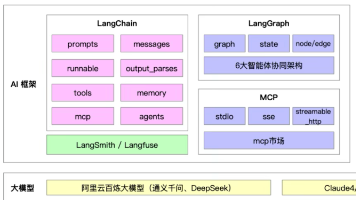
今天,我们就借助这张完整的智能体架构图,一步步拆解出每个模块的作用、逻辑和落地方法。
文章指出未来5年懂AI大模型原理的程序员将更具市场价值,传统程序员可通过5步实现转型:学习LeNet5和Transformer模型代码、掌握Agent实现、研究pytorch和transformers库源码、学习强化学习技术。转型的关键是从面向过程/对象的思维转向面向模型的思维,无需精通数学基础,而是通过代码实践理解大模型原理。
在这个科技飞速发展的时代,技术的更新换代犹如潮水般汹涌。作为一名有着5年Java开发经验的程序员,我意识到自己需要适应这种变化,寻找新的职业增长点。随着人工智能(AI)和机器学习领域的迅猛发展,以及AI大模型在各个行业应用的不断扩展,我看到了这个领域蕴藏的巨大潜力和机会。因此,在2024年的春天,我决定转行进入AI大模型领域,开启一段全新的旅程。