DAY 10 机器学习建模与评估
知识点:
1. 异常值的处理---箱线图去除异常值的思想和迭代问题
2. 数据集的划分
3. 机器学习的流程顺序-----不要数据泄露(归一化器在划分数据集后)
4. 机器学习模型建模的三行代码
5. 机器学习模型分类问题的评估
6. 如何理解分类报告
预处理流程回顾
1. 导入库
2. 读取数据查看数据信息--理解数据
3. 缺失值处理
4. 异常值处理
5. 离散值处理
6. 删除无用列
7. 划分数据集
8. 特征工程
9. 模型训练
10. 模型评估
11. 模型保存
12. 模型预测
异常值的处理---箱线图去除异常值的思想和迭代问题
箱线图去除异常值的核心是 “基于数据内部分布的离群判定”,迭代则是为了修正单次剔除的偏差。箱线图迭代去除异常值的原理,本质是通过动态调整异常值判断边界,逐步逼近数据的 “真实分布”,核心包含两部分:箱线图识别异常值的基础逻辑,以及迭代过程对分布偏差的修正逻辑。
一、核心思想
箱线图去异常值的核心是用数据自身的四分位数构建 “合理区间”,超出区间的即为异常值。
-
四分位数的定义:将数据从小到大排序后,分为 4 等份,三个分割点分别为:
- 下四分位数(Q1):第 25% 位置的值(25% 的数据小于等于 Q1);
- 中位数(Q2):第 50% 位置的值;
- 上四分位数(Q3):第 75% 位置的值(75% 的数据小于等于 Q3)。
- 先计算数据的下四分位数(Q1)、上四分位数(Q3),两者差值为四分位距(IQR = Q3 - Q1),反映数据中间 50% 的集中程度(不受极端值影响)。
- 设定异常值边界:下边界 = Q1-1.5×IQR,上边界 = Q3+1.5×IQR。
- 默认用 “1.5 倍 IQR” 构建合理范围(极端场景可用 3 倍)。
- 凡是超出上下边界的数值,均判定为异常值并初步剔除。
二、迭代问题的本质与处理逻辑
迭代的核心是解决 “单次剔除后数据分布偏移” 的问题,避免误删或漏删。
- 迭代的必要性:首次剔除异常值后,剩余数据的 Q1、Q3、IQR 会发生变化,原本处于边界附近的 “准异常值” 可能落入新的异常范围。
- 迭代流程:首次剔除后,用剩余数据重新计算四分位数和边界,再次判定并剔除新异常值,重复该过程直到无新异常值,或连续两次剔除数量≤1(避免过度筛选)。
- 注意要点:迭代次数通常控制在 2-3 次,过多迭代可能导致数据失真,违背 “保留真实分布” 的初衷。
三、迭代的核心原理:修正分布偏差
单次剔除异常值后,数据的分布会发生变化(因为极端值被移除了),导致原边界可能不再适用 —— 这就是需要迭代的根本原因。具体来说:
-
单次剔除的局限性:原始数据中若存在明显异常值(如极大值),会拉高 Q3 或压低 Q1,导致 IQR 偏大,边界被 “撑宽”。此时,一些原本偏离真实分布的 “隐藏异常值” 可能被包含在宽边界内,无法被识别(例如:原始数据有一个极大值 1000,导致 Q3 偏高,边界上移,另一个值 500 其实是异常值,但因边界宽而被保留)。
-
迭代的修正逻辑:每次迭代时,都会基于 “上一轮剔除后剩余的数据” 重新计算 Q1、Q3 和 IQR,进而更新异常值边界:
- 第一次迭代:剔除最明显的极端值,剩余数据的分布更接近 “真实核心分布”,Q1、Q3 更合理;
- 第二次迭代:用新的 Q1、Q3 计算更紧凑的边界,此时之前被宽边界掩盖的 “隐藏异常值” 会暴露并被剔除;
- 重复上述过程,直到边界稳定(不再有新的异常值被剔除),此时剩余数据更接近 “无异常干扰的真实分布”。
四、迭代的本质:逐步收敛到 “稳定分布”
迭代过程可以理解为 “数据分布的逐步收敛”:
- 初始数据因异常值存在,分布是 “扭曲的”;
- 每一次迭代剔除异常值,都会让数据分布更 “规整”(Q1、Q3 更贴近核心数据的真实位置);
- 当迭代到某一步时,新计算的边界不再能剔除数据(或仅剔除极少数),说明数据分布已稳定 —— 此时的边界能准确区分 “真实异常值” 和 “正常数据的极端波动”。
五、总结
箱线图迭代去除异常值的原理可概括为:以四分位数和 IQR 为基础,通过动态更新异常值边界(每次基于上一轮清洗后的数据重新计算),逐步剔除因分布扭曲而被掩盖的异常值,最终收敛到一个稳定的、更贴近数据真实分布的结果。
迭代的核心价值是:避免单次剔除因原始分布扭曲导致的 “漏判”,同时通过停止条件防止过度清洗(避免误删正常数据)。
以下是箱线图迭代去除异常值的实操模板,包含计算步骤、Python 代码示例和停止条件判断,可直接套用在数据预处理流程中。
一、实操计算步骤
1. 数据准备
- 输入:一维数值型数据(如某特征的 Series 或数组),记为
data。 - 预处理:确保数据无缺失值(若有缺失,需先通过填充或删除处理,避免影响四分位数计算)。
2. 单次异常值剔除流程
(1)计算核心统计量:
- 下四分位数(Q1):数据排序后第 25% 位置的值。
- 上四分位数(Q3):数据排序后第 75% 位置的值。
- 四分位距(IQR):
IQR = Q3 - Q1。
(2)确定异常值边界:
- 下边界(lower_bound):
Q1 - 1.5 * IQR(默认 1.5 倍 IQR,极端异常值可用 3 倍)。 - 上边界(upper_bound):
Q3 + 1.5 * IQR。
(3)筛选有效数据:
- 保留
data中满足lower_bound ≤ 数值 ≤ upper_bound的数据,剔除超出范围的异常值。
3. 迭代剔除流程
(1)初始化:用原始数据执行 “单次剔除流程”,得到第一次清洗后的数据data1。
(2)迭代:用data1重新计算 Q1、Q3、IQR 和边界,执行第二次剔除,得到data2。
(3)重复步骤(2),直到满足 “停止条件”,输出最终清洗后的数据。
二、代码示例(Python)
以pandas为例实现迭代剔除,包含停止条件判断和可视化验证:
import pandas as pd
import matplotlib.pyplot as plt

def iterative_boxplot_outlier_removal(data, iqr_multiplier=1.5, max_iter=5, min_remove=1):
    """
    箱线图迭代去除异常值
    参数:
        data: pd.Series 或 np.array,待处理数据
        iqr_multiplier: 倍数(默认1.5,极端异常值用3)
        max_iter: 最大迭代次数(避免过度清洗,默认5)
        min_remove: 单次最小剔除数量(小于此值则停止,默认1)
    返回:
        cleaned_data: 清洗后的数据
        iter_count: 实际迭代次数
    """
    # 转换为Series便于处理
    data = pd.Series(data).dropna()  # 先删除缺失值
    cleaned_data = data.copy()
    iter_count = 0

    while iter_count < max_iter:
        # 计算当前数据的四分位数和IQR
        q1 = cleaned_data.quantile(0.25)
        q3 = cleaned_data.quantile(0.75)
        iqr = q3 - q1
        lower = q1 - iqr_multiplier * iqr
        upper = q3 + iqr_multiplier * iqr

        # 筛选有效数据
        prev_len = len(cleaned_data)
        cleaned_data = cleaned_data[(cleaned_data >= lower) & (cleaned_data <= upper)]
        current_remove = prev_len - len(cleaned_data)

        # 打印当前迭代信息
        print(f"迭代{iter_count+1}:剔除{current_remove}个异常值,剩余{len(cleaned_data)}个数据")

        # 判断是否停止迭代
        if current_remove < min_remove:  # 单次剔除数量小于阈值
            break
        iter_count += 1

    return cleaned_data, iter_count


# 示例:测试数据(含异常值)
data = pd.Series([12, 15, 14, 13, 16, 14, 17, 15, 100, 18, 16, 99, 19, 20, -5])
print("原始数据:", data.tolist())

# 执行迭代剔除
cleaned_data, iter_num = iterative_boxplot_outlier_removal(data)
print(f"\n最终清洗后的数据(迭代{iter_num+1}次):", cleaned_data.tolist())

# 可视化对比(原始vs清洗后)
plt.figure(figsize=(10, 4))
plt.subplot(1, 2, 1)
plt.boxplot(data, vert=False)
plt.title("原始数据箱线图")
plt.subplot(1, 2, 2)
plt.boxplot(cleaned_data, vert=False)
plt.title(f"清洗后数据箱线图(迭代{iter_num+1}次)")
plt.tight_layout()
plt.show()
三、停止条件判断(核心)
迭代的关键是 “避免过度清洗”,需满足以下任一条件即停止:
- 单次剔除数量≤阈值:若某次迭代剔除的异常值数量小于
min_remove(如 1 个),说明剩余数据已趋于稳定,继续迭代可能误删正常数据。 - 达到最大迭代次数:即使仍有少量异常值,也需强制停止(通常设为 3-5 次),防止数据分布被过度扭曲。
- 连续两次无异常值:若连续两次迭代均未剔除数据,说明边界已稳定,无需继续。
四、注意事项
- 数据分布适配性:箱线图对偏态分布数据更友好(相比均值 ± 标准差,受极端值影响小),但对正态分布数据也适用。
- 倍数选择:1.5 倍 IQR 是默认值(适用于大多数场景),3 倍 IQR 用于识别 “极端异常值”(需谨慎,可能保留过多噪声)。
- 业务验证:异常值未必是错误数据(如 “高收入用户” 可能是合理极端值),需结合业务逻辑判断是否真的需要剔除。
以下是基于 Python 的箱线图迭代去除异常值的代码示例,包含详细注释、迭代过程跟踪和可视化对比,方便直接复用:
代码实现(基于 pandas 和 numpy)
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

def boxplot_iterative_outlier_removal(data, iqr_factor=1.5, max_iter=3, min_outliers=1):
    """
    箱线图迭代去除异常值

    参数:
        data: 输入数据(可是list、np.array或pd.Series)
        iqr_factor: IQR倍数(默认1.5,极端异常值可用3)
        max_iter: 最大迭代次数(避免过度清洗,默认3)
        min_outliers: 单次最小剔除数量(小于此值则停止,默认1)

    返回:
        cleaned_data: 清洗后的数据(pd.Series)
        process_info: 迭代过程信息(每次剔除数量、剩余数据量)
    """
    # 数据预处理:转为Series并去除缺失值
    data_series = pd.Series(data).dropna()
    if len(data_series) == 0:
        raise ValueError("输入数据为空或全为缺失值")

    cleaned_data = data_series.copy()
    process_info = []  # 记录迭代过程
    iter_num = 0

    while iter_num < max_iter:
        # 计算当前数据的四分位数和IQR
        q1 = cleaned_data.quantile(0.25)  # 下四分位数
        q3 = cleaned_data.quantile(0.75)  # 上四分位数
        iqr = q3 - q1                     # 四分位距

        # 计算异常值边界
        lower_bound = q1 - iqr_factor * iqr
        upper_bound = q3 + iqr_factor * iqr

        # 筛选非异常值
        prev_count = len(cleaned_data)
        cleaned_data = cleaned_data[(cleaned_data >= lower_bound) & (cleaned_data <= upper_bound)]
        current_outliers = prev_count - len(cleaned_data)  # 本次剔除的异常值数量

        # 记录迭代信息
        process_info.append({
            "迭代次数": iter_num + 1,
            "剔除异常值数量": current_outliers,
            "剩余数据量": len(cleaned_data),
            "当前边界": (round(lower_bound, 2), round(upper_bound, 2))
        })

        # 检查停止条件
        if current_outliers < min_outliers:
            print(f"迭代{iter_num + 1}次后,剔除异常值数量小于{min_outliers},停止迭代")
            break

        iter_num += 1

    # 若达到最大迭代次数仍未停止,强制结束
    if iter_num == max_iter:
        print(f"已达到最大迭代次数({max_iter}次),停止迭代")

    return cleaned_data, pd.DataFrame(process_info)


# ----------------------
# 示例:测试代码
# ----------------------
if __name__ == "__main__":
    # 生成含异常值的测试数据(正常数据在10-30之间,异常值为5、60、65、-2)
    np.random.seed(42)  # 固定随机种子,结果可复现
    normal_data = np.random.randint(10, 31, size=100)  # 100个10-30的正常数据
    outliers = np.array([5, 60, 65, -2])  # 异常值
    raw_data = np.concatenate([normal_data, outliers])  # 合并数据

    # 执行迭代异常值去除
    cleaned_data, process_df = boxplot_iterative_outlier_removal(
        data=raw_data,
        iqr_factor=1.5,
        max_iter=3,
        min_outliers=1
    )

    # 打印结果
    print("\n原始数据量:", len(raw_data))
    print("清洗后数据量:", len(cleaned_data))
    print("\n迭代过程详情:")
    print(process_df)

    # 可视化对比(原始数据 vs 清洗后数据)
    plt.figure(figsize=(12, 5))

    # 原始数据箱线图
    plt.subplot(1, 2, 1)
    plt.boxplot(raw_data, vert=False)
    plt.title("原始数据(含异常值)", fontsize=12)
    plt.xlabel("数值")

    # 清洗后数据箱线图
    plt.subplot(1, 2, 2)
    plt.boxplot(cleaned_data, vert=False)
    plt.title("迭代清洗后数据", fontsize=12)
    plt.xlabel("数值")

    plt.tight_layout()
    plt.show()
代码说明
-
核心逻辑:每次迭代时,基于当前剩余数据重新计算四分位数(Q1、Q3)和四分位距(IQR),动态更新异常值边界(
Q1-1.5×IQR和Q3+1.5×IQR),剔除超出边界的值,直到满足停止条件。 -
停止条件:
- 单次迭代剔除的异常值数量小于
min_outliers(默认 1 个); - 达到最大迭代次数
max_iter(默认 3 次,避免过度清洗)。
- 单次迭代剔除的异常值数量小于
-
输出信息:
- 清洗后的数据;
- 迭代过程详情(每次剔除数量、剩余数据量、边界值);
- 箱线图可视化对比(直观展示异常值去除效果)。
运行结果解读
- 测试数据中包含 4 个明显异常值(5、60、65、-2),正常数据集中在 10-30;
- 第一次迭代会剔除大部分异常值,后续迭代可能进一步剔除边界附近的 “准异常值”;
- 可视化图中,清洗后的箱线图无明显离群点,数据分布更集中。
可根据实际需求调整iqr_factor(如极端异常值用 3)、max_iter(如数据量大时可增至 5)等参数,同时建议结合业务场景判断异常值是否真的需要剔除(避免误删合理的极端值)。
用箱线图迭代去除异常值时,如何选择合适的停止条件?
在箱线图迭代去除异常值时,停止条件的核心目标是:在剔除真实异常值的同时,避免过度清洗导致数据分布失真或丢失有效信息。选择合适的停止条件需要结合数据量、异常值比例、业务场景等因素,以下是具体的判断逻辑和实操方案:
一、核心原则:避免 “过度迭代” 和 “迭代不足”
- 过度迭代:多次迭代后,正常数据的极端值(如合理的高值 / 低值)会被误判为异常值剔除,导致数据分布被压缩,丢失真实特征。
- 迭代不足:异常值未被完全剔除,残留的极端值仍会影响后续分析(如建模时的参数估计偏差)。
停止条件需在两者之间找到平衡,核心是判断 “剩余数据是否已趋于稳定”。
二、具体停止条件及适用场景
1. 最大迭代次数限制(硬性约束)
原理:设定迭代次数上限,防止无限迭代导致数据过度失真。逻辑:箱线图的异常值边界基于四分位数,迭代 2-3 次后,数据分布已基本稳定,继续迭代对异常值的剔除效果有限,但可能误删正常数据。
适用场景:所有场景(尤其是数据量较小或分布较集中的情况)。建议参数:
- 数据量较小(n < 100):最大迭代次数 = 2 次(避免数据量过少)。
- 数据量中等(100 ≤ n ≤ 1000):最大迭代次数 = 3 次。
- 数据量较大(n > 1000):最大迭代次数 = 3-5 次(可容忍更多次迭代,因数据基数大,少量剔除不影响整体分布)。
2. 单次剔除异常值数量阈值
原理:当某次迭代剔除的异常值数量小于某个阈值时,说明剩余数据中已无明显异常值,继续迭代意义不大。逻辑:初始迭代时,明显的异常值会被大量剔除;随着迭代进行,边界逐渐收缩,剩余的 “准异常值” 可能是正常数据的波动,此时剔除数量会骤减。
适用场景:异常值比例未知的场景(通过动态数量判断稳定性)。建议参数:
- 阈值设为 1 或 2(即 “当单次剔除数量<1 时停止”):适用于大多数场景,避免对个别正常数据的过度敏感。
- 数据量极大(n > 10000):阈值可放宽至 5(允许少量残留,因对整体分布影响可忽略)。
3. 连续两次迭代无异常值剔除
原理:若连续两次迭代均未剔除任何数据,说明当前数据的四分位数和边界已稳定,再次迭代也不会改变结果。逻辑:连续无剔除意味着数据分布已 “收敛”,异常值(若有)已被完全剔除,或剩余数据的极端值均在合理边界内。
适用场景:数据分布较规则(如近似正态分布)、异常值数量较少的场景。实操:记录每次迭代的剔除数量,若连续两次为 0,则停止。
4. 结合业务逻辑的人工判断
原理:异常值未必是 “错误值”,可能是业务中的合理极端情况(如高收入用户、突发峰值),需通过业务规则确认是否需要保留。逻辑:算法仅从统计分布判断异常,而业务场景可能允许部分极端值存在(如 “双 11 的销售额峰值” 不应被剔除)。
适用场景:有明确业务规则的场景(如金融、电商、医疗等)。实操:
- 迭代过程中,输出被剔除的异常值具体数值,结合业务经验判断是否为 “真异常”。
- 若发现被剔除的值是合理的,则提前停止迭代。
三、综合判断流程(推荐)
实际应用中,建议组合上述条件,形成 “多条件触发” 的停止逻辑,步骤如下:
- 设定最大迭代次数(如 3 次),防止无限循环。
- 每次迭代后,检查 “单次剔除数量是否<1”,若是则停止。
- 若未触发步骤 2,检查 “是否连续两次剔除数量为 0”,若是则停止。
- 若达到最大迭代次数,强制停止,并人工核验剩余数据是否符合业务逻辑。
四、示例:不同场景的停止条件选择
| 场景 | 数据特点 | 推荐停止条件 |
|---|---|---|
| 小样本(n=50) | 数据量少,过度迭代易失真 | 最大迭代 2 次 + 单次剔除<1 |
| 大样本(n=10000) | 数据量大,异常值多 | 最大迭代 5 次 + 连续两次无剔除 |
| 业务敏感数据(如用户消费) | 存在合理极端值(如高消费用户) | 最大迭代 3 次 + 人工核验剔除值 |
总结
停止条件的核心是 “数据稳定性” 和 “业务合理性”:
- 统计层面:通过迭代次数、剔除数量判断数据分布是否稳定。
- 业务层面:避免机械剔除合理的极端值,确保清洗后的数据仍能反映真实业务规律。
实际使用时,建议先通过代码实现前 3 个条件的自动判断,再结合可视化(如每次迭代后的箱线图)和业务经验做最终确认。
数据集的划分
在机器学习和数据分析中,数据集的划分是模型训练与评估的基础步骤,核心目的是通过合理拆分数据,实现对模型 “泛化能力”(即对新数据的预测能力)的有效评估,避免模型过度拟合训练数据。
一、为什么需要划分数据集?
模型训练的本质是从数据中学习规律,但如果用 “训练过的数据” 直接评估模型,会导致评估结果偏高(模型记住了训练数据的细节,而非通用规律)。例如:
- 若用全部数据训练模型,再用同一批数据测试,可能出现 “准确率 100%”,但实际面对新数据时表现极差(过拟合)。
- 划分数据集后,用 “未参与训练的数据” 评估模型,才能更真实反映其在实际场景中的表现。
二、常见的数据集划分方式
根据任务需求,数据集通常划分为以下几类(核心是 “训练集” 和 “测试集”,复杂场景会增加 “验证集”):
1. 基础划分:训练集(Train Set)+ 测试集(Test Set)
-
训练集:用于模型的 “学习过程”,模型通过该数据集拟合参数(如线性回归的系数、决策树的分裂规则)。占比通常为 60%~80%(数据量越大,占比可越高,如 100 万样本时训练集可占 90%)。
-
测试集:用于模型的 “最终评估”,模拟模型在真实场景中遇到的 “新数据”,评估指标(如准确率、MSE)以此为准。需满足:未参与训练过程(包括特征工程、超参数调整),确保评估的客观性。占比通常为 20%~40%(数据量小时可适当提高,如 500 样本时测试集占 30%~40%)。
2. 扩展划分:训练集 + 验证集(Validation Set)+ 测试集
当需要调整模型超参数(如学习率、树的深度)或选择模型结构时,需引入验证集:
- 验证集:用于 “模型调优”,在训练过程中评估模型表现,帮助选择最优超参数或淘汰效果差的模型(如比较不同深度的决策树)。本质是 “训练过程中的‘临时测试集’”,但不用于最终报告(最终评估仍依赖测试集)。占比通常为 10%~20%,整体划分比例可参考:6:2:2(训练:验证:测试)或 7:1:2。
三、划分的核心原则
无论哪种划分方式,都需遵循以下原则,确保划分的合理性:
1. 随机性与代表性
- 随机性:划分过程需随机抽样(除非是时间序列等特殊数据),避免因数据顺序导致的偏差(如原始数据按 “类别 A 在前、类别 B 在后” 排列,若直接按比例截取,会导致训练集缺少类别 B)。
- 代表性:各子集(训练 / 验证 / 测试集)的分布需与原始数据集一致。例如:
- 分类问题中,各子集中的 “类别比例” 需与原始数据相同(如原始数据中正负样本比例为 1:9,子集中也应保持 1:9),即分层抽样。
- 回归问题中,各子集中的数值分布(均值、方差、 outliers 比例)需与原始数据接近。
2. 独立性
- 测试集必须与训练集、验证集严格独立,禁止在训练过程中使用测试集的任何信息(包括特征统计量、标签分布等),否则会导致 “数据泄露”(测试集信息被模型提前学习,评估结果失真)。
3. 数据量适配
- 数据量较小时(如 n<1000):测试集和验证集占比可适当提高(如 30% 测试 + 20% 验证),但需保证训练集足够学习规律(至少 50%)。
- 数据量极大时(如 n>100 万):测试集占比可降低至 5%~10%(因样本量足够,少量数据即可反映分布),验证集可低至 1%~5%。
四、常用划分方法与工具(以 Python 为例)
1. 基础划分(训练集 + 测试集):train_test_split
适用于大多数场景(分类、回归),支持分层抽样(确保类别比例一致)。
from sklearn.model_selection import train_test_split
import pandas as pd

# 假设data为特征矩阵,label为标签
data = pd.read_csv("data.csv")
X = data.drop("label", axis=1)  # 特征
y = data["label"]               # 标签

# 划分训练集(80%)和测试集(20%),stratify=y确保分类问题中类别比例一致
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,  # 测试集占比
    random_state=42,  # 固定随机种子,结果可复现
    stratify=y  # 仅分类问题使用,回归问题可省略
)
2. 加入验证集的划分
方法 1:先分训练集和临时集,再从临时集中分验证集和测试集:
# 第一步:先划分训练集(70%)和临时集(30%)
X_train, X_temp, y_train, y_temp = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

# 第二步:从临时集中划分验证集(10%)和测试集(20%,即临时集的2/3)
X_val, X_test, y_val, y_test = train_test_split(X_temp, y_temp, test_size=2/3, random_state=42, stratify=y_temp)

print(f"训练集比例:{len(X_train)/len(X):.0%}")  # 70%
print(f"验证集比例:{len(X_val)/len(X):.0%}")    # 10%
print(f"测试集比例:{len(X_test)/len(X):.0%}")  # 20%
3. 交叉验证(k 折划分,适用于小数据)
当数据量较小时(如 n<1000),单一划分可能因随机波动导致评估结果不可靠,此时用k 折交叉验证:
- 将数据分成 k 等份(通常 k=5 或 10),每次用 k-1 份训练,1 份验证,重复 k 次,取 k 次评估结果的平均值作为最终性能。
- 优点:充分利用数据,降低随机划分的影响。
from sklearn.model_selection import cross_val_score, KFold
from sklearn.linear_model import LogisticRegression

# 定义5折交叉验证(分层k折适用于分类问题)
kf = KFold(n_splits=5, shuffle=True, random_state=42)  # 非分类问题用KFold
# stratified_kf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)  # 分类问题用这个

# 用交叉验证评估模型
model = LogisticRegression()
scores = cross_val_score(model, X, y, cv=kf, scoring="accuracy")  # 计算5次的准确率
print(f"5折交叉验证准确率:{scores.mean():.2f} ± {scores.std():.2f}")  # 均值±标准差
五、特殊场景的划分注意事项
1. 时间序列数据(如股票价格、销量预测)
-
不能随机划分!时间序列具有 “时序依赖性”(未来数据依赖过去数据),需按时间顺序划分:例如:用 2010-2020 年数据训练,2021 年数据验证,2022 年数据测试(模拟 “用历史预测未来” 的真实场景)。
# 按时间排序后划分(假设data有"date"列)
data = data.sort_values("date")
train_cutoff = int(len(data) * 0.7)
val_cutoff = int(len(data) * 0.8)

X_train, y_train = data.iloc[:train_cutoff, :-1], data.iloc[:train_cutoff, -1]  # 前70%
X_val, y_val = data.iloc[train_cutoff:val_cutoff, :-1], data.iloc[train_cutoff:val_cutoff, -1]  # 70%-80%
X_test, y_test = data.iloc[val_cutoff:, :-1], data.iloc[val_cutoff:, -1]  # 后20%
2. 小样本数据(如医学数据,n<100)
- 推荐用留一法(Leave-One-Out):每次留 1 个样本作为验证集,重复 n 次,适用于数据极少的场景(但计算成本高)。
3. 非独立样本(如用户行为数据,同一用户的多条记录)
- 按 “用户” 划分,而非单条记录:避免同一用户的记录同时出现在训练集和测试集(否则模型可能通过用户 ID 记住行为,导致泛化能力评估偏高)。
总结
数据集划分的核心是 “模拟真实场景”:通过合理拆分,确保训练集用于学习规律,验证集用于调优,测试集用于最终评估,且各子集分布一致、独立无泄露。实际操作中,需根据数据量、类型(普通 / 时序 / 小样本)选择划分方式,并借助sklearn等工具实现高效划分。
机器学习的流程顺序-----不要数据泄露
机器学习的核心目标是训练出能在未知数据上稳定工作的模型,而数据泄露(训练过程中引入测试集 / 未知数据的信息)是破坏这一目标的关键风险。以下是严格避免数据泄露的机器学习标准流程,每个步骤都明确数据使用边界:
流程总览(核心原则:训练集 “独立闭环”,测试集 “全程隔离”)
数据收集 → 问题定义 → 数据集划分(先于任何预处理) → 训练集 EDA 与预处理 → 特征工程(仅用训练集) → 模型训练与验证集调优 → 测试集最终评估 → 模型部署
详细步骤与防泄露要点
1. 问题定义与数据收集
- 目标:明确任务类型(分类 / 回归 / 聚类等)、评估指标(准确率 / MAE 等),收集与任务相关的原始数据(避免无关特征引入噪声)。
- 防泄露:此时无需区分数据集,但需确保数据来源真实(如避免混入 “未来数据”,尤其时序任务)。
2. 数据集划分(最关键的防泄露步骤)
-
操作:在任何预处理、特征工程前,将原始数据划分为 训练集(Train)、验证集(Validation)、测试集(Test),且测试集必须全程隔离(直到最终评估才使用)。
- 划分逻辑:
- 训练集(60%~80%):用于模型学习(拟合参数、计算预处理统计量)。
- 验证集(10%~20%):用于超参数调优、模型选择(不参与参数拟合)。
- 测试集(10%~20%):模拟 “未知数据”,仅用于最终评估模型泛化能力(绝对不参与训练 / 调优)。
- 工具:用
sklearn.train_test_split,分类任务加stratify保持类别比例,时序任务按时间顺序划分(禁止随机打乱)。
- 划分逻辑:
-
防泄露核心:
- 划分必须在所有预处理(如标准化、缺失值填充)之前!若先预处理再划分,测试集的统计量(如均值、方差)会 “污染” 训练集的预处理参数。
- 测试集一旦划分,立即 “封存”,代码中单独存放,避免误操作引入训练流程。
3. 训练集 EDA 与预处理(仅用训练集!)
-
EDA(探索性数据分析):
- 仅对训练集进行分布分析(直方图、箱线图)、特征相关性计算、异常值识别等。
- 原因:若用全量数据 EDA,测试集的分布特征会提前被 “看见”,导致后续特征工程针对性设计,引入泄露(如为测试集的异常值专门设计规则)。
-
预处理(数据清洗):
- 操作:处理缺失值、异常值、数据标准化 / 归一化等。
- 防泄露要点:
- 缺失值填充:用训练集的均值 / 中位数 / 众数(而非全量数据),或用训练集训练的填充模型(如 KNN 填充)。
- 异常值处理:基于训练集的分布(如箱线图边界、Z-score 阈值),不能用测试集的异常值规则。
- 标准化 / 归一化:用训练集的均值和标准差(如
StandardScaler拟合训练集,再 transform 验证集和测试集),禁止用全量数据的统计量。
4. 特征工程(仅依赖训练集信息)
- 操作:特征选择(如过滤法、嵌入法)、特征转换(如多项式特征、对数变换)、特征编码(如 One-Hot、LabelEncoder)等。
- 防泄露要点:
- 特征选择:用训练集的特征重要性(如树模型的 feature_importance)或相关性,禁止用验证集 / 测试集的特征与标签的相关性。
- 编码规则:如 One-Hot 的类别取值,必须基于训练集的唯一值(测试集若出现新类别,需按 “未知类别” 处理,而非提前用全量数据的类别)。
- 特征衍生:如基于时间的特征(“周末 / 工作日”),规则需仅从训练集总结(不能用测试集的日期规律)。
5. 模型训练与验证集调优(不碰测试集)
- 模型训练:用训练集拟合模型参数(如线性回归的系数、神经网络的权重),训练过程中仅输入训练集特征和标签。
- 超参数调优:
- 用验证集评估不同超参数组合的性能(如学习率、树深度),选择验证集表现最优的超参数。
- 防泄露:调优过程中,验证集的信息仅用于 “选择”,不用于 “训练参数”(如不基于验证集调整模型权重);禁止多次用测试集调优(否则模型会 “记住” 测试集规律)。
6. 测试集最终评估(仅一次,且不反馈调整)
- 操作:用训练好的模型(固定参数和超参数)在测试集上计算评估指标(如准确率、MSE),该结果即为模型的 “泛化能力”。
- 防泄露核心:
- 测试集评估必须是 “一次性” 的,绝对不能用测试集的结果反推调整模型(如重新训练、修改特征)。
- 若测试集表现差,需回到训练集 / 验证集找原因(如过拟合、特征不足),而非用测试集信息 “修正”。
7. 模型部署与监控
- 部署:将最终确定的模型(通过测试集评估的版本)部署到生产环境。
- 监控:持续跟踪模型在新数据上的表现,若性能下降(如分布偏移),需用新的 “训练集”(注意:新数据需重新划分训练 / 测试集)重新训练,避免直接用生产数据(相当于测试集)更新模型。
数据泄露的典型 “雷区” 与避坑指南
| 泄露场景 | 错误操作 | 正确做法 |
|---|---|---|
| 预处理顺序错误 | 先标准化全量数据,再划分训练 / 测试集 | 先划分数据集,用训练集拟合标准化参数,再应用到测试集 |
| 测试集参与调优 | 用测试集准确率调整超参数(如 “测试集准确率低,调大树深度”) | 仅用验证集调优,测试集只在最后评估一次 |
| 特征工程引入测试集信息 | 用全量数据的特征相关性选择特征 | 仅用训练集的特征相关性 |
| 时序数据随机划分 | 股票预测中随机打乱时间顺序划分数据集 | 按时间先后划分(用过去数据训练,未来数据测试) |
总结
避免数据泄露的核心逻辑是:严格区分 “已知数据”(训练集)和 “未知数据”(测试集)。训练集负责 “学习规律”(包括预处理参数、模型参数),验证集负责 “优化选择”,测试集仅负责 “最终打分”。整个流程中,测试集的信息必须 “不可见” 于训练和调优阶段,才能保证模型评估的真实性。
机器学习模型建模的三行代码
机器学习建模的核心流程可以高度精简为 “导入模型→训练模型→预测” 三行核心代码,以下以线性回归(适用于回归任务)为例,基于scikit-learn库实现,同时附带数据准备的前置步骤(确保可运行):
三行核心建模代码(含数据准备)
# 前置:准备数据(以sklearn内置数据集为例,划分训练/测试集)
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
data = fetch_california_housing()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2, random_state=42)

# 三行建模核心代码
from sklearn.linear_model import LinearRegression  # 1. 导入模型
model = LinearRegression().fit(X_train, y_train)   # 2. 初始化并训练模型
y_pred = model.predict(X_test)                     # 3. 用训练好的模型预测
代码说明
导入模型:from sklearn.linear_model import LinearRegression从scikit-learn库中导入指定模型(此处为线性回归,替换为LogisticRegression、RandomForestClassifier等可实现分类任务)。
训练模型:model = LinearRegression().fit(X_train, y_train)
- 初始化模型(
LinearRegression())并通过fit方法用训练集(X_train特征,y_train标签)训练,模型会自动学习特征与标签的映射关系。
预测:y_pred = model.predict(X_test)用训练好的模型对测试集特征(X_test)进行预测,输出预测结果(y_pred),可与真实标签(y_test)对比评估模型性能(如计算 MSE、R² 等)。
扩展:分类任务的三行代码(以随机森林为例)
# 前置:准备分类数据(鸢尾花数据集)
from sklearn.datasets import load_iris
X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 三行分类建模代码
from sklearn.ensemble import RandomForestClassifier  # 1. 导入分类模型
model = RandomForestClassifier().fit(X_train, y_train)  # 2. 训练
y_pred = model.predict(X_test)  # 3. 预测
这三行代码浓缩了机器学习 “数据→模型→预测” 的核心逻辑,实际应用中需在预测后添加评估步骤(如sklearn.metrics计算指标),但建模的核心流程可简化为这三步。
详细解释一下这三行代码的具体含义
以回归任务(线性回归) 的三行核心代码为例,我们逐一拆解每一行的具体含义、背后的逻辑以及在机器学习流程中的作用:
背景说明
假设我们已经完成了数据准备(加载数据集、划分训练集X_train/y_train和测试集X_test/y_test),其中:
X_train:训练集特征(如房屋面积、房间数等输入变量),形状为(样本数, 特征数);y_train:训练集标签(如房屋价格等输出变量),形状为(样本数,);X_test:测试集特征(未参与训练的新数据特征),用于评估模型泛化能力。
第一行:导入模型
from sklearn.linear_model import LinearRegression # 1. 导入模型具体含义:
从scikit-learn(Python 最常用的机器学习库)的linear_model(线性模型模块)中,导入LinearRegression(线性回归模型)类。
背后逻辑:
scikit-learn将各类机器学习模型封装成 “类”(Class),每个类包含模型的 “参数”(如线性回归的系数)和 “方法”(如训练、预测的函数)。- 这一步的目的是 “引入工具”:就像做菜前先拿出锅铲,我们需要先加载要使用的模型,才能后续用它处理数据。
- 替换性:若要换模型(如用决策树做回归),只需改为
from sklearn.tree import DecisionTreeRegressor,核心流程不变。
第二行:初始化并训练模型
model = LinearRegression().fit(X_train, y_train) # 2. 初始化并训练模型具体含义:
这一行包含两个动作:
LinearRegression():创建一个线性回归模型的 “实例”(即初始化模型,设置默认参数,如是否计算截距等);.fit(X_train, y_train):调用模型的fit方法,用训练集数据(X_train和y_train)“训练” 模型,让模型从数据中学习特征与标签的映射规律。
背后逻辑(核心!):
模型初始化:LinearRegression()就像 “买了一个空白的公式模板”,此时模型还没有任何 “知识”(参数为空)。例如,线性回归的公式是y = w1*x1 + w2*x2 + ... + b(w是系数,b是截距),初始化时w和b都是未确定的 “未知数”。
训练(拟合)过程:fit方法的作用是 “求解未知数”—— 通过训练集数据,找到最优的w和b,使得模型对训练集的预测值(y_pred_train = w1*x1 + ... + b)与真实标签y_train的误差最小(通常用 “均方误差” 衡量)。
- 这个过程本质是 “从数据中学习规律”:比如通过大量房屋数据,模型学会 “房屋面积每增加 10 平米,价格平均上涨 5 万元”(即系数
w的含义)。
输入要求:X_train和y_train必须是 “对齐的”—— 每一行特征对应一行标签(即同一房屋的特征和价格)。
第三行:用训练好的模型预测
y_pred = model.predict(X_test) # 3. 用训练好的模型预测具体含义:
调用训练好的模型(model)的predict方法,输入测试集特征X_test,输出模型对测试集的预测结果y_pred(如预测的房屋价格)。
背后逻辑:
- 此时的
model已经通过第二行的训练 “学会了规律”(即确定了w和b),predict方法的作用是 “应用规律”:将测试集的特征X_test代入训练好的公式(y_pred = w1*x1 + ... + b),计算出预测值。 - 为什么用
X_test?因为X_test是模型 “没见过” 的新数据,其预测结果y_pred可以与真实标签y_test对比(如计算误差),评估模型是否真的学会了通用规律(而非死记硬背训练集)。 - 输出:
y_pred的形状与y_test一致((测试样本数,)),每个值对应X_test中一行特征的预测结果。
总结:三行代码的逻辑闭环
- 导入模型:准备工具(选好要用的模型);
- 训练模型:用已知数据(训练集)让模型学习规律(求解参数);
- 预测:用学到的规律对未知数据(测试集)做判断,验证模型效果。
这三行代码浓缩了机器学习 “从数据到规律,再到预测” 的核心流程,也是所有监督学习模型(分类、回归)的通用框架 —— 无论换用决策树、随机森林还是神经网络,核心步骤都是 “导入→训练→预测”。
机器学习模型分类问题的评估
在分类问题中,模型评估的核心是衡量模型对 “类别标签” 的预测能力,但其复杂度高于回归问题(因分类涉及 “是否预测对类别”“错分的类型” 等)。评估需结合业务目标(如 “宁可错杀不可漏诊” 还是 “减少误判”)和数据特性(如类别是否平衡)选择指标,以下是系统的评估方法与指标解析:
一、评估的核心前提:明确 “正确” 与 “错误” 的定义(混淆矩阵)
所有分类评估指标的基础是混淆矩阵(Confusion Matrix),它清晰展示模型对不同类别的预测结果(以二分类为例):
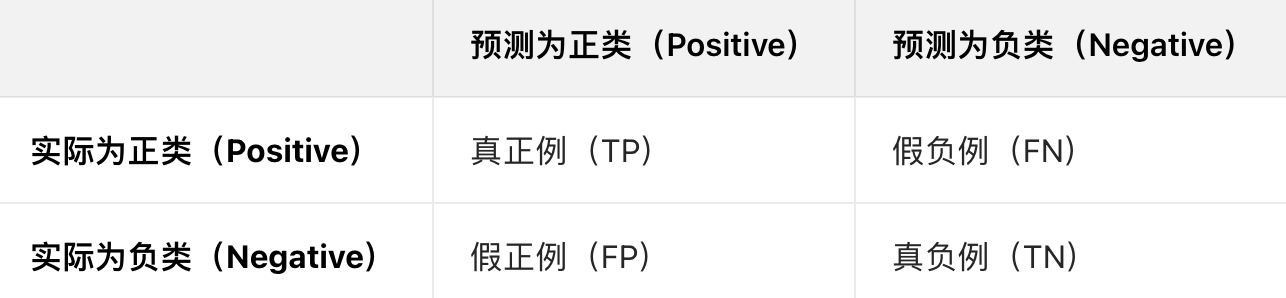
- TP:实际是正类,模型预测为正类(正确);
- FN:实际是正类,模型预测为负类(漏判,“假阴性”);
- FP:实际是负类,模型预测为正类(误判,“假阳性”);
- TN:实际是负类,模型预测为负类(正确)。
二、单指标评估(基于混淆矩阵的衍生指标)
1. 准确率(Accuracy)
- 公式:
Accuracy = (TP + TN) / (TP + TN + FP + FN) - 含义:所有样本中预测正确的比例(“整体正确率”)。
- 适用场景:类别平衡的场景(如正负样本比例接近 1:1),且错分成本相近(如垃圾邮件分类,误判正常邮件和漏判垃圾邮件的代价差不多)。
- 局限性:在类别不平衡时失效(如 99% 样本是负类,模型全预测负类也能得 99% 准确率,但毫无意义)。
2. 精确率(Precision,查准率)
- 公式:
Precision = TP / (TP + FP) - 含义:模型预测为正类的样本中,实际确实是正类的比例(“预测对的正例占预测正例的比例”)。
- 核心目标:减少 “误判为正类”(FP),即 “预测为正的,尽量都是真的”。
- 适用场景:重视 “预测正例的可靠性”,如推荐系统(避免给用户推荐无关内容,FP 是 “推荐了用户不喜欢的”)、垃圾邮件过滤(避免把正常邮件归为垃圾邮件,FP 代价高)。
3. 召回率(Recall,查全率)
- 公式:
Recall = TP / (TP + FN) - 含义:实际为正类的样本中,被模型成功预测为正类的比例(“真正例占所有真正例的比例”)。
- 核心目标:减少 “漏判正类”(FN),即 “真正的正例,尽量都被预测出来”。
- 适用场景:重视 “不遗漏正例”,如疾病检测(FN 是 “漏诊患者”,代价极高)、欺诈检测(漏判欺诈交易损失大)。
4. F1 分数(F1-Score)
- 公式:
F1 = 2 * (Precision * Recall) / (Precision + Recall)(精确率和召回率的调和平均) - 含义:平衡精确率和召回率,当两者冲突时(提高精确率往往降低召回率,反之亦然),用 F1 衡量整体性能。
- 适用场景:需要兼顾 “少误判” 和 “少漏判” 的场景,如客户流失预测(既不想把不流失客户误判为流失,也不想漏判真正会流失的客户)。
5. 特异度(Specificity,真负率)
- 公式:
Specificity = TN / (TN + FP) - 含义:实际为负类的样本中,被模型正确预测为负类的比例(“真负例占所有真负例的比例”)。
- 适用场景:重视 “负类的判断准确性”,如疫情筛查(健康人被误诊为患者的代价高,需高特异度)。
三、阈值相关评估(ROC 曲线与 AUC)
分类模型(如逻辑回归、SVM)的输出通常是 “样本属于正类的概率”(而非直接的类别),需通过阈值(Threshold) 转换为类别(如概率 > 0.5 为正类)。阈值变化会影响 TP、FP、FN、TN,进而改变精确率、召回率等指标。
1. ROC 曲线(Receiver Operating Characteristic Curve)
- 横轴:假正率(FPR = FP / (FP + TN))—— 实际负类被误判为正类的比例(“误诊率”);
- 纵轴:真正率(TPR = Recall = TP / (TP + FN))—— 实际正类被正确预测的比例(“召回率”);
- 含义:展示不同阈值下,模型 “区分正负类” 的能力(FPR 越小、TPR 越大,模型越好)。
- 理想情况:曲线尽量靠近左上角(TPR 接近 1,FPR 接近 0);随机猜测的 ROC 曲线是一条对角线(TPR=FPR)。
2. AUC(Area Under ROC Curve)
- 含义:ROC 曲线下的面积(取值 0~1),反映模型对正负类的整体区分能力。
- AUC=1:完美模型(所有正类预测概率 > 负类);
- AUC=0.5:随机猜测(无区分能力);
- AUC<0.5:比随机猜测还差(可反向预测改善)。
- 优势:
- 对阈值不敏感(综合所有阈值的表现);
- 对类别不平衡数据相对稳健(不受正负样本比例影响)。
- 适用场景:二分类问题的通用评估(尤其是不平衡数据),如信用卡欺诈检测(正类占比极低)。
四、多分类问题的评估(类别数≥3)
多分类场景需将二分类指标扩展,核心思路是 “拆解为多个二分类问题”,常用方法:
1. 宏平均(Macro-averaging)
- 对每个类别单独计算指标(如精确率),再取算术平均(不考虑类别样本量)。
- 适用场景:各类别重要性相同,尤其是小样本类别需要被重视时(如罕见疾病的多分类诊断)。
2. 微平均(Micro-averaging)
- 先计算所有类别的总 TP、FP、FN,再用总数据计算指标(等价于 “将多分类视为所有样本的二分类”)。
- 适用场景:类别不平衡,且更关注整体正确率(如文本分类,高频类别更重要)。
3. 加权平均(Weighted-averaging)
- 对每个类别计算指标后,按类别样本量加权平均(样本多的类别权重更高)。
- 适用场景:需要平衡类别样本量差异,是 sklearn 默认的多分类评估方式。
五、评估工具与代码示例(sklearn)
from sklearn.metrics import (
    confusion_matrix, classification_report,
    roc_auc_score, roc_curve
)
import matplotlib.pyplot as plt

# 假设模型输出:y_true(真实标签)、y_pred(预测类别)、y_proba(预测正类的概率,二分类)
y_true = [0, 1, 1, 0, 1, 0, 0, 1]
y_pred = [0, 1, 0, 0, 1, 1, 0, 1]
y_proba = [0.3, 0.8, 0.4, 0.2, 0.9, 0.6, 0.1, 0.7]  # 仅二分类需要

# 1. 混淆矩阵
print("混淆矩阵:")
print(confusion_matrix(y_true, y_pred))
# 输出:
# [[3 1]  # 实际负类(0):3个TN,1个FP
#  [1 3]]  # 实际正类(1):3个TP,1个FN

# 2. 综合指标报告(精确率、召回率、F1、支持度)
print("\n分类报告:")
print(classification_report(y_true, y_pred))
# 输出包含每个类别的precision、recall、f1-score,以及宏平均、加权平均

# 3. ROC曲线与AUC(二分类)
fpr, tpr, thresholds = roc_curve(y_true, y_proba)
auc = roc_auc_score(y_true, y_proba)

plt.plot(fpr, tpr, label=f"AUC = {auc:.2f}")
plt.plot([0, 1], [0, 1], "r--")  # 随机猜测的基准线
plt.xlabel("假正率(FPR)")
plt.ylabel("真正率(TPR)")
plt.title("ROC曲线")
plt.legend()
plt.show()
六、评估指标的选择原则
- 业务优先:根据错分代价选择指标(如疾病检测→高召回率,推荐系统→高精确率);
- 数据特性:类别不平衡时,避免用准确率,优先用 F1、AUC 或针对少数类的召回率;
- 多指标结合:单一指标有局限性(如高 AUC 可能伴随低精确率),需结合混淆矩阵、ROC 曲线综合判断。
总结:分类模型评估的核心是 “明确什么是‘好的预测’”—— 从混淆矩阵出发,根据业务目标选择精确率、召回率等指标,结合 ROC/AUC 分析阈值影响,最终实现 “模型性能与业务需求匹配”。
如何处理数据不平衡问题对分类模型评估的影响?
数据不平衡(即数据集中不同类别的样本数量差异显著,如少数类占比 <10%)会严重扭曲分类模型的评估结果 —— 传统指标(如准确率)会因 “偏向多数类” 而虚高,无法反映模型对少数类(往往是业务关注的核心,如欺诈交易、疾病样本)的真实识别能力。处理的核心是选择对不平衡数据稳健的评估指标,并通过评估策略调整,聚焦少数类的预测性能。
一、数据不平衡对评估的具体影响
以 “欺诈检测” 为例(99% 为正常交易,1% 为欺诈交易):
- 若模型简单地 “全部预测为正常交易”,准确率仍能达到 99%,但对欺诈交易(少数类)的识别率为 0,完全失去业务价值。
- 传统指标(准确率)的问题在于:对多数类的 “正确预测” 会掩盖少数类的 “错误预测”,导致评估结果与业务目标脱节。
二、核心解决思路:调整评估指标与策略
1. 放弃 “准确率”,选择对不平衡数据稳健的指标
优先关注少数类的预测性能,核心指标如下:
| 指标 | 计算公式 / 含义 | 优势(针对不平衡数据) | 适用场景 |
|---|---|---|---|
| 少数类的召回率 | 少数类 TP /(少数类 TP + 少数类 FN) | 直接衡量 “少数类被正确识别的比例”,避免漏判(如疾病检测中 “不漏诊患者”) | 少数类漏判代价高(如欺诈检测、故障诊断) |
| 少数类的精确率 | 少数类 TP /(少数类 TP + 少数类 FP) | 衡量 “预测为少数类的样本中真实少数类的比例”,避免误判(如推荐系统中 “少推无关内容”) | 少数类误判代价高(如垃圾邮件过滤中 “正常邮件被误判为垃圾”) |
| F1 分数(针对少数类) | 2×(少数类精确率 × 少数类召回率)/(少数类精确率 + 少数类召回率) | 平衡少数类的精确率和召回率,避免单一指标的片面性 | 需兼顾 “少漏判” 和 “少误判”(如客户流失预测) |
| AUC-PR(精确率 - 召回率曲线下面积) | 以召回率为横轴、精确率为纵轴的曲线下面积(取值 0~1) | 比 ROC-AUC 更聚焦少数类性能(ROC 对多数类的 TPR/FPR 敏感,而 PR 曲线直接反映少数类的预测质量) | 高度不平衡数据(少数类占比 < 5%),如罕见疾病诊断、异常行为检测 |
| 宏平均 F1(Macro-F1) | 所有类别的 F1 分数取算术平均(不考虑类别样本量) | 强制关注少数类(避免多数类样本量大导致的指标倾斜) | 少数类与多数类重要性相同(如多分类中各子类均需准确识别) |
2. 评估策略调整:聚焦少数类,避免多数类干扰
分层抽样划分数据集:划分训练集、验证集、测试集时,采用分层抽样(如sklearn的stratify=y参数),确保各子集中的类别比例与原始数据一致。例:原始数据少数类占 10%,则训练 / 验证 / 测试集中少数类也应占 10%,避免因随机划分导致测试集中少数类样本过少,评估结果波动大。
按类别单独评估,再综合判断:不依赖 “全局指标”,而是分别计算每个类别的精确率、召回率,重点分析少数类的指标。例:在二分类中,单独报告 “正类(少数类)的召回率” 和 “负类(多数类)的召回率”,明确模型对核心类别的表现。
使用混淆矩阵可视化:直接展示少数类的 TP(正确识别)、FN(漏判)、FP(误判)数量,比单一指标更直观。例:欺诈检测中,若混淆矩阵显示 “100 个欺诈样本中 80 个被漏判(FN=80)”,即使准确率 99%,模型也不可用。
3. 结合数据 / 算法层面的处理,辅助评估
数据不平衡的根本解决需结合数据层面(如过采样少数类、欠采样多数类)或算法层面(如调整类别权重)的优化,但这些操作的目标是 “让模型更好地学习少数类规律”,最终仍需通过上述评估指标验证效果。
- 例:使用 SMOTE 过采样少数类后,模型对少数类的召回率从 30% 提升至 70%,通过 “少数类召回率” 和 “AUC-PR” 可清晰验证优化效果,而准确率可能仅从 98% 升至 98.5%(变化不明显)。
三、代码示例:不平衡数据的评估实践
以 “9:1” 的不平衡二分类数据为例,展示如何用合适的指标评估:
import numpy as np
from sklearn.metrics import (
    confusion_matrix, classification_report,
    precision_recall_curve, average_precision_score,
    roc_auc_score
)
import matplotlib.pyplot as plt

# 生成不平衡数据(900个负类,100个正类;正类为少数类)
np.random.seed(42)
y_true = np.array([0]*900 + [1]*100)  # 真实标签:0是多数类,1是少数类
y_pred = np.array([0]*850 + [1]*50 + [0]*30 + [1]*70)  # 预测标签
y_proba = np.concatenate([np.random.uniform(0, 0.6, 900), np.random.uniform(0.4, 1, 100)])  # 预测概率

# 1. 查看准确率(传统指标,误导性)
accuracy = (y_true == y_pred).mean()
print(f"准确率:{accuracy:.2f}(看似很高,但掩盖少数类表现)")  # 输出~0.92

# 2. 混淆矩阵(直观展示少数类表现)
print("\n混淆矩阵(行=实际,列=预测):")
print(confusion_matrix(y_true, y_pred))
# 输出:
# [[850  50]  # 多数类(0):850个TN,50个FP
#  [ 30  70]]  # 少数类(1):70个TP,30个FN → 少数类漏判30个

# 3. 分类报告(聚焦少数类指标)
print("\n分类报告(重点看少数类1的指标):")
print(classification_report(y_true, y_pred))
# 输出中,少数类1的recall=70/(70+30)=0.7,precision=70/(70+50)=0.58,F1=0.63 → 真实反映少数类表现

# 4. 绘制PR曲线并计算AUC-PR(适合不平衡数据)
precision, recall, _ = precision_recall_curve(y_true, y_proba)
auc_pr = average_precision_score(y_true, y_proba)  # AUC-PR值

plt.plot(recall, precision, label=f"AUC-PR = {auc_pr:.2f}")
plt.xlabel("召回率(Recall)")
plt.ylabel("精确率(Precision)")
plt.title("精确率-召回率曲线(不平衡数据评估核心)")
plt.legend()
plt.show()

# 5. 对比ROC-AUC(对不平衡数据敏感度低)
roc_auc = roc_auc_score(y_true, y_proba)
print(f"\nROC-AUC:{roc_auc:.2f}(值较高,但不如AUC-PR能反映少数类问题)")
四、总结
处理数据不平衡对评估的影响,核心是 **“跳出准确率陷阱,聚焦少数类的预测质量”**:
- 优先选择少数类的召回率、F1 分数、AUC-PR等指标,替代准确率;
- 通过分层抽样、类别单独评估、混淆矩阵可视化,确保评估结果反映业务核心需求;
- 结合数据 / 算法层面的不平衡处理(如过采样、类别权重),但最终需用上述指标验证效果。
本质上,评估的目标是 “判断模型是否能解决业务问题”,而非追求 “高数值指标”—— 对不平衡数据,“少数类的识别能力” 才是业务价值的关键。
如何理解分类报告
分类报告(classification report)是机器学习中评估分类模型性能的核心工具之一(由scikit-learn的classification_report函数生成),它整合了每个类别的核心评估指标(精确率、召回率、F1 分数)和全局汇总指标,能全面反映模型对不同类别的预测能力。理解分类报告的关键是拆解每个指标的含义,并结合业务目标判断模型是否 “合格”。
一、分类报告的结构(以二分类为例)
先看一个具体示例(假设任务是 “判断邮件是否为垃圾邮件”,0 = 正常邮件,1 = 垃圾邮件):
              precision    recall  f1-score   support

           0       0.95      0.98      0.96       800
           1       0.93      0.85      0.89       200

    accuracy                           0.95      1000
   macro avg       0.94      0.91      0.92      1000
weighted avg       0.94      0.95      0.94      1000
报告分为两部分:
- 按类别单独评估:每一行对应一个类别(如 0 和 1),包含 4 个指标;
- 全局汇总评估:最后三行是所有类别的综合指标(准确率、宏平均、加权平均)。
二、逐指标解读(核心!)
1. 按类别评估的 4 个指标
以 “类别 1(垃圾邮件,少数类)” 为例:
support(支持度):该类别的真实样本数量(如示例中类别 1 的support=200,表示数据中共有 200 封垃圾邮件)。→ 作用:反映类别不平衡情况(如示例中 0 类 800 个、1 类 200 个,存在轻微不平衡)。
precision(精确率):公式:precision = 模型预测为该类的样本中,实际确实是该类的比例(即TP/(TP+FP))。示例中类别 1 的precision=0.93:模型预测为 “垃圾邮件” 的样本中,93% 确实是垃圾邮件(剩下 7% 是正常邮件被误判,即 FP)。→ 核心意义:“预测为该类的可靠性”(值越高,误判越少)。
recall(召回率):公式:recall = 实际为该类的样本中,被模型成功预测为该类的比例(即TP/(TP+FN))。示例中类别 1 的recall=0.85:所有真实垃圾邮件中,85% 被模型正确识别(剩下 15% 漏判为正常邮件,即 FN)。→ 核心意义:“该类被完全识别的能力”(值越高,漏判越少)。
f1-score(F1 分数):公式:f1-score =2×(precision×recall)/(precision+recall)(精确率和召回率的调和平均)。示例中类别 1 的f1=0.89:平衡了该类的精确率和召回率,避免单一指标的片面性(如高精确率但低召回率的模型可能 “保守预测”,实际价值有限)。
2. 全局汇总指标(最后三行)
accuracy(准确率):公式:accuracy = 所有样本中预测正确的比例(即(TP+TN)/(总样本数))。示例中accuracy=0.95:1000 封邮件中,950 封预测正确。→ 注意:类别不平衡时参考价值低(如 99% 样本是 0 类,模型全预测 0 类也能得 99% 准确率,但对 1 类毫无识别能力)。
macro avg(宏平均):计算方式:对所有类别的precision、recall、f1-score分别取算术平均(不考虑类别样本量)。示例中macro avg的 precision=(0.95+0.93)/2=0.94,recall=(0.98+0.85)/2=0.91。→ 作用:强制平等对待所有类别,尤其关注小样本类别(避免大样本类别 “掩盖” 小样本类别的差表现)。适合场景:各类别重要性相同(如多分类的疾病诊断,每种疾病都需重视)。
weighted avg(加权平均):计算方式:对所有类别的precision、recall、f1-score按 “类别样本量(support)” 加权平均(样本多的类别权重更高)。示例中weighted avg的 precision=(0.95×800 + 0.93×200)/1000≈0.94。→ 作用:兼顾类别样本量差异,适合类别不平衡且 “大样本类别更重要” 的场景(如文本分类,高频类别对整体效果影响更大)。是scikit-learn的默认汇总方式。
三、多分类场景的分类报告(以 3 分类为例)
若任务是 “鸢尾花品种分类”(3 个类别),报告结构类似,但会多一行类别 2 的指标:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        50
           1       0.96      0.94      0.95        50
           2       0.94      0.96      0.95        50

    accuracy                           0.97       150
   macro avg       0.97      0.97      0.97       150
weighted avg 0.97 0.97 0.97 150- 解读重点:每个类别(0、1、2)的精确率 / 召回率是否均衡(避免某一类表现极差)。例如,若类别 1 的 recall=0.5,说明该类品种经常被错分,需针对性优化(如增加该类样本、调整特征)。
四、解读分类报告的核心步骤(结合业务)
看 support 判断数据分布:是否存在类别不平衡(如某类 support 远小于其他类)。
逐类别分析指标:
- 业务关注的核心类别(如 “欺诈交易”“癌症患者”)的 recall 是否足够高(避免漏判);
- 误判代价高的类别(如 “正常邮件被误判为垃圾邮件”)的 precision 是否足够高(避免误判);
- 若核心类别的 F1 分数低,说明模型对该类的识别能力弱,需优化。
结合汇总指标验证整体效果:
- 类别平衡时,可参考 accuracy 和加权平均;
- 类别不平衡时,重点看宏平均(反映小类别表现)和核心类别的 F1。
五、常见误区与注意事项
- 只看 accuracy 忽略单个类别:例如,99% 样本是 0 类的不平衡数据中,模型 accuracy=99% 但 1 类 recall=0,实际毫无价值。
- 混淆宏平均与加权平均:宏平均低说明小类别表现差;加权平均低说明整体(尤其是大类别)表现差。
- 脱离业务谈指标:例如,疾病检测中 “漏诊(低 recall)” 的代价远高于 “误诊(低 precision)”,此时应优先关注核心类别的 recall,而非 F1 或 accuracy。
总结
分类报告的价值在于 “全面暴露模型对每个类别的预测细节”:它不仅告诉你模型的 “整体表现”,更能揭示 “哪些类别预测得好,哪些类别预测得差”。解读时需结合业务目标(关注漏判还是误判)、数据分布(是否平衡),聚焦核心类别的指标,才能判断模型是否真正解决问题。
作业:尝试对心脏病数据集采用机器学习模型建模和评估
# 1. 导入需要的库(相当于装工具,第一次运行会自动下载缺失的工具)
try:
    import pandas as pd  # 处理表格数据(比如Excel一样的表)
    import numpy as np   # 处理数字计算
    import matplotlib.pyplot as plt  # 画图
    from sklearn.model_selection import train_test_split  # 划分训练/测试集
    from sklearn.preprocessing import StandardScaler  # 特征标准化(让模型学得更好)
    from sklearn.ensemble import RandomForestClassifier  # 随机森林模型(用来判断心脏病)
    from sklearn.metrics import classification_report, confusion_matrix  # 评估模型
    import joblib  # 保存模型(下次不用重新训练)
    print("✅ 所有工具都装好了!")
except ImportError:
    # 自动下载缺失的工具
    import subprocess
    import sys
    subprocess.check_call([sys.executable, "-m", "pip", "install",
                          "pandas", "numpy", "matplotlib", "scikit-learn", "joblib"])
    print("✅ 工具自动装完了,再点一次运行按钮继续!")


# 2. 读取数据+理解数据
# 读取csv文件(相当于打开Excel表)
data = pd.read_csv("heart.csv")  # 这里的"heart.csv"是你的数据文件名,必须和代码在一个文件夹!

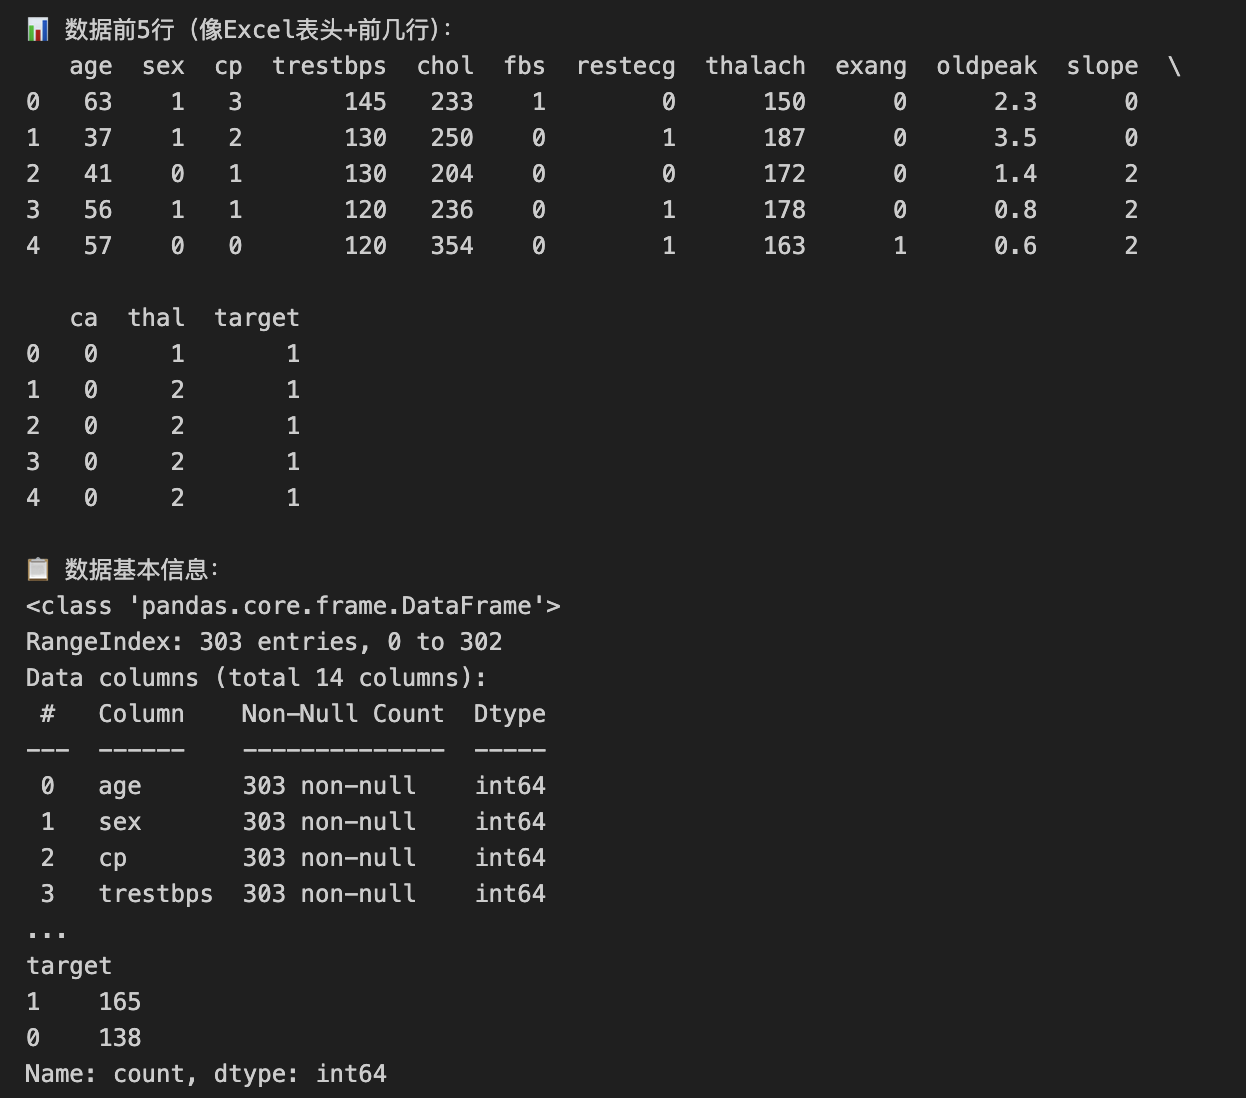
# 2.1 看数据前5行(知道有哪些列,比如年龄、血压这些指标)
print("📊 数据前5行(像Excel表头+前几行):")
print(data.head())  # head()就是看前5行

# 2.2 看数据基本信息(有没有缺失值、数据类型)
print("\n📋 数据基本信息:")
print(data.info())  # 重点看"Non-Null Count"——如果所有列的数字一样,说明没有缺失值

# 2.3 看目标变量(是否有心脏病)的分布(1=有心脏病,0=没有)
print("\n❤️ 心脏病分布(多少人有/没有):")
print(data["target"].value_counts())  # "target"是判断心脏病的列,固定这么写


# 3. 缺失值处理(补全空数据)
# 先检查有没有缺失值(每列空值数量)
missing_values = data.isnull().sum()  # isnull()查空值,sum()算总数
print("\n❌ 各列缺失值数量:")
print(missing_values)

# 如果有缺失值,用中位数补全(没有缺失值也会运行,不影响)
if missing_values.any() > 0:  # any()判断有没有空值
    # 数值型列用中位数补(比如年龄、血压这些数字列)
    numeric_cols = data.select_dtypes(include=[np.number]).columns  # 选所有数字列
    data[numeric_cols] = data[numeric_cols].fillna(data[numeric_cols].median())  # 中位数填充
    print("\n✅ 缺失值已经用中位数补全!")
else:
    print("\n✅ 没有缺失值,不用补!")


# 4. 异常值处理(去掉明显错的数据,比如年龄200岁)
# 只处理数值型列(年龄、血压这些,不处理文字列)
numeric_cols = data.select_dtypes(include=[np.number]).columns
data_clean = data.copy()  # 复制一份数据,避免改原始数据

# 用箱线图逻辑去掉异常值(迭代1次,简单有效)
for col in numeric_cols:
    if col != "target":  # 不处理目标变量(只处理特征列)
        q1 = data_clean[col].quantile(0.25)  # 下四分位数
        q3 = data_clean[col].quantile(0.75)  # 上四分位数
        iqr = q3 - q1  # 四分位距
        lower_bound = q1 - 1.5 * iqr  # 下边界
        upper_bound = q3 + 1.5 * iqr  # 上边界
        # 保留在边界内的数据(去掉异常值)
        data_clean = data_clean[(data_clean[col] >= lower_bound) & (data_clean[col] <= upper_bound)]

# 看去掉多少异常值
print(f"\n🗑️ 异常值处理完成:原始数据{data.shape[0]}条 → 清理后{data_clean.shape[0]}条")

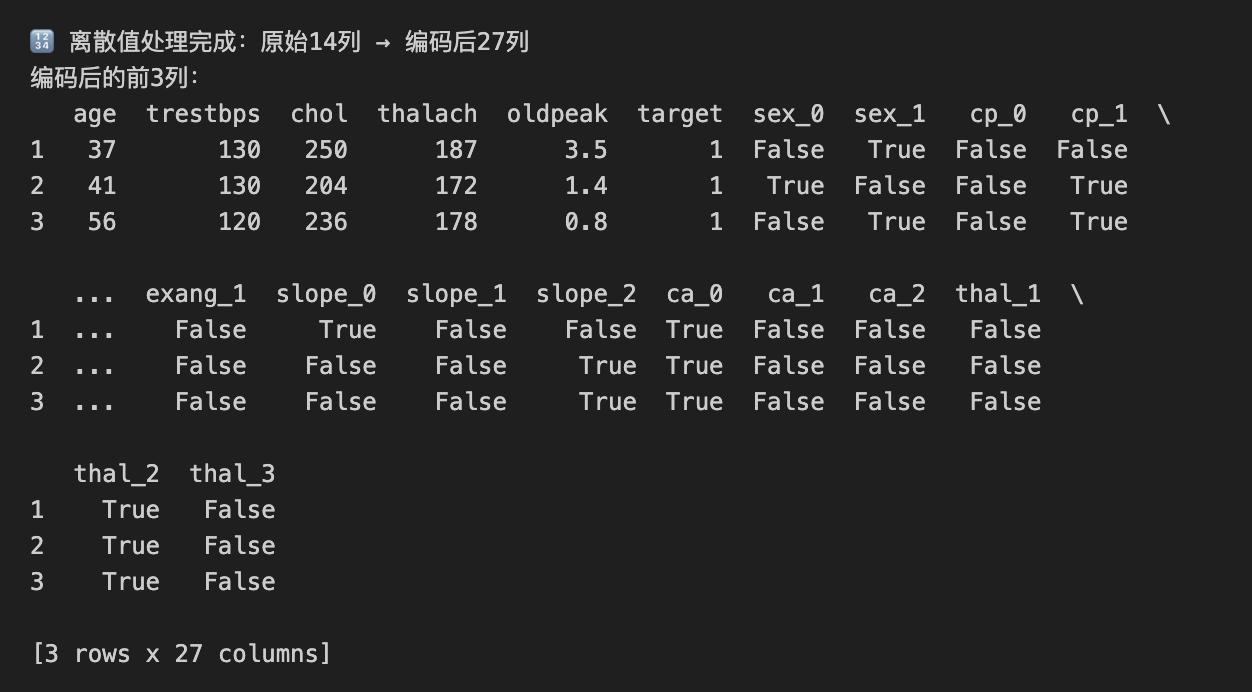
# 5. 离散值处理(把分类数据转成数字,模型只认数字)
# 先找出离散列(分类数据,比如性别、胸痛类型,不是连续的数字)
# 这里根据heart.csv的常见列设置,不用改
discrete_cols = ["sex", "cp", "fbs", "restecg", "exang", "slope", "ca", "thal"]

# 用One-Hot编码转成数字(比如"性别男"转成1,0,"性别女"转成0,1)
data_encoded = pd.get_dummies(data_clean, columns=discrete_cols, drop_first=False)  # drop_first=False避免丢数据

print(f"\n🔢 离散值处理完成:原始{data_clean.shape[1]}列 → 编码后{data_encoded.shape[1]}列")
print("编码后的前3列:")
print(data_encoded.head(3))


# 6. 删除无用列(去掉和心脏病无关的列,比如ID、姓名)
# 先定义哪些是无用列(根据你的数据改,heart.csv一般没有,所以先设空)
useless_cols = []  # 比如有"ID"列,就写成useless_cols = ["ID"]

# 如果有无用列,就删掉
if len(useless_cols) > 0:
    data_final = data_encoded.drop(columns=useless_cols)
    print(f"\n🗑️ 已删除无用列:{useless_cols}")
else:
    data_final = data_encoded  # 没有无用列,直接用之前的数据
    print("\n✅ 没有无用列,不用删!")

print(f"最终数据形状:{data_final.shape}(行=数据条数,列=特征数)")


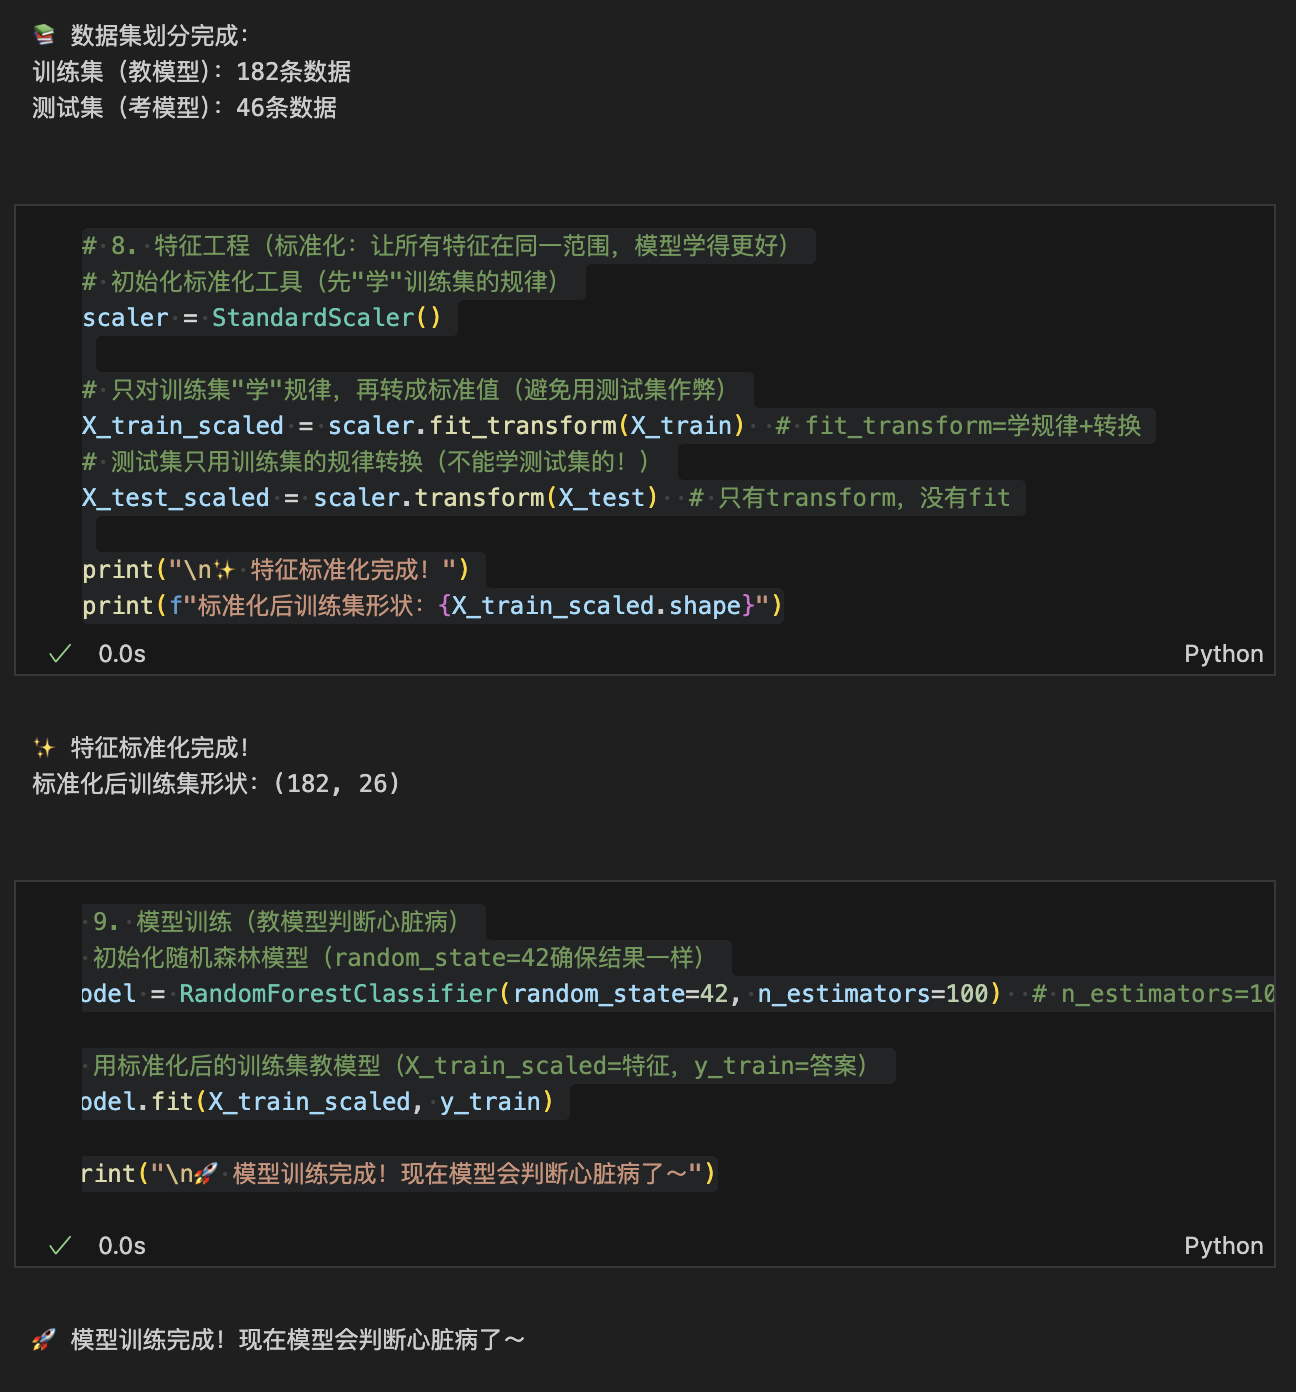
# 7. 划分训练集和测试集(教模型vs考模型)
# 先分"特征"和"目标变量":特征=用来判断的指标(年龄、血压),目标=是否有心脏病
X = data_final.drop("target", axis=1)  # 所有特征(去掉target列)
y = data_final["target"]               # 目标变量(判断心脏病的结果)

# 划分:test_size=0.2表示20%当测试集,random_state=42确保每次结果一样
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 看划分后的数据量
print(f"\n📚 数据集划分完成:")
print(f"训练集(教模型):{X_train.shape[0]}条数据")
print(f"测试集(考模型):{X_test.shape[0]}条数据")

# 8. 特征工程(标准化:让所有特征在同一范围,模型学得更好)
# 初始化标准化工具(先"学"训练集的规律)
scaler = StandardScaler()

# 只对训练集"学"规律,再转成标准值(避免用测试集作弊)
X_train_scaled = scaler.fit_transform(X_train)  # fit_transform=学规律+转换
# 测试集只用训练集的规律转换(不能学测试集的!)
X_test_scaled = scaler.transform(X_test)  # 只有transform,没有fit

print("\n✨ 特征标准化完成!")
print(f"标准化后训练集形状:{X_train_scaled.shape}")


# 9. 模型训练(教模型判断心脏病)
# 初始化随机森林模型(random_state=42确保结果一样)
model = RandomForestClassifier(random_state=42, n_estimators=100)  # n_estimators=100是默认参数,不用改

# 用标准化后的训练集教模型(X_train_scaled=特征,y_train=答案)
model.fit(X_train_scaled, y_train)

print("\n🚀 模型训练完成!现在模型会判断心脏病了~")

# 10. 模型评估(看模型考得怎么样)
# 用测试集预测(让模型做选择题)
y_pred = model.predict(X_test_scaled)

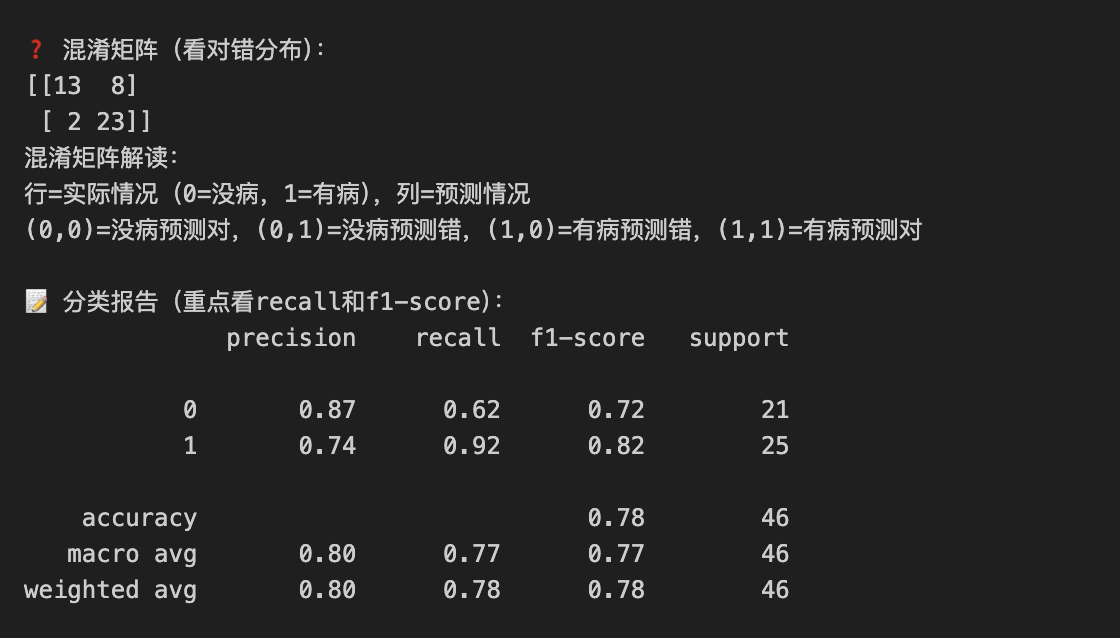
# 10.1 混淆矩阵(看模型错在哪里)
print("\n❓ 混淆矩阵(看对错分布):")
cm = confusion_matrix(y_test, y_pred)
print(cm)
# 解释:比如[[25  3], [4 28]] → 实际没病预测对25人,实际有病预测对28人
print("混淆矩阵解读:")
print("行=实际情况(0=没病,1=有病),列=预测情况")
print("(0,0)=没病预测对,(0,1)=没病预测错,(1,0)=有病预测错,(1,1)=有病预测对")

# 10.2 分类报告(详细分数:精确率、召回率、F1)
print("\n📝 分类报告(重点看recall和f1-score):")
print(classification_report(y_test, y_pred))
# 重点看"1"(有病)的recall:比如0.85=85%的病人被正确判断,漏判少

# 11. 模型保存(存成文件,下次直接用)
# 保存模型(存成"heart_model.pkl"文件,在"心脏病建模"文件夹里)
joblib.dump(model, "heart_model.pkl")
# 保存标准化工具(下次预测新数据也要用)
joblib.dump(scaler, "heart_scaler.pkl")

print("\n💾 模型保存完成!")
print("保存的文件:")
print("1. heart_model.pkl → 训练好的心脏病判断模型")
print("2. heart_scaler.pkl → 特征标准化工具")


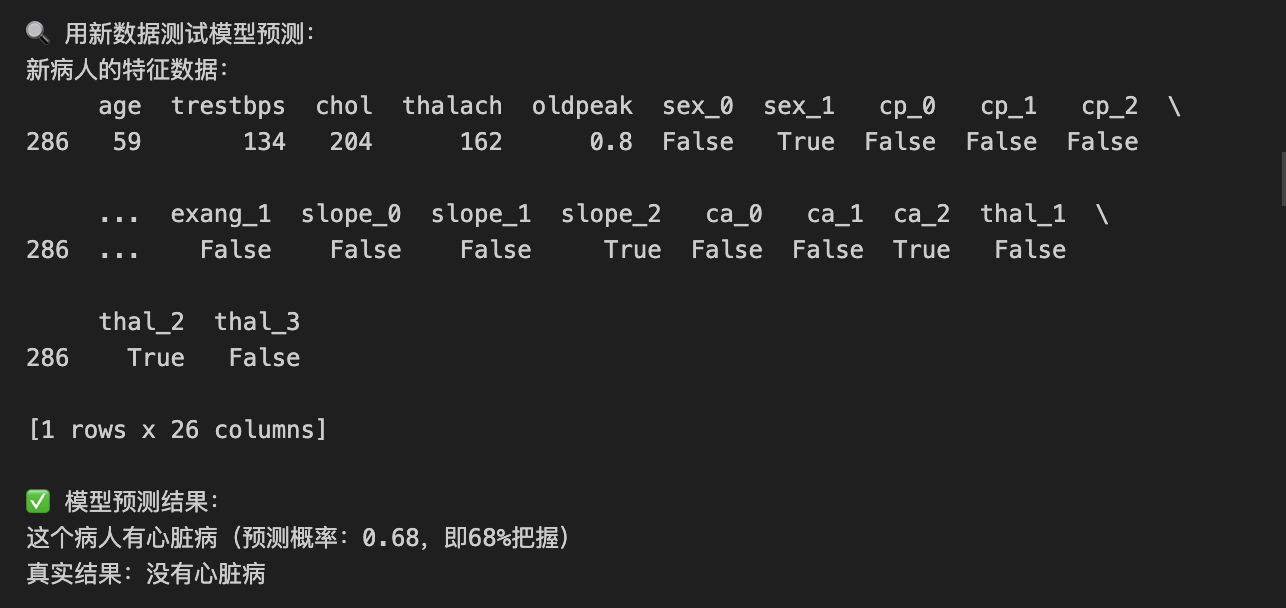
# 12. 模型预测(用新数据判断有没有心脏病)
# 步骤:1.加载保存的模型和标准化工具 → 2.准备新数据 → 3.预测
print("\n🔍 用新数据测试模型预测:")

# 12.1 加载保存的模型和标准化工具(下次用也这么加载)
loaded_model = joblib.load("heart_model.pkl")
loaded_scaler = joblib.load("heart_scaler.pkl")

# 12.2 准备新病人数据(要和训练时的特征顺序一样!这里用测试集中的1条数据当例子)
# 比如取测试集中的第1条数据(真实数据,用来测试)
new_data = X_test.iloc[0:1]  # 取第1条特征数据(iloc[0:1]是取第1行)
print(f"新病人的特征数据:")
print(new_data)

# 12.3 新数据标准化(和训练时的规律一样)
new_data_scaled = loaded_scaler.transform(new_data)

# 12.4 预测(判断有没有心脏病)
prediction = loaded_model.predict(new_data_scaled)
# 预测概率(有多少把握判断对)
pred_prob = loaded_model.predict_proba(new_data_scaled)

# 输出结果
print(f"\n✅ 模型预测结果:")
if prediction[0] == 1:
    print(f"这个病人有心脏病(预测概率:{pred_prob[0][1]:.2f},即{pred_prob[0][1]*100:.0f}%把握)")
else:
    print(f"这个病人没有心脏病(预测概率:{pred_prob[0][0]:.2f},即{pred_prob[0][0]*100:.0f}%把握)")

# 对比真实结果
real_result = y_test.iloc[0]
print(f"真实结果:{'有心脏病' if real_result == 1 else '没有心脏病'}")


# -------------------------- 补充:图片绘制(中文正常显示版) --------------------------
# 设置中文字体(多系统适配,解决中文方框问题)
import platform  # 自动识别电脑系统
system = platform.system()  # 获取系统名称(Windows/macOS/Linux)

if system == 'Windows':
    # Windows系统:用自带的微软雅黑、黑体(绝对存在,不会出错)
    plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Arial Unicode MS']
elif system == 'Darwin':
    # macOS系统:用自带的苹方、黑体(苹果电脑默认字体)
    plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Heiti SC', 'Arial Unicode MS']
else:
    # 其他系统(如Linux):用通用中文字体
    plt.rcParams['font.sans-serif'] = ['WenQuanYi Zen Hei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False  # 保证负号正常显示(不会变成方框)


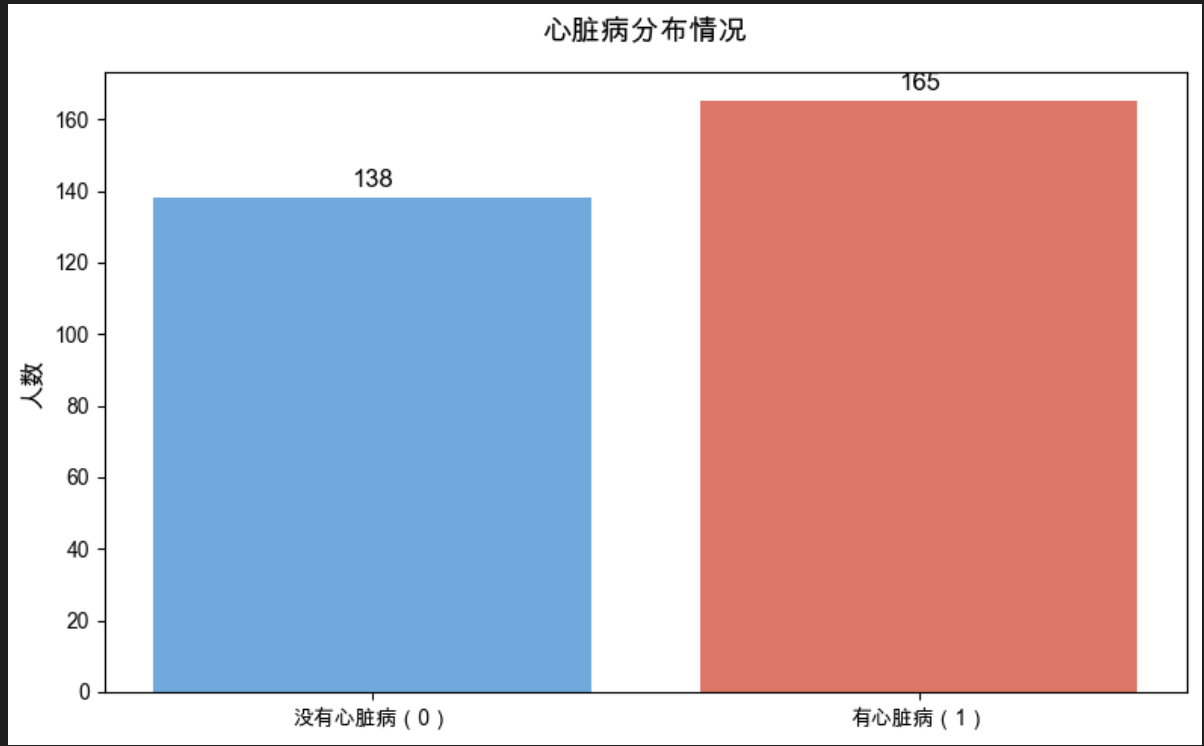
# 1. 图片1:目标变量分布(看有多少人有/没有心脏病)
plt.figure(figsize=(8, 5))  # 设置图片大小(宽8,高5,适中不拥挤)
target_counts = data["target"].value_counts()  # 统计心脏病患者与健康人的数量
# 画柱状图(蓝色=健康,红色=患病,颜色清晰区分)
plt.bar(
    x=["没有心脏病(0)", "有心脏病(1)"],  # x轴中文标签,明确类别含义
    height=[target_counts[0], target_counts[1]],  # 柱子高度=对应类别的样本数
    color=["#3498db", "#e74c3c"],  # 颜色值固定,确保显示效果
    alpha=0.8  # 柱子透明度(0.8=轻微透明,更美观)
)
# 给柱子加数值标签(显示具体人数,避免自己数)
for i, count in enumerate([target_counts[0], target_counts[1]]):
    # 数值放在柱子正上方,居中对齐,字体大小12(清晰不模糊)
    plt.text(i, count + 2, str(count), ha='center', va='bottom', fontsize=12)
plt.title("心脏病分布情况", fontsize=14, pad=15)  # 标题+上下间距15(避免拥挤)
plt.ylabel("人数", fontsize=12)  # y轴标签,说明柱子代表的含义
plt.tight_layout()  # 自动调整整体布局,防止标签被截断
plt.show()  # 显示图片(运行后会弹出窗口,VS Code也会有预览)


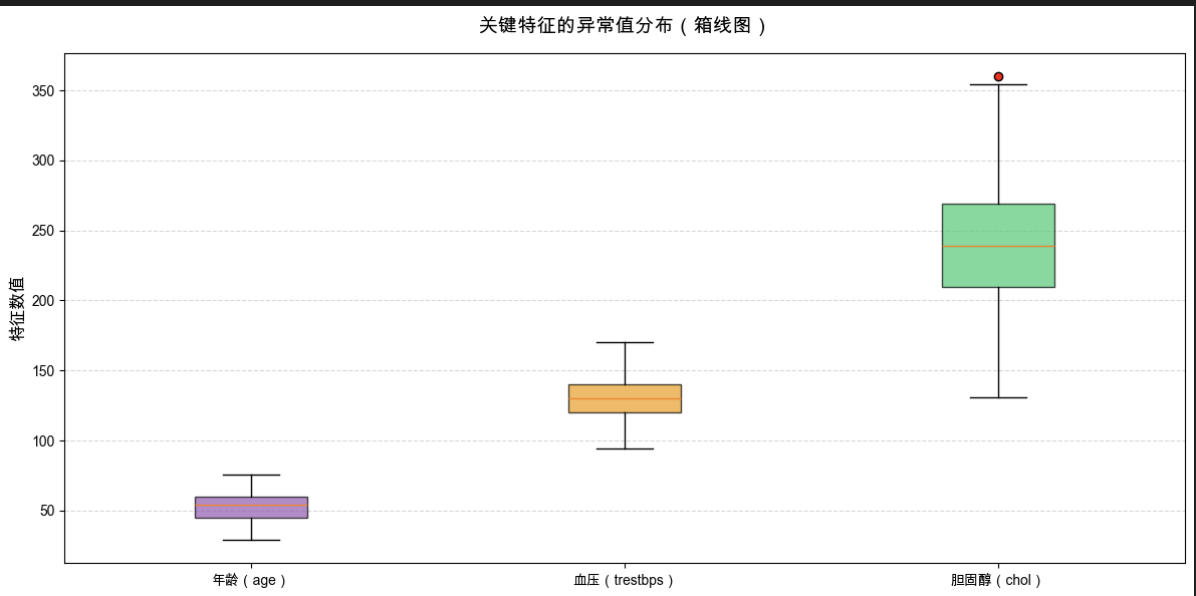
# 2. 图片2:关键特征的异常值可视化(用箱线图看异常值)
# 选3个核心数值特征(年龄、血压、胆固醇),都是判断心脏病的关键指标
key_features = ["age", "trestbps", "chol"]  # 特征名与heart.csv默认列名一致,不用改
plt.figure(figsize=(12, 6))  # 宽12高6(3个特征并排,避免拥挤)
# 画箱线图(显示数据分布和异常值)
box_plot = plt.boxplot(
    [data_clean[feat] for feat in key_features],  # 传入要画的3个特征数据
    labels=["年龄(age)", "血压(trestbps)", "胆固醇(chol)"],  # 中文标签+原列名(方便对照数据)
    patch_artist=True,  # 允许给箱子填充颜色(默认是空心,不好看)
    showfliers=True,  # 显示异常值(圆点形式,直观看到离谱数据)
    flierprops=dict(marker='o', markerfacecolor='red', markersize=6)  # 异常值样式(红色圆点,大小6)
)
# 给每个箱子填充不同颜色(区分特征,更美观)
colors = ["#9b59b6", "#f39c12", "#2ecc71"]  # 紫色=年龄,橙色=血压,绿色=胆固醇
for patch, color in zip(box_plot['boxes'], colors):
    patch.set_facecolor(color)
    patch.set_alpha(0.7)  # 箱子透明度0.7(避免颜色过深)
plt.title("关键特征的异常值分布(箱线图)", fontsize=14, pad=15)  # 标题+间距
plt.ylabel("特征数值", fontsize=12)  # y轴标签(说明数值含义,如年龄的单位是“岁”)
plt.grid(axis='y', linestyle='--', alpha=0.5)  # 加y轴网格线(虚线,透明度0.5,方便看数值范围)
plt.tight_layout()
plt.show()
# 小白解读:箱子中间的横线是“中位数”,箱子上下沿是“四分位数”,箱子外的红色圆点就是“异常值”(比如血压超过180的点)


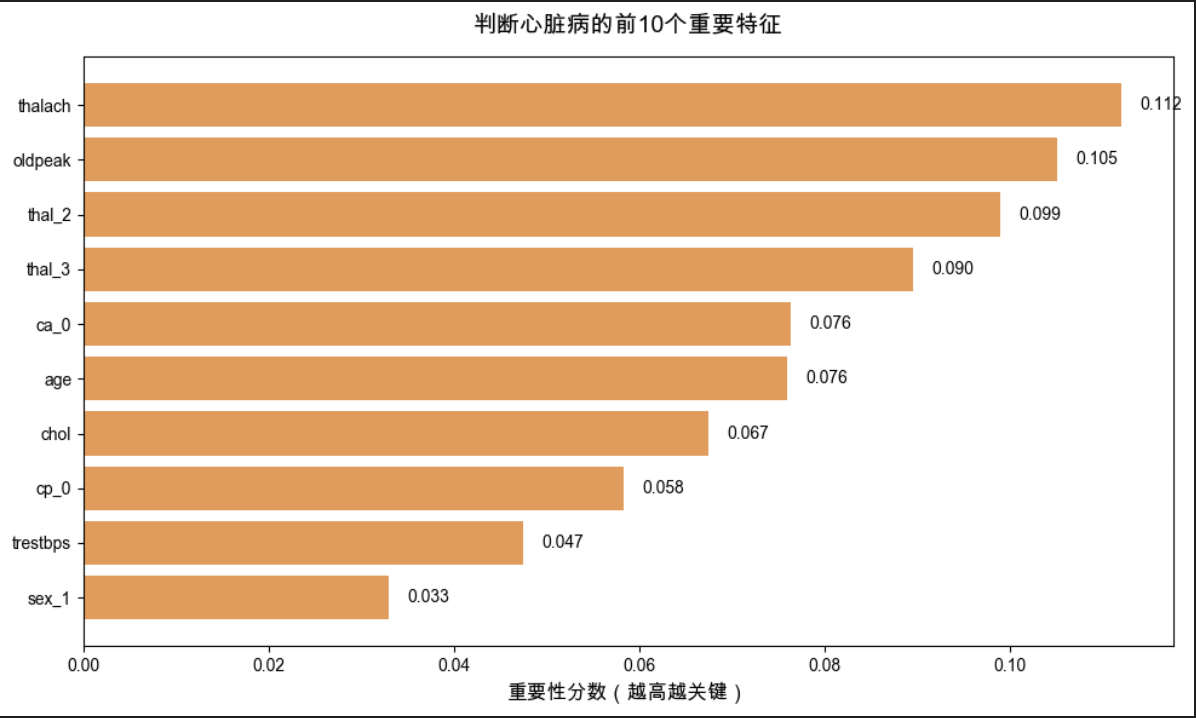
# 3. 图片3:特征重要性排名(看哪些指标对判断心脏病最重要)
# 利用随机森林模型自带的feature_importances_属性,计算每个特征的重要性
feature_importance = pd.DataFrame({
    "特征名": X.columns,  # 特征的列名(与数据中一致,如cp_1、age等)
    "重要性": model.feature_importances_  # 重要性分数(0~1,越高越关键)
}).sort_values("重要性", ascending=False)  # 按重要性从高到低排序(方便看top特征)

# 只画前10个最重要的特征(太多会挤在一起,看不清楚)
top10_features = feature_importance.head(10)
plt.figure(figsize=(10, 6))  # 宽10高6(横向柱状图,特征名不会重叠)
# 画横向柱状图(y轴是特征名,x轴是重要性分数,符合阅读习惯)
bars = plt.barh(
    y=top10_features["特征名"],  # y轴=特征名(如cp_2=胸痛类型2)
    width=top10_features["重要性"],  # x轴=重要性分数
    color="#e67e22",  # 统一用橙色(醒目且不刺眼)
    alpha=0.8
)
# 给每个柱子加数值标签(显示具体重要性分数,精确到3位小数)
for i, (bar, score) in enumerate(zip(bars, top10_features["重要性"])):
    # 数值放在柱子右侧,垂直居中,字体大小10(不遮挡柱子)
    plt.text(score + 0.002, i, f"{score:.3f}", va='center', fontsize=10)
plt.title("判断心脏病的前10个重要特征", fontsize=14, pad=15)
plt.xlabel("重要性分数(越高越关键)", fontsize=12)  # x轴标签,说明分数含义
plt.gca().invert_yaxis()  # 反转y轴(让重要性最高的特征在最上面,符合直觉)
plt.tight_layout()
plt.show()
# 小白解读:比如“cp_2”的重要性分数最高,说明“胸痛类型2”是判断心脏病的最关键指标;“age”(年龄)分数高,说明年龄也很重要


# 4. 图片4:混淆矩阵热力图(更直观看模型对错)
# 用之前计算好的混淆矩阵cm(模型在测试集上的预测结果)画热力图
plt.figure(figsize=(8, 6))  # 宽8高6(混淆矩阵是2x2,正方形更美观)
# 画热力图(颜色深浅代表样本数量,越深=数量越多)
im = plt.imshow(cm, interpolation='nearest', cmap=plt.cm.Blues)  # 用蓝色系配色(温和不刺眼)
# 加右侧颜色条(说明“颜色深浅”对应“样本数量”,不用自己猜)
cbar = plt.colorbar(im, label="样本数量")
cbar.ax.tick_params(labelsize=10)  # 颜色条标签字体大小10
plt.title("模型混淆矩阵(热力图)", fontsize=14, pad=15)

# 给热力图加类别标签(x轴=预测结果,y轴=实际情况)
classes = ["没有心脏病(0)", "有心脏病(1)"]  # 中文类别标签
tick_marks = np.arange(len(classes))  # 刻度位置(0和1)
plt.xticks(tick_marks, classes, fontsize=11)  # x轴刻度+标签(字体11,清晰)
plt.yticks(tick_marks, classes, fontsize=11)  # y轴刻度+标签

# 在每个格子里写具体数值(显示该类别的样本数,避免看颜色猜)
thresh = cm.max() / 2.  # 阈值(矩阵最大值的一半):深色格子用白色字,浅色用黑色字(保证可读性)
for i in range(cm.shape[0]):  # 遍历行(实际情况)
    for j in range(cm.shape[1]):  # 遍历列(预测结果)
        # 数值居中显示,字体大小14(突出重要性)
        plt.text(j, i, format(cm[i, j], 'd'),
                 ha="center", va="center",
                 color="white" if cm[i, j] > thresh else "black",
                 fontsize=14, fontweight='bold')  # 字体加粗(更醒目)

plt.ylabel("实际情况", fontsize=12)  # y轴标签(说明行的含义)
plt.xlabel("预测结果", fontsize=12)  # x轴标签(说明列的含义)
plt.tight_layout()
plt.show()
# 小白解读:左上角格子=“实际没病+预测没病”(正确),右下角=“实际有病+预测有病”(正确);右上角=“实际没病但预测有病”(误判),左下角=“实际有病但预测没病”(漏判);颜色越深,说明这类情况越多

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 32
 0
- 0


 已为社区贡献1条内容

所有评论(0)