登录社区云,与社区用户共同成长
邀请您加入社区
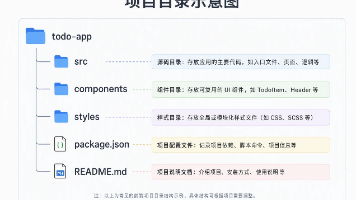
<think>我们根据要求,生成≤150字的文章摘要。需要提炼核心:先让Codex理解现有项目,再计划,后修改;给出提示词模板;避免直接修改。字数限制。</think>已有项目修改前,别急着让 Codex 动手。先引导它阅读项目结构、判断技术栈、定位相关文件,再输出修改计划与影响评估,确认后再执行。这样可减少重复组件、无关改动等风险。文章还提供了可复用提示词模板,并强调初学者只需观察入口、组件与说
文章详细介绍了Deepseek大模型的接入方法,包括获取API参数、通过环境变量安全配置、解决常见问题,以及使用Ollama进行本地部署。内容涵盖Spring Boot集成配置、参数设置和测试用例编写,帮助开发者快速将Deepseek模型集成到应用中,同时提供了本地部署方案以增强数据安全性和降低成本。
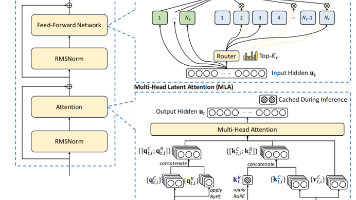
DeepSeek-V3大模型通过创新的多头潜在注意力机制(MLA)和专家混合架构(DeepSeekMoE)实现了性能突破。MLA采用低秩联合压缩技术,显著减少键值缓存需求,提升推理效率;DeepSeekMoE通过细粒度专家划分和无辅助损失负载均衡策略优化计算资源分配。模型还引入序列级辅助损失和受限路由机制,在保持负载均衡的同时降低训练成本。这些创新使DeepSeek-V3在长序列处理、内存利用和计
本文详细介绍了如何使用FastAPI框架构建大模型聚合服务,通过集成DeepSeek和Qwen两大主流大模型实现统一API调用。内容涵盖FastAPI框架优势、API Key获取、环境变量配置、依赖库安装及核心代码实现,帮助开发者高效构建自己的大语言模型服务,提升开发效率和应用灵活性。
摘要: DeepSeek基于混合专家(MoE)架构突破大模型性能与效率瓶颈,以2048个专家子网络的动态分工实现“万亿参数能力、百亿级消耗”。其技术亮点包括动态稀疏注意力(128K上下文窗口)、分层量化策略及自适应计算机制,训练成本较稠密模型降低80%。在多模态理解(MMBench Top3)和代码生成(HumanEval 81.5%通过率)领域表现卓越,支持20+编程语言。企业级应用如智能客服(
摘要: DeepSeek大模型以“自我帮助”为核心登上《Nature》封面,成为首个经同行评审的大模型研究。团队公开全流程细节,仅用600万美元(行业预期的1/10)实现突破,证明AI技术可民主化。其创新包括:1. 拟人化训练,通过“名师带徒”到“自我突破”四步培养模型推理能力;2. 精准奖励机制,分阶段设计规则避免模型“偏科”;3. “慢思考”能力,模型输出中推理词汇显著增加,复杂任务性能提升4
大模型使用和部署,场景应用
本届峰会以“共建安全、可信、包容的智能新生态”为主题,聚焦生成式AI、具身智能、智算基础设施、数据治理与AI治理规则、AI for Science与产业深度应用,服务新质生产力培育与高质量发展。《行动计划》坚持以产业、教育、科技、民生、治理等领域为重点,大力推动人工智能科技创新与产业创新深度融合,全面赋能河北省八大重点产业,深化京津冀人工智能产业协同,着力建设国内领先的人工智能产业创新发展和融合应
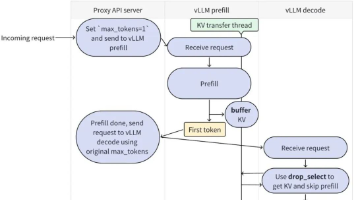
本文深入解析大语言模型推理中的Prefill(P)和Decode(D)分离计算技术,详细介绍了vLLM框架的PD分离方案现状,并对比分析了Connector-Base、英伟达Dynamo、Mooncake集成和SGLang等多种实现方案。通过分离计算密集的Prefill阶段和存储密集的Decode阶段,这些技术显著提升了大模型推理效率和资源利用率,是DeepSeek等大模型高性能运行的关键技术。
本文介绍了如何在星图GPU平台上自动化部署🖋️ 深求·墨鉴 (DeepSeek-OCR-2)镜像,快速搭建私有化OCR服务。该服务能高效识别图片中的中文长文本,并输出为结构清晰的Markdown格式,典型应用于将纸质文档、书籍图片等快速转换为可编辑的电子文本,提升文档处理效率。