登录社区云,与社区用户共同成长
邀请您加入社区
FlashAttention通过I/O感知、Tiling和Recomputation技术,将注意力机制的内存占用从平方关系降低为线性关系。FlashAttention-2优化了工作划分和并行化,FlashAttention-3进一步利用现代硬件特性和低精度计算,实现比标准实现快10倍以上的性能提升,同时保持数值稳定性,使大模型能够高效处理超长文本。
大家好 我是南木我观察到2025年的AI人才市场正经历着深刻变革。随着大模型技术从实验室走向产业落地,企业对算法工程师的技能要求已从单一的模型调优转向"技术深度+工程落地+领域认知"的复合型能力体系。本文将结合最新行业报告和技术突破,系统解析2025年企业最看重的5项核心技能,并配套实战面试题,为你的职业发展提供清晰指引。同时需要学习规划、就业指导、技术答疑和系统课程学习的同学 欢迎扫码交流。
文章讲述了作者尝试将多模态模型应用于RAG系统的实践经历。发现多模态应用比理论复杂,尤其是在RAG系统中处理不同模态数据并保持关联关系。市场多模态模型大多只支持部分模态,全模态较少。作者探讨了应用多模态的挑战,包括维护文档中不同模态数据的关联关系和有效数据召回等问题。强调了实践的重要性,指出多模态RAG系统实现远比理论复杂。
本文分析了智能驾驶中单一传感器面临的"内战"问题(数据孤岛、误差叠加、场景盲区),探讨了多模态融合技术如何通过跨模态互补、层级化处理和动态决策解决这些问题,并介绍了特斯拉、Waymo和华为等公司的实际应用案例。文章展望了多模态融合的未来趋势,强调其正在重新定义自动驾驶安全的边界。
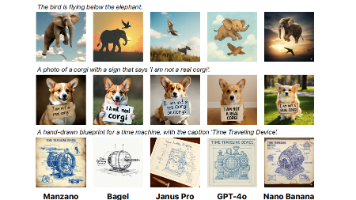
本文的研究目标是解决统一多模态模型中图像理解与生成能力之间的性能冲突。具体问题是,现有的视觉分词策略(连续嵌入用于理解,离散令牌用于生成)导致LLM内部产生任务冲突,影响模型整体性能。为解决此问题,论文提出了 Manzano 模型,其核心技术贡献是设计了一个混合图像分词器。该分词器使用一个共享的视觉编码器,派生出两个适配器:一个连续适配器为理解任务生成连续嵌入,一个离散适配器为生成任务提供离散令牌
本文通过构建简单模型详细解析Transformer架构,追踪输入数据的维度变化,解释多头注意力机制、编码器和解码器的工作原理。文章解答了训练过程、损失计算和文本生成的关键问题,揭示了掩码多头注意力如何防止模型"作弊",以及如何通过逐步预测生成文本。通过图解方式,帮助读者深入理解这一大模型的核心技术。
《MST-Distill:跨模态知识蒸馏的专业化教师混合框架》提出创新方法解决AI模型跨模态学习中的教师选择与知识漂移问题。该框架通过三阶段实现:协作初始化促进模型协同学习,MaskNet模块过滤适配知识,GateNet动态选择最优教师组合。实验表明,相比传统方法性能提升3-8%,在自动驾驶、医疗诊断等领域具有应用潜力。核心贡献在于建立了多教师动态辅导新范式,有效解决了知识传递中的注意力不匹配问题
本文为有Python基础的工程师提供大模型入门教程,涵盖角色定位、Transformer原理、PyTorch实战训练迷你模型、HuggingFace工具应用及分阶段学习路径,通过从简到繁的实战项目帮助读者逐步掌握大模型开发技能,最终实现模型微调和部署应用。
本周聚焦多模态大模型架构创新与交互式智能体训练方法。深入研究了字节Seed1.5-VL的三阶段预训练策略(MLP适配器对齐→视觉定位OCR→视频推理扩展)与强化学习后训练机制(拒绝采样+PPO算法),重点分析了其动态帧采样和时间戳标记等核心技术;系统学习了LLaVA-mini的视觉token压缩与模态预融合优化方案,以及USERRL框架的交互式训练环境设计与轨迹级评分机制。研究构建了从多模态特征对
文章通过巴黎旅行比喻,详细解析了多模态深度学习的六大步骤:同时收集视觉、听觉、文字等多模态信息;让不同信息源相互关联;将复杂体验转化为可比较的编码;确保信息一致性;智能融合所有信息得出结论;将深度理解转化为准确表达。这种学习方式让AI能够像人类一样通过"多重感官"全面理解世界,实现更精准的认知和判断。
摘要: DeepSeek大模型以“自我帮助”为核心登上《Nature》封面,成为首个经同行评审的大模型研究。团队公开全流程细节,仅用600万美元(行业预期的1/10)实现突破,证明AI技术可民主化。其创新包括:1. 拟人化训练,通过“名师带徒”到“自我突破”四步培养模型推理能力;2. 精准奖励机制,分阶段设计规则避免模型“偏科”;3. “慢思考”能力,模型输出中推理词汇显著增加,复杂任务性能提升4