登录社区云,与社区用户共同成长
邀请您加入社区
OpenAI 上周整理了一篇文章,介绍内部是怎么用 Codex 的。使用 Codex 的团队包括安全、产品、前端、API、基础设施和性能工程。从接手的任务来看,Codex 主要的使用场景为:理解复杂代码库、重构和迁移、性能优化、补测试、交付新功能,以及在紧急情况下排查故障等等。
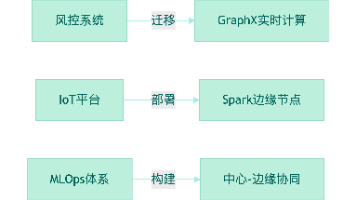
Apache Spark已从内存计算引擎发展为覆盖数据处理、机器学习、图计算和边缘计算的完整生态系统。本文将深入探讨Spark生态中两大前沿方向:GraphX图计算在金融风控的应用以及Spark在IoT边缘计算场景的创新实践。随着Spark 3.5对边缘场景的深度优化及图神经网络的融合,开发者将获得更强大的工具应对数字化挑战。Spark正从"数据中心框架"蜕变为连接云端与边缘的"全域智能计算中枢"
本文介绍了视觉多模态模型Qwen2.5-VL的部署优化方案。通过对比vLLM和SGLang框架,提出了三种部署策略:独立部署(快速验证)、混合部署(结合TensorRT优化ViT模块)和分离部署(ViT与LLM分设备运行)。测试显示,分离部署模式在4090显卡上实现了最佳性能(QPS 10.8),同时分析了不同方案的适用场景。文章还探讨了视频预处理对CPU资源的占用问题,强调了控制服务分离的重要性
阿里开源了全新的推理模型:QwQ-32B。据官方发布消息,该模型性能比肩满血版 DeepSeek-R1(671B)!
综合官方的比较,发现 Qwen3 的8个模型的从优到劣分别是:Qwen3-235B-A22B > Qwen3-32B > Qwen3-30B-A3B > …,本地24G显存可以部署 Qwen3-32B 和 Qwen3-30B-A3B 的量化版。
本文介绍了SpringCloud中的声明式HTTP客户端Feign的基本使用和优化方法。Feign通过注解方式简化了微服务间的远程调用,支持负载均衡和多种配置选项。文章详细讲解了Feign的引入方式、接口定义、日志级别设置等基本用法,并提供了性能优化建议,如使用HttpClient连接池替代默认实现。Feign能显著提升开发效率,使远程调用像本地方法一样简单,同时支持灵活的定制和扩展,是微服务架构
本文将系统解析跨地域虚拟化环境中如何实施精确的存储资源控制,涵盖配额设定、监控预警、动态调整等核心流程,为分布式系统管理员提供可落地的解决方案。
LLaMA 模型因其高效的性能和较小的模型尺寸而受到关注,这使得它们能够在资源有限的环境中运行,例如个人计算机或移动设备。
作用:将每个分组的数据作为一个完整的迭代器(Iterator)传递给一个自定义函数。它通常在Shuffle之后发生,没有Combiner。生活场景:总经理已经把各个台的数据分好组了,他把一个台的所有交易数据(可能已经很多了)交给一个专家,说:“你帮我仔细分析一下这个台的数据,怎么分析我不管,给我一个最终报告就行。代码示例(找出每个台最大的一笔交易):val resultDS = salesDS.
FastGPT 依然延续着早期的思路去完善和扩展。目前,其在向量搜索 + LLM 线性问答方面的功能基本已完成。
本文详细介绍了在Windows系统的Docker Desktop环境中搭建6节点(3主3从)Redis集群的完整流程。主要内容包括:环境清理、创建Docker网络、配置目录结构、生成Redis配置文件、启动容器、初始化集群以及功能验证等步骤。文章还提供了简化版3节点集群搭建方法,并针对常见问题给出解决方案。此外,还介绍了高级功能如密码认证配置和持久化优化选项。通过清晰的PowerShell命令和验
机器学习指南
大家好,我是阿可,微赚淘客系统及省赚客APP创始人,是个冬天不穿秋裤,天冷也要风度的程序猿!电商返利APP在用户量激增、促销活动等场景下,常面临响应延迟、接口超时等性能问题。基于微服务架构的特性,可从服务调用、数据存储、资源调度三个维度实施优化,以下结合具体代码与实践方案展开。
部署一个本地知识库,将你所有的东西都丢进去,一查即出,重要的是不用担心泄密,是不是很优秀。
在大模型应用和推理系统中,性能优化是关键环节。无论是 LangChain、vLLM 还是 RAG 系统,架构设计、推理策略和资源调度都会直接影响延迟、吞吐量和成本。
会导致MySQL扫描前100万条记录。