「日拱一码」083 深度学习——残差网络
·
目录
残差网络(ResNet)介绍
核心思想与要解决的问题
在深度学习领域,一个直觉是:网络越深(层数越多),其能够学习到的特征就越复杂,性能也应该越好。然而,实验发现,当网络深度增加到一定程度时,模型的准确率会达到饱和,甚至开始迅速下降。这种现象被称为退化问题(Degradation Problem)。
退化问题并非由过拟合引起(因为训练误差也会随之增加),而是因为深度网络难以训练,尤其是存在梯度消失/爆炸等问题,使得深层网络难以被优化。
解决方案:残差学习(Residual Learning)
ResNet 的作者何恺明等人提出了一个革命性的思路:与其让堆叠的层直接学习一个潜在的映射 H(x),不如让它们学习一个残差映射(Residual Mapping)。
- 原始映射:
H(x) = desired underlying mapping - 残差映射:
F(x) = H(x) - x - 目标映射变为:
H(x) = F(x) + x
这里的 x 是输入,也称为恒等映射(Identity Mapping)或快捷连接(Shortcut Connection)。
通过这种结构,学习的目标从 H(x) 变成了 F(x),即学习输出与输入之间的残差(差值)。
为什么有效?
- 缓解梯度消失:梯度可以直接通过快捷连接反向传播到更浅的层,使得深层网络的训练变得更加容易。
- 恒等映射是高效的:如果某一层的输出已经是最优了(即
H(x) = x是最优解),那么将残差F(x)学习为 0 比学习一个恒等映射要容易得多(F(x) = 0比F(x) = x更简单)。 - 集成行为:ResNet 可以被看作是一系列路径集合的浅层网络,改善了网络的表达能力和训练动态。
ResNet 的提出使得构建成百上千层的深度神经网络成为可能,并在图像分类、目标检测等计算机视觉任务上取得了突破性的成果。
代码示例
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
import matplotlib.pyplot as plt

# 设置设备(GPU如果可用)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Using device: {device}")


# 1. 定义残差块 (Residual Block)
class BasicBlock(nn.Module):
    expansion = 1

    def __init__(self, in_planes, planes, stride=1):
        super(BasicBlock, self).__init__()
        self.conv1 = nn.Conv2d(in_planes, planes, kernel_size=3, stride=stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(planes)
        self.conv2 = nn.Conv2d(planes, planes, kernel_size=3, stride=1, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(planes)

        # 快捷连接 (Shortcut Connection)
        self.shortcut = nn.Sequential()
        if stride != 1 or in_planes != self.expansion * planes:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_planes, self.expansion * planes, kernel_size=1, stride=stride, bias=False),
                nn.BatchNorm2d(self.expansion * planes)
            )

    def forward(self, x):
        out = F.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))
        out += self.shortcut(x)  # 残差连接
        out = F.relu(out)
        return out


# 2. 定义小型ResNet模型
class SmallResNet(nn.Module):
    def __init__(self, block, num_blocks, num_classes=10):
        super(SmallResNet, self).__init__()
        self.in_planes = 64

        # 初始卷积层
        self.conv1 = nn.Conv2d(3, 64, kernel_size=3, stride=1, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(64)

        # 残差层
        self.layer1 = self._make_layer(block, 64, num_blocks[0], stride=1)
        self.layer2 = self._make_layer(block, 128, num_blocks[1], stride=2)
        self.layer3 = self._make_layer(block, 256, num_blocks[2], stride=2)
        self.layer4 = self._make_layer(block, 512, num_blocks[3], stride=2)

        # 分类层
        self.linear = nn.Linear(512 * block.expansion, num_classes)

    def _make_layer(self, block, planes, num_blocks, stride):
        strides = [stride] + [1] * (num_blocks - 1)
        layers = []
        for stride in strides:
            layers.append(block(self.in_planes, planes, stride))
            self.in_planes = planes * block.expansion
        return nn.Sequential(*layers)

    def forward(self, x):
        out = F.relu(self.bn1(self.conv1(x)))
        out = self.layer1(out)
        out = self.layer2(out)
        out = self.layer3(out)
        out = self.layer4(out)
        out = F.avg_pool2d(out, 4)  # CIFAR-10最终特征图尺寸为4x4
        out = out.view(out.size(0), -1)
        out = self.linear(out)
        return out


# 3. 数据预处理和加载
transform_train = transforms.Compose([
    transforms.RandomCrop(32, padding=4),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])

transform_test = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])

train_dataset = datasets.CIFAR10(root='./data', train=True, download=True, transform=transform_train)
test_dataset = datasets.CIFAR10(root='./data', train=False, download=True, transform=transform_test)

train_loader = DataLoader(train_dataset, batch_size=128, shuffle=True, num_workers=2)
test_loader = DataLoader(test_dataset, batch_size=100, shuffle=False, num_workers=2)

# 4. 初始化模型、损失函数和优化器
model = SmallResNet(BasicBlock, [2, 2, 2, 2]).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.1, momentum=0.9, weight_decay=5e-4)
scheduler = optim.lr_scheduler.MultiStepLR(optimizer, milestones=[50, 75], gamma=0.1)


# 5. 训练和测试函数
def train(epoch):
    model.train()
    train_loss = 0
    correct = 0
    total = 0
    for batch_idx, (inputs, targets) in enumerate(train_loader):
        inputs, targets = inputs.to(device), targets.to(device)

        optimizer.zero_grad()
        outputs = model(inputs)
        loss = criterion(outputs, targets)
        loss.backward()
        optimizer.step()

        train_loss += loss.item()
        _, predicted = outputs.max(1)
        total += targets.size(0)
        correct += predicted.eq(targets).sum().item()

    acc = 100. * correct / total
    print(f'Epoch: {epoch} | Train Loss: {train_loss / (batch_idx + 1):.3f} | Acc: {acc:.3f}%')


def test(epoch):
    model.eval()
    test_loss = 0
    correct = 0
    total = 0
    with torch.no_grad():
        for batch_idx, (inputs, targets) in enumerate(test_loader):
            inputs, targets = inputs.to(device), targets.to(device)
            outputs = model(inputs)
            loss = criterion(outputs, targets)

            test_loss += loss.item()
            _, predicted = outputs.max(1)
            total += targets.size(0)
            correct += predicted.eq(targets).sum().item()

    acc = 100. * correct / total
    print(f'Test Loss: {test_loss / (batch_idx + 1):.3f} | Acc: {acc:.3f}%')
    return acc


if __name__ == '__main__':
    # 6. 训练循环
    train_accuracies = []
    test_accuracies = []

    print("开始训练...")
    for epoch in range(1, 101):  # 训练100个epoch
        train_acc = train(epoch)
        test_acc = test(epoch)
        scheduler.step()

        train_accuracies.append(train_acc)
        test_accuracies.append(test_acc)

    print("训练完成!")

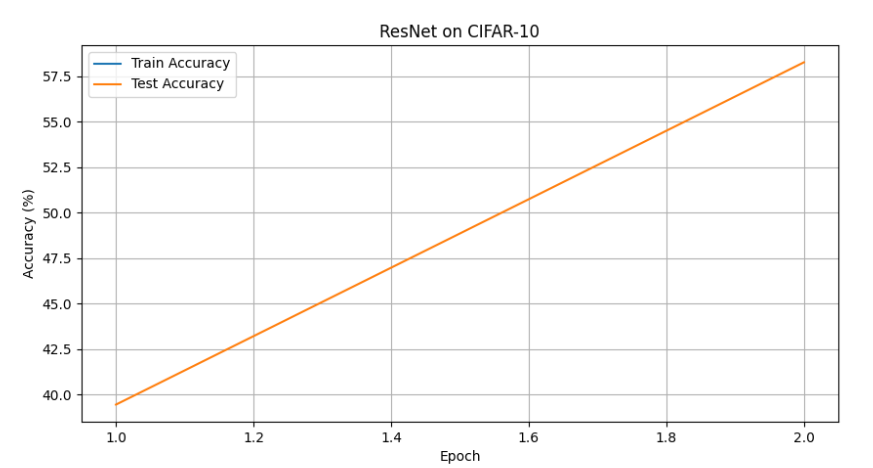
    # 7. 绘制准确率曲线
    plt.figure(figsize=(10, 5))
    plt.plot(range(1, 101), train_accuracies, label='Train Accuracy')
    plt.plot(range(1, 101), test_accuracies, label='Test Accuracy')
    plt.xlabel('Epoch')
    plt.ylabel('Accuracy (%)')
    plt.title('ResNet on CIFAR-10')
    plt.legend()
    plt.grid(True)
    plt.savefig('resnet_cifar10.png')
    plt.show()

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 7
 0
- 0


 已为社区贡献7条内容

所有评论(0)