决策树算法的核心应用场景、概念原理、Python完整代码实现与参数设置、性能调优 附小白零基础友好入门Python机器学习与数据分析学习教材
一、决策树算法的核心应用场景
-
分类任务场景
在需要明确分类结果的场景中,决策树通过特征阈值划分实现精准决策。金融风控领域,银行利用决策树分析客户收入、信用评分、负债率等特征,构建贷款审批模型(如"收入>50万且信用评级≥A则批准贷款"的规则链),既能处理数值型数据(如年收入),也能处理类别型特征(如职业类型)。医疗诊断场景中,通过年龄、症状、检测指标等特征构建疾病预测模型,例如基于肿瘤大小、淋巴结状态判断癌症分期,其树状结构可直观展示诊断逻辑,辅助医生理解关键指标权重。电商运营则用于用户流失预测,通过登录频次、客单价、最近购买时间等特征识别高风险用户群体,及时触发挽留策略。
-
回归预测场景
对于连续值预测需求,决策树通过最小化均方误差(MSE)实现高效建模。房地产领域,基于房屋面积、地段、房龄等结构化特征预测房价,模型可自动生成区域价格基准(如"核心商圈每平米溢价30%"),帮助评估资产价值。能源管理中,结合历史用电数据、天气特征预测负荷峰值,为电网调度提供依据。工业生产场景下,通过设备运行参数(温度、振动频率)预测剩余寿命,实现预防性维护,降低停机损失。
-
混合数据场景
决策树天然支持数值型与类别型特征的混合处理,无需复杂预处理。客户分群时,可同时纳入消费金额(数值)、会员等级(类别)、地域(类别)等多模态数据,自动识别高价值客户特征组合(如"一线城市VIP客户月均消费>5000元")。教育评估中,结合考试成绩(数值)、出勤率(数值)、课外活动参与度(类别)预测学生升学概率,为教学干预提供数据支持。
-
复杂系统优化
在需要规则透明化的复杂系统中,决策树展现独特优势。供应链管理通过订单量、库存水平、运输成本等特征优化补货策略,生成"当库存周转率<5且运输成本>预算20%时启动紧急采购"的决策规则。交通调度场景下,基于实时路况、车辆位置、信号灯状态构建动态路径规划模型,提升通行效率。游戏AI开发中,决策树用于角色行为树构建,例如NPC根据玩家距离、血量、武器类型选择攻击或躲避策略。
-
集成学习基座
作为随机森林、梯度提升树(如XGBoost)的核心组件,决策树通过Bagging和Boosting策略显著提升性能。在推荐系统中,多棵决策树并行学习用户行为特征,通过投票机制提高点击率预测准确率。图像识别领域,决策树用于特征提取阶段,辅助卷积神经网络(CNN)提升小样本学习效果。
核心价值总结:决策树在需要规则可解释性、混合数据处理、快速原型开发的场景中具有不可替代性,其树状结构天然适配业务人员与技术团队的协作需求。结合剪枝策略(如代价复杂度剪枝)和集成方法,可有效平衡模型复杂度与预测精度,在金融、医疗、工业等领域的实际业务中持续创造价值。
二、核心概念与原理
决策树是一种基于树状结构的监督学习算法,通过递归划分数据特征实现分类或回归。其核心要素包括:
-
节点类型:
-
根节点:起始特征(如"是否有房")
-
内部节点:特征判断分支(如"收入>5000")
-
叶节点:最终决策结果(如"批准贷款")
-
-
分裂准则:
-
分类任务:信息增益(ID3)、信息增益率(C4.5)、基尼指数(CART)
-
回归任务:均方误差(MSE)最小化
-
-
停止条件:
-
节点纯度达标(如基尼指数<0.1)
-
达到最大深度(如max_depth=5)
-
样本数小于阈值(如min_samples_split=10)
-
-
剪枝策略:
-
预剪枝:通过参数限制树生长(如设置max_depth)
-
后剪枝:生成树后剪除冗余分支(如CCP成本复杂度剪枝)
-
三、Python实现步骤(以鸢尾花分类为例)
1. 数据准备
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# 加载数据
iris = load_iris()
X, y = iris.data, iris.target

# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)
2. 模型训练
from sklearn.tree import DecisionTreeClassifier

# 创建CART分类树(基尼指数)
clf = DecisionTreeClassifier(
    criterion='gini',  # 分裂准则
    max_depth=3,       # 防止过拟合
    min_samples_split=5 # 最小样本分裂数
)

# 训练模型
clf.fit(X_train, y_train)
3. 模型评估
from sklearn.metrics import accuracy_score, classification_report

# 预测
y_pred = clf.predict(X_test)

# 评估
print(f"准确率: {accuracy_score(y_test, y_pred):.2f}")
print("分类报告:")
print(classification_report(y_test, y_pred))
4. 可视化决策树
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(12,8))
plot_tree(
    clf,
    feature_names=iris.feature_names,
    class_names=iris.target_names,
    filled=True,      # 填充颜色表示类别
    rounded=True,     # 圆角节点
    fontsize=12
)
plt.show()
四、完整代码示例(贷款审批场景)
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, export_text
from sklearn.preprocessing import LabelEncoder

# 模拟数据
data = {
    '年龄': ['青年', '中年', '老年', '中年', '青年', '老年'],
    '收入': [50000, 80000, 30000, 120000, 45000, 90000],
    '有房': [0, 1, 0, 1, 0, 1],
    '信贷记录': ['一般', '良好', '差', '优秀', '一般', '良好'],
    '是否批准': [0, 1, 0, 1, 0, 1]
}

df = pd.DataFrame(data)

# 数据编码
le = LabelEncoder()
df['年龄'] = le.fit_transform(df['年龄'])
df['信贷记录'] = le.fit_transform(df['信贷记录'])
df['是否批准'] = le.fit_transform(df['是否批准'])

# 划分特征与标签
X = df[['年龄', '收入', '有房', '信贷记录']]
y = df['是否批准']

# 训练模型
model = DecisionTreeClassifier(max_depth=3)
model.fit(X, y)

# 可视化规则
tree_rules = export_text(model, feature_names=X.columns)
print(tree_rules)

# 预测新样本
new_sample = [[3, 85000, 1, 2]]  # 青年、高收入、有房、优秀信贷
prediction = model.predict(new_sample)
print(f"审批结果: {'批准' if prediction[0]==1 else '拒绝'}")
五、关键参数调优
| 参数 | 作用 | 典型值 |
|---|---|---|
| max_depth | 限制树深度,防止过拟合 | 3-10 |
| min_samples_split | 节点最小样本数 | 2-20 |
| max_features | 分裂时考虑的最大特征数 | 'sqrt'/'log2' |
| class_weight | 处理类别不平衡(如'balanced') | None/'balanced' |
六、应用场景对比
| 场景类型 | 推荐算法 | 案例说明 |
|---|---|---|
| 分类任务 | CART | 客户分群(收入/消费习惯) |
| 回归任务 | CART | 房价预测(面积/地段/房龄) |
| 高维数据 | C4.5 | 基因表达数据分析 |
| 实时预测 | ID3 | 网络流量异常检测 |
七、性能优化技巧
-
特征工程:
-
对连续特征进行分箱处理(如年龄分段)
-
使用PCA降维减少冗余特征
-
-
集成方法:
from sklearn.ensemble import RandomForestClassifier # 随机森林(100棵树) rf = RandomForestClassifier(n_estimators=100, max_depth=5) rf.fit(X_train, y_train) -
交叉验证:
from sklearn.model_selection import GridSearchCV
param_grid = {'max_depth': [3,5,7]}
grid = GridSearchCV(DecisionTreeClassifier(), param_grid, cv=5)
grid.fit(X_train, y_train)
print(f"最佳参数: {grid.best_params_}")
通过上述实现与调优策略,决策树可有效处理分类与回归问题。建议结合业务场景选择算法(如金融风控用CART,医疗诊断用ID3),并通过可视化工具(如Graphviz)深入理解模型决策逻辑。
八、Python 数据分析或机器学习推荐
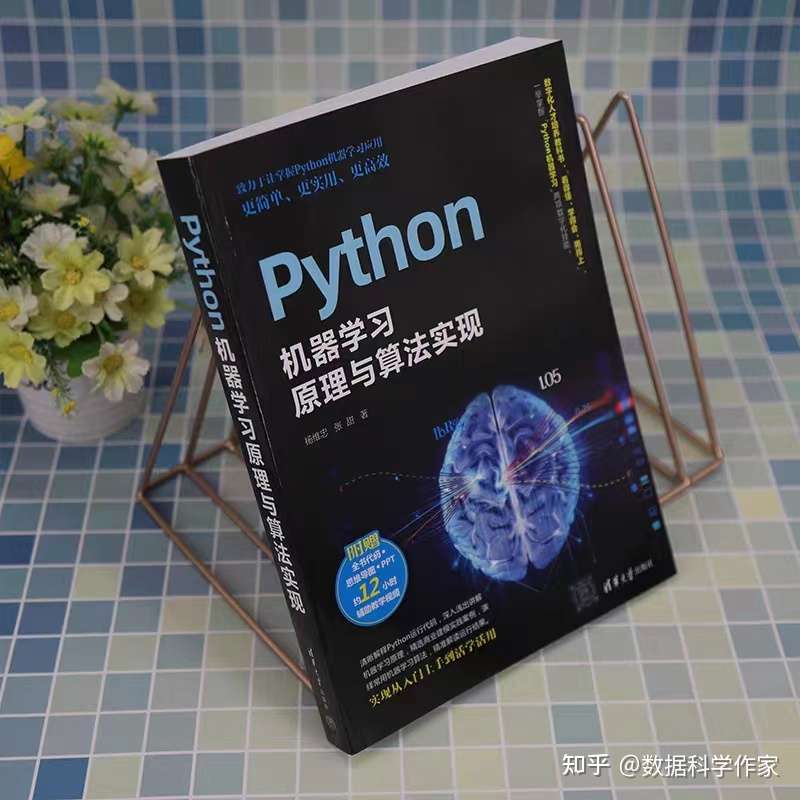
1.针对 Python 数据分析或机器学习推荐两本入门级的图书:《Python 机器学习原理与算法实现》(杨维忠,张甜 著,2023 年 2 月新书,清华大学出版社)《Python 数据科学应用从入门到精通》(张甜,杨维忠 著,2023 年 11 月新书,清华大学出版社)。
这两本书的特色是在数据分析、机器学习各种算法的介绍方面通俗易懂,较少涉及数学推导,对数学基础要求相对不高,在 Python 代码方面讲的很细致,看了以后根据自身需要选取算法、优化代码、科学调参。都有配套免费提供的源代码、数据文件和视频讲解,也有 PPT、思维导图、习题等。
(1)《Python 机器学习原理与算法实现》杨维忠,张甜编著,清华大学出版社,2023 年,适用于 Python 基础教学、数据分析、数据挖掘与建模、机器学习等教学。内容非常详实,包含了 Python 和机器学习,相当于一次获得了两本书。在讲解各类机器学习算法时,逐一详解用到的各种 Python 代码,针对每行代码均有恰当注释(这一点基本上是大多数书目做不到的)。本书将Python与机器学习应用相结合,通过“深入浅出讲解机器学习原理—贴近实际精选操作案例—详细演示Python操作及代码含义—准确完整解读分析结果”的一站式服务,旨在写出让读者“能看得懂、学的进去、真用得上”的Python 机器学习书目,献给新时代的莘莘学子和职场奋斗者。
全书内容共17章。第1、2章介绍Python的入门知识和进阶知识(这两章就相当于学习一本厚厚的Python教材);第3章介绍机器学习的概念及各种术语及评价标准(学会这一章就可以出去吹了,不算外行了,网上那些机器学习的新闻和帖子就都能看懂了);第4~10章介绍相对简单的监督式学习方法,包括线性回归算法、二元Logistic回归算法、多元Logistic回归算法、判别分析算法、朴素贝叶斯算法、高维数据惩罚回归算法、K近邻算法(这些都是基本功,也很好学,没有什么复杂的数学推导,数学不好的可以大胆放心学!);第11、12章介绍主成分分析算法、聚类分析算法两种非监督式学习算法(很简单的两章);第13~15章介绍相对复杂的监督式学习算法,包括决策树算法和随机森林算法、提升法两种集成学习算法(这3章相对难些,但是有了前面的基础,稍微下下功夫就会了);第16、17章介绍支持向量机算法、神经网络算法两种高级监督式学习算法(这2章虽然复杂点,但也是学习深度学习、大语言模型的基础,加把劲也就学过来,从此人生尽是坦途)。
(2)《Python 数据科学应用从入门到精通》张甜 杨维忠编著 清华大学出版社 2023 年 适用于 Python 基础教学、数据分析、数据挖掘与建模、数据可视化、数据清洗等教学。旨在教会读者实现全流程的数据分析,并且相对《Python 机器学习原理与算法实现》一书增加了很多概念性、科普性的内容,进一步降低了学习难度。
国务院发展研究中心创新发展研究部第二研究室主任杨超 ,山东大学经济学院金融系党支部书记、副主任、副教授、硕士生导师张博,山东管理学院信息工程学院院长 袁锋 教授、硕士生导师,山东大学经济学院刘一鸣副研究员、硕士生导师,得厚投资合伙人张伟民等一众大牛联袂推荐。
最大的特色来了:书中全是干货,买这一本书相当于一下子得到了 5 本书(Python 基础、数据清洗、特征工程、数据可视化、数据挖掘与建模),而且入门超级简单,不需要编程基础,也不需要过多数学推导,非常适用于零基础学生。
全书内容共分 13 章。其中第 1 章为数据科学应用概述,第 2 章讲解 Python 的入门基础知识,第 3 章讲解数据清洗。第 4~6 章介绍特征工程,包括特征选择、特征处理、特征提取。第 7 章介绍数据可视化。第 8~13 章介绍 6 种数据挖掘与建模方法,分别为线性回归、Logistic 回归、决策树、随机森林、神经网络、RFM 分析。从数据科学应用和 Python 的入门,再到数据清洗与特征工程,最终完成数据挖掘与建模或数据可视化,从而可以为读者提供“从拿到数据开始,一直到构建形成最终模型或可视化报告成果”的一站式、全流程指导。

强烈建议《Python 数据科学应用从入门到精通》《Python 机器学习原理与算法实现》两本都学!

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 21
 0
- 0


 已为社区贡献6条内容

所有评论(0)