如何快速入门机器学习?技术小白也能快速学习并掌握人工智能知识吗?完全零基础学机器学习的话,还需要掌握哪些知识?有没有推荐机器学习的路线(或者课程)?机器学习可以自学吗?
记住:真正的技术竞争力不在于推导公式的速度,而在于将想法转化为可落地解决方案的能力。
机器学习的核心价值在于解决实际问题,而非追求理论完备性。对于非科班出身且不以科研为目标的机器学习学习者而言,应当将学习重心聚焦于实用技能培养与快速产出价值,而非陷入数学公式的抽象推导中。这一观点在人工智能技术快速迭代的当下尤为重要——企业更关注如何通过算法优化业务流程、提升决策效率,而非验证某个定理的数学严谨性。例如,零售企业需要的是能预测销量波动的模型,而非复杂数学推导下的完美公式;医疗机构需要的是可解释的疾病诊断工具,而非理论上的最优解。这种实用主义导向,恰恰与非科班学习者的职业发展需求高度契合。
Python作为人工智能领域的主流编程语言,其简洁的语法、丰富的库生态(如NumPy、Pandas、Scikit-learn、PyTorch等)以及活跃的开源社区,为非技术背景者提供了低门槛的实践路径。通过Python实现机器学习,学习者无需从零构建底层算法,而是可以直接调用成熟的库函数快速搭建模型。例如,使用Scikit-learn仅需三行代码即可完成线性回归模型的训练与预测,这种"即插即用"的特性极大降低了学习门槛。更关键的是,Python的可视化工具(如Matplotlib、Seaborn)能将抽象的模型性能转化为ROC曲线、混淆矩阵等直观图表,使学习者通过结果反馈快速验证学习效果,形成"编码-验证-优化"的正向循环。这种"边做边学"的模式,既能规避复杂数学推导带来的挫败感,又能通过解决真实业务问题积累成就感,这正是非科班学习者突破技术壁垒的关键。
在职业发展层面,Python机器学习的学习路径具有显著的"学以致用"特征。以金融风控场景为例,学习者可通过Pandas清洗贷款申请数据,利用Scikit-learn构建逻辑回归模型评估违约风险,最终将模型部署至生产环境。这种从数据预处理到模型部署的全流程实践,不仅培养了解决实际问题的能力,更直接对接企业的人才需求。数据显示,掌握Python机器学习技能的非科班从业者,在金融、电商、医疗等行业的起薪普遍高于传统数据分析岗位30%以上。更重要的是,Python的开源生态(如GitHub、Kaggle)提供了海量实战项目,学习者可通过参与"泰坦尼克生存预测""房价预测"等经典案例,快速积累可展示的作品集,为职业跃迁奠定基础。
针对Python数据分析或机器学习入门,推荐两本极具实操价值的图书:
-
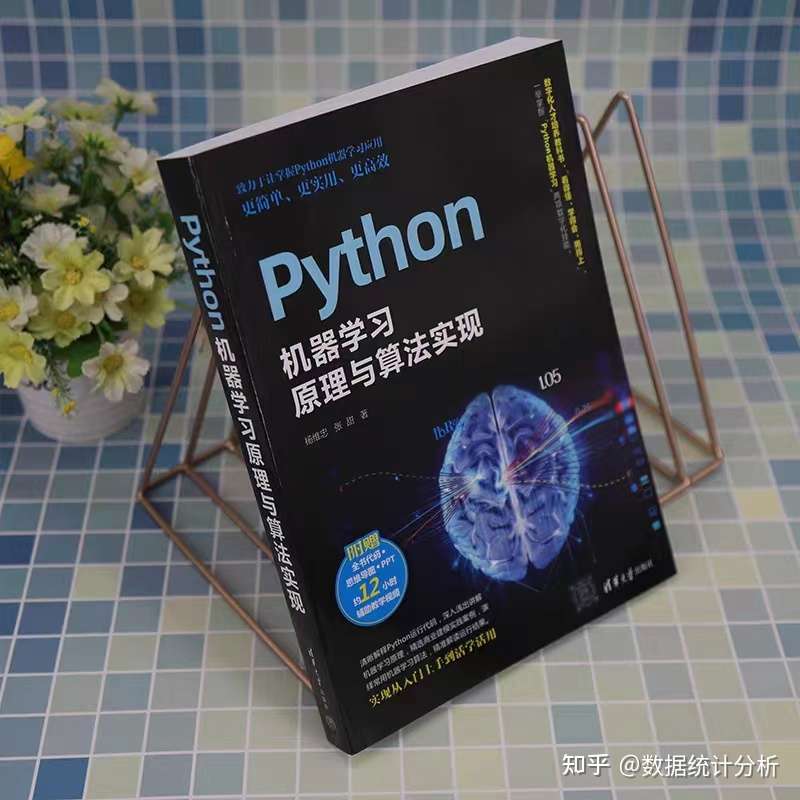
《Python机器学习原理与算法实现》(杨维忠、张甜,清华大学出版社,2023年2月)
该书以"理论精简+代码详解"为特色,通过490个代码示例逐行解析算法实现细节。例如在决策树章节,不仅展示
sklearn.tree.DecisionTreeClassifier的调用方法,更通过可视化代码揭示信息增益的计算过程。书中特别设置"避坑指南"专栏,针对新手常见的维度灾难、过拟合等问题提供解决方案,适合零基础读者通过"复制-修改-创新"三步法快速上手。 -
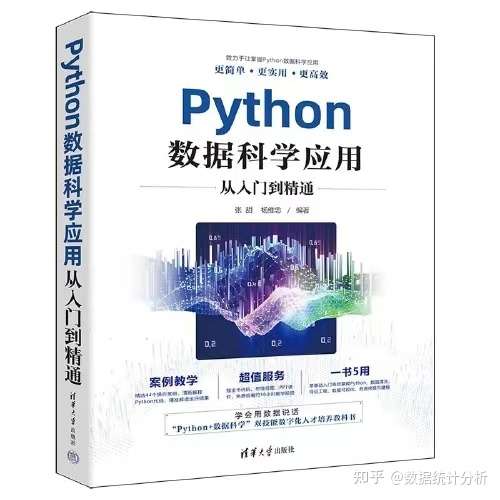
《Python数据科学应用从入门到精通》(张甜、杨维忠,清华大学出版社,2023年11月)
该书构建了"数据获取-清洗-分析-建模"的完整知识链,独创"业务场景驱动"学习框架。例如在电商用户分析章节,先解析RFM模型理论,再通过
pandas.cut实现用户分群,最后构建用户模型。书中附赠10小时配套视频,演示如何将模型结果转化为Tableau可视化看板,帮助学习者跨越"算法理解"到"业务落地"的鸿沟。
这两本著作均采用"问题导向"编写逻辑,每章设置企业真实案例(如银行信贷风险评估、在线旅游用户分类),使读者在解决具体问题的过程中自然掌握特征工程、模型调优等核心技能。更值得关注的是,书中代码均经过工业级验证,可直接迁移至实际工作场景,真正实现"学完即用"的学习目标。对于希望快速切入AI领域的非科班从业者而言,这套组合堪称性价比最高的学习方案——既避免了陷入数学公式的泥潭,又通过系统化的项目实践构建完整的技术闭环。
针对 Python 数据分析或机器学习推荐两本入门级的图书:《Python 机器学习原理与算法实现》(杨维忠 张甜 著 2023 年 2 月新书 清华大学出版社)《Python 数据科学应用从入门到精通》(张甜 杨维忠 著 2023 年 11 月新书 清华大学出版社)。这两本书的特色是在数据分析、机器学习各种算法的介绍方面通俗易懂,较少涉及数学推导,对数学基础要求相对不高,在 Python 代码方面讲的很细致,看了以后根据自身需要选取算法、优化代码、科学调参。都有配套免费提供的源代码、数据文件和视频讲解,也有 PPT、思维导图、习题等。
为什么说这两本书值得?首先说《Python 机器学习原理与算法实现》(杨维忠 张甜 著 2023 年 2 月新书 清华大学出版社),内容非常详实,包含了 Python 和机器学习,相当于一次获得了两本书。在讲解各类机器学习算法时,逐一详解用到的各种 Python 代码,针对每行代码均有恰当注释(这一点基本上是大多数书目做不到的)。很多银行员工通过这些学习一下子就学会了 Python,并且用于工作中开展数据分析、机器学习、数据可视化等,这本书也成为银行员工的一本网红书。
全书内容共 17 章。第 1、2 章介绍 Python 的入门知识和进阶知识;第 3 章介绍机器学习的概念及各种术语及评价标准;第 4~10 章介绍相对简单的监督式学习方法,包括线性回归算法、二元 Logistic 回归算法、多元 Logistic 回归算法、判别分析算法、朴素贝叶斯算法、高维数据惩罚回归算法、K 近邻算法;第 11、12 章介绍主成分分析算法、聚类分析算法两种非监督式学习算法;第 13~15 章介绍相对复杂的监督式学习算法,包括决策树算法和随机森林算法、提升法两种集成学习算法;第 16、17 章介绍支持向量机算法、神经网络算法两种高级监督式学习算法。
《Python 数据科学应用从入门到精通》一书,旨在教会读者实现全流程的数据分析,并且相对《Python 机器学习原理与算法实现》一书增加了很多概念性、科普性的内容,进一步降低了学习难度。
国务院发展研究中心创新发展研究部第二研究室主任杨超 ,山东大学经济学院金融系党支部书记、副主任、副教授、硕士生导师张博,山东管理学院信息工程学院院长 袁锋 教授、硕士生导师,山东大学经济学院刘一鸣副研究员、硕士生导师,得厚投资合伙人张伟民等一众大牛联袂推荐。书中全是干货,买这一本书相当于一下子得到了 5 本书(Python 基础、数据清洗、特征工程、数据可视化、数据挖掘与建模),而且入门超级简单,不需要编程基础,也不需要过多数学推导,非常适用于零基础学生。
全书内容共分 13 章。其中第 1 章为数据科学应用概述,第 2 章讲解 Python 的入门基础知识,第 3 章讲解数据清洗。第 4~6 章介绍特征工程,包括特征选择、特征处理、特征提取。第 7 章介绍数据可视化。第 8~13 章介绍 6 种数据挖掘与建模方法,分别为线性回归、Logistic 回归、决策树、随机森林、神经网络、RFM 分析。从数据科学应用和 Python 的入门,再到数据清洗与特征工程,最终完成数据挖掘与建模或数据可视化,从而可以为读者提供“从拿到数据开始,一直到构建形成最终模型或可视化报告成果”的一站式、全流程指导。
两本书随书赠送的学习资料也很多,包括全部的源代码、PPT、思维导图,还有 10 小时以上的讲解视频,每一章后面还有练习题及参考答案,还有学习群,相对于只看网络上的视频,一方面更加系统、高效,另一方面照着书一步步操作学起来也事半功倍。全网热销中,当当、京东等平台搜索“Python 机器学习 杨维忠”“Python 数据科学 杨维忠”即可。
创作不易,恳请多多点赞,感谢您的支持!也期待大家多多关注我,一起学习数据分析知识。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 17
 0
- 0


 已为社区贡献6条内容

所有评论(0)