登录社区云,与社区用户共同成长
邀请您加入社区
∙Docker:是打包和创建容器的工具。它解决了“应用和环境一起搬运”的问题。∙比喻:负责制造和标准化集装箱。∙:是自动化管理和调度大量容器的平台。它解决了“成千上万个容器如何在集群中高效、可靠地运行”的问题。∙比喻:负责指挥全球的集装箱货轮舰队,决定哪个集装箱放哪艘船、何时出发、如何路由、坏了如何替换。所以,在你之前了解
在过去,很多中小型网站或应用通常选择传统 IDC 机房来托管服务器。这种方式有一定优势,例如物理机器性能可控、单价相对透明,但随着业务的发展,也逐渐暴露出局限。某影视社区的运营者在一次迁移中,分享了他们从传统 IDC 切换到 AWS 云服务的完整经历。
如下图,基于ubuntu镜像创建的容器,返回的是容器的id。重启,命令:‘docker restart’-n显示最近创建的n个容器。-l显示最近创建的容器。-f选项:删除正在运行的容器。-s显示总的文件大小。-a显示所有容器。
在Hadoop集群中,作业调度策略是决定资源分配效率和业务SLA保障的核心机制。随着集群规模扩大和业务多样性增加,如何选择合适的调度器成为提升集群利用率和满足业务需求的关键。本文将系统剖析Hadoop的作业调度策略,对比各类调度器的适用场景,并结合实际项目经验提供选型指南与优化方案。
将数据划分为4个阶段:热数据(0-7天)、温数据(8-30天)、冷数据(31-90天)、归档数据(90天以上),分别对应不同的副本策略。
在分布式计算中,数据的物理位置直接决定了系统性能的上限。Hadoop的核心设计哲学之一就是"移动计算而非移动数据",这一理念通过数据本地化机制得以实现。本文将系统剖析Hadoop数据本地化的实现原理、调度策略及在大规模集群中的优化实践,为资深工程师提供全面的技术参考。
自定义InputFormat类,继承FileInputFormat重写getSplits()方法实现分片逻辑实现对应的RecordReader处理分片数据@Override// 1. 获取输入文件列表// 2. 自定义分片逻辑// 实现业务特定的分片逻辑@Override// 自定义文件分片方法// 实现具体的分片逻辑// ...// 自定义InputSplit// 实现自定义分片属性和方法//
在阿里、字节等大厂的PB级大数据集群中,Hadoop负载均衡是保障集群资源利用率、避免单点过载、提升任务执行效率的核心能力。不同于传统单机负载均衡,Hadoop的负载均衡贯穿与,需结合分布式架构特性实现“数据与计算的协同均衡”。本文从核心机制、策略拆解、实战落地三个维度,系统剖析Hadoop负载均衡的实现逻辑。
容器技术已成为现代软件开发和部署的重要组成部分。本文介绍了容器技术的基本原理,包括Linux内核中的命名空间和控制组等核心机制,并对比分析了LXC与Docker两种主流容器工具的特点和使用方法。文章详细阐述了容器化的优势,如环境一致性、轻量级和隔离性等,同时提供了创建、运行和管理容器的具体命令示例。针对常见问题,文章解答了容器与虚拟机的区别、数据持久化等关键问题,并给出了使用Dockerfile、
项目基于springboot2.1.6.RELEASE+Dubbo2.7.3 来构建微服务。业务模块划分,尽量贴合互联网公司的架构体系。所以,除了业务本身的复杂度不是很高之外,整体的架构基本和实际架构相差无几。但实际上,真实的生产级的项目由于用户量以及业务的复杂度,会变得非常复杂。所以我们会让更多的人参与进来,从需求、设计、解决方案等方面出发来对项目进行迭代,从而培养出一定的实际解决方案的经验和能
下一代Spark在状态管理方面正朝着更高效、更弹性的方向演进,例如优化状态后端(StateStore)的存储效率与 checkpoint 机制,以支持更大规模的状态和更快的恢复速度。未来的竞争焦点将集中在如何以更低的开销实现跨越多阶段复杂流水线的一致性,以及在故障恢复时提供更细粒度的控制与更快的恢复时间目标(RTO)。未来的演进将侧重于提升在动态资源环境下的稳定性与资源利用率,支持更灵活的多租户隔
前端:Spring+SpringMVC+Mybatis后端:大数据数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!SSM 框架的整合使用,为程序设计带来了诸多优势。在开发过程中,Spring 负责整体的架构管理和资源整合,SpringMVC 处理用户请求和业务逻辑,MyBatis 进行数据的持久化操作。
前端:Spring+SpringMVC+Mybatis,SpringCloud微服务、网关、注册中心等组件,Maven构建项目jar包,内置Tomcat运行Web环境,后端语言Java后端:SpringBoot+Mybatis数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!SpringMVC 在 SSM
与此前版本的 Admin 的支持方式不同,新版本中将注册中心作为一个“隔离域”,所有的资源(应用/服务/实例/规则等)都会规约到一个注册中心下面,切换注册中心就相当于切换一个“隔离域”,这也契合大多数企业在生产实践中的使用方式。此外,得益于 client-go 的 informer 机制,新版本中对注册中心/K8s 的监听使用 list-watch 模型进行了统一,所有的资源都以事件的方式进行异步
本文深入探讨了Web容器的关键技术与实践,通过案例分析展示了Web容器在实际应用中的价值。随着Web技术的飞速发展,Web容器作为支撑各类Web应用的核心组件,其重要性日益凸显。本文将带领大家深入探索Web容器的内涵,分析其关键技术,并通过实践指导大家如何发散创新,优化Web容器的设计与实现。Web容器是一种运行Web应用的环境,它提供了Web应用运行所需的各类服务,如网络通信、资源管理、安全控制
在高并发场景下,未经优化的Java微服务可能面临响应延迟、资源竞争和内存泄漏等问题,因此需从代码、运行时及基础设施多个层面进行系统性优化。对于有序数据,可采用TreeMap实现自动排序,避免手动排序的开销。对于低延迟要求的服务,可选用ZGC或ShenandoahGC,实现毫秒级停顿时间。开发团队需定期进行性能优化培训,培养性能优先的编码习惯。通过混沌工程测试系统在异常条件下的性能表现,构建高可用的
前端:Django、Python Web框架,后端语言Python后端:Spring+SpringMVC+Mybatis数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!在程序设计的安全性方面,Django 提供了多种保障措施。它自动处理 SQL 注入、跨站脚本攻击等常见的安全问题,确保程序的安全性。程序
文章摘要:本文探讨容器化技术的创新部署方法,提出四种提升效率、安全性和可管理性的"新玩法":1)多阶段构建实现"构建即部署",精简镜像并增强安全;2)采用声明式GitOps工作流确保环境一致性;3)Rootless容器与用户命名空间隔离降低安全风险;4)不可变基础设施结合临时调试容器保障运行时安全。这些实践通过优化镜像构建、自动化部署、权限控制和调试方式,为
大家好,那天家里领导在想他们初中托管机构的宣传词,突然词穷了,就把任务安排给我。
采用“管理Bot+专业Bot”架构[11]:管理Bot:接收用户请求,通过意图识别分发给子Agent(如财务Bot、客服Bot)[11]。子Agent:独立处理专项任务(如财务Bot调用ERP插件生成报表)[11]。:通过共享内存(Shared Memory)实现任务进度和中间结果传递,避免重复执行[130]。:预设关键词触发Agent切换(如用户输入“预算审批”自动跳转至财务Bot)[121]。
卷存储是主机文件系统的一部分,这部分由Docker管理,在Linux主机上默认是/var/lib/docker/volumes目录。执行命令启动一个运行nginx容器,并使用容器的/usr/share/nginx/html目录内容填充新卷nginx-vol。卷支持使用卷驱动,卷驱动允许用户将数据存储在远程主机、云提供商,以及其他位置上可以以匿名方式或命名方式挂载卷。启动一个容器,并将test-vo
Dubbo 是高性能的 RPC 框架,允许服务调用者像调用本地方法一样调用远程服务。核心功能:服务注册与发现服务暴露负载均衡容错和集群管理高效的远程调用协议。
相比之下,如果采用1.5倍扩容,容量会变成非2的幂次方(如100→150),索引计算必须使用取模运算,且元素迁移规则会变得复杂——每个元素的新索引可能是任意值,需要重新计算哈希值并取模,这会让扩容时间大幅增加。在扩容时的数据迁移环节,2倍扩容的优势更加明显。Java的设计者并没有试图找到一个“万能倍数”,而是承认场景的多样性,为不同数据结构定制不同策略——这种“不追求完美,只追求适配”的思维,恰恰
从数据准备到模型部署,Keras提供了一整套简洁而强大的工作流。通过本指南的步骤,您可以系统地掌握使用TensorFlow和Keras进行深度学习模型开发的核心技能。实践是学习的关键,建议读者选择自己感兴趣的数据集,亲手搭建和训练模型,并在过程中不断调试和优化,从而深入理解深度学习的强大能力。
总而言之,TensorFlow 2.x中的Eager Execution模式是一场深刻的范式转移,它彻底改变了深度学习的开发范式。它将TensorFlow从一个相对晦涩、需要复杂预定义的框架,转变为一个直观、灵活、易于使用的强大工具。
SpringCloud与Dubbo微服务架构对比分析 SpringCloud基于Spring生态,提供一站式微服务解决方案,支持HTTP协议,功能全面但性能略低,适合复杂企业级应用。Dubbo专注高性能RPC调用,采用二进制协议,服务治理能力强,更适合内部高频核心服务场景。选型需考虑技术栈、性能需求及业务场景,未来二者可能趋向融合。两者各有优势,开发者应根据项目需求合理选择。
器云平台作为支撑业务创新和快速发展的关键基础设施,其稳定性和可靠性对于整个集团的业务连续性至关重要。面对日益增长的业务需求和不断变化的技术环境,对容器云平台的质量加固工作提出了更高的要求。在本方案中,我们详细分析了当前平台面临的挑战,并提出了一系列针对性的质量提升措施。通过降低故障频次、缩短故障恢复时间、提高服务可用性等方向的努力,我们旨在构建一个更加健壮、高效和可靠的容器云平台。这些措施不仅能够
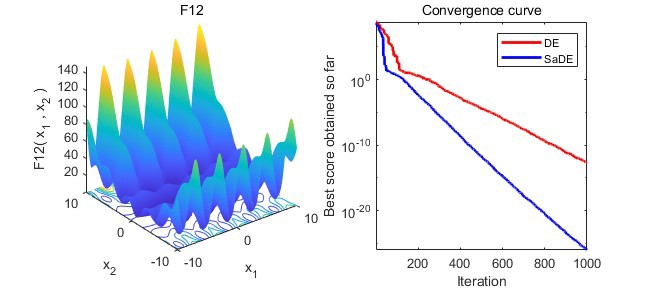
在智能优化算法的江湖里,差分进化(DE)就像一位基本功扎实的剑客,而它的升级版自适应差分进化(SaDE)则更像精通变招的宗师。这三个函数构成了DE的进化引擎。而自适应差分进化算法 (SaDE)算法是差分进化的一个变种,其主要特点是引入了自适应机制来动态调整算法参数(例如变异和交叉概率)。总的来说,DE是一种经典的全局优化算法,而SaDE是在DE基础上引入自适应机制来提高算法性能和适应性的一种改进算
前端:Spring+SpringMVC+Mybatis后端:大数据数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!SpringMVC 在 SSM 中扮演着重要的角色。它实现了经典的 MVC 设计模式,将业务逻辑与视图展示分离得更加清晰。程序设计者可以通过 SpringMVC 方便地处理用户请求,进行数据