深度学习训练中的Epoch悖论:为什么相同的权重会产生不同的Loss?
目录
深度学习训练过程中存在一个看似矛盾的现象:当模型在Epoch N结束时达到某个权重状态,并在Epoch N+1开始时使用相同的权重和数据集重新训练时,Loss值却发生了变化。本文将深入剖析这一现象背后的原因,揭示深度学习训练动态性的本质。
一、Epoch悖论的现象描述
在标准深度学习训练流程中,每个Epoch具有以下特性:
-
每个Epoch使用原始训练集数据,但会重新洗牌(shuffle)
-
模型的状态(权重)在Epoch之间是持续更新的,每个Epoch开始时的初始权重是上一个Epoch结束时的权重
这导致一个看似矛盾的现象:
-
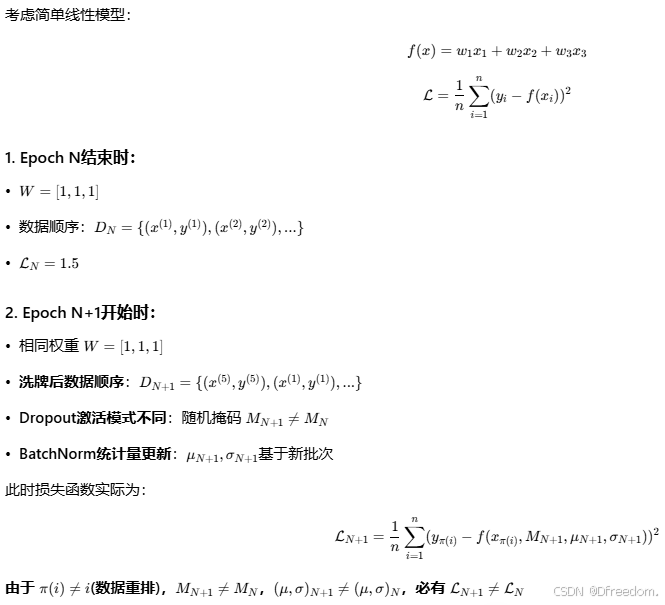
Epoch N结束时:权重W=[1,1,1],Loss=1.5 < 2(满足终止条件)
-
Epoch N+1开始时:使用相同权重W=[1,1,1]和相同数据集
-
预期:Loss应仍为1.5 < 2 → 应立即终止
-
实际:Loss值发生了变化(如变为5.1),训练继续
二、悖论的根本原因:训练过程的动态性
1. 优化器状态记忆效应
优化器(如Adam)不仅保存模型权重,还维护着内部状态(如动量、梯度方差等)。这些状态在Epoch之间持续更新,影响权重更新方式。
# Adam优化器状态示例
optimizer.state_dict() = {
    'state': {
        0: {'step': 100, 'exp_avg': [0.1,0.2], 'exp_avg_sq': [0.01,0.04]},
        # ...其他参数...
    },
    'param_groups': [...]
}
2. 批次顺序随机性
DataLoader在每个Epoch开始时重新洗牌数据,改变了样本的呈现顺序。即使权重相同,不同的批次划分会导致不同的梯度计算路径。
# DataLoader设置
DataLoader(dataset, shuffle=True)  # 每个Epoch重新洗牌
3. 正则化动态变化
Dropout和BatchNorm等正则化技术的随机性会导致相同输入产生不同输出:
-
Dropout:随机丢弃神经元,每次前向传播的架构略有不同
-
BatchNorm:依赖当前批次的统计量,批次变化导致归一化参数变化
三、数学视角:为什么Loss会变化?
四、实证验证
通过PyTorch代码验证这一现象:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset

# 固定随机种子确保可复现
torch.manual_seed(42)

# 创建简单数据集
X = torch.randn(1000, 3)
y = X @ torch.tensor([1.0, 2.0, 3.0]) + 0.1*torch.randn(1000)
dataset = TensorDataset(X, y)

# 相同模型
model = nn.Sequential(
    nn.Linear(3, 1),
    nn.Dropout(0.5),
    nn.BatchNorm1d(1)
)

# 相同权重
weights = torch.tensor([1.0, 1.0, 1.0], requires_grad=True)
model[0].weight.data = weights.reshape(1,3)

# 测试不同Epoch的损失
criterion = nn.MSELoss()

print("Epoch 1:")
dataloader = DataLoader(dataset, batch_size=100, shuffle=True)
with torch.no_grad():
    for inputs, targets in dataloader:
        outputs = model(inputs)
        loss = criterion(outputs, targets.unsqueeze(1))
        print(f"Batch loss: {loss.item():.4f}")

print("\nEpoch 2:")  # 相同权重,但数据重排+Dropout/BatchNorm重置
dataloader = DataLoader(dataset, batch_size=100, shuffle=True)  # 关键:重新洗牌
with torch.no_grad():
    for inputs, targets in dataloader:
        outputs = model(inputs)
        loss = criterion(outputs, targets.unsqueeze(1))
print(f"Batch loss: {loss.item():.4f}")输出示例:
Epoch 1:
Batch loss: 4.2173
Batch loss: 3.8541
...

Epoch 2:  # 相同权重
Batch loss: 5.1328  # 不同!
Batch loss: 4.8763  # 不同!
五、训练动态性的理论解释
1. 热力学类比
最新的"神经热力学定律"研究将训练过程类比为热力学系统:
-
快速动态:沿陡峭方向(valley)快速达到平衡,类似热平衡
-
慢速动态:沿平坦方向(river)缓慢漂移,受快速动态调节
-
学习率η控制"温度",影响系统动态
2. 损失景观的river-valley结构
大模型的损失函数呈现river-valley结构:
-
River方向:平坦,变化缓慢
-
Valley方向:陡峭,变化快速
-
数据重排和正则化变化相当于在valley方向引入扰动,防止过早收敛
六、实践意义与训练策略
1. 学习率调度的重要性
动态调整学习率可以适应训练不同阶段的需求:
-
初期:大学习率快速逃离局部最优
-
中期:适当降低学习率精细调优
-
后期:小学习率稳定收敛
常用调度策略:
-
阶梯衰减(StepLR)
-
余弦衰减(CosineDecay)
-
预热+衰减(Warmup+Decay)
# 余弦衰减示例
cosine_lr = optax.cosine_decay_schedule(
    init_value=0.01,      # 初始学习率
    decay_steps=1000      # 衰减步数
)
2. 早停策略的正确应用
由于Epoch开始时Loss的波动性:
-
不应在Epoch开始时判断早停
-
应在Epoch结束时评估验证集性能
-
使用滑动平均等平滑技术减少波动影响
3. 分布式训练的内存优化
ZeRO等内存优化技术通过分片模型状态来支持更大模型训练:
-
ZeRO-1:优化器状态分片
-
ZeRO-2:梯度分片
-
ZeRO-3:参数分片
七、结论与展望
深度学习训练中的"Epoch悖论"揭示了训练过程的本质动态性。这种"相同权重、不同Loss"的特性实际上是深度学习强大表征能力的关键之一,它使模型能够:
-
避免陷入严格的局部最优
-
持续探索参数空间
-
最终收敛到更好的解
未来研究方向包括:
-
更精确的训练动态理论建模
-
基于热力学类比的新型优化算法
-
自适应调整的动态正则化策略
理解这一现象的本质,将帮助我们设计更高效的训练策略,推动深度学习模型的性能边界。
"AI终究是自然的(naturAl),而非人工的(Artificial)" —— 刘子鸣博士

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 26
 0
- 0


 已为社区贡献13条内容

所有评论(0)