【万字解析—小白也能上手的大模型实践:2 小时从零训练 26M 超轻量 MiniMind,详解部署全流程与实战避坑指南】
一、项目介绍:什么是 MiniMind?
1.1 项目核心目标
项目开源地址:jingyaogong/minimind: 🚀🚀 「大模型」2小时完全从0训练26M的小参数GPT!🌏 Train a 26M-parameter GPT from scratch in just 2h!
MiniMind 是一个旨在 "降低大模型学习门槛" 的开源项目,核心目标是让普通人仅用 2 小时 + 低成本服务器(最低 3 元),就能从 0 训练出一个仅 25.8M 参数的超轻量语言模型。不同于市面上动辄百亿参数的 "巨无霸" 模型,MiniMind 系列以 "极简" 为特色:最小版本体积仅为 GPT-3 的 1/7000,普通个人 GPU 即可轻松训练,堪称 "大模型入门的最佳实践样本"。
1.2 项目核心优势
- 全流程开源:包含从模型结构(基础 Dense + 拓展 MoE 混合专家)、数据集清洗,到预训练(Pretrain)、监督微调(SFT)、LoRA 微调、DPO 强化学习、模型蒸馏的完整代码,且全部基于 PyTorch 原生实现,不依赖第三方库的抽象接口,真正做到 "白盒可解释"。
- 轻量易部署:最小模型仅 26M 参数,推理时仅占用 0.5GB 内存,兼容 llama.cpp、vllm、ollama 等主流推理引擎,甚至可部署在普通笔记本上。
- 学习价值高:不仅是可运行的模型,更是一套完整的 LLM 入门教程。通过亲手训练,能深入理解 Transformer 结构、分词器原理、强化学习对齐等核心技术,避免 "只会调用 API" 的表层学习。
1.3 为什么要选择 MiniMind?
大语言模型(LLM)的热潮下,ChatGPT、DeepSeek 等模型虽强大,但数百亿参数的规模让个人难以触及 —— 不仅训练需要巨额资源,甚至连部署都需专业硬件。多数学习者只能停留在 "用 LoRA 微调现有模型" 的阶段,如同 "只会用手机却不懂通信原理"。
而 MiniMind 的出现打破了这一壁垒:它用极简代码复现了 LLM 的全生命周期,让普通人能从 "0 到 1" 体验模型训练的完整流程。正如项目作者所说:"用乐高拼出一架飞机,远比坐在头等舱里飞行更让人兴奋!"
1.4 已发布模型列表
截至 2025 年 4 月,MiniMind 系列已包含多个型号,满足不同场景需求:
| 模型名称 | 参数规模 | 推理内存占用 | 发布时间 |
|---|---|---|---|
| MiniMind2-small | 26M | 0.5 GB | 2025.04.26 |
| MiniMind2-MoE | 145M | 1.0 GB | 2025.04.26 |
| MiniMind2 | 104M | 1.0 GB | 2025.04.26 |
| minimind-v1-small | 26M | 0.5 GB | 2024.08.28 |
| minimind-v1-moe(4×26M) | 约 104M | 1.0 GB | 2024.09.17 |
| minimind-v1 | 108M | 1.0 GB | 2024.09.01 |
二、部署环境:软硬件配置说明
2.1 硬件配置(服务器租用参考)
本次部署使用的服务器配置如下,有想使用该服务器的可私信我,供新手参考(非强制,更低配置也可尝试):
| 组件 | 规格详情 | 性能说明 |
|---|---|---|
| CPU | Intel Xeon E5-2673 v4(16 核 @2.3GHz) | 16 核处理器满足数据预处理和模型并行需求 |
| 内存 | 62GB DDR4(可用 48GB) | 充足内存避免数据加载时 OOM(内存占用率仅 19%) |
| GPU | 2×Tesla P40(24GB 显存 / 卡) | 单卡 24GB 显存可支持 26M 模型训练,双卡可加速 |
| 存储 | 1TB SSD(可用 697GB) | 高速存储保障数据集读写效率(使用率仅 28%) |
注意事项:部署时需注意 GPU 负载均衡,笔者服务器中 GPU0 负载常达 99.7%(接近满载),建议优先使用负载较低的 GPU1(12% 占用)。
在这里给大家推荐一个专为程序员和运维人员量身打造的一站式开发运维利器:hexhub,它可以同时支持数据库开发、SSH 以及 RDP 远程连接、SFTP 文件传输以及 Docker 面板管理。
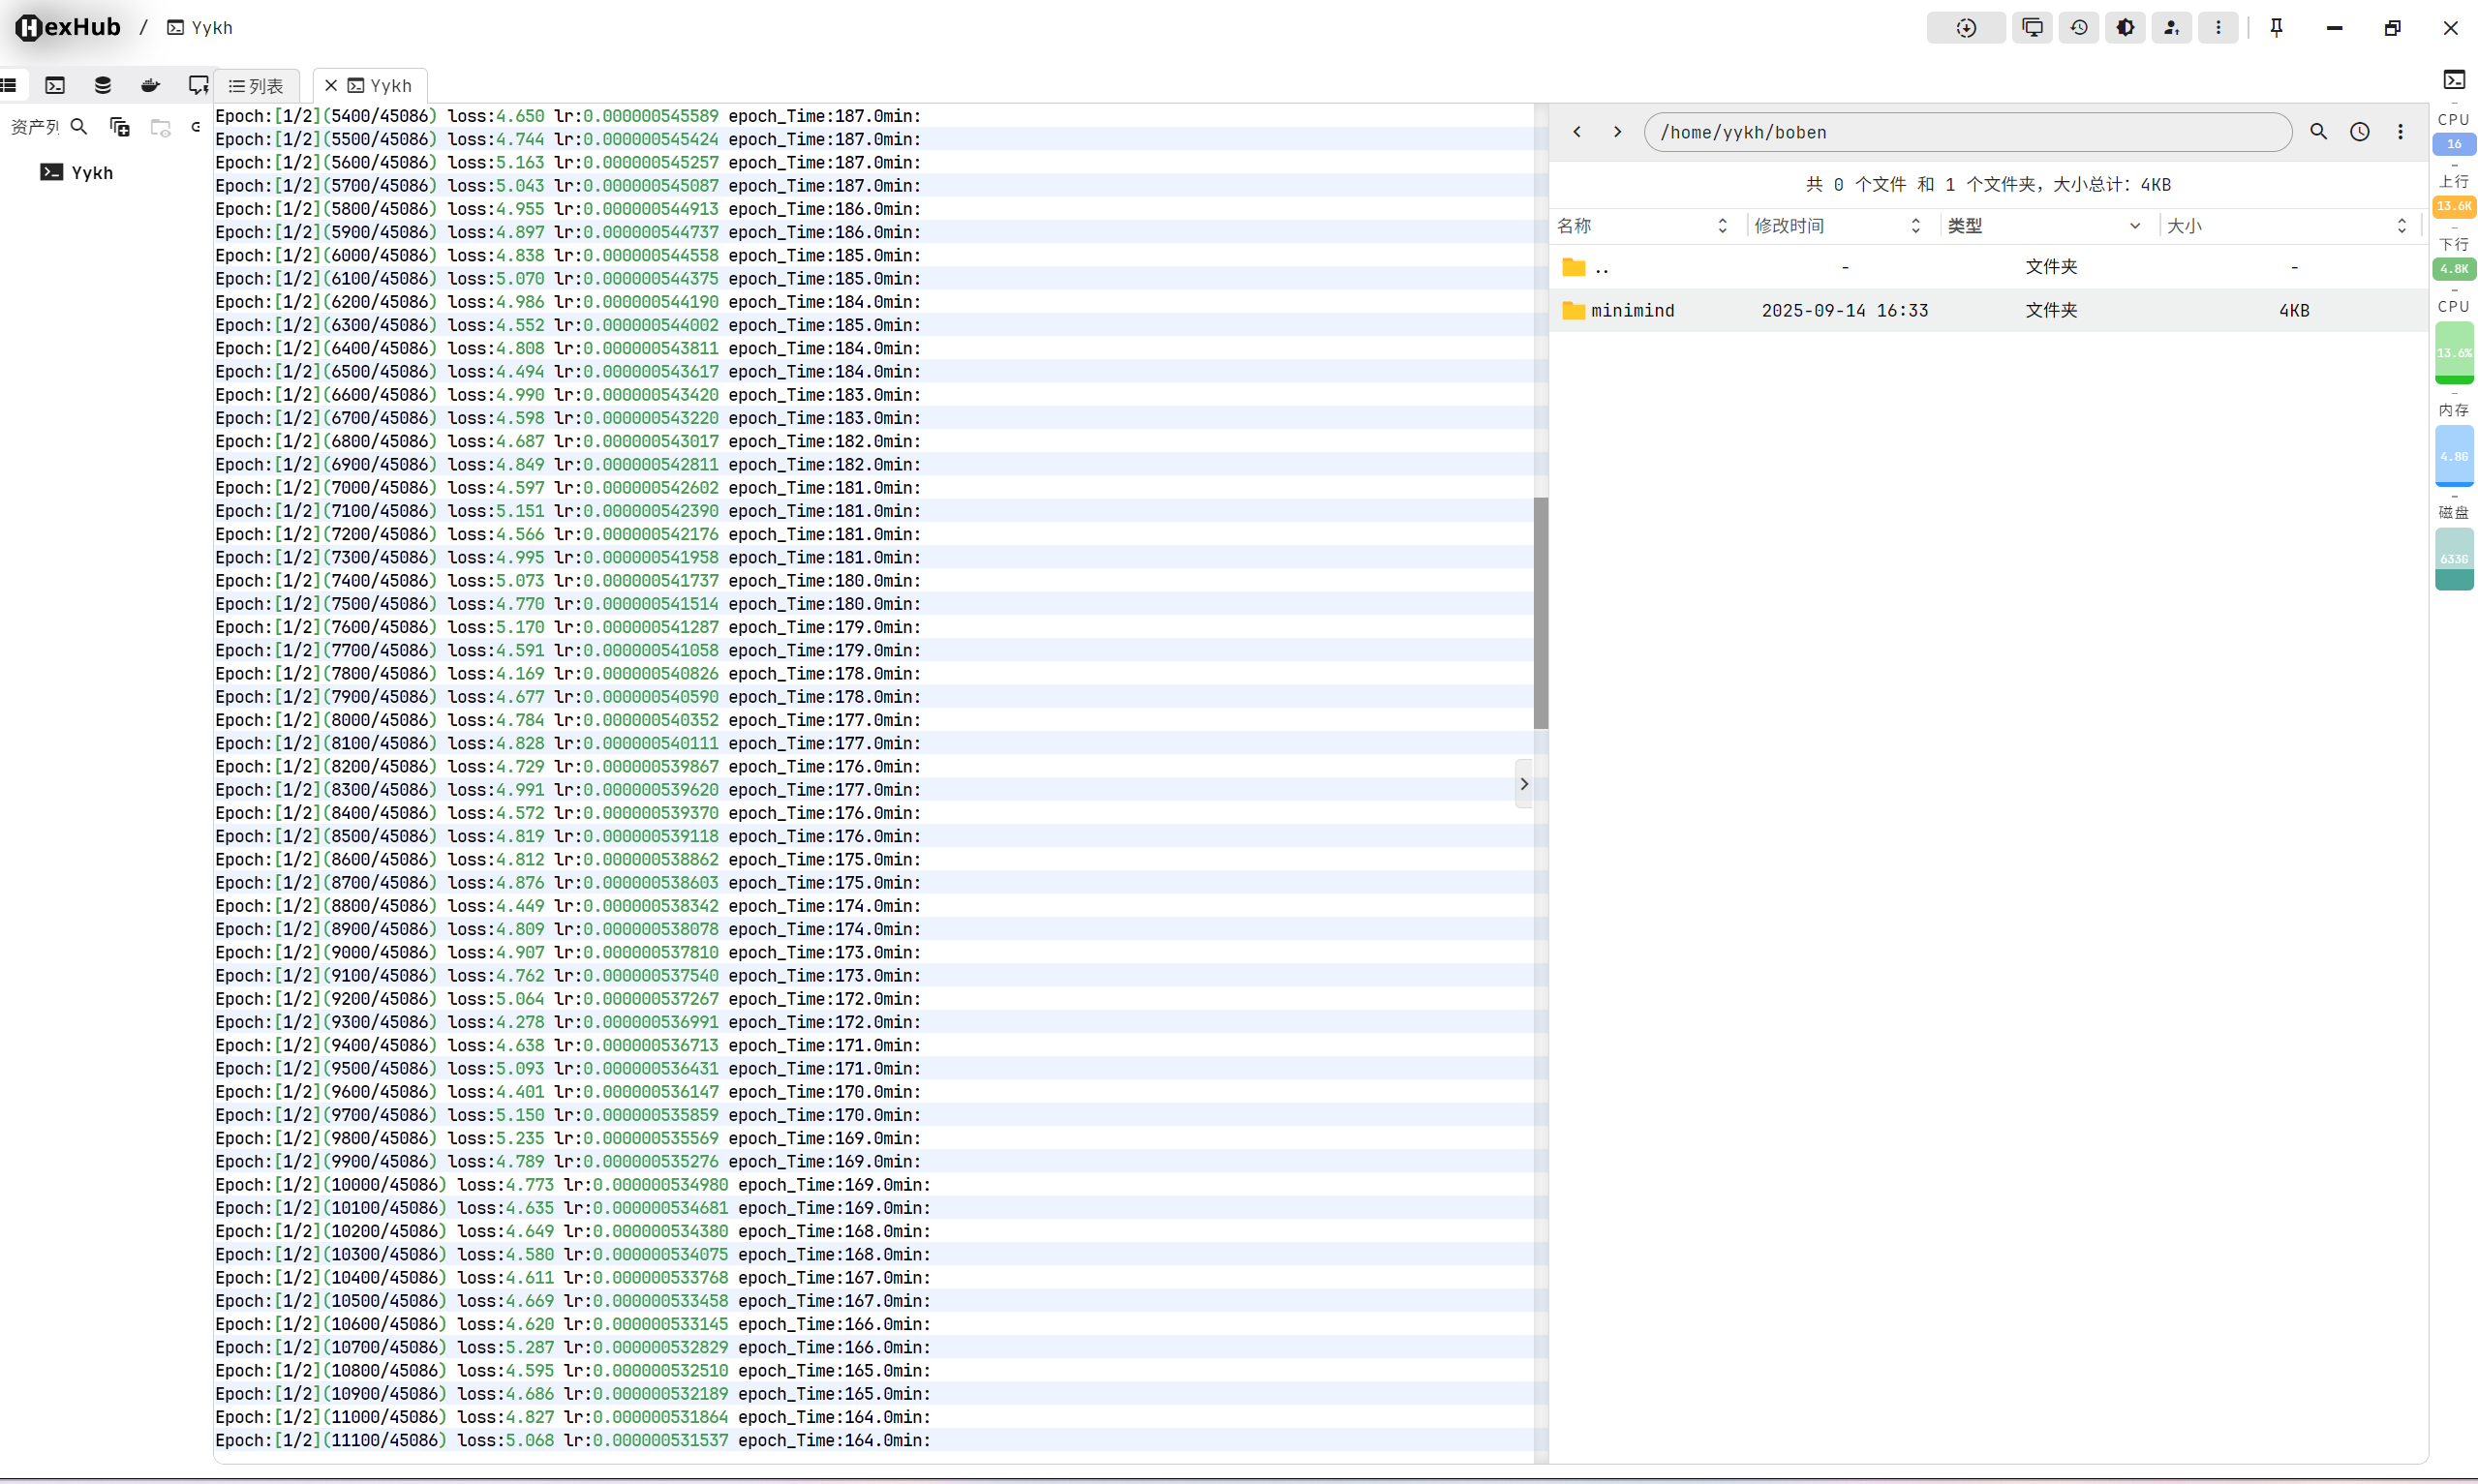
2.2 软件环境配置
- 操作系统:Ubuntu 18.04.6 LTS
- 内核版本:5.4.0-150-generic
- CUDA 版本:12.0(需与 PyTorch 版本匹配)
- 驱动版本:525.105.17
- 核心依赖:PyTorch 2.0.1、transformers 4.36.2、tokenizers 0.15.0 等(建议通过虚拟环境隔离,避免版本冲突)
三、部署全流程:从克隆项目到模型训练
3.1 项目准备
3.1.1 克隆代码仓库
首先通过 Git 克隆项目到本地服务器:
git clone https://github.com/jingyaogong/minimind.git
cd minimind
3.1.2 数据集下载与整理
MiniMind 的训练依赖多个阶段的数据集,需通过 ModelScope 下载(需提前安装 modelscope 库)。下载命令格式如下:
# 示例:下载README.md到指定目录
modelscope download --dataset gongjy/minimind_dataset README.md --local_dir ./dir核心数据集清单(放置于./dataset/目录):
| 文件名 | 大小 | 作用 | 优先级 |
|---|---|---|---|
| pretrain_hq.jsonl | 1.6GB | 预训练核心数据 | ✨必选 |
| sft_mini_512.jsonl | 1.2GB | 轻量监督微调数据 | ✨必选 |
| dpo.jsonl | 909MB | DPO 强化学习数据 | 可选 |
| r1_mix_1024.jsonl | 340MB | 推理蒸馏数据 | 可选 |
| tokenizer_train.jsonl | 1GB | 分词器训练数据 | 必选 |
推荐组合:新手优先下载pretrain_hq.jsonl+sft_mini_512.jsonl,可最快复现基础聊天模型。
3.2 预训练:让模型 "学会语言"
预训练是模型的 "基础教育" 阶段,目标是让模型从海量文本中学习语言规律(语法、词汇关联、连贯性等)。
3.2.1 前置步骤:训练分词器
分词器是大模型的 "语言字典"—— 它负责将人类可理解的自然语言(如中文、英文)转换为模型能处理的数字序列(token id),同时也能将模型输出的数字序列转回自然语言。在预训练大模型前,必须先有这个 "字典",否则模型无法 "读懂" 文本。
分词器是模型的 "语言字典",必须在预训练前生成。执行以下命令:
cd scripts
python train_tokenizer.py
train_tokenizer.py源码如下:
import random
import json
from tokenizers import (
    decoders,
    models,
    pre_tokenizers,
    trainers,
    Tokenizer,
)
import os

random.seed(42)


def train_tokenizer():
    # 读取JSONL文件并提取文本数据
    def read_texts_from_jsonl(file_path):
        with open(file_path, 'r', encoding='utf-8') as f:
            for line in f:
                data = json.loads(line)
                yield data['text']

    data_path = '../dataset/pretrain_hq.jsonl'

    # 初始化tokenizer
    tokenizer = Tokenizer(models.BPE())
    tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)

    # 定义特殊token
    special_tokens = ["<|endoftext|>", "<|im_start|>", "<|im_end|>"]

    # 设置训练器并添加特殊token
    trainer = trainers.BpeTrainer(
        vocab_size=6400,
        special_tokens=special_tokens,  # 确保这三个token被包含
        show_progress=True,
        initial_alphabet=pre_tokenizers.ByteLevel.alphabet()
    )

    # 读取文本数据
    texts = read_texts_from_jsonl(data_path)

    # 训练tokenizer
    tokenizer.train_from_iterator(texts, trainer=trainer)

    # 设置解码器
    tokenizer.decoder = decoders.ByteLevel()

    # 检查特殊token的索引
    assert tokenizer.token_to_id("<|endoftext|>") == 0
    assert tokenizer.token_to_id("<|im_start|>") == 1
    assert tokenizer.token_to_id("<|im_end|>") == 2

    # 保存tokenizer
    tokenizer_dir = "../model/"
    os.makedirs(tokenizer_dir, exist_ok=True)
    tokenizer.save(os.path.join(tokenizer_dir, "tokenizer.json"))
    tokenizer.model.save("../model/")

    # 手动创建配置文件
    config = {
        "add_bos_token": False,
        "add_eos_token": False,
        "add_prefix_space": False,
        "added_tokens_decoder": {
            "0": {
                "content": "<|endoftext|>",
                "lstrip": False,
                "normalized": False,
                "rstrip": False,
                "single_word": False,
                "special": True
            },
            "1": {
                "content": "<|im_start|>",
                "lstrip": False,
                "normalized": False,
                "rstrip": False,
                "single_word": False,
                "special": True
            },
            "2": {
                "content": "<|im_end|>",
                "lstrip": False,
                "normalized": False,
                "rstrip": False,
                "single_word": False,
                "special": True
            }
        },
        "additional_special_tokens": [],
        "bos_token": "<|im_start|>",
        "clean_up_tokenization_spaces": False,
        "eos_token": "<|im_end|>",
        "legacy": True,
        "model_max_length": 32768,
        "pad_token": "<|endoftext|>",
        "sp_model_kwargs": {},
        "spaces_between_special_tokens": False,
        "tokenizer_class": "PreTrainedTokenizerFast",
        "unk_token": "<|endoftext|>",
        "chat_template": "{% if messages[0]['role'] == 'system' %}{% set system_message = messages[0]['content'] %}{{ '<|im_start|>system\\n' + system_message + '<|im_end|>\\n' }}{% else %}{{ '<|im_start|>system\\nYou are a helpful assistant<|im_end|>\\n' }}{% endif %}{% for message in messages %}{% set content = message['content'] %}{% if message['role'] == 'user' %}{{ '<|im_start|>user\\n' + content + '<|im_end|>\\n<|im_start|>assistant\\n' }}{% elif message['role'] == 'assistant' %}{{ content + '<|im_end|>' + '\\n' }}{% endif %}{% endfor %}"
    }

    # 保存配置文件
    with open(os.path.join(tokenizer_dir, "tokenizer_config.json"), "w", encoding="utf-8") as config_file:
        json.dump(config, config_file, ensure_ascii=False, indent=4)

    print("Tokenizer training completed and saved.")


def eval_tokenizer():
    from transformers import AutoTokenizer

    # 加载预训练的tokenizer
    tokenizer = AutoTokenizer.from_pretrained("../model/")

    messages = [
        {"role": "system", "content": "你是一个优秀的聊天机器人,总是给我正确的回应!"},
        {"role": "user", "content": '你来自哪里?'},
        {"role": "assistant", "content": '我来自地球'}
    ]
    new_prompt = tokenizer.apply_chat_template(
        messages,
        tokenize=False
    )
    print(new_prompt)

    # 获取实际词汇表长度(包括特殊符号)
    actual_vocab_size = len(tokenizer)
    print('tokenizer实际词表长度:', actual_vocab_size)

    model_inputs = tokenizer(new_prompt)
    print('encoder长度:', len(model_inputs['input_ids']))

    input_ids = model_inputs['input_ids']
    response = tokenizer.decode(input_ids, skip_special_tokens=False)
    print('decoder和原始文本是否一致:', response == new_prompt)


def main():
    train_tokenizer()
    eval_tokenizer()


if __name__ == '__main__':
    main()
下面结合代码,详细解释分词器的训练过程和核心知识点:
(1)分词器的核心是 "分词算法",这里选择了 BPE(Byte Pair Encoding,字节对编码),这是大模型中最常用的分词算法之一:
# 初始化BPE模型的分词器
tokenizer = Tokenizer(models.BPE())
# 设置预分词器:按字节级别处理文本(支持多语言,包括中文)
tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)- BPE 算法原理:从单个字符(字节)开始,不断合并语料中出现频率最高的字符对,最终形成包含单个字符、常用词、词根等的词表(例如 "学习" 可能被合并为一个 token,而罕见词可能拆分为多个字符 token)。
- ByteLevel 预分词:先按字节分割文本(如中文每个字对应 2-3 个字节),再交给 BPE 合并,确保所有字符(包括生僻字、符号)都能被处理。
(2)分词器训练需要指定词表大小和特殊标记:
# 定义特殊token(模型对话/文本处理的"控制符")
special_tokens = ["<|endoftext|>", "<|im_start|>", "<|im_end|>"]

# 配置BPE训练器
trainer = trainers.BpeTrainer(
    vocab_size=6400,  # 词表总大小(包含特殊token)
    special_tokens=special_tokens,  # 强制包含特殊token
    show_progress=True,  # 显示训练进度
    initial_alphabet=pre_tokenizers.ByteLevel.alphabet()  # 初始字符集(字节级所有可能字符)
)- 词表大小(vocab_size=6400):MiniMind 选择 6400 是为了控制模型体积。词表越小,模型的嵌入层参数越少(嵌入层参数 = 词表大小 × 嵌入维度),避免 "头重脚轻"(嵌入层参数占比过高)。
- 特殊 token 作用:
<|endoftext|>:文本结束标记,同时作为填充符(pad token)。<|im_start|>/<|im_end|>:对话开始 / 结束标记,用于区分用户、助手、系统的消息(如<|im_start|>user表示用户消息开始)。
(3)训练分词器:从语料中学习 "字典":
# 用文本迭代器训练分词器
tokenizer.train_from_iterator(texts, trainer=trainer)
训练过程本质是:让分词器从语料中统计字符对的出现频率,按 BPE 算法不断合并,最终生成包含 6400 个 token 的词表(包括特殊 token 和从语料中学到的普通 token)。
(4)配置解码器与验证:
训练完成后,需要确保分词器能正确 "解码"(将数字转回文本),并验证特殊 token 的位置:
# 设置解码器(与预分词器对应,确保编码/解码一致)
tokenizer.decoder = decoders.ByteLevel()

# 验证特殊token的id是否正确(必须固定为0、1、2,方便后续模型处理)
assert tokenizer.token_to_id("<|endoftext|>") == 0
assert tokenizer.token_to_id("<|im_start|>") == 1
assert tokenizer.token_to_id("<|im_end|>") == 2- 解码器与预分词器匹配(都用 ByteLevel),才能保证 "编码→解码" 过程无损失。
- 特殊 token 的 id 必须固定(如
<|endoftext|>=0),否则模型训练时会混淆填充符、对话标记的含义。
(5)保存分词器:生成可用的 "字典文件":
训练好的分词器需要保存为文件,供后续预训练和推理使用:
tokenizer_dir = "../model/"
os.makedirs(tokenizer_dir, exist_ok=True)
# 保存分词器核心文件
tokenizer.save(os.path.join(tokenizer_dir, "tokenizer.json"))
tokenizer.model.save("../model/")

# 手动创建配置文件(定义分词器的行为参数)
config = {
    "add_bos_token": False,  # 不自动添加句首标记
    "add_eos_token": False,  # 不自动添加句尾标记
    "pad_token": "<|endoftext|>",  # 填充符
    "bos_token": "<|im_start|>",  # 句首标记(对话场景用)
    "eos_token": "<|im_end|>",  # 句尾标记(对话场景用)
    "model_max_length": 32768,  # 最大序列长度
    "chat_template": "..."  # 对话格式模板(确保对话按固定格式编码)
}
with open(os.path.join(tokenizer_dir, "tokenizer_config.json"), "w", encoding="utf-8") as f:
json.dump(config, f, ensure_ascii=False, indent=4)- 保存的文件包括:
tokenizer.json(分词器核心数据)、模型文件(BPE 合并规则)、tokenizer_config.json(行为配置)。 chat_template是对话场景的关键配置,它定义了用户 / 助手 / 系统消息的编码格式(例如用户消息需包裹在<|im_start|>user和<|im_end|>之间)。
训练分词器的本质是从语料中学习一套 "语言映射规则"(词表),让模型能理解自然语言。MiniMind 选择自定义 6400 大小的 BPE 分词器,是为了在模型轻量性和基本功能间取得平衡 —— 小词表降低了模型参数压力,同时通过 ByteLevel 处理保证了多语言兼容性。
这一步是预训练的基础,只有分词器稳定可靠,后续模型训练才能正常进行。
常见问题与解决:
-
报错现象:
json.decoder.JSONDecodeError: Unterminated string starting at: line 1 column 10 (char 9)
原因:pretrain_hq.jsonl中某行存在未闭合的字符串(如引号缺失、转义错误)。
解决:修改train_tokenizer.py中的read_texts_from_jsonl函数,添加错误捕获与跳过逻辑:
def read_texts_from_jsonl(file_path):
    with open(file_path, 'r', encoding='utf-8') as f:
        for line_num, line in enumerate(f, 1):
            line = line.strip()
            if not line:
                continue
            try:
                data = json.loads(line)
                yield data['text']
            except json.JSONDecodeError as e:
                print(f"跳过错误行 {line_num}:{e},内容:{line}")
continue-
成功标志:
../model/目录生成tokenizer.json、tokenizer_config.json等文件,日志显示 "Tokenizer training completed and saved",词表长度为 6400(符合预期)。
3.2.2 执行预训练
回到trainer目录,执行预训练命令(根据硬件调整参数):
cd ../trainer
python train_pretrain.py --hidden_size 512 --num_hidden_layers 8 --max_seq_len 512 --batch_size 8 --epochs 1 --device cuda:0
参数说明:
hidden_size 512:模型隐藏层维度(决定模型容量)num_hidden_layers 8:Transformer 层数max_seq_len 512:文本最大长度(需与数据集匹配)batch_size 8:批次大小(根据 GPU 显存调整,24GB 显存可设为 8-16)
train_pretrain.py源码如下:
import os
import sys
__package__ = "trainer"
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), '..')))

import argparse
import time
import math
import warnings
import torch
import torch.distributed as dist
from torch import optim, nn
from torch.nn.parallel import DistributedDataParallel
from torch.utils.data import DataLoader, DistributedSampler
from contextlib import nullcontext
from transformers import AutoTokenizer
from model.model_minimind import MiniMindConfig, MiniMindForCausalLM
from dataset.lm_dataset import PretrainDataset

warnings.filterwarnings('ignore')


def Logger(content):
    if not ddp or dist.get_rank() == 0:
        print(content)


def get_lr(current_step, total_steps, lr):
    return lr / 10 + 0.5 * lr * (1 + math.cos(math.pi * current_step / total_steps))


def train_epoch(epoch, wandb):
    loss_fct = nn.CrossEntropyLoss(reduction='none')
    start_time = time.time()
    for step, (X, Y, loss_mask) in enumerate(train_loader):
        X = X.to(args.device)
        Y = Y.to(args.device)
        loss_mask = loss_mask.to(args.device)

        lr = get_lr(epoch * iter_per_epoch + step, args.epochs * iter_per_epoch, args.learning_rate)
        for param_group in optimizer.param_groups:
            param_group['lr'] = lr

        with ctx:
            res = model(X)
            loss = loss_fct(
                res.logits.view(-1, res.logits.size(-1)),
                Y.view(-1)
            ).view(Y.size())
            loss = (loss * loss_mask).sum() / loss_mask.sum()
            loss += res.aux_loss
            loss = loss / args.accumulation_steps

        scaler.scale(loss).backward()

        if (step + 1) % args.accumulation_steps == 0:
            scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)

            scaler.step(optimizer)
            scaler.update()

            optimizer.zero_grad(set_to_none=True)

        if step % args.log_interval == 0:
            spend_time = time.time() - start_time
            Logger(
                'Epoch:[{}/{}]({}/{}) loss:{:.3f} lr:{:.12f} epoch_Time:{}min:'.format(
                    epoch + 1,
                    args.epochs,
                    step,
                    iter_per_epoch,
                    loss.item() * args.accumulation_steps,
                    optimizer.param_groups[-1]['lr'],
                    spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60))

            if (wandb is not None) and (not ddp or dist.get_rank() == 0):
                wandb.log({"loss": loss.item() * args.accumulation_steps,
                           "lr": optimizer.param_groups[-1]['lr'],
                           "epoch_Time": spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60})

        if (step + 1) % args.save_interval == 0 and (not ddp or dist.get_rank() == 0):
            model.eval()
            moe_path = '_moe' if lm_config.use_moe else ''
            ckp = f'{args.save_dir}/pretrain_{lm_config.hidden_size}{moe_path}.pth'

            if isinstance(model, torch.nn.parallel.DistributedDataParallel):
                state_dict = model.module.state_dict()
            else:
                state_dict = model.state_dict()

            state_dict = {k: v.half() for k, v in state_dict.items()}  # 半精度保存
            torch.save(state_dict, ckp)
            model.train()


def init_model(lm_config):
    tokenizer = AutoTokenizer.from_pretrained('../model/')
    model = MiniMindForCausalLM(lm_config).to(args.device)
    Logger(f'LLM可训练总参数量:{sum(p.numel() for p in model.parameters() if p.requires_grad) / 1e6:.3f} 百万')
    return model, tokenizer


def init_distributed_mode():
    if not ddp: return
    global ddp_local_rank, DEVICE

    dist.init_process_group(backend="nccl")
    ddp_rank = int(os.environ["RANK"])
    ddp_local_rank = int(os.environ["LOCAL_RANK"])
    ddp_world_size = int(os.environ["WORLD_SIZE"])
    DEVICE = f"cuda:{ddp_local_rank}"
    torch.cuda.set_device(DEVICE)


# torchrun --nproc_per_node 2 1-pretrain.py
if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="MiniMind Pretraining")
    parser.add_argument("--out_dir", type=str, default="../out")
    # 若要以最快速度实现zero则epochs设置为1轮;否则应当利用有限的数据训练2~6个epochs。
    parser.add_argument("--epochs", type=int, default=1)
    parser.add_argument("--batch_size", type=int, default=32)
    parser.add_argument("--learning_rate", type=float, default=5e-4)
    parser.add_argument("--device", type=str, default="cuda:0" if torch.cuda.is_available() else "cpu")
    parser.add_argument("--dtype", type=str, default="bfloat16")
    parser.add_argument("--use_wandb", action="store_true")
    parser.add_argument("--wandb_project", type=str, default="MiniMind-Pretrain")
    parser.add_argument("--num_workers", type=int, default=1)
    parser.add_argument("--ddp", action="store_true")
    parser.add_argument("--accumulation_steps", type=int, default=8)
    parser.add_argument("--grad_clip", type=float, default=1.0)
    parser.add_argument("--warmup_iters", type=int, default=0)
    parser.add_argument("--log_interval", type=int, default=100)
    parser.add_argument("--save_interval", type=int, default=100)
    parser.add_argument('--local_rank', type=int, default=-1)
    parser.add_argument('--hidden_size', default=512, type=int)
    parser.add_argument('--num_hidden_layers', default=8, type=int)
    parser.add_argument('--max_seq_len', default=512, type=int)
    parser.add_argument('--use_moe', default=False, type=bool)
    parser.add_argument("--data_path", type=str, default="../dataset/pretrain_hq.jsonl")
    args = parser.parse_args()

    lm_config = MiniMindConfig(hidden_size=args.hidden_size, num_hidden_layers=args.num_hidden_layers, use_moe=args.use_moe)
    args.save_dir = os.path.join(args.out_dir)
    os.makedirs(args.save_dir, exist_ok=True)
    os.makedirs(args.out_dir, exist_ok=True)
    tokens_per_iter = args.batch_size * args.max_seq_len
    device_type = "cuda" if "cuda" in args.device else "cpu"

    args.wandb_run_name = f"MiniMind-Pretrain-Epoch-{args.epochs}-BatchSize-{args.batch_size}-LearningRate-{args.learning_rate}"

    ctx = nullcontext() if device_type == "cpu" else torch.cuda.amp.autocast()

    ddp = int(os.environ.get("RANK", -1)) != -1  # is this a ddp run?
    ddp_local_rank, DEVICE = 0, "cuda:0"

    base_seed = 1337
    torch.manual_seed(base_seed)
    torch.cuda.manual_seed(base_seed)

    if ddp:
        init_distributed_mode()
        args.device = torch.device(DEVICE)
        rank = dist.get_rank()
        torch.manual_seed(base_seed + rank)
        # 同时设置 CUDA 的随机种子
        torch.cuda.manual_seed(base_seed + rank)

    if args.use_wandb and (not ddp or ddp_local_rank == 0):
        import wandb

        wandb.init(project=args.wandb_project, name=args.wandb_run_name)
    else:
        wandb = None

    model, tokenizer = init_model(lm_config)
    train_ds = PretrainDataset(args.data_path, tokenizer, max_length=args.max_seq_len)
    train_sampler = DistributedSampler(train_ds) if ddp else None
    train_loader = DataLoader(
        train_ds,
        batch_size=args.batch_size,
        pin_memory=True,
        drop_last=False,
        shuffle=False,
        num_workers=args.num_workers,
        sampler=train_sampler
    )

    scaler = torch.cuda.amp.GradScaler(enabled=(args.dtype in ['float16', 'bfloat16']))
    optimizer = optim.AdamW(model.parameters(), lr=args.learning_rate)

    if ddp:
        model._ddp_params_and_buffers_to_ignore = {"pos_cis"}
        model = DistributedDataParallel(model, device_ids=[ddp_local_rank])

    iter_per_epoch = len(train_loader)
    for epoch in range(args.epochs):
        train_epoch(epoch, wandb)
注意:所有训练过程默认每隔100步保存1次参数到文件./out/***.pth(每次会覆盖掉旧权重文件)。
预训练是大模型学习基础语言规律和世界知识的核心阶段,相当于让模型 “饱读诗书”。下面结合train_pretrain.py代码,详细解析预训练的实现逻辑和关键技术点。
(1)该脚本主要包含以下核心模块:
- 环境配置(库导入、参数解析)
- 训练工具函数(日志、学习率调度)
- 核心训练逻辑(前向传播、损失计算、参数更新)
- 分布式训练支持
- 模型与数据初始化
(2)学习率调度(get_lr)
def get_lr(current_step, total_steps, lr):
return lr / 10 + 0.5 * lr * (1 + math.cos(math.pi * current_step / total_steps))- 策略:采用余弦退火学习率,公式拆解:
- 初始学习率为
lr/10(预热) - 随训练进度(
current_step/total_steps)按余弦曲线从lr平滑下降
- 初始学习率为
- 优势:相比固定学习率,能在训练后期减小学习率,帮助模型稳定收敛。
(3)前向传播与损失计算
with ctx:  # 自动混合精度训练上下文
    res = model(X)  # 模型输出(包含logits)
    loss = loss_fct(
        res.logits.view(-1, res.logits.size(-1)),  # 展平为二维张量:(batch*seq_len, vocab_size)
        Y.view(-1)  # 展平标签:(batch*seq_len,)
    ).view(Y.size())  # 恢复为原形状
    loss = (loss * loss_mask).sum() / loss_mask.sum()  # 只计算有效token的损失
    loss += res.aux_loss  # 辅助损失(如MoE模型的负载均衡损失)
loss = loss / args.accumulation_steps # 梯度累积时的损失缩放- 核心知识点:
- 因果语言模型任务:通过输入
X预测下一个 tokenY,本质是 “词语接龙” - 交叉熵损失:
nn.CrossEntropyLoss计算预测概率与真实标签的差异 - 混合精度训练:
ctx通过torch.cuda.amp.autocast()启用,用半精度(float16/bfloat16)加速计算并节省显存 - 梯度累积:当
accumulation_steps>1时,累计多步梯度再更新参数,模拟大批次训练效果
- 因果语言模型任务:通过输入
(4)反向传播与参数更新
scaler.scale(loss).backward()  # 梯度缩放(防止混合精度下梯度溢出)

if (step + 1) % args.accumulation_steps == 0:
    scaler.unscale_(optimizer)  # 取消梯度缩放
    torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)  # 梯度裁剪(防止梯度爆炸)
    scaler.step(optimizer)  # 更新参数
    scaler.update()  # 更新缩放器状态
optimizer.zero_grad(set_to_none=True) # 清空梯度- 关键技术:
- 梯度裁剪:限制梯度的最大范数(
grad_clip),避免训练不稳定 - 梯度缩放:
GradScaler解决半精度计算中梯度下溢问题
- 梯度裁剪:限制梯度的最大范数(
另外,如果遇到数据集加载问题需要修复:
若dataset/lm_dataset.py报错(如编码错误、数据格式异常),可替换为适配后的代码(增强编码兼容性与错误处理):
# 关键改进点:
# 1. 支持多编码尝试(utf-8/gbk/latin1),解决中文乱码
# 2. 逐行处理二进制数据,避免整体解码失败
# 3. 增加字段校验与错误提示,便于定位问题
class PretrainDataset(Dataset):
    def load_data(self, data_path):
        samples = []
        encodings = ['utf-8', 'gbk', 'latin1']  # 多编码尝试
        with open(data_path, 'rb') as f:  # 二进制打开,避免整体解码失败
            for line_num, line_bytes in enumerate(f, 1):
                line = None
                # 尝试多种编码解码
                for encoding in encodings:
                    try:
                        line = line_bytes.decode(encoding).strip()
                        break
                    except UnicodeDecodeError:
                        continue
                if line is None:
                    print(f"跳过无法解码的行 {line_num}")
                    continue
                # 解析JSON并校验字段
                try:
                    data = json.loads(line)
                    if "text" in data:
                        samples.append(data["text"])
                except json.JSONDecodeError:
                    print(f"跳过JSON错误行 {line_num}")
        print(f"加载完成,有效样本数:{len(samples)}")
        return samples
预训练日志分析:
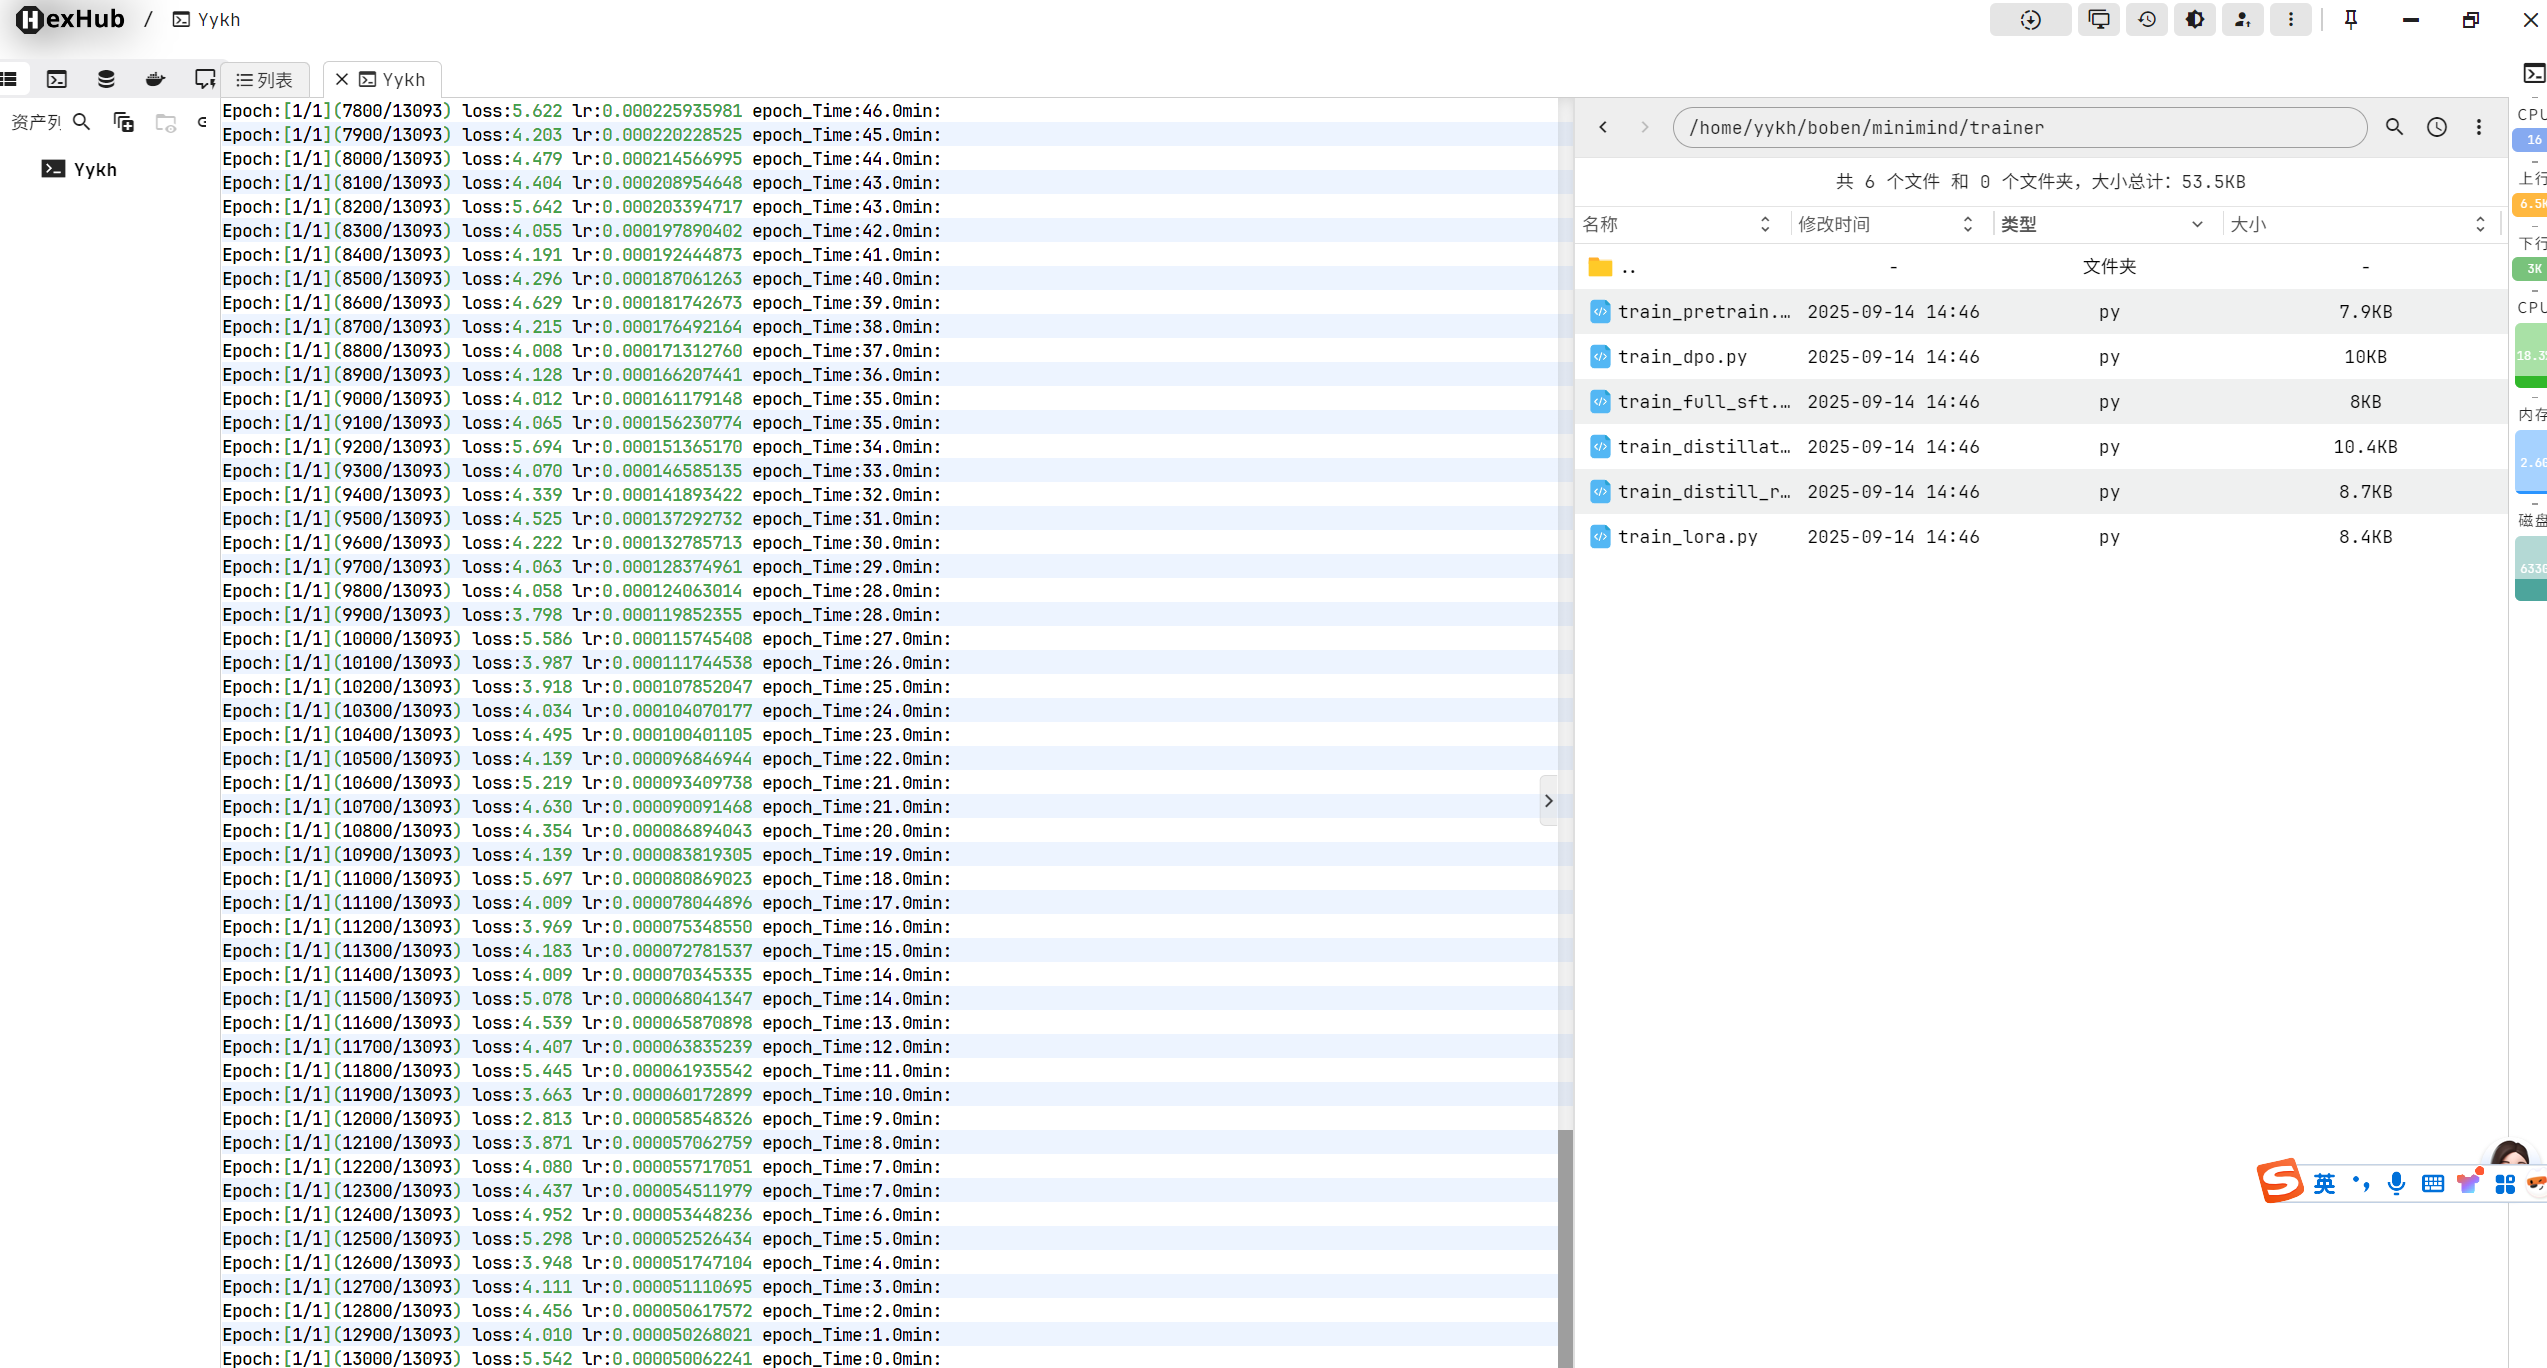
成功运行后,日志会显示每步的 loss(损失值)、学习率等信息。以 25.8M 模型为例,loss 通常在 3.6~5.5 之间波动(小模型拟合能力有限,无需追求过低 loss),说明模型已初步学会语言规律:
- 语法层面:能区分 "我吃饭" 与 "饭吃我" 的合理性
- 语义层面:能关联 "手机" 与 "通话" 等相关词汇
- 格式层面:熟悉
<|im_start|>等特殊 token 的作用
3.3 监督微调:让模型 "学会对话"
预训练后的模型仅具备基础语言能力,需通过监督微调(SFT)让其掌握对话逻辑(如遵循 "用户问 - 助手答" 的格式)。
3.3.1 执行监督微调
使用train_full_sft.py脚本,基于预训练模型继续训练:
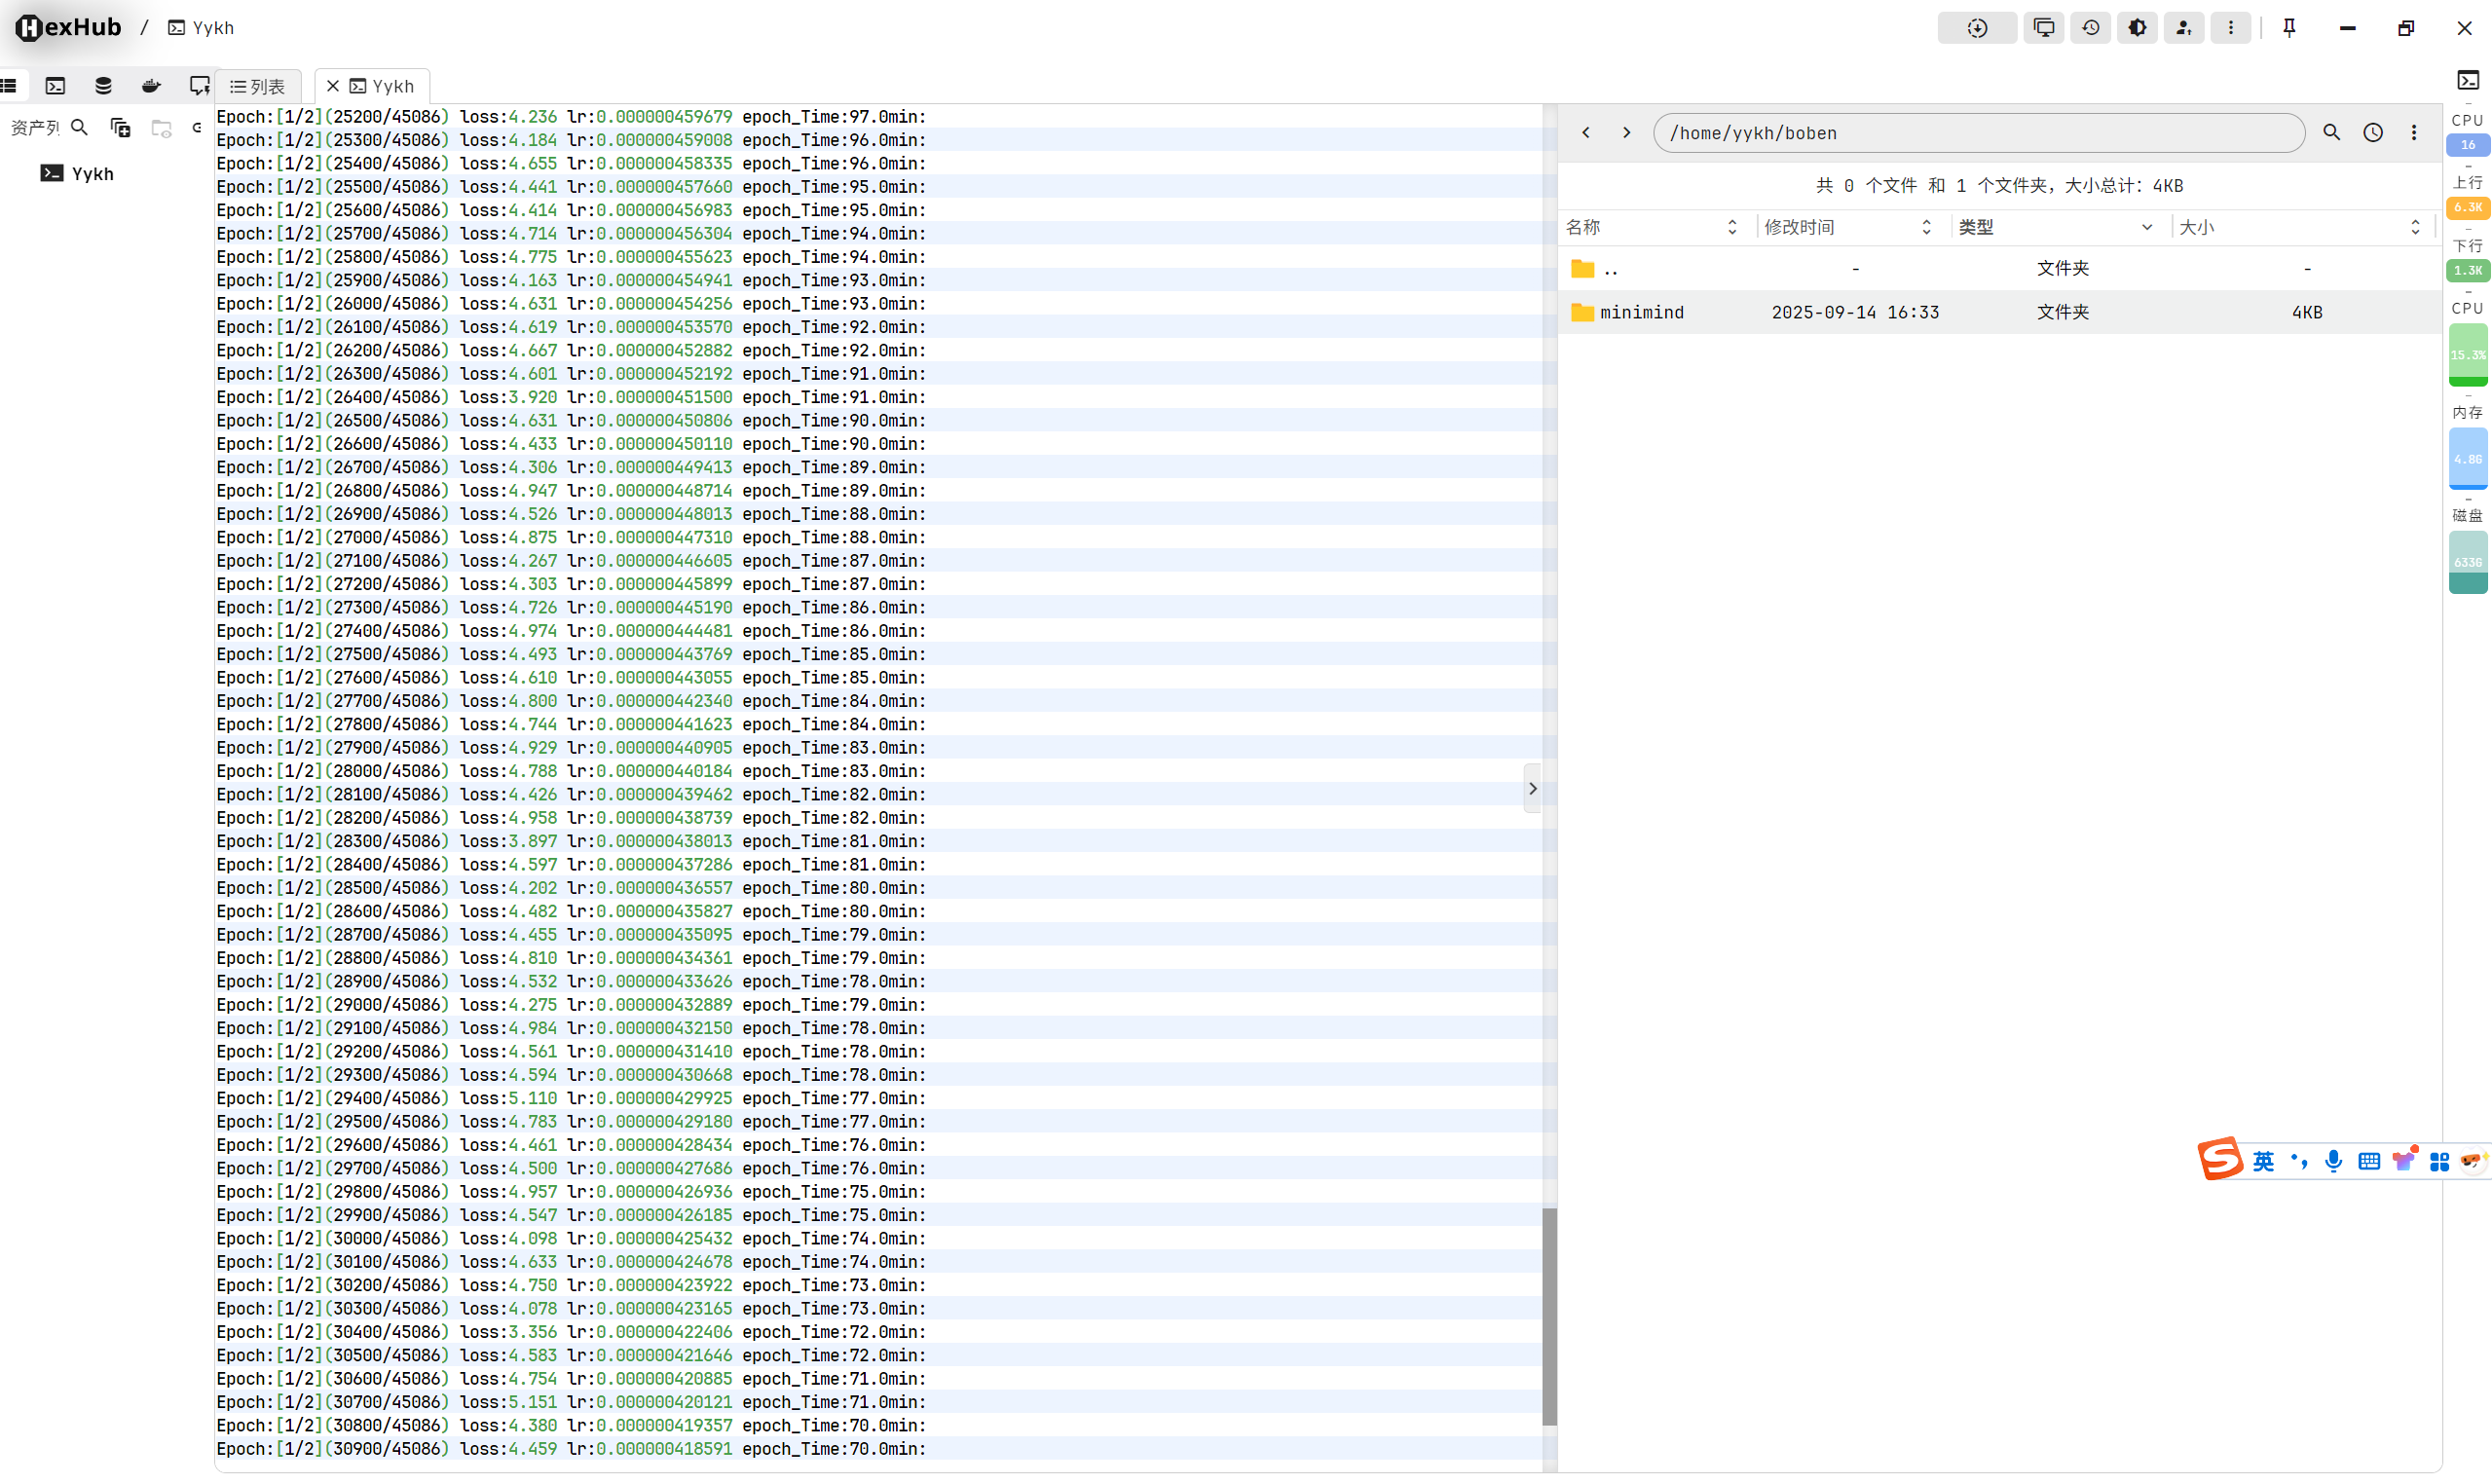
python train_full_sft.py --hidden_size 512 --num_hidden_layers 8 --max_seq_len 512 --batch_size 4 --epochs 3 --device cuda:0监督微调结果日志如下:
train_full_sft.py源码如下:
import os
import sys

__package__ = "trainer"
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), '..')))

import argparse
import time
import math
import warnings
import torch
import torch.distributed as dist
from contextlib import nullcontext
from torch import optim, nn
from torch.nn.parallel import DistributedDataParallel
from torch.utils.data import DataLoader, DistributedSampler
from transformers import AutoTokenizer, AutoModelForCausalLM
from model.model_minimind import MiniMindConfig, MiniMindForCausalLM
from dataset.lm_dataset import SFTDataset

warnings.filterwarnings('ignore')


def Logger(content):
    if not ddp or dist.get_rank() == 0:
        print(content)


def get_lr(current_step, total_steps, lr):
    return lr / 10 + 0.5 * lr * (1 + math.cos(math.pi * current_step / total_steps))


def train_epoch(epoch, wandb):
    loss_fct = nn.CrossEntropyLoss(reduction='none')
    start_time = time.time()
    for step, (X, Y, loss_mask) in enumerate(train_loader):
        X = X.to(args.device)
        Y = Y.to(args.device)
        loss_mask = loss_mask.to(args.device)
        lr = get_lr(epoch * iter_per_epoch + step, args.epochs * iter_per_epoch, args.learning_rate)
        for param_group in optimizer.param_groups:
            param_group['lr'] = lr

        with ctx:
            res = model(X)
            loss = loss_fct(
                res.logits.view(-1, res.logits.size(-1)),
                Y.view(-1)
            ).view(Y.size())

            loss = (loss * loss_mask).sum() / loss_mask.sum()
            loss += res.aux_loss
            loss = loss / args.accumulation_steps

        scaler.scale(loss).backward()

        if (step + 1) % args.accumulation_steps == 0:
            scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)

            scaler.step(optimizer)
            scaler.update()

            optimizer.zero_grad(set_to_none=True)

        if step % args.log_interval == 0:
            spend_time = time.time() - start_time
            Logger(
                'Epoch:[{}/{}]({}/{}) loss:{:.3f} lr:{:.12f} epoch_Time:{}min:'.format(
                    epoch + 1,
                    args.epochs,
                    step,
                    iter_per_epoch,
                    loss.item() * args.accumulation_steps,
                    optimizer.param_groups[-1]['lr'],
                    spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60))

            if (wandb is not None) and (not ddp or dist.get_rank() == 0):
                wandb.log({"loss": loss * args.accumulation_steps,
                           "lr": optimizer.param_groups[-1]['lr'],
                           "epoch_Time": spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60})

        if (step + 1) % args.save_interval == 0 and (not ddp or dist.get_rank() == 0):
            model.eval()
            moe_path = '_moe' if lm_config.use_moe else ''
            ckp = f'{args.save_dir}/full_sft_{lm_config.hidden_size}{moe_path}.pth'
            if isinstance(model, torch.nn.parallel.DistributedDataParallel):
                state_dict = model.module.state_dict()
            else:
                state_dict = model.state_dict()
            state_dict = {k: v.half() for k, v in state_dict.items()}  # 半精度保存
            torch.save(state_dict, ckp)
            model.train()


def init_model(lm_config):
    tokenizer = AutoTokenizer.from_pretrained('../model')
    model = MiniMindForCausalLM(lm_config)
    moe_path = '_moe' if lm_config.use_moe else ''
    ckp = f'{args.save_dir}/pretrain_{lm_config.hidden_size}{moe_path}.pth'
    state_dict = torch.load(ckp, map_location=args.device)
    model.load_state_dict(state_dict, strict=False)

    Logger(f'LLM可训练总参数量:{sum(p.numel() for p in model.parameters() if p.requires_grad) / 1e6:.3f} 百万')
    model = model.to(args.device)
    return model, tokenizer


def init_distributed_mode():
    if not ddp: return
    global ddp_local_rank, DEVICE

    dist.init_process_group(backend="nccl")
    ddp_rank = int(os.environ["RANK"])
    ddp_local_rank = int(os.environ["LOCAL_RANK"])
    ddp_world_size = int(os.environ["WORLD_SIZE"])
    DEVICE = f"cuda:{ddp_local_rank}"
    torch.cuda.set_device(DEVICE)


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="MiniMind Full SFT")
    parser.add_argument("--out_dir", type=str, default="../out")
    parser.add_argument("--epochs", type=int, default=2)
    parser.add_argument("--batch_size", type=int, default=16)
    parser.add_argument("--learning_rate", type=float, default=5e-7)
    parser.add_argument("--device", type=str, default="cuda:0" if torch.cuda.is_available() else "cpu")
    parser.add_argument("--dtype", type=str, default="bfloat16")
    parser.add_argument("--use_wandb", action="store_true")
    parser.add_argument("--wandb_project", type=str, default="MiniMind-Full-SFT")
    parser.add_argument("--num_workers", type=int, default=1)
    parser.add_argument("--ddp", action="store_true")
    parser.add_argument("--accumulation_steps", type=int, default=1)
    parser.add_argument("--grad_clip", type=float, default=1.0)
    parser.add_argument("--warmup_iters", type=int, default=0)
    parser.add_argument("--log_interval", type=int, default=100)
    parser.add_argument("--save_interval", type=int, default=100)
    parser.add_argument('--local_rank', type=int, default=-1)
    parser.add_argument('--hidden_size', default=512, type=int)
    parser.add_argument('--num_hidden_layers', default=8, type=int)
    parser.add_argument('--max_seq_len', default=512, type=int)
    parser.add_argument('--use_moe', default=False, type=bool)
    parser.add_argument("--data_path", type=str, default="../dataset/sft_mini_512.jsonl")

    args = parser.parse_args()

    lm_config = MiniMindConfig(hidden_size=args.hidden_size, num_hidden_layers=args.num_hidden_layers,
                               use_moe=args.use_moe)
    args.save_dir = os.path.join(args.out_dir)
    os.makedirs(args.save_dir, exist_ok=True)
    os.makedirs(args.out_dir, exist_ok=True)
    tokens_per_iter = args.batch_size * args.max_seq_len
    device_type = "cuda" if "cuda" in args.device else "cpu"

    args.wandb_run_name = f"MiniMind-Full-SFT-Epoch-{args.epochs}-BatchSize-{args.batch_size}-LearningRate-{args.learning_rate}"

    ctx = nullcontext() if device_type == "cpu" else torch.cuda.amp.autocast()
    ddp = int(os.environ.get("RANK", -1)) != -1  # is this a ddp run?
    ddp_local_rank, DEVICE = 0, "cuda:0"
    base_seed = 1337
    torch.manual_seed(base_seed)
    torch.cuda.manual_seed(base_seed)

    if ddp:
        init_distributed_mode()
        args.device = torch.device(DEVICE)
        rank = dist.get_rank()
        torch.manual_seed(base_seed + rank)
        # 同时设置 CUDA 的随机种子
        torch.cuda.manual_seed(base_seed + rank)

    if args.use_wandb and (not ddp or ddp_local_rank == 0):
        import wandb

        wandb.init(project=args.wandb_project, name=args.wandb_run_name)
    else:
        wandb = None

    model, tokenizer = init_model(lm_config)

    train_ds = SFTDataset(args.data_path, tokenizer, max_length=args.max_seq_len)
    train_sampler = DistributedSampler(train_ds) if ddp else None
    train_loader = DataLoader(
        train_ds,
        batch_size=args.batch_size,
        pin_memory=True,
        drop_last=False,
        shuffle=False,
        num_workers=args.num_workers,
        sampler=train_sampler
    )

    scaler = torch.cuda.amp.GradScaler(enabled=(args.dtype in ['float16', 'bfloat16']))
    optimizer = optim.AdamW(model.parameters(), lr=args.learning_rate)

    if ddp:
        model._ddp_params_and_buffers_to_ignore = {"pos_cis"}
        model = DistributedDataParallel(model, device_ids=[ddp_local_rank])

    iter_per_epoch = len(train_loader)
    for epoch in range(args.epochs):
        train_epoch(epoch, wandb)
监督微调(Supervised Fine-Tuning,简称 SFT)是大模型从 "能理解语言" 到 "会对话交互" 的关键一步。通过在人工标注的高质量对话数据上训练,模型能学习人类对话的逻辑、风格和知识应用方式。下面结合train_full_sft.py代码,详细解析监督微调的实现过程。
预训练模型(如前面提到的pretrain阶段)已经具备了语言理解和基本生成能力,但缺乏对话交互的针对性。SFT 的核心目标是:
- 让模型理解对话场景(如问答、闲聊、指令遵循)
- 学习符合人类习惯的回复方式(逻辑连贯、信息准确)
- 对齐人类价值观(避免有害输出、保持礼貌)
(1)模型初始化
def init_model(lm_config):
    # 加载分词器(与预训练保持一致)
    tokenizer = AutoTokenizer.from_pretrained('../model')
    # 初始化模型结构
    model = MiniMindForCausalLM(lm_config)
    # 加载预训练权重(关键:基于预训练模型继续训练)
    ckp = f'{args.save_dir}/pretrain_{lm_config.hidden_size}.pth'
    state_dict = torch.load(ckp, map_location=args.device)
    model.load_state_dict(state_dict, strict=False)  # strict=False允许部分权重不匹配
    # 统计可训练参数
    Logger(f'LLM可训练总参数量:{sum(p.numel() for p in model.parameters() if p.requires_grad)/1e6:.3f} 百万')
    model = model.to(args.device)
return model, tokenizer知识点:
- SFT 基于预训练模型进行,而非从头训练,这是 "站在巨人肩膀上" 的高效训练方式
strict=False的作用:如果预训练模型与 SFT 模型结构有细微差异(如新增输出层),仍能加载兼容的权重
(2)前向传播与损失计算
# 输入数据迁移到设备
X = X.to(args.device)  # 输入序列
Y = Y.to(args.device)  # 标签序列(期望输出)
loss_mask = loss_mask.to(args.device)  # 损失掩码

# 模型前向传播
with ctx:  # ctx是混合精度训练上下文(节省显存)
    res = model(X)  # 得到模型输出(logits:词汇表概率分布)
    # 计算交叉熵损失
    loss = loss_fct(
        res.logits.view(-1, res.logits.size(-1)),  # 展平为(batch*seq_len, vocab_size)
        Y.view(-1)  # 展平为(batch*seq_len,)
    ).view(Y.size())  # 恢复为(batch, seq_len)

    # 应用损失掩码:只计算需要学习的位置(如回复部分)
    loss = (loss * loss_mask).sum() / loss_mask.sum()
    # 加入辅助损失(如MoE模型的平衡损失,可选)
    loss += res.aux_loss
    # 梯度累积:将损失除以累积步数
loss = loss / args.accumulation_steps关键知识点:
- 损失掩码(loss_mask):对话数据中,输入部分(如用户提问)不需要模型学习(模型应 "理解" 而非 "生成" 输入),只有回复部分需要计算损失
- 交叉熵损失(CrossEntropyLoss):衡量模型生成的词汇分布与真实回复的差异,推动模型学习 "正确的回复方式"
(3)反向传播与参数更新
# 梯度缩放(混合精度训练防止梯度溢出)
scaler.scale(loss).backward()

# 梯度累积达到指定步数后更新参数
if (step + 1) % args.accumulation_steps == 0:
    scaler.unscale_(optimizer)  #  unscaling梯度
    torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)  # 梯度裁剪(防止梯度爆炸)
    scaler.step(optimizer)  # 更新参数
    scaler.update()  # 更新缩放器
optimizer.zero_grad(set_to_none=True) # 清空梯度- 梯度累积:当显存不足时,可将多个小批次的梯度累积后再更新参数,等效于使用大批次
- 梯度裁剪:对话数据较长时容易出现梯度爆炸,通过限制梯度的最大范数(这里 1.0)保证训练稳定
通过监督微调,预训练模型从 "通用语言模型" 转变为 "对话模型"。接下来,我们还可以通过 RLHF(基于人类反馈的强化学习)进一步提升模型的对话质量,但 SFT 是这一切的基础 —— 没有良好的监督微调,后续优化将难以为继。
3.4 让模型懂人心:基于直接偏好优化(DPO)的人类反馈强化学习实践
在前面的监督微调(SFT)阶段,模型已经具备了基本的对话能力,但它的输出更像是 “单词接龙”—— 仅基于训练数据的模式生成内容,却不知道 “什么是好回答”“什么是差回答”。人类反馈强化学习(RLHF)正是为了解决这个问题:通过人类对回答的偏好数据(哪些回答更优、哪些更差),让模型学会对齐人类价值观,减少不合预期的输出。
在 RLHF 的众多实现中,直接偏好优化(Direct Preference Optimization, DPO) 因其简洁高效成为主流方案。与传统的 PPO(Proximal Policy Optimization)相比,DPO 无需单独训练奖励模型和价值模型,仅通过离线偏好数据即可实现与 PPO 相当的性能,同时节省大量显存并提升训练稳定性。接下来,我们结合代码详细解析 DPO 的实现过程。
DPO 的核心思想是:通过人类标注的 “优质回答(chosen)” 和 “劣质回答(rejected)” 样本对,直接调整模型参数,让模型更倾向于生成优质回答,避免劣质回答。其数学逻辑可简化为:最大化优质回答与劣质回答的概率比,并以一个初始模型(参考模型)为基准约束优化方向。
具体来说,假设模型当前输出优质回答的概率为P(chosen),输出劣质回答的概率为P(rejected),参考模型(通常是 SFT 后的模型)的对应概率为P_ref(chosen)和P_ref(rejected),则 DPO 的目标是让:
(P(chosen)/P(rejected)) / (P_ref(chosen)/P_ref(rejected)) 越大越好通过这个比例,DPO 既保证了模型向优质回答倾斜,又避免了与初始模型(SFT 结果)偏差过大,从而保持模型的基础能力。
train_dpo.py的源码如下:
import os
import sys
__package__ = "trainer"
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), '..')))

import argparse
import time
import math
import warnings
import torch
import torch.nn.functional as F
import torch.distributed as dist
from contextlib import nullcontext
from torch import optim
from torch.nn.parallel import DistributedDataParallel
from torch.utils.data import DataLoader, DistributedSampler
from transformers import AutoTokenizer, AutoModelForCausalLM
from model.model_minimind import MiniMindConfig, MiniMindForCausalLM
from dataset.lm_dataset import DPODataset

warnings.filterwarnings('ignore')


def Logger(content):
    if not ddp or dist.get_rank() == 0:
        print(content)


def get_lr(current_step, total_steps, lr):
    return lr / 10 + 0.5 * lr * (1 + math.cos(math.pi * current_step / total_steps))


def logits_to_probs(logits, labels):
    # logits shape: (batch_size, seq_len, vocab_size)
    # labels shape: (batch_size, seq_len)
    # probs shape: (batch_size, seq_len)
    log_probs = F.log_softmax(logits, dim=2)
    probs = torch.gather(log_probs, dim=2, index=labels.unsqueeze(2)).squeeze(-1)
    return probs


def dpo_loss(ref_probs, probs, mask, beta):
    # ref_probs 和 probs 都是 shape: (batch_size, seq_len)
    # https://github.com/jingyaogong/minimind/issues/298
    seq_lengths = mask.sum(dim=1, keepdim=True)  # (batch_size, 1)
    ref_probs = (ref_probs * mask).sum(dim=1) / seq_lengths.squeeze()
    probs = (probs * mask).sum(dim=1) / seq_lengths.squeeze()

    # 将 chosen 和 rejected 数据分开
    batch_size = ref_probs.shape[0]
    chosen_ref_probs = ref_probs[:batch_size // 2]
    reject_ref_probs = ref_probs[batch_size // 2:]
    chosen_probs = probs[:batch_size // 2]
    reject_probs = probs[batch_size // 2:]

    pi_logratios = chosen_probs - reject_probs
    ref_logratios = chosen_ref_probs - reject_ref_probs
    logits = pi_logratios - ref_logratios
    loss = -F.logsigmoid(beta * logits)
    return loss.mean()


def train_epoch(epoch, wandb):
    start_time = time.time()
    for step, batch in enumerate(train_loader):
        x_chosen = batch['x_chosen'].to(args.device)
        x_rejected = batch['x_rejected'].to(args.device)
        y_chosen = batch['y_chosen'].to(args.device)
        y_rejected = batch['y_rejected'].to(args.device)
        mask_chosen = batch['mask_chosen'].to(args.device)
        mask_rejected = batch['mask_rejected'].to(args.device)
        x = torch.cat([x_chosen, x_rejected], dim=0)
        y = torch.cat([y_chosen, y_rejected], dim=0)
        mask = torch.cat([mask_chosen, mask_rejected], dim=0)

        lr = get_lr(epoch * iter_per_epoch + step, args.epochs * iter_per_epoch, args.learning_rate)
        for param_group in optimizer.param_groups:
            param_group['lr'] = lr

        with ctx:
            with torch.no_grad():
                ref_outputs = ref_model(x)
                ref_logits = ref_outputs.logits
            ref_probs = logits_to_probs(ref_logits, y)
            ref_probs = ref_probs * mask
            outputs = model(x)
            logits = outputs.logits
            probs = logits_to_probs(logits, y)
            probs = probs * mask
            loss = dpo_loss(ref_probs, probs, mask, beta=0.1)
            loss = loss / args.accumulation_steps

        scaler.scale(loss).backward()

        if (step + 1) % args.accumulation_steps == 0:
            scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)
            scaler.step(optimizer)
            scaler.update()
            optimizer.zero_grad(set_to_none=True)

        if step % args.log_interval == 0:
            spend_time = time.time() - start_time
            Logger(
                'Epoch:[{}/{}]({}/{}) loss:{:.3f} lr:{:.12f} epoch_Time:{}min:'.format(
                    epoch + 1,
                    args.epochs,
                    step,
                    iter_per_epoch,
                    loss.item() * args.accumulation_steps,
                    optimizer.param_groups[-1]['lr'],
                    spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60))

            if (wandb is not None) and (not ddp or dist.get_rank() == 0):
                wandb.log({"loss": loss * args.accumulation_steps,
                           "lr": optimizer.param_groups[-1]['lr'],
                           "epoch_Time": spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60})

        if (step + 1) % args.save_interval == 0 and (not ddp or dist.get_rank() == 0):
            model.eval()
            moe_path = '_moe' if lm_config.use_moe else ''
            ckp = f'{args.save_dir}/rlhf_{lm_config.hidden_size}{moe_path}.pth'

            if isinstance(model, torch.nn.parallel.DistributedDataParallel):
                state_dict = model.module.state_dict()
            else:
                state_dict = model.state_dict()
            state_dict = {k: v.half() for k, v in state_dict.items()}  # 半精度保存
            torch.save(state_dict, ckp)
            model.train()


def init_model(lm_config):
    tokenizer = AutoTokenizer.from_pretrained('../model/')
    model = MiniMindForCausalLM(lm_config)
    moe_path = '_moe' if lm_config.use_moe else ''
    ckp = f'{args.save_dir}/full_sft_{lm_config.hidden_size}{moe_path}.pth'
    state_dict = torch.load(ckp, map_location=args.device)
    model.load_state_dict(state_dict, strict=False)
    # 初始化参考模型
    ref_model = MiniMindForCausalLM(lm_config)
    ref_model.load_state_dict(state_dict, strict=False)
    ref_model.eval()
    ref_model.requires_grad_(False)

    Logger(f'LLM总参数量:{sum(p.numel() for p in model.parameters() if p.requires_grad) / 1e6:.3f} 百万')
    model = model.to(args.device)
    ref_model = ref_model.to(args.device)

    return model, ref_model, tokenizer


def init_distributed_mode():
    if not ddp: return
    global ddp_local_rank, DEVICE

    dist.init_process_group(backend="nccl")
    ddp_rank = int(os.environ["RANK"])
    ddp_local_rank = int(os.environ["LOCAL_RANK"])
    ddp_world_size = int(os.environ["WORLD_SIZE"])
    DEVICE = f"cuda:{ddp_local_rank}"
    torch.cuda.set_device(DEVICE)


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="MiniMind RLHF")
    parser.add_argument("--out_dir", type=str, default="../out")
    parser.add_argument("--epochs", type=int, default=2)
    parser.add_argument("--batch_size", type=int, default=4)
    # sft阶段学习率为 「5e-6」->「5e-7」长度512,建议离线正负样本「概率」偏好对齐阶段lr <=「1e-8」长度3000,否则很容易遗忘训坏
    parser.add_argument("--learning_rate", type=float, default=1e-8)
    parser.add_argument("--device", type=str, default="cuda:0" if torch.cuda.is_available() else "cpu")
    parser.add_argument("--dtype", type=str, default="bfloat16")
    parser.add_argument("--use_wandb", action="store_true")
    parser.add_argument("--wandb_project", type=str, default="MiniMind-RLHF-SFT")
    parser.add_argument("--num_workers", type=int, default=1)
    parser.add_argument("--ddp", action="store_true")
    parser.add_argument("--accumulation_steps", type=int, default=1)
    parser.add_argument("--grad_clip", type=float, default=1.0)
    parser.add_argument("--warmup_iters", type=int, default=0)
    parser.add_argument("--log_interval", type=int, default=100)
    parser.add_argument("--save_interval", type=int, default=100)
    parser.add_argument('--local_rank', type=int, default=-1)
    parser.add_argument('--hidden_size', default=512, type=int)
    parser.add_argument('--num_hidden_layers', default=8, type=int)
    parser.add_argument('--max_seq_len', default=1024, type=int)
    parser.add_argument('--use_moe', default=False, type=bool)
    parser.add_argument("--data_path", type=str, default="../dataset/dpo.jsonl")

    args = parser.parse_args()

    lm_config = MiniMindConfig(hidden_size=args.hidden_size, num_hidden_layers=args.num_hidden_layers, use_moe=args.use_moe)
    args.save_dir = os.path.join(args.out_dir)
    os.makedirs(args.save_dir, exist_ok=True)
    os.makedirs(args.out_dir, exist_ok=True)
    tokens_per_iter = args.batch_size * args.max_seq_len
    device_type = "cuda" if "cuda" in args.device else "cpu"

    args.wandb_run_name = f"MiniMind-Full-DPO-Epoch-{args.epochs}-BatchSize-{args.batch_size}-LearningRate-{args.learning_rate}"

    ctx = nullcontext() if device_type == "cpu" else torch.cuda.amp.autocast()
    ddp = int(os.environ.get("RANK", -1)) != -1  # is this a ddp run?
    ddp_local_rank, DEVICE = 0, "cuda:0"
    base_seed = 1337
    torch.manual_seed(base_seed)
    torch.cuda.manual_seed(base_seed)

    if ddp:
        init_distributed_mode()
        args.device = torch.device(DEVICE)
        rank = dist.get_rank()
        torch.manual_seed(base_seed + rank)
        # 同时设置 CUDA 的随机种子
        torch.cuda.manual_seed(base_seed + rank)

    if args.use_wandb and (not ddp or ddp_local_rank == 0):
        import wandb

        wandb.init(project=args.wandb_project, name=args.wandb_run_name)
    else:
        wandb = None

    model, ref_model, tokenizer = init_model(lm_config)

    train_ds = DPODataset(args.data_path, tokenizer, max_length=args.max_seq_len)
    train_sampler = DistributedSampler(train_ds) if ddp else None
    train_loader = DataLoader(
        train_ds,
        batch_size=args.batch_size,
        pin_memory=True,
        drop_last=False,
        shuffle=False,
        num_workers=args.num_workers,
        sampler=train_sampler
    )

    scaler = torch.cuda.amp.GradScaler(enabled=(args.dtype in ['float16', 'bfloat16']))
    optimizer = optim.AdamW(model.parameters(), lr=args.learning_rate)

    if ddp:
        model._ddp_params_and_buffers_to_ignore = {"pos_cis"}
        model = DistributedDataParallel(model, device_ids=[ddp_local_rank])

    iter_per_epoch = len(train_loader)
    for epoch in range(args.epochs):
        train_epoch(epoch, wandb)
(1)核心函数:DPO 损失计算(dpo_loss)
损失函数是 DPO 的核心,直接决定了模型优化的方向。代码中dpo_loss函数的实现逻辑如下:
def dpo_loss(ref_probs, probs, mask, beta):
    # ref_probs:参考模型的概率(shape: [batch_size, seq_len])
    # probs:当前模型的概率(shape: [batch_size, seq_len])
    # mask:用于过滤padding的掩码
    # beta:温度参数,控制优化强度

    # 1. 计算每条序列的平均概率(去除padding影响)
    seq_lengths = mask.sum(dim=1, keepdim=True)  # 每条序列的有效长度
    ref_probs = (ref_probs * mask).sum(dim=1) / seq_lengths.squeeze()  # 参考模型的序列平均概率
    probs = (probs * mask).sum(dim=1) / seq_lengths.squeeze()  # 当前模型的序列平均概率

    # 2. 分离优质回答(chosen)和劣质回答(rejected)
    batch_size = ref_probs.shape[0]
    chosen_ref_probs = ref_probs[:batch_size // 2]  # 参考模型对优质回答的概率
    reject_ref_probs = ref_probs[batch_size // 2:]  # 参考模型对劣质回答的概率
    chosen_probs = probs[:batch_size // 2]  # 当前模型对优质回答的概率
    reject_probs = probs[batch_size // 2:]  # 当前模型对劣质回答的概率

    # 3. 计算概率比与损失
    pi_logratios = chosen_probs - reject_probs  # 当前模型的优质/劣质概率比(对数形式)
    ref_logratios = chosen_ref_probs - reject_ref_probs  # 参考模型的优质/劣质概率比(对数形式)
    logits = pi_logratios - ref_logratios  # 相对于参考模型的改进量
    loss = -F.logsigmoid(beta * logits)  # DPO损失(最大化改进量)
return loss.mean()关键逻辑:
- 通过掩码(
mask)忽略 padding 部分对概率的影响,确保计算的是有效内容的概率。 - 将批次数据按 “优质 / 劣质” 分为两组(前半为优质,后半为劣质),分别计算概率比。
- 损失函数
-log(sigmoid(beta * logits))的作用是:当logits为正时(当前模型比参考模型更偏好优质回答),损失减小;反之损失增大,从而推动模型向 “更偏好优质回答” 优化。
(2)概率转换:从 logits 到序列概率(logits_to_probs)
模型输出的是logits(未归一化的概率),需要先转换为对数概率,再提取标签对应的概率:
def logits_to_probs(logits, labels):
    # logits: [batch_size, seq_len, vocab_size](模型输出)
    # labels: [batch_size, seq_len](真实标签,即生成的序列)
    log_probs = F.log_softmax(logits, dim=2)  # 转换为对数概率(归一化)
    # 提取labels位置对应的概率(每个token的概率)
    probs = torch.gather(log_probs, dim=2, index=labels.unsqueeze(2)).squeeze(-1)
return probs # [batch_size, seq_len](每条序列中每个token的对数概率)作用:将模型输出的logits转换为每条序列中每个 token 的对数概率,便于后续计算整个序列的概率(通过求和,因为对数概率的和等于联合概率的对数)。
(3)训练配置与注意事项
在__main__函数中,解析了训练所需的参数,其中几个关键参数需要特别注意:
- 学习率(
learning_rate):默认1e-8,远小于 SFT 阶段(5e-7)。原因是 DPO 仅需微调模型偏好,过大的学习率会导致模型遗忘 SFT 阶段学到的基础能力。 - 批次大小(
batch_size):默认 4,因 DPO 数据包含成对的优质 / 劣质样本,显存占用较高,需根据 GPU 配置调整。 - 数据路径(
data_path):默认../dataset/dpo.jsonl,需包含chosen(优质回答)和rejected(劣质回答)字段的 JSONL 文件。 - beta 参数:在
dpo_loss中固定为 0.1,控制偏好优化的强度(值越大,模型越倾向于放大优质 / 劣质差异)。
3.5 轻量级微调利器:LoRA 低秩适配技术详解与实战
在大模型微调领域,全量参数微调(Full Fine-Tuning)虽然能让模型充分适配下游任务,但存在训练成本高、容易遗忘预训练知识(灾难性遗忘)等问题。而 LoRA(Low-Rank Adaptation)技术通过 "低秩分解" 的创新思路,仅训练少量参数就能实现与全量微调接近的效果,成为参数高效微调的标杆方法。本文将结合实战代码,从原理到实践全面解析 LoRA 的实现逻辑。
LoRA 的核心思想可以概括为:冻结预训练模型的全部权重,仅在特定层插入可训练的低秩矩阵,通过低秩矩阵的更新实现模型微调。
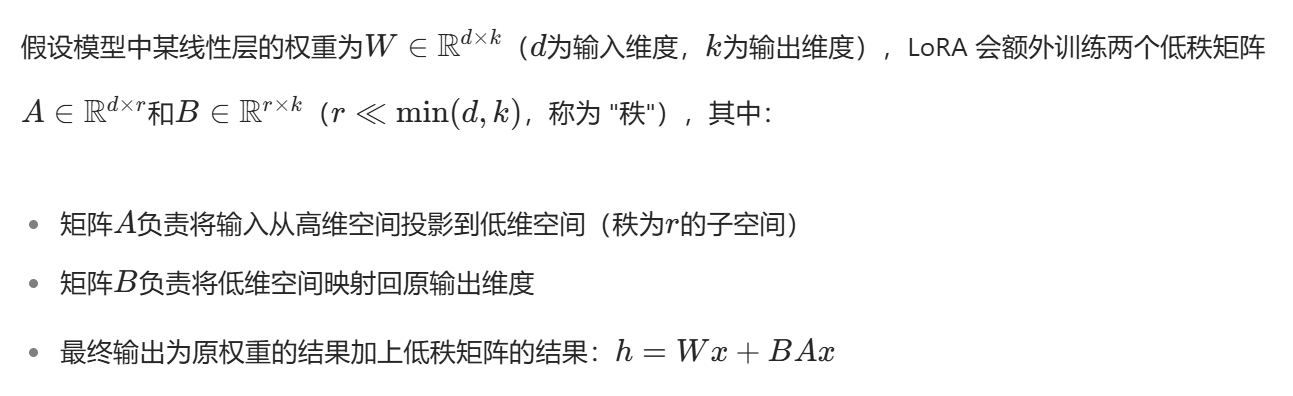
这种设计的优势在于:
- 参数量锐减:原始权重参数为\(d \times k\),而 LoRA 仅需\(r \times (d + k)\)个参数(通常\(r=8\)或16)
- 训练高效:无需更新预训练权重,仅优化低秩矩阵,显存占用大幅降低
- 避免遗忘:冻结的预训练权重保留了原始知识,微调后模型兼具通用性和领域适配性
本项目train_lora.py源码如下:
import os
import sys

__package__ = "trainer"
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), '..')))

import argparse
import time
import math
import warnings
import torch
from torch import optim, nn
import torch.distributed as dist
from contextlib import nullcontext
from torch.utils.data import DataLoader, DistributedSampler
from transformers import AutoTokenizer, AutoModelForCausalLM
from model.model_minimind import MiniMindConfig, MiniMindForCausalLM
from dataset.lm_dataset import SFTDataset
from model.model_lora import load_lora, save_lora, apply_lora

warnings.filterwarnings('ignore')


# Logger function
def Logger(content):
    if not ddp or dist.get_rank() == 0:
        print(content)


def get_lr(current_step, total_steps, lr):
    return lr / 10 + 0.5 * lr * (1 + math.cos(math.pi * current_step / total_steps))


# 代码和full_sft「几乎」一致
def train_epoch(epoch, wandb):
    loss_fct = nn.CrossEntropyLoss(reduction='none')
    start_time = time.time()
    for step, (X, Y, loss_mask) in enumerate(train_loader):
        X = X.to(args.device)
        Y = Y.to(args.device)
        loss_mask = loss_mask.to(args.device)
        lr = get_lr(epoch * iter_per_epoch + step, args.epochs * iter_per_epoch, args.learning_rate)
        for param_group in optimizer.param_groups:
            param_group['lr'] = lr

        with ctx:
            res = model(X)
            loss = loss_fct(
                res.logits.view(-1, res.logits.size(-1)),
                Y.view(-1)
            ).view(Y.size())
            loss = (loss * loss_mask).sum() / loss_mask.sum()
            loss += res.aux_loss
            loss = loss / args.accumulation_steps

        scaler.scale(loss).backward()

        if (step + 1) % args.accumulation_steps == 0:
            scaler.unscale_(optimizer)
            torch.nn.utils.clip_grad_norm_(lora_params, args.grad_clip)

            scaler.step(optimizer)
            scaler.update()

            optimizer.zero_grad(set_to_none=True)

        if step % args.log_interval == 0:
            spend_time = time.time() - start_time
            Logger(
                'Epoch:[{}/{}]({}/{}) loss:{:.3f} lr:{:.12f} epoch_Time:{}min:'.format(
                    epoch + 1,
                    args.epochs,
                    step,
                    iter_per_epoch,
                    loss.item() * args.accumulation_steps,
                    optimizer.param_groups[-1]['lr'],
                    spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60))

            if (wandb is not None) and (not ddp or dist.get_rank() == 0):
                wandb.log({"loss": loss * args.accumulation_steps,
                           "lr": optimizer.param_groups[-1]['lr'],
                           "epoch_Time": spend_time / (step + 1) * iter_per_epoch // 60 - spend_time // 60})

        if (step + 1) % args.save_interval == 0 and (not ddp or dist.get_rank() == 0):
            model.eval()
            lora_save_path = f'{args.save_dir}/lora/{args.lora_name}_{lm_config.hidden_size}.pth'
            os.makedirs(os.path.dirname(lora_save_path), exist_ok=True)
            # 【区别1】只保存lora权重即可
            save_lora(model, lora_save_path)
            model.train()


def init_model(lm_config):
    tokenizer = AutoTokenizer.from_pretrained('../model/')
    model = MiniMindForCausalLM(lm_config)
    moe_path = '_moe' if lm_config.use_moe else ''
    ckp = f'{args.save_dir}/full_sft_{lm_config.hidden_size}{moe_path}.pth'
    state_dict = torch.load(ckp, map_location=args.device)
    model.load_state_dict(state_dict, strict=False)
    return model.to(args.device), tokenizer


def init_distributed_mode():
    if not ddp: return
    global ddp_local_rank, DEVICE

    dist.init_process_group(backend="nccl")
    ddp_rank = int(os.environ["RANK"])
    ddp_local_rank = int(os.environ["LOCAL_RANK"])
    ddp_world_size = int(os.environ["WORLD_SIZE"])
    DEVICE = f"cuda:{ddp_local_rank}"
    torch.cuda.set_device(DEVICE)


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="MiniMind SFT with LoRA")
    parser.add_argument("--out_dir", type=str, default="../out")
    parser.add_argument("--epochs", type=int, default=10)
    parser.add_argument("--batch_size", type=int, default=32)
    parser.add_argument("--learning_rate", type=float, default=1e-4)
    parser.add_argument("--device", type=str, default="cuda:0" if torch.cuda.is_available() else "cpu")
    parser.add_argument("--dtype", type=str, default="bfloat16")
    parser.add_argument("--use_wandb", action="store_true")
    parser.add_argument("--wandb_project", type=str, default="MiniMind-LoRA-SFT")
    parser.add_argument("--num_workers", type=int, default=1)
    parser.add_argument("--ddp", action="store_true")
    parser.add_argument("--accumulation_steps", type=int, default=1)
    parser.add_argument("--grad_clip", type=float, default=1.0)
    parser.add_argument("--warmup_iters", type=int, default=0)
    parser.add_argument("--log_interval", type=int, default=100)
    parser.add_argument("--save_interval", type=int, default=100)
    parser.add_argument('--local_rank', type=int, default=-1)
    parser.add_argument('--hidden_size', default=512, type=int)
    parser.add_argument('--num_hidden_layers', default=8, type=int)
    parser.add_argument('--max_seq_len', default=512, type=int)
    parser.add_argument('--use_moe', default=False, type=bool)
    parser.add_argument("--data_path", type=str, default="../dataset/lora_medical.jsonl")
    parser.add_argument("--lora_name", type=str, default="lora_medical", help="根据任务保存成lora_(英文/医学/心理...)")
    args = parser.parse_args()

    lm_config = MiniMindConfig(hidden_size=args.hidden_size, num_hidden_layers=args.num_hidden_layers,
                               use_moe=args.use_moe)
    args.save_dir = os.path.join(args.out_dir)
    os.makedirs(args.save_dir, exist_ok=True)
    os.makedirs(args.out_dir, exist_ok=True)
    tokens_per_iter = args.batch_size * args.max_seq_len
    device_type = "cuda" if "cuda" in args.device else "cpu"

    ctx = nullcontext() if device_type == "cpu" else torch.cuda.amp.autocast()
    ddp = int(os.environ.get("RANK", -1)) != -1  # is this a ddp run?
    ddp_local_rank, DEVICE = 0, "cuda:0"
    base_seed = 1337
    torch.manual_seed(base_seed)
    torch.cuda.manual_seed(base_seed)

    if ddp:
        init_distributed_mode()
        args.device = torch.device(DEVICE)
        rank = dist.get_rank()
        torch.manual_seed(base_seed + rank)
        # 同时设置 CUDA 的随机种子
        torch.cuda.manual_seed(base_seed + rank)

    args.wandb_run_name = f"MiniMind-Lora-SFT-Epoch-{args.epochs}-BatchSize-{args.batch_size}-LearningRate-{args.learning_rate}"
    if args.use_wandb and (not ddp or ddp_local_rank == 0):
        import wandb

        wandb.init(project=args.wandb_project, name=args.wandb_run_name)
    else:
        wandb = None

    model, tokenizer = init_model(lm_config)
    apply_lora(model)

    total_params = sum(p.numel() for p in model.parameters())  # 总参数数量
    lora_params_count = sum(p.numel() for name, p in model.named_parameters() if 'lora' in name)  # LoRA 参数数量
    if not ddp or dist.get_rank() == 0:
        print(f"LLM 总参数量: {total_params}")
        print(f"LoRA 参数量: {lora_params_count}")
        print(f"LoRA 参数占比: {lora_params_count / total_params * 100:.2f}%")

    for name, param in model.named_parameters():
        if 'lora' not in name:
            param.requires_grad = False
    lora_params = []
    for name, param in model.named_parameters():
        if 'lora' in name:
            lora_params.append(param)

    # 只对 LoRA 参数进行优化
    optimizer = optim.AdamW(lora_params, lr=args.learning_rate)
    train_ds = SFTDataset(args.data_path, tokenizer, max_length=args.max_seq_len)
    train_sampler = DistributedSampler(train_ds) if ddp else None
    train_loader = DataLoader(
        train_ds,
        batch_size=args.batch_size,
        pin_memory=True,
        drop_last=False,
        shuffle=False,
        num_workers=args.num_workers,
        sampler=train_sampler
    )

    scaler = torch.cuda.amp.GradScaler(enabled=(args.dtype in ['float16', 'bfloat16']))
    iter_per_epoch = len(train_loader)

    for epoch in range(args.epochs):
        train_epoch(epoch, wandb)
该项目从零实现了 LoRA 的核心逻辑,未依赖第三方库,代码结构清晰,主要包含 3 个核心功能:
(1)LoRA 层定义
class LoRA(nn.Module):
    def __init__(self, in_features, out_features, rank):
        super().__init__()
        self.rank = rank  # 低秩矩阵的秩(关键超参数)
        self.A = nn.Linear(in_features, rank, bias=False)  # 投影矩阵A
        self.B = nn.Linear(rank, out_features, bias=False)  # 映射矩阵B

        # 初始化:A采用高斯分布,B初始化为全0(保证初始时LoRA不影响原模型输出)
        self.A.weight.data.normal_(mean=0.0, std=0.02)
        self.B.weight.data.zero_()

    def forward(self, x):
        return self.B(self.A(x))  # 低秩路径:x → A → B → 输出
(2)为模型注入 LoRA(apply_lora)
def apply_lora(model, rank=8):
    for name, module in model.named_modules():
        # 仅对对称线性层(输入输出维度相同)注入LoRA(通常是注意力层的Q/K/V投影)
        if isinstance(module, nn.Linear) and module.weight.shape[0] == module.weight.shape[1]:
            # 为线性层添加LoRA子模块
            lora = LoRA(module.weight.shape[0], module.weight.shape[1], rank=rank).to(model.device)
            setattr(module, "lora", lora)

            # 重写forward方法:原输出 + LoRA输出
            original_forward = module.forward
            def forward_with_lora(x, layer1=original_forward, layer2=lora):
                return layer1(x) + layer2(x)  # 原路径 + 低秩路径
            module.forward = forward_with_lora
(3)LoRA 权重的保存与加载
# 仅保存含"lora"的参数(避免保存整个模型)
def save_lora(model, path):
    state_dict = {}
    for name, module in model.named_modules():
        if hasattr(module, 'lora'):
            # 为参数添加模块名前缀,避免冲突
            lora_state = {f'{name}.lora.{k}': v for k, v in module.lora.state_dict().items()}
            state_dict.update(lora_state)
    torch.save(state_dict, path)

# 加载LoRA权重到对应模块
def load_lora(model, path):
    state_dict = torch.load(path, map_location=model.device)
    for name, module in model.named_modules():
        if hasattr(module, 'lora'):
            # 提取当前模块的LoRA参数
            lora_state = {k.replace(f'{name}.lora.', ''): v
                          for k, v in state_dict.items() if f'{name}.lora.' in k}
            module.lora.load_state_dict(lora_state)
LoRA 的训练流程与全量微调类似,但核心差异在于仅优化 LoRA 参数
(4)实战指南:用 LoRA 打造领域模型
1. 数据集准备
需准备 JSONL 格式的对话数据,放置于./dataset/lora_xxx.jsonl,示例:
{"conversations": [{"role": "user", "content": "颈椎病患者适合多高的枕头?"},
                   {"role": "assistant", "content": "颈椎病患者的枕头高度建议与本人拳头高度相当..."}]}
2. 启动训练
# 单卡训练
python train_lora.py --data_path ../dataset/lora_medical.jsonl --lora_name lora_medical

# 多卡分布式训练
torchrun --nproc_per_node 2 train_lora.py --ddp --lora_name lora_medical
3. 关键参数说明
--lora_name:指定 LoRA 权重的保存名称(需与任务匹配,如lora_medical)--learning_rate:LoRA 学习率通常高于全量微调(建议 1e-4,全量微调约 5e-7)--save_interval:每隔多少步保存一次 LoRA 权重(默认 100 步,新权重会覆盖旧权重)
通过 LoRA 技术,我们既能让大模型快速适配特定任务,又能保持其原有能力,是平衡效果与成本的理想选择。
四、避坑指南:部署中常见问题总结
- JSON 解析错误:多因数据集存在格式异常行,通过添加错误捕获逻辑跳过即可,不影响整体训练。
- 编码问题:中文数据集可能存在 utf-8/gbk 混合编码,需在加载时尝试多种编码。
- 显存溢出:若报
CUDA out of memory,可降低batch_size或max_seq_len(如从 8→4,512→256)。
五、总结与拓展
通过 MiniMind 的部署实践,我们不仅训练出了一个可用的轻量语言模型,更深入理解了 LLM 的核心流程:从分词器训练到预训练、微调,每一步都是对大模型原理的直观体验。
对于新手而言,这只是开始:后续可尝试多卡加速训练(torchrun --nproc_per_node 2 train_pretrain.py)、部署 OpenAI 兼容 API(python scripts/serve_openai_api.py),或基于模型开发简单聊天应用。
结语
MiniMind 的价值不在于性能超越大模型,而在于为普通人打开了 "亲手造模型" 的大门。正如项目所说:"希望每个人都能感受创造的乐趣,推动 AI 社区的进步!"
感谢大佬原创开源项目:https://github.com/jingyaogong/minimind
技术交流欢迎私信——本人技术有限,不喜勿喷,但乐于与各位同行交流学习,共同进步。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 41
 0
- 0


 已为社区贡献1条内容

所有评论(0)