机器学习项目:python考研院校推荐系统 协同过滤推荐算法 爬虫 混合推荐 推荐系统 可视化 Django框架 大数据(源码+文档)✅
·
博主介绍:✌全网粉丝50W+,前互联网大厂软件研发、集结硕博英豪成立软件开发工作室,专注于计算机相关专业项目实战6年之久,累计开发项目作品上万套。凭借丰富的经验与专业实力,已帮助成千上万的学生顺利毕业,选择我们,就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2025年计算机专业毕业设计选题汇总(建议收藏)✅
1、项目介绍
技术栈:
Python语言 MySQL数据库 Django框架 协同过滤推荐算法 requests网络爬虫 pyecharts数据可视化 html页面、爬取院校信息:https://yz.chsi.com.cn/sch/(研招网)
备注:已更新最新数据-----2025.4.9
在当下的考研热潮中,众多考生面临着选择合适院校的难题,而院校信息的海量性与复杂性使得个性化院校推荐和数据可视化分析成为解决问题的关键。考研院校数据分析与可视化系统的开发,旨在为考生提供一个直观、易用的决策支持工具,通过数据可视化和智能推荐算法,帮助考生更加科学地进行院校选择,从而提高考研的效率和成功率。该系统利用最新的Web技术和数据分析方法,将复杂的院校数据转化为直观的图表和推荐列表,极大地简化了考生的决策过程,具有重要的实用价值和广阔的应用前景。
系统基于Django框架开发,前端采用HTML、CSS、JavaScript,后端应用协同过滤算法进行智能数据处理,通过echarts库实现数据可视化。具体完成了院校查看、数据可视化分析、院校推荐、用户评分和用户收藏等业务功能。这些功能的集成,不仅提高了系统的互动性和个性化服务水平,还使得复杂的数据分析结果以直观的方式呈现给用户,帮助用户深入了解各院校的特色和优势。
通过引入协同过滤算法和数据可视化技术,考研院校数据分析与可视化系统有效解决了考生在选择院校时信息过载和决策困难的问题。系统的智能推荐算法根据用户的历史行为和偏好,精准推荐符合用户需求的院校,而数据可视化的应用则使得复杂的院校信息和用户数据变得易于理解和分析。这些优势不仅为考生提供了便捷高效的院校选择方案,也为高等教育资源的合理分配和利用提供了技术支撑,具有显著的社会效益和经济价值。
2、项目界面
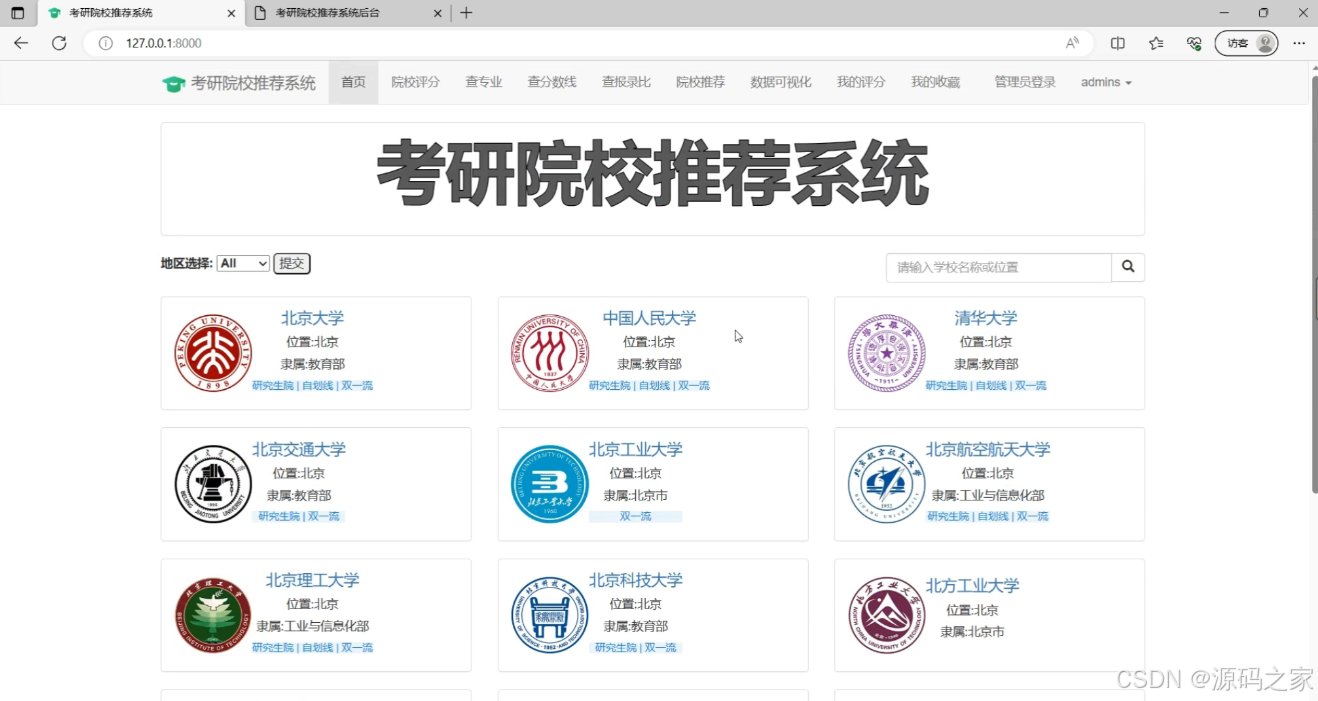
(1)首页院校展示
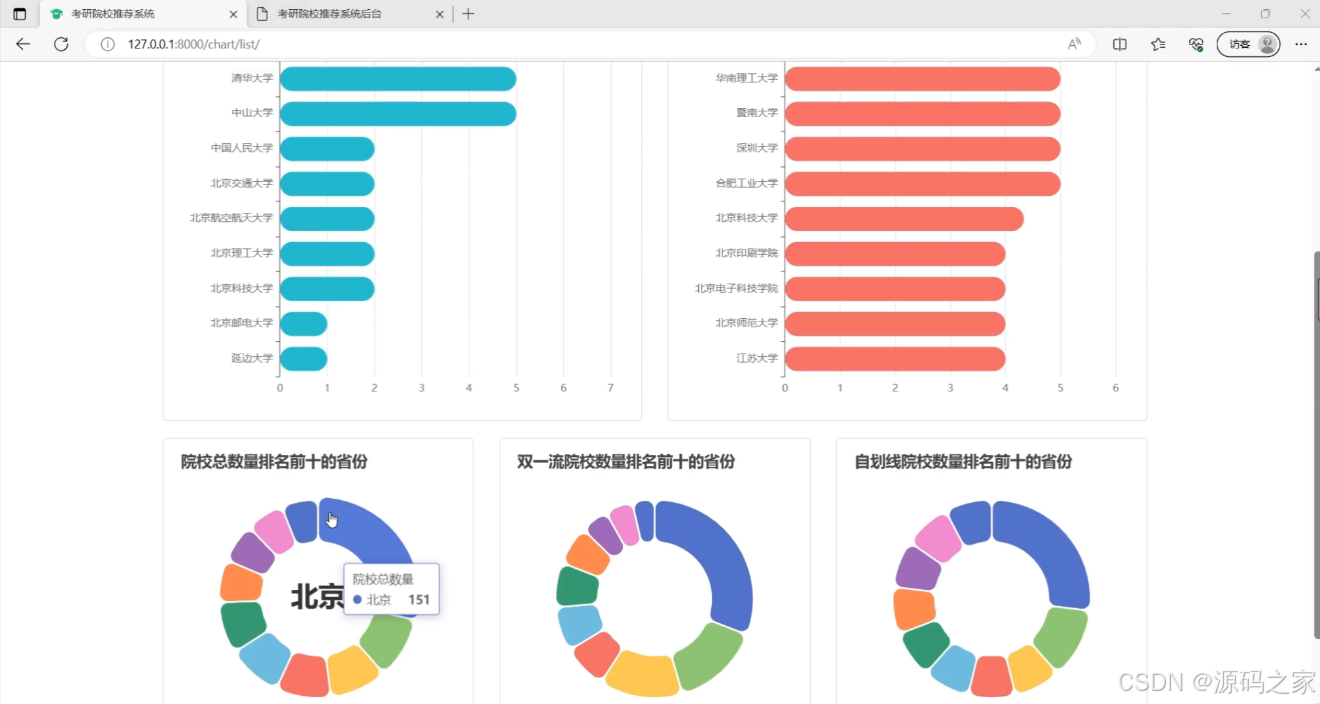
(2)数据可视化分析
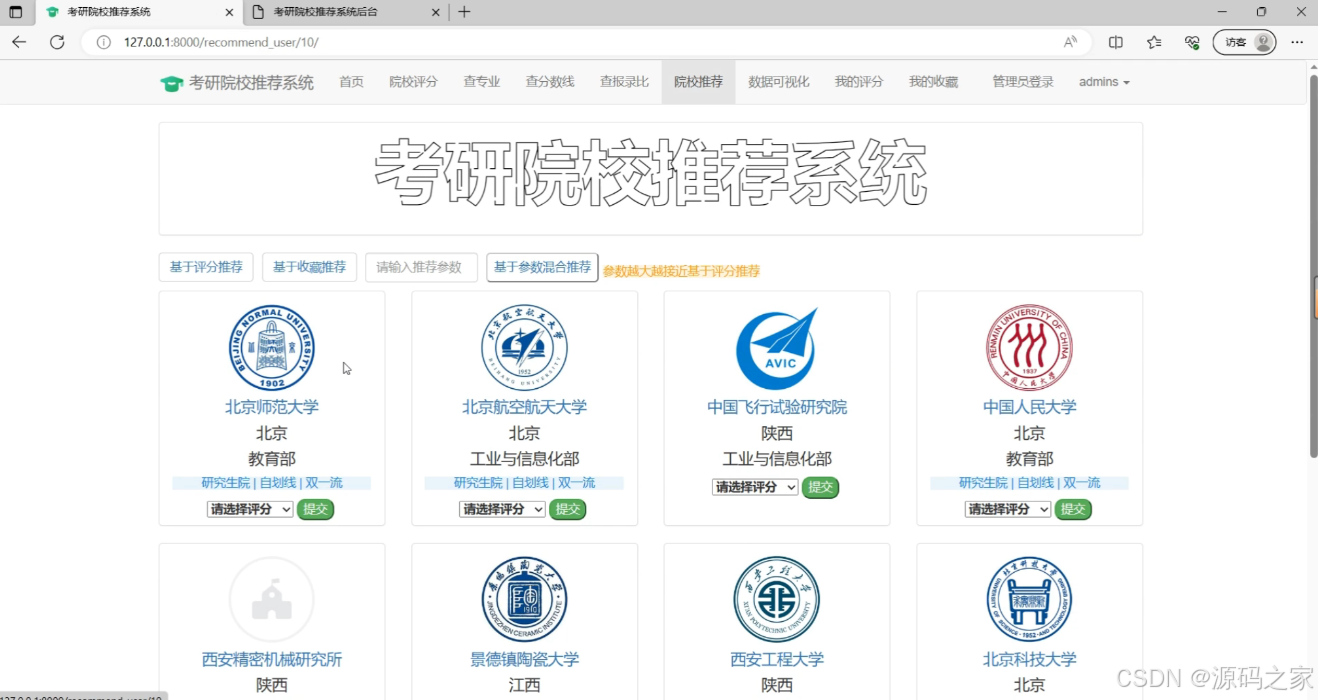
(3)院校推荐模块—混合推荐(协同过滤推荐算法)
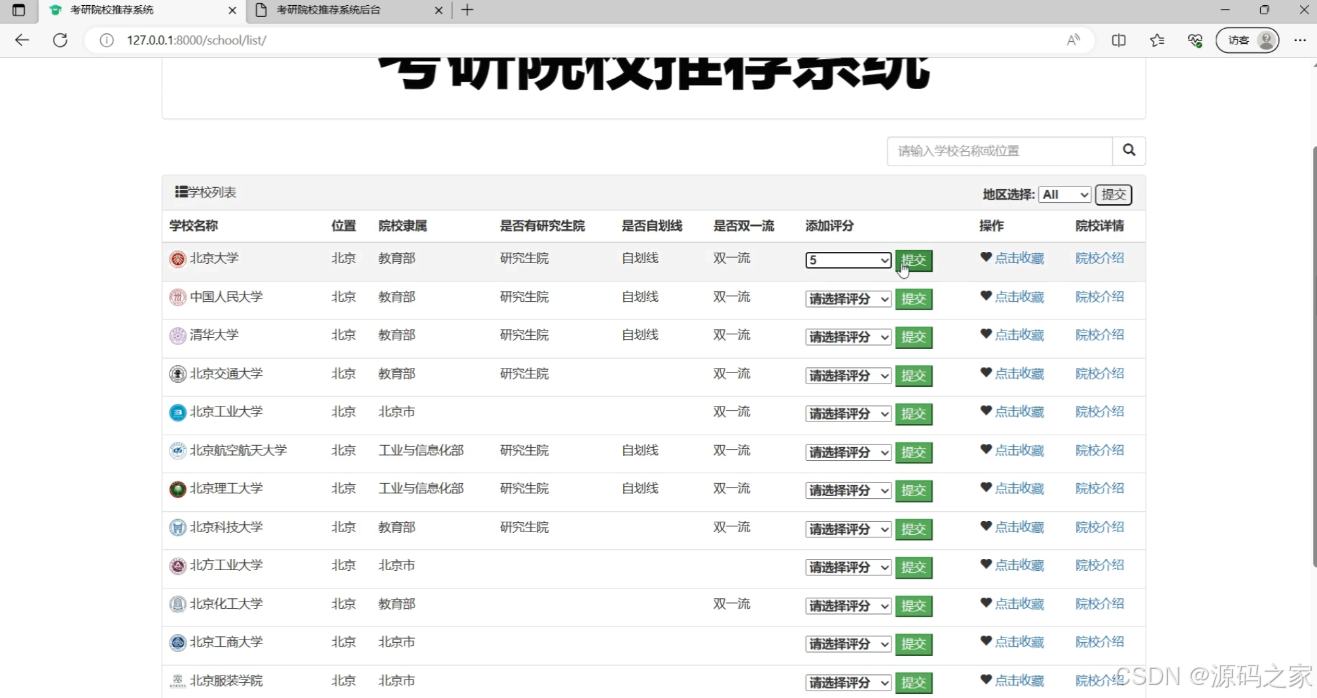
(4)院校评分、收藏
(5)报录比查询
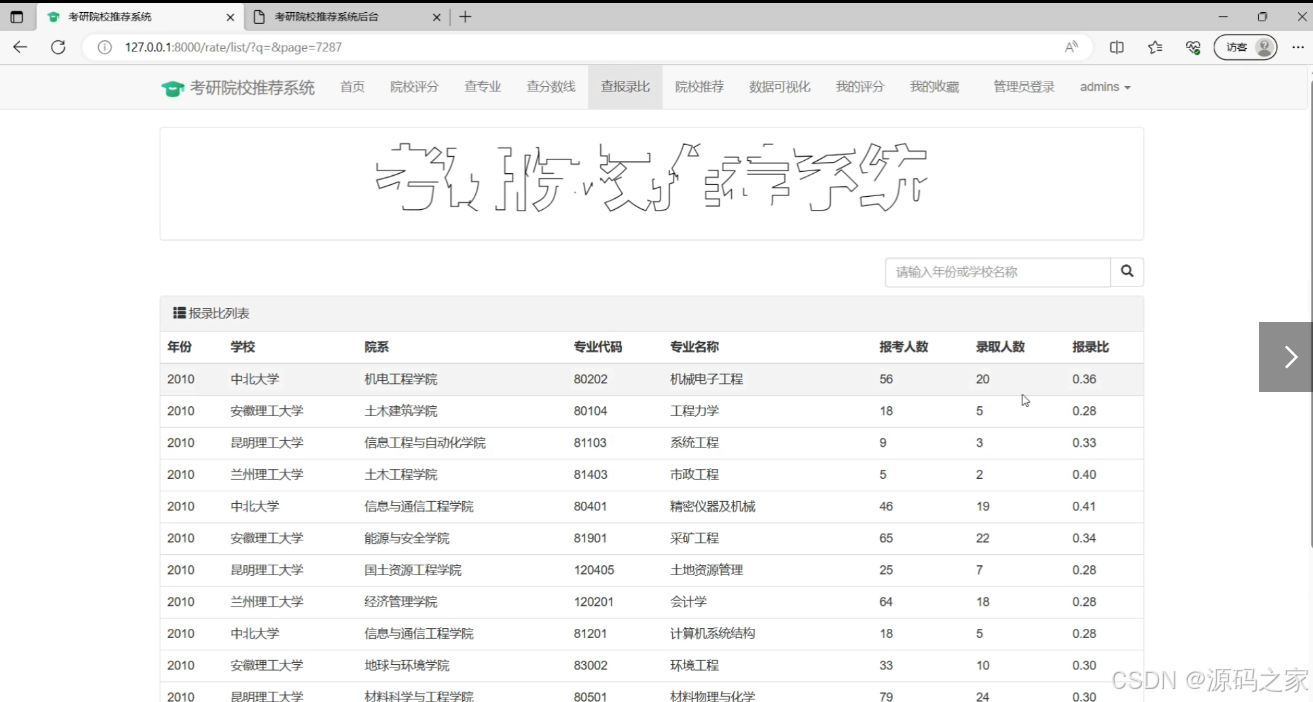
(6)我的收藏
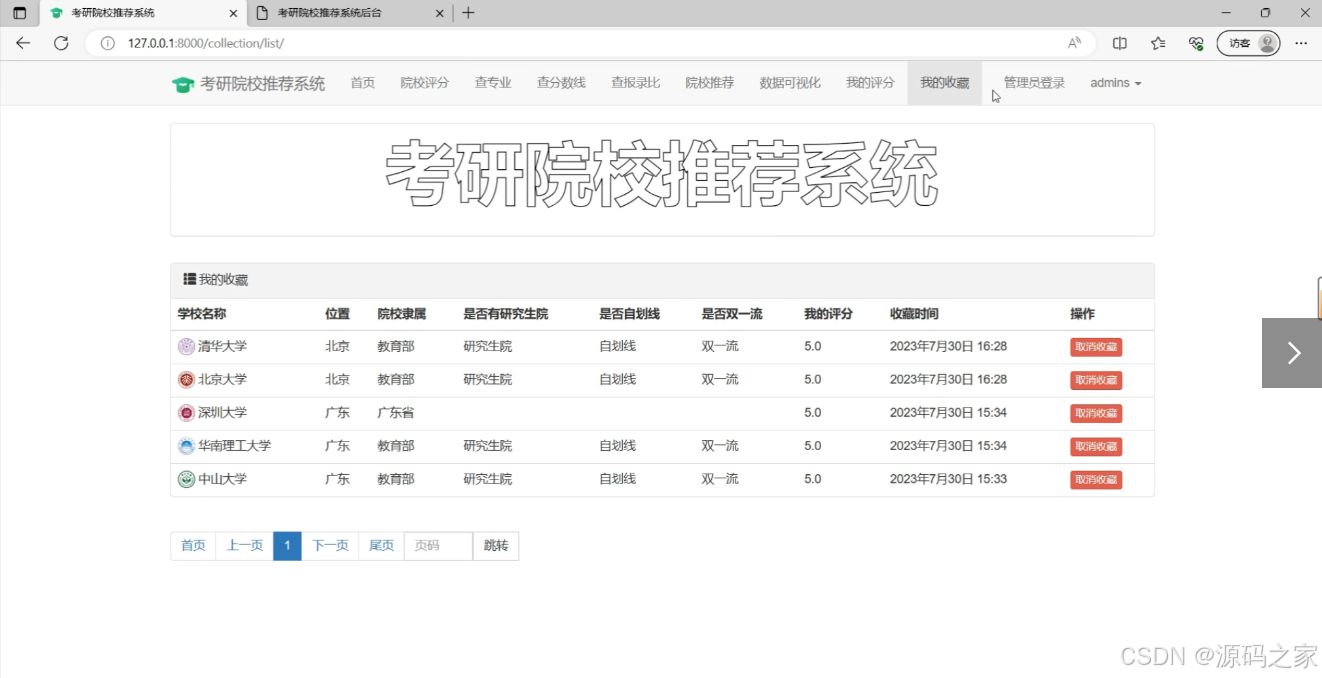
(7)后台数据管理
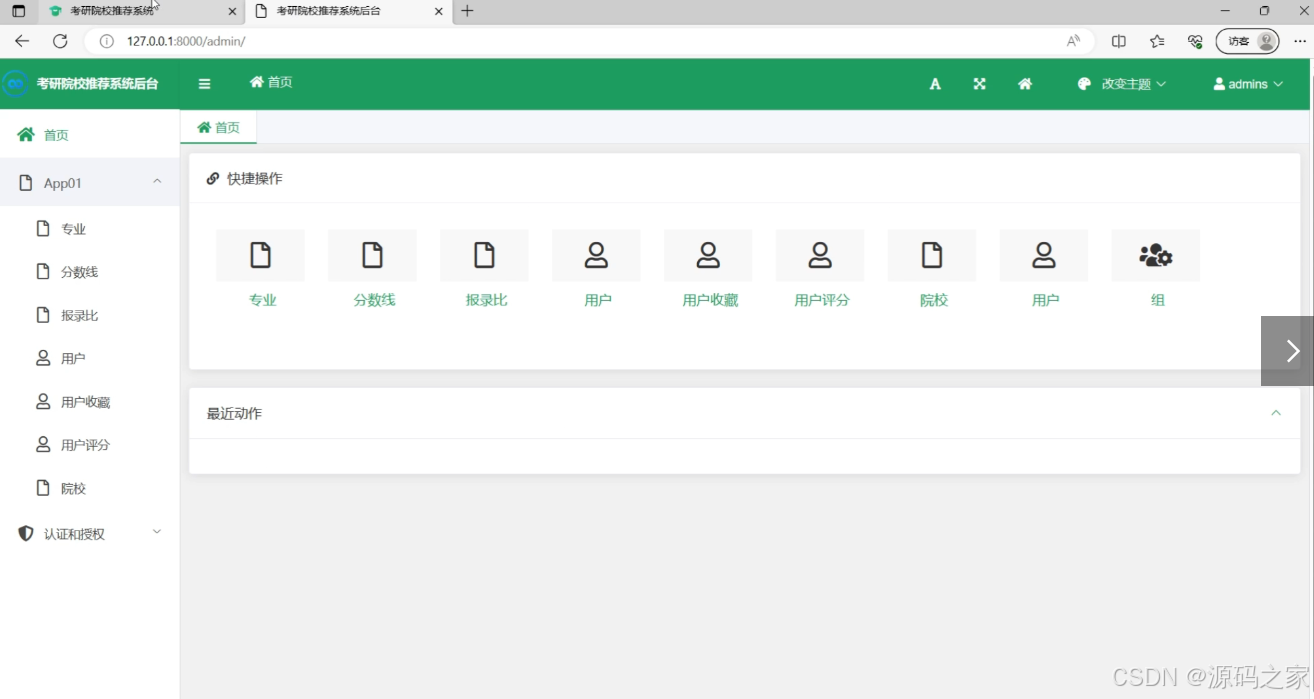
(8)数据采集
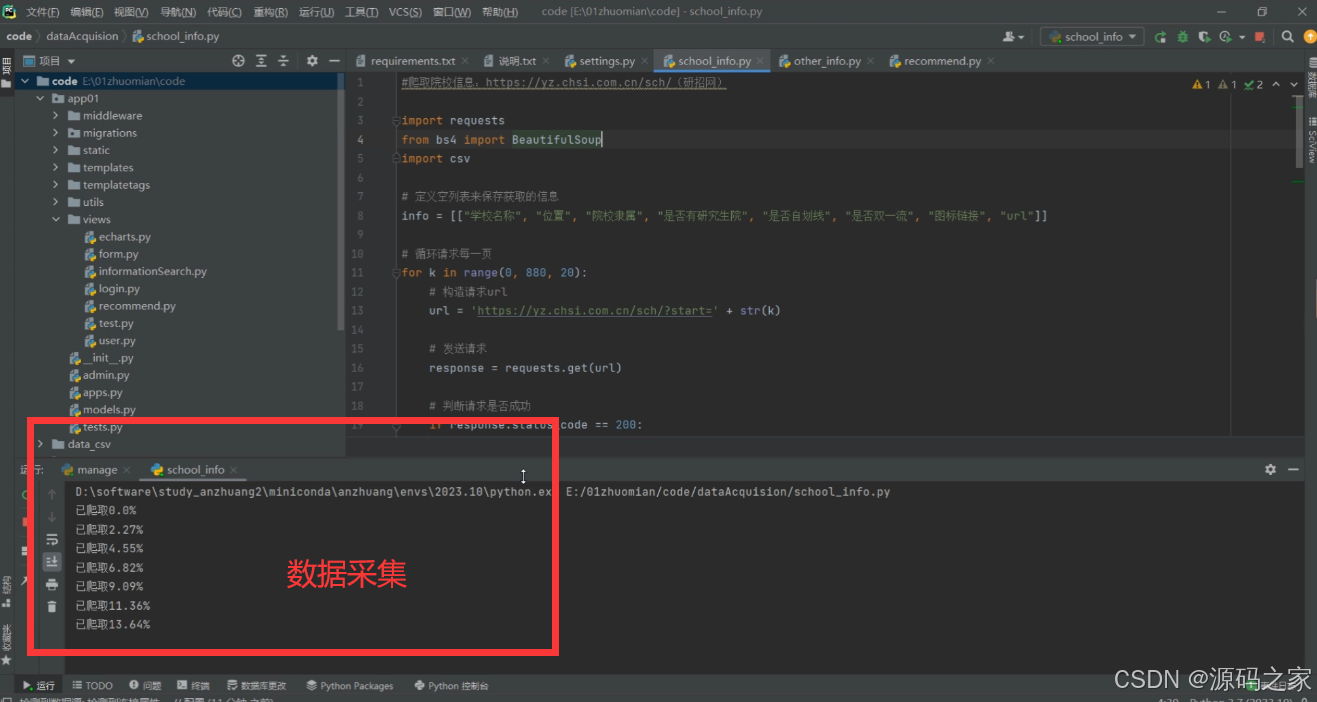
3、项目说明
在当下的考研热潮中,众多考生面临着选择合适院校的难题,而院校信息的海量性与复杂性使得个性化院校推荐和数据可视化分析成为解决问题的关键。考研院校数据分析与可视化系统的开发,旨在为考生提供一个直观、易用的决策支持工具,通过数据可视化和智能推荐算法,帮助考生更加科学地进行院校选择,从而提高考研的效率和成功率。该系统利用最新的Web技术和数据分析方法,将复杂的院校数据转化为直观的图表和推荐列表,极大地简化了考生的决策过程,具有重要的实用价值和广阔的应用前景。
系统基于Django框架开发,前端采用HTML、CSS、JavaScript,后端应用协同过滤算法进行智能数据处理,通过echarts库实现数据可视化。具体完成了院校查看、数据可视化分析、院校推荐、用户评分和用户收藏等业务功能。这些功能的集成,不仅提高了系统的互动性和个性化服务水平,还使得复杂的数据分析结果以直观的方式呈现给用户,帮助用户深入了解各院校的特色和优势。
通过引入协同过滤算法和数据可视化技术,考研院校数据分析与可视化系统有效解决了考生在选择院校时信息过载和决策困难的问题。系统的智能推荐算法根据用户的历史行为和偏好,精准推荐符合用户需求的院校,而数据可视化的应用则使得复杂的院校信息和用户数据变得易于理解和分析。这些优势不仅为考生提供了便捷高效的院校选择方案,也为高等教育资源的合理分配和利用提供了技术支撑,具有显著的社会效益和经济价值。
关键词:考研院校数据分析与可视化系统;Django;协同过滤算法;echarts;数据可视化
4、核心代码
import random

from django.shortcuts import render
import math
from app01 import models
from app01.models import School, UserScore, User, UserCollection
from app01.utils.pagination import Pagination


def jaccard_similarity(a, b):
    # 计算杰卡德相似度
    # 将布尔向量转换为集合
    set_a = set(i for i, x in enumerate(a) if x)
    # print("set_a:", set_a)
    set_b = set(i for i, x in enumerate(b) if x)
    # print("set_b:", set_b)
    # 计算交集和并集的大小
    intersection = len(set_a.intersection(set_b))
    # print("a和b交集:", set_a.intersection(set_b))
    union = len(set_a.union(set_b))
    # print("a和b并集:", set_a.union(set_b))
    # 计算相似度
    similarity = intersection / union if union else 0
    return similarity

#重载字典计算方法
class MyDict(dict):
    def __add__(self, other):
        res = MyDict(self)
        for key, val in other.items():
            if key in res:
                res[key] += val
            else:
                res[key] = val
        return res

    def __mul__(self, factor):
        res = MyDict()
        for key, val in self.items():
            res[key] = val * factor
        return res

    def __rmul__(self, factor):
        return self.__mul__(factor)


def cosine_similarity(v1, v2):
    # 计算余弦相似度
    numerator = sum([a * b for a, b in zip(v1, v2)])  # 两向量的内积作为分子
    denominator = math.sqrt(sum([a ** 2 for a in v1])) * math.sqrt(sum([b ** 2 for b in v2]))  # 两向量模长的乘积作为分母
    if denominator > 0:
        return numerator / denominator
    else:
        return 0


# 基于用户收藏计算当前用户与其他用户的杰卡德相似度
def user_jaccard_similarity_collections(user_id, default_similarity_jaccard=0):
    # 获取当前用户的收藏数据
    user_collections = UserCollection.objects.filter(user_id=user_id).values('school_id', 'collection')
    # 获取当前用户收藏的学校id
    user_collections_school_id = [user_collection['school_id'] for user_collection in user_collections]
    # print("当前用户收藏情况:")
    # print(user_collections_school_id)
    # print("基于用户收藏的邻居用户收藏情况:")
    # 构造当前用户收藏向量
    user_collection_vector = [0 for i in range(999)]
    for school_id in user_collections_school_id:
        user_collection_vector[school_id] = 1

    similarities_jaccard = {}  # 定义字典来存放与当前用户相似用户的id和相似度
    for user in User.objects.exclude(id=user_id):
        # 获取当前用户与其他用户共同收藏的物品的id
        collections = user.usercollections.filter(school_id__in=user_collections_school_id).values('school_id')
        if collections:  # 如果当前用户与该用户有共同收藏的学校,则计算当前用户与该用户的相似度,这里使用杰卡德
            # 获取该用户所有的收藏情况:(school_id)
            collections = user.usercollections.filter().values('school_id')
            collections_school_id = [(collection['school_id']) for collection in collections]
            # print(collections_school_id)
            # 构造该用户收藏向量:collection_vector
            collection_vector = [0 for i in range(999)]
            for school_id in collections_school_id:
                collection_vector[school_id] = 1
            #     collection_vector[0] = user.id
            # print(collection_vector)
            # 计算两用户之间的杰卡德相似度
            similarity_jaccard = jaccard_similarity(user_collection_vector, collection_vector)
            if similarity_jaccard > default_similarity_jaccard:
                similarities_jaccard[user.id] = similarity_jaccard
    return similarities_jaccard
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目编程以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 33
 0
- 0


 已为社区贡献80条内容

所有评论(0)