python文本评论情感分析预测 KNN算法SVM算法 朴素贝叶斯算法 决策树算法 MINIST数据 机器学习 大数据 毕业设计(建议收藏)✅
·
博主介绍:✌全网粉丝50W+,前互联网大厂软件研发、集结硕博英豪成立软件开发工作室,专注于计算机相关专业项目实战6年之久,累计开发项目作品上万套。凭借丰富的经验与专业实力,已帮助成千上万的学生顺利毕业,选择我们,就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2025年计算机专业毕业设计选题汇总(建议收藏)✅
1、项目介绍
技术栈:
python语言、pyqt界面、requests爬虫、KNN > SVM > 朴素贝叶斯算法 > 决策树算法(多算法对比)、matplotlib可视化
系统功能
1.重点是算法比较 各个算法参数 产生的图和数据足够了 做影评参照
2.自适应svm 既然加了自适应 那它比svm的优势在哪,自适应也是逐步完善的算法 拿新的和旧的比较一下
3.分析结果显示 调图标库即可,条状图 饼状图之类的 也不需要做成网页的
本次实验我采用了SVM、决策树算法、朴素贝叶斯算法、KNN四中算法对MINIST数据进行分类。
从实验结果来看,就准确率而言: KNN > SVM > 朴素贝叶斯算法 > 决策树算法。
摘 要
随着经济的发展和人们生活水平的提升,电影作为丰富人们文化生活的重要组成部分,通过电影可以帮助人们丰富业余生活,同时电影也可以实现不同国家之间的文化交流,在近一百年的电影发展历程中,人们对于电影的了解逐渐深入也让电影消费成为了经济体中必不可少的一个环节,电影评价在电影消费和发展上起到了至关重要的作用,很多观众选择观看的电影不仅要看题材、演员阵容,对于影视作品的评价也成为了观影抉择的一个重要因素,同时通过电影评价的高低也可以间接的反应出观众对于电影的认同度,也给电影制作方和发行方提供了一定的数据支持,电影评价倾向性在一定程度上会影响电影的票房。随着预测技术及统计分析领域的相关技术越发成熟,对于电影票房预测、影评分析等内容成为了很多电影平台的重要功能模块,电影评价预测会受到数据不规整以及预测精度欠缺的影响,利用现有的运算技术实现更加精准的电影评价分析可以帮助更好的预测电影的票房成绩。
本文结合当前电影市场的现状以及电影评价预测意义,利用Python编程语言基于C/S结构开发设计针对电影评价倾向性分析的系统平台,同时为了确保电影评价分析数据信息判断的精确性,通过自适应SVM支持向量机的算法应用,实现了数据信息的分类提取,结合电影评价内容实现积极和消极影评数字信息的分类,结合电影评价的统计图例帮助更好的了解电影评价倾向性,结合数据预处理、特征量化以及模型结构的确认来实现电影影评的分析,对于电影票房预测提供了更加详尽的数据信息支持。
关键词:Python语言;Mysql数据库;自适应SVM;电影评价倾向性;
2、项目界面
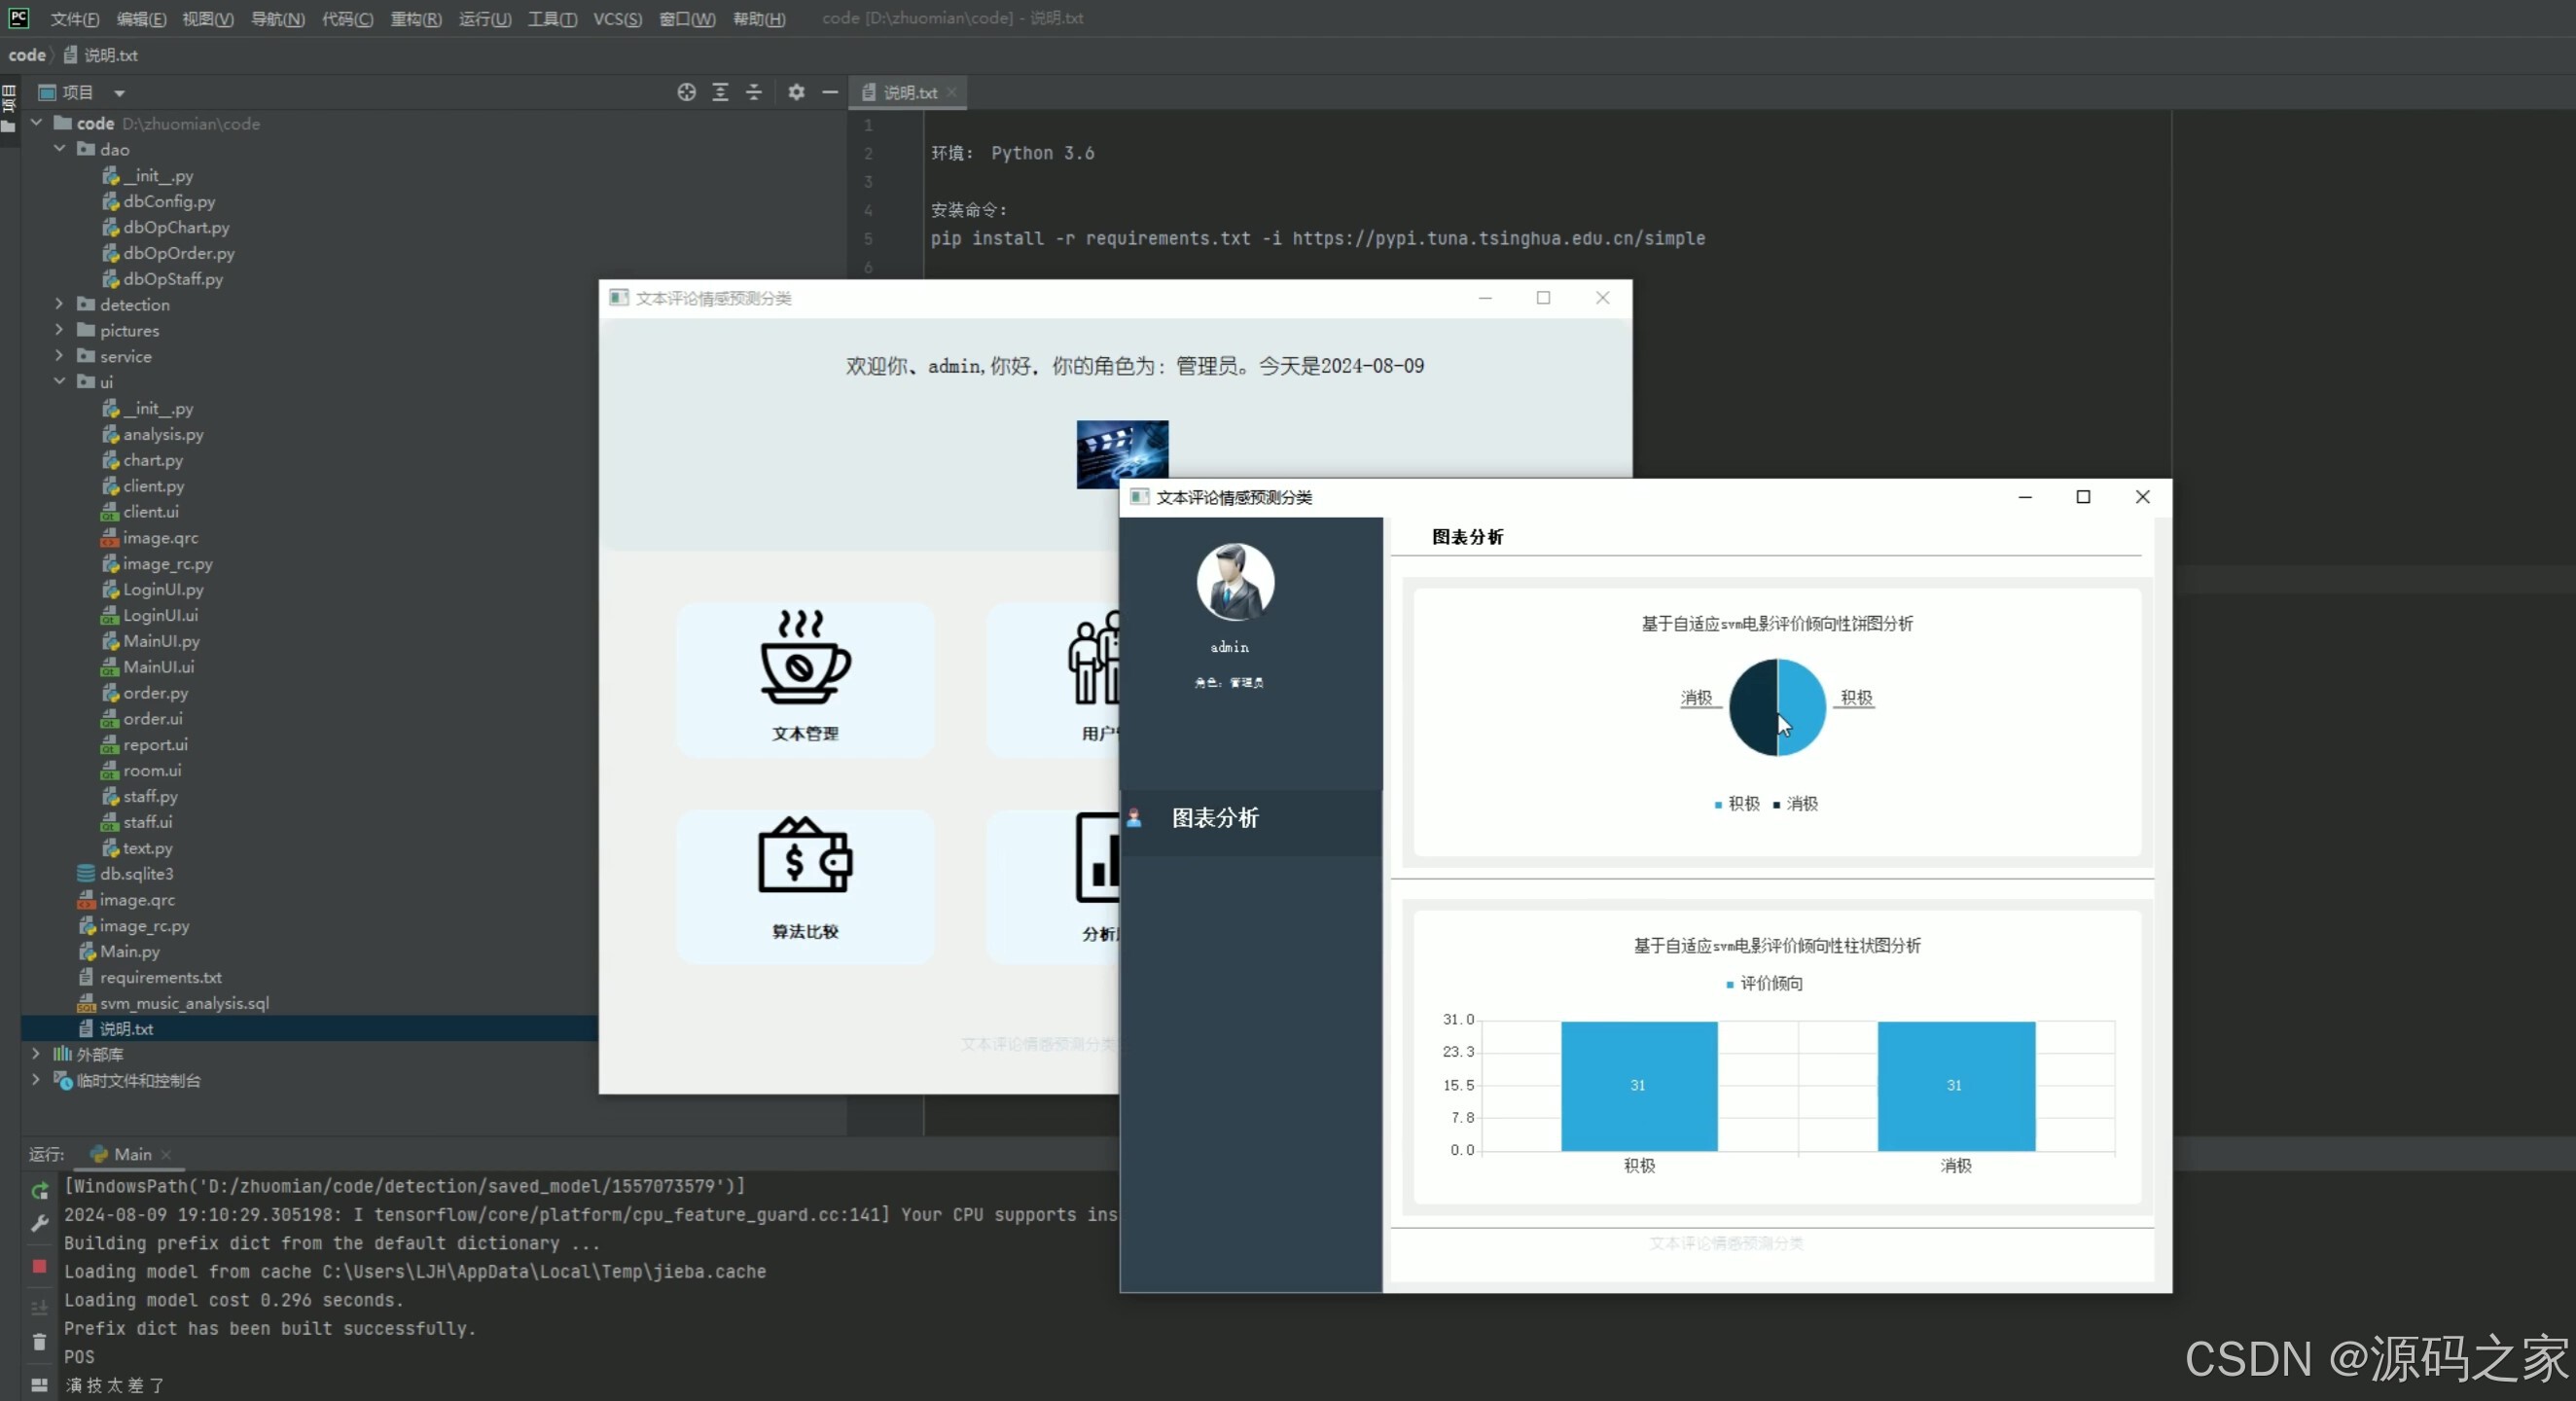
(1)数据图表分析
(2)系统功能

(3)文本评论列表

(4)文本评论预测–积极、消极

(5)算法比较、优缺点

(6)登录

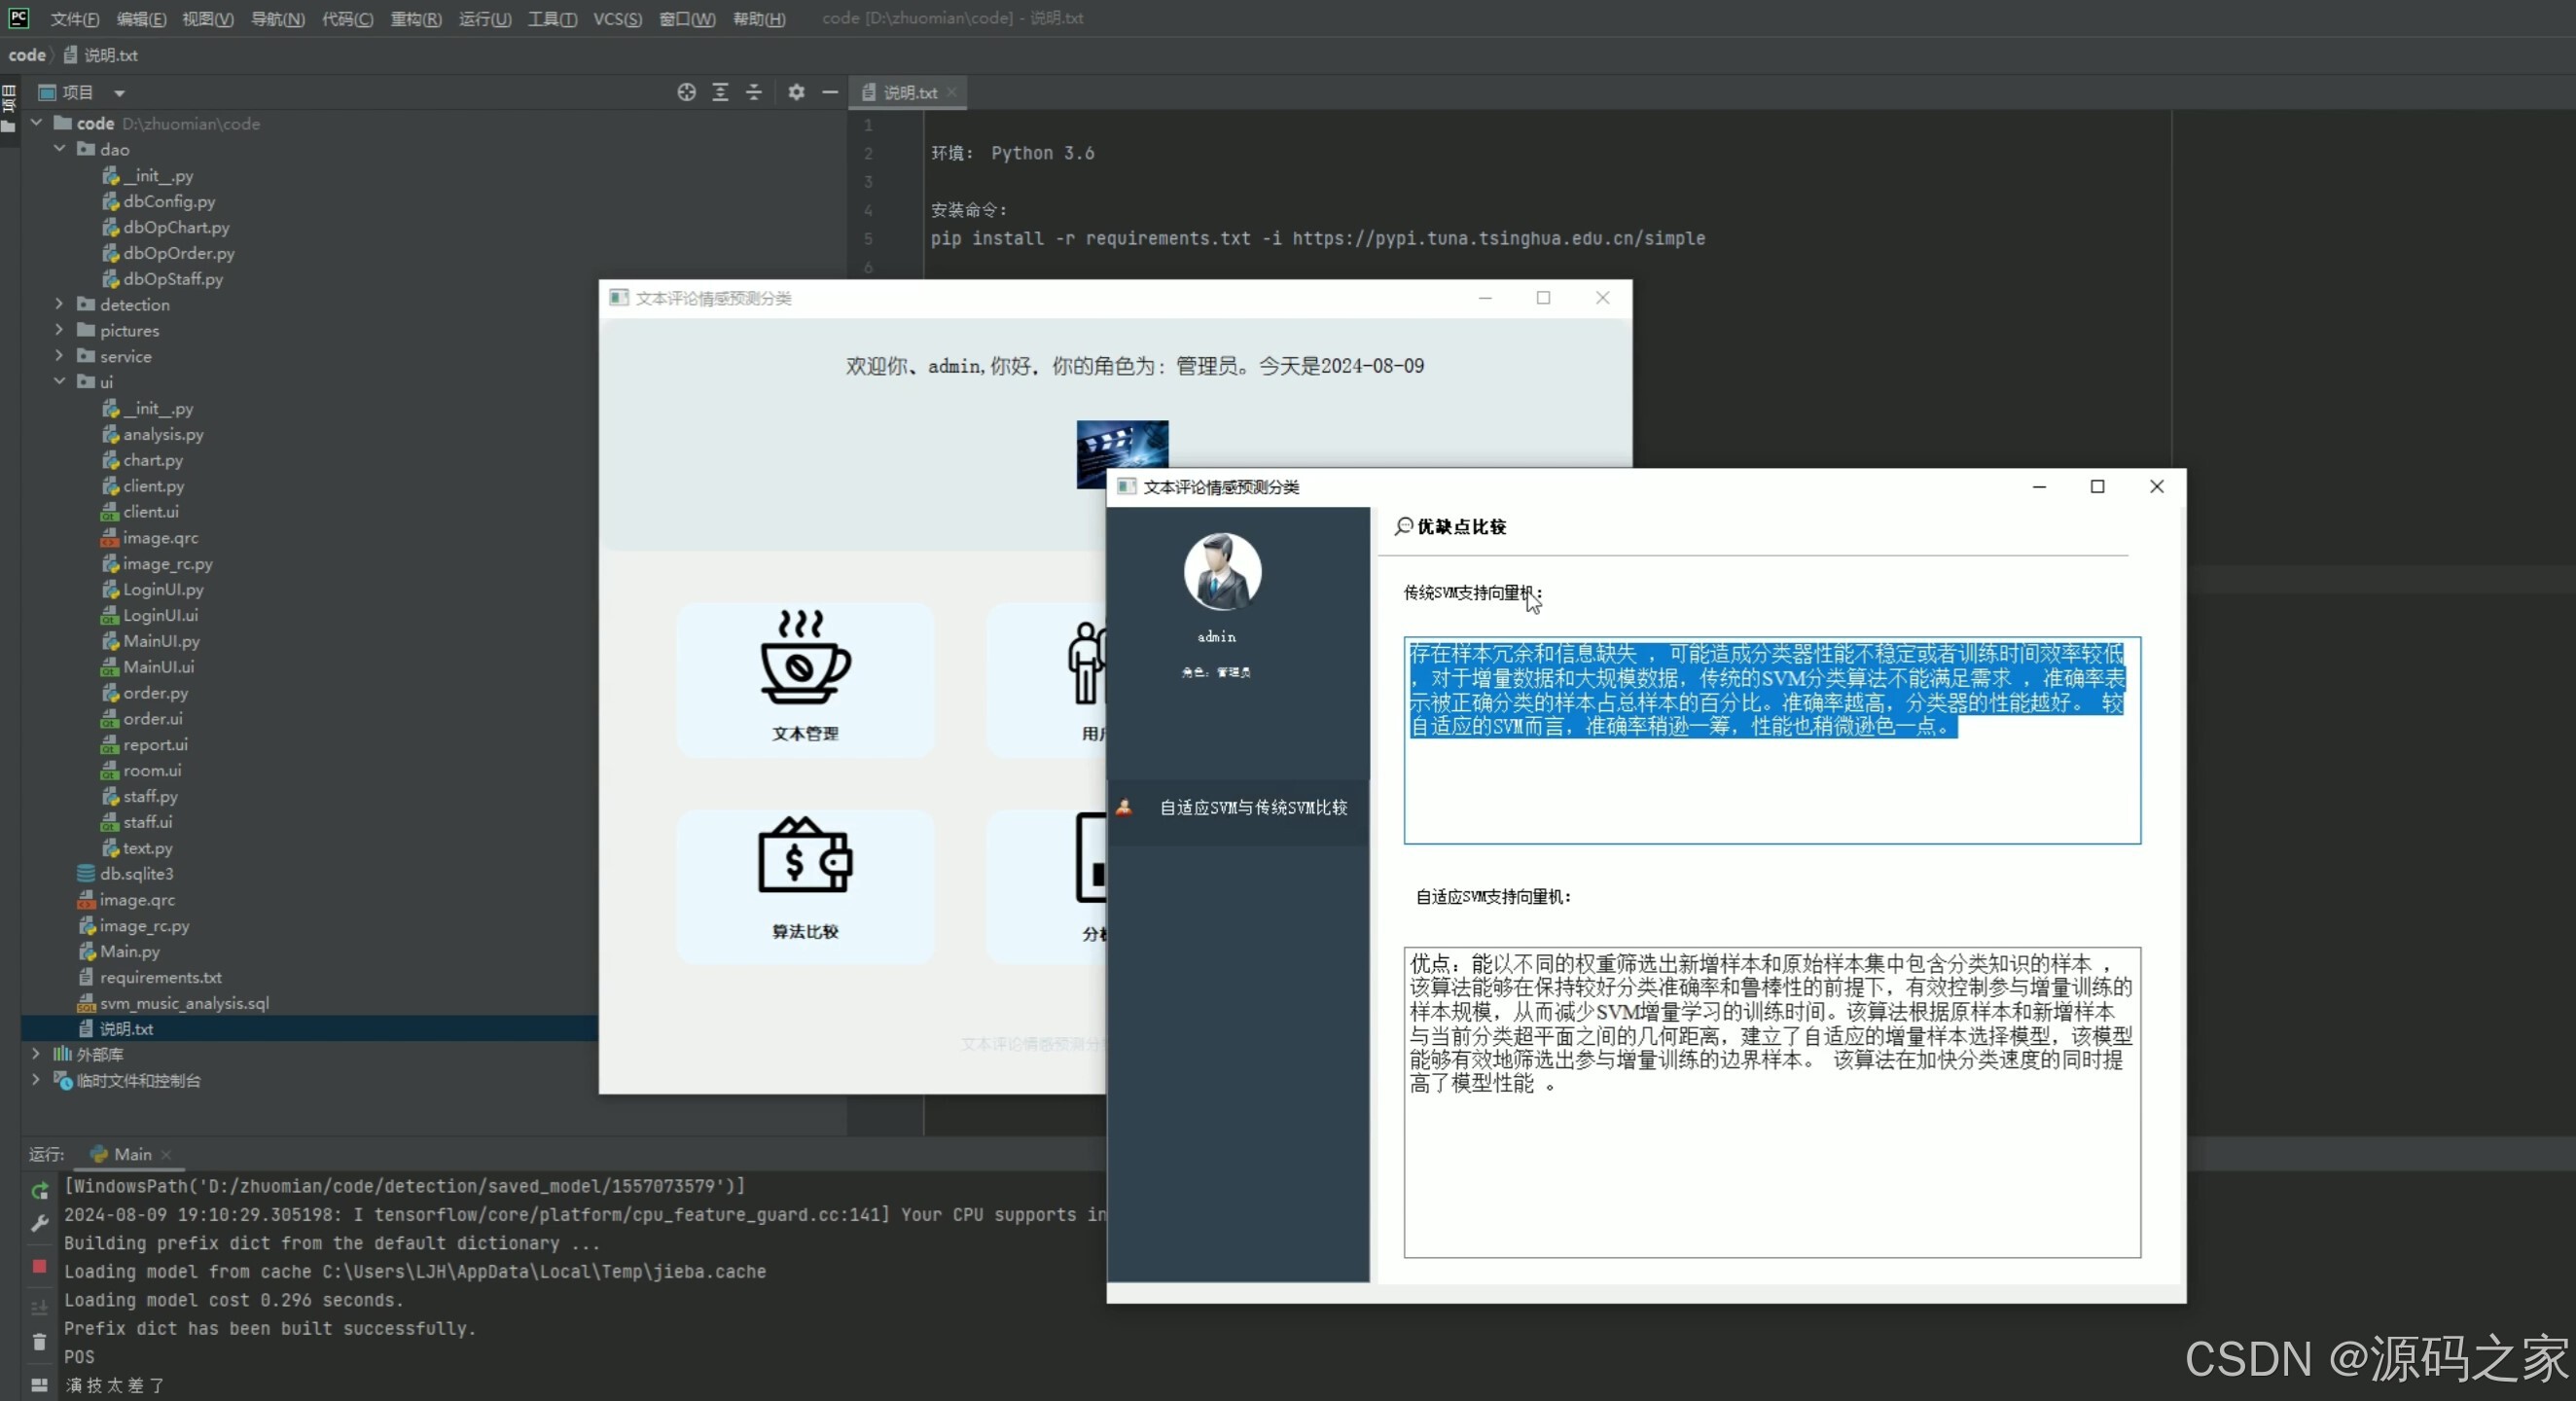
(7)新旧对比
(8)个人中心
3、项目说明
5.1 系统主页
此次对于电影评价倾向性系统平台的主业内容主要包括了电影评论管理、系统注册用户管理、评论预测、新旧对比、评价分析展示以及算法对比等内容,作为分析型的系统平台,通过评论信息的录入可以判断评价内容的所属类型,具体系统主页的主要功能模块内容呈现如下图所示:
图5.1 系统主页
5.2评论管理界面
通过评论管理界面可以查看到最新的电影评价信息以及对应的分析评价状态,结合电影评价文本的字段内容来搭判断电影评价属于积极还是消极,通过时还包括了相关评论的评论人及点评点赞次数,通过更新数据可以实现评论信息的自动刷新。
图5.2评论管理界面
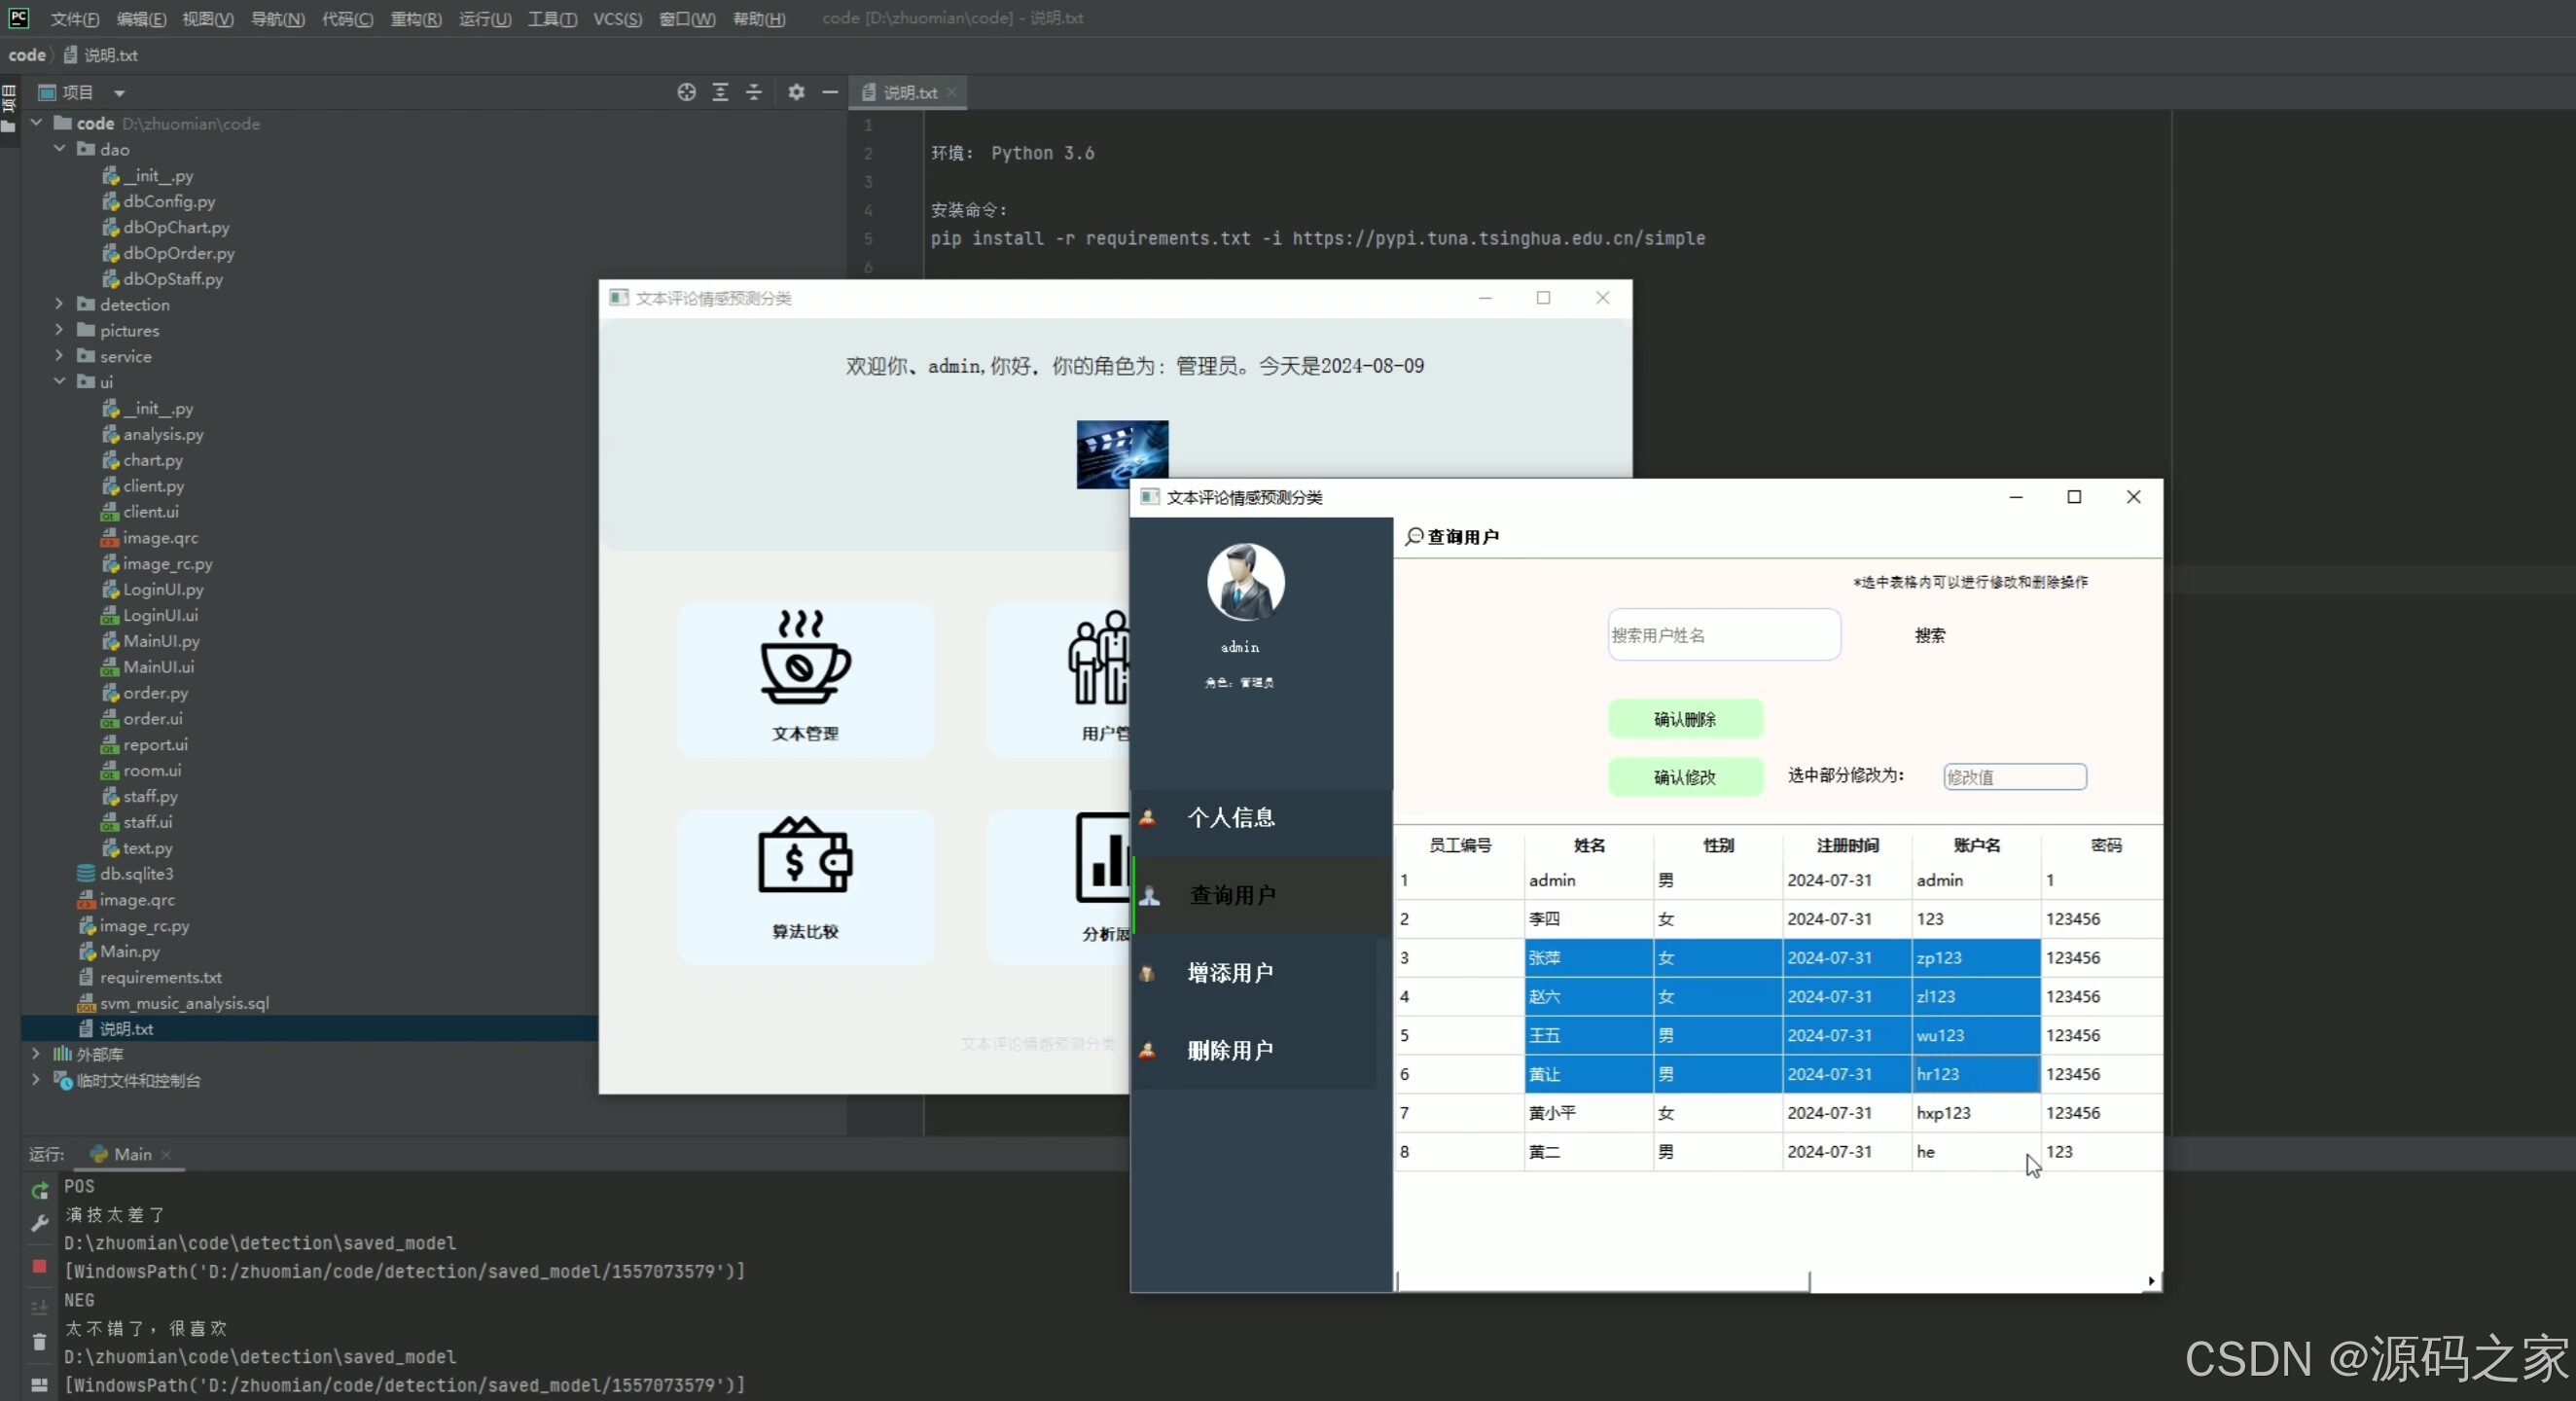
5.3用户管理
通过用户管理界面可以实现用户信息的查询、新增以及删除,用户信息主要包括了用户编号、姓名、性别、注册时间、身份证号以及手机号等个人基本资料,同时还包括登录系统所需要的账户名、密码和权限,通过用户管理界面可以实现个人资料的修改和新增。
图5.3用户管理界面
5.5评论预测界面
用户通过评价预测界面可以实现电影评价信息的录入,通过点击开始识别按钮可以实现在线的评价测评,结合系统算法实现了测评结果信息的反馈,具体评论预测界面内容呈现如下图所示:
图5.4评论预测界面
5.5 算法准确率比较
通过算法比较窗口可以实现不同算法的准确率的对比,对于SVM、决策树算法、朴素贝叶斯算法以及KNN算法这四种算法的数据准确率进行对比,通过数据分类对比结果KNN>SVM>朴素贝叶斯算法>决策树算法,具体准确率对比界面呈现如下:
图5.5 算法准确率比较
5.6 算法优缺点比较
系统同时对于四种算法的优缺点进行了比较分析,具体四种算法优缺点的内容呈现如下图所示:
图5.6 算法优缺点比较
5.7 自适应SVM与SVM对比
相比传统的SVM支持向量算法,自适应SVM支持向量算法能够实现较高的数据分类准确性,通过自适应增量样本选择模型的建立来有效的筛选出增量训练的边界样本,提升了数据分类的速度,传统的SVM支持向量算法在运算的效率和准确率上都略逊一筹。
图5.7 自适应SVM与SVM对比
5.8 电影评价倾向性图表分析
通过图表分析洁敏可以查看到系统内的电影评价倾向性分析数据统计,结合饼状图和柱状图来呈现电影评价积极和消极的分类占比,利用图表呈现更加直观的分析结果。
图5.8电影评价倾向性图表分析
4、核心代码
import sys
import json
import logging
import functools
import numpy as np
import tensorflow as tf
from pathlib import Path

DATA_DIR = '../../data/hotel_comment'

# Logging
Path('results').mkdir(exist_ok=True)
tf.logging.set_verbosity(logging.INFO)
handlers = [
    logging.FileHandler('results/main.log'),
    logging.StreamHandler(sys.stdout)
]
logging.getLogger('tensorflow').handlers = handlers


# Input function
def parse_fn(line_words, line_tag):
    # Encode in Bytes for TF
    words = [w.encode() for w in line_words.strip().split()]
    tag = line_tag.strip().encode()
    return (words, len(words)), tag


def generator_fn(words, tags):
    with Path(words).open('r', encoding='utf-8') as f_words, Path(tags).open('r', encoding='utf-8') as f_tags:
        for line_words, line_tag in zip(f_words, f_tags):
            yield parse_fn(line_words, line_tag)


def input_fn(words_path, tags_path, params=None, shuffle_and_repeat=False):
    params = params if params is not None else {}
    shapes = (([None], ()), ())  # shape of every sample
    types = ((tf.string, tf.int32), tf.string)
    defaults = (('<pad>', 0), '')

    dataset = tf.data.Dataset.from_generator(
        functools.partial(generator_fn, words_path, tags_path),
        output_shapes=shapes, output_types=types)

    if shuffle_and_repeat:
        dataset = dataset.shuffle(params['buffer']).repeat(params['epochs'])

    dataset = (dataset
               .padded_batch(params.get('batch_size', 20), shapes, defaults)
               .prefetch(1))
    return dataset


def model_fn(features, labels, mode, params):
    if isinstance(features, dict):
        features = features['words'], features['nwords']

    # Read vocabs and inputs
    dropout = params['dropout']
    words, nwords = features
    training = (mode == tf.estimator.ModeKeys.TRAIN)
    vocab_words = tf.contrib.lookup.index_table_from_file(
        params['words'], num_oov_buckets=params['num_oov_buckets'])
    with Path(params['tags']).open(encoding='utf-8') as f:
        indices = [idx for idx, tag in enumerate(f)]
        num_tags = len(indices)

    # Word Embeddings
    word_ids = vocab_words.lookup(words)
    w2v = np.load(params['w2v'])['embeddings']
    w2v_var = np.vstack([w2v, [[0.] * params['dim']]])
    w2v_var = tf.Variable(w2v_var, dtype=tf.float32, trainable=False)
    embeddings = tf.nn.embedding_lookup(w2v_var, word_ids)
    embeddings = tf.layers.dropout(embeddings, rate=dropout, training=training)

    # LSTM
    t = tf.transpose(embeddings, perm=[1, 0, 2])
    lstm_cell_fw = tf.contrib.rnn.LSTMBlockFusedCell(params['lstm_size'])
    lstm_cell_bw = tf.contrib.rnn.LSTMBlockFusedCell(params['lstm_size'])
    lstm_cell_bw = tf.contrib.rnn.TimeReversedFusedRNN(lstm_cell_bw)
    _, (cf, hf) = lstm_cell_fw(t, dtype=tf.float32, sequence_length=nwords)
    _, (cb, hb) = lstm_cell_bw(t, dtype=tf.float32, sequence_length=nwords)
    output = tf.concat([hf, hb], axis=-1)
    output = tf.layers.dropout(output, rate=dropout, training=training)

    # FC
    logits = tf.layers.dense(output, num_tags)
    pred_ids = tf.argmax(input=logits, axis=1)

    if mode == tf.estimator.ModeKeys.PREDICT:
        reversed_tags = tf.contrib.lookup.index_to_string_table_from_file(params['tags'])
        pred_labels = reversed_tags.lookup(tf.argmax(input=logits, axis=1))
        predictions = {
            'classes_id': pred_ids,
            'labels': pred_labels
        }
        return tf.estimator.EstimatorSpec(mode, predictions=predictions)

    else:
        # LOSS
        tags_table = tf.contrib.lookup.index_table_from_file(params['tags'])
        tags = tags_table.lookup(labels)
        loss = tf.losses.sparse_softmax_cross_entropy(labels=tags, logits=logits)

        # Metrics
        metrics = {
            'acc': tf.metrics.accuracy(tags, pred_ids),
            'precision': tf.metrics.precision(tags, pred_ids),
            'recall': tf.metrics.recall(tags, pred_ids)
        }

        for metric_name, op in metrics.items():
            tf.summary.scalar(metric_name, op[1])

        if mode == tf.estimator.ModeKeys.TRAIN:
            train_op = tf.train.AdamOptimizer().minimize(
                loss, global_step=tf.train.get_or_create_global_step())
            return tf.estimator.EstimatorSpec(mode, loss=loss, train_op=train_op)
        elif mode == tf.estimator.ModeKeys.EVAL:
            return tf.estimator.EstimatorSpec(
                mode, loss=loss, eval_metric_ops=metrics)


if __name__ == '__main__':
    params = {
        'dim': 300,
        'lstm_size': 32,
        'dropout': 0.5,
        'num_oov_buckets': 1,
        'epochs': 25,
        'batch_size': 20,
        'buffer': 3500,
        'words': str(Path(DATA_DIR, 'vocab.words.txt')),
        'tags': str(Path(DATA_DIR, 'vocab.labels.txt')),
        'w2v': str(Path(DATA_DIR, 'w2v.npz'))
    }

    with Path('results/params.json').open('w', encoding='utf-8') as f:
        json.dump(params, f, indent=4, sort_keys=True)


    def fwords(name):
        return str(Path(DATA_DIR, '{}.words.txt'.format(name)))


    def ftags(name):
        return str(Path(DATA_DIR, '{}.labels.txt'.format(name)))


    train_inpf = functools.partial(input_fn, fwords('train'), ftags('train'),
                                   params, shuffle_and_repeat=True)
    eval_inpf = functools.partial(input_fn, fwords('eval'), ftags('eval'))
    cfg = tf.estimator.RunConfig(save_checkpoints_secs=60)
    estimator = tf.estimator.Estimator(model_fn, 'results/model', cfg, params)
    Path(estimator.eval_dir()).mkdir(parents=True, exist_ok=True)
    train_spec = tf.estimator.TrainSpec(input_fn=train_inpf)
    eval_spec = tf.estimator.EvalSpec(input_fn=eval_inpf, throttle_secs=60)
    tf.estimator.train_and_evaluate(estimator, train_spec, eval_spec)


    # Write predictions to file
    def write_predictions(name):
        Path('results/score').mkdir(parents=True, exist_ok=True)
        with Path('results/score/{}.preds.txt'.format(name)).open('wb', encoding='utf-8') as f:
            test_inpf = functools.partial(input_fn, fwords(name), ftags(name))
            golds_gen = generator_fn(fwords(name), ftags(name))
            preds_gen = estimator.predict(test_inpf)
            for golds, preds in zip(golds_gen, preds_gen):
                ((words, _), tag) = golds
                f.write(b' '.join([tag, preds['labels'], ''.join(words)]) + b'\n')


    for name in ['train', 'eval']:
        write_predictions(name)
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目编程以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 49
 0
- 0


 已为社区贡献108条内容

所有评论(0)