计算机毕业设计Python+决策树模型房价预测系统 房价可视化 房源推荐系统 大数据毕业设计(源码+LW+PPT+讲解+教程)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Python+决策树模型房价预测系统文献综述
引言
房价预测作为房地产、金融投资及城市规划领域的关键问题,其核心挑战在于如何从多源异构数据中提取非线性特征并构建高精度预测模型。传统线性回归方法因假设特征与目标变量呈线性关系,难以捕捉复杂交互作用(如学区房溢价随面积增大而衰减),而决策树模型凭借其递归划分特征空间、自动学习非线性决策边界的能力,成为房价预测领域的主流技术之一。Python凭借丰富的机器学习库(如Scikit-learn、XGBoost)和数据处理工具(如Pandas、NumPy),为决策树模型的快速开发与部署提供了高效技术栈。本文系统梳理了Python与决策树模型在房价预测中的技术路径、研究进展及现存挑战,重点分析数据预处理、模型优化、可解释性增强等关键方向。
数据预处理:奠定模型性能的基础
房价预测的准确性高度依赖数据质量与覆盖度。数据来源涵盖结构化数据(如房屋面积、楼层、房龄)、地理空间数据(通过API获取周边学校、地铁站、商业设施的POI信息)及市场动态数据(爬取挂牌价、成交量等时序数据)。然而,数据缺失率普遍高于30%(尤其老旧小区房龄字段),且不同来源数据存在尺度不一致问题(如面积单位混用“平方米”与“平方英尺”)。
Python生态中的Pandas库通过均值填充、KNN插值等方法处理缺失值,箱线图法识别极端房价(如超出区域均价3倍以上)或异常面积(如小于20㎡或大于500㎡的住宅),并通过GeoPandas库统一地理数据格式。特征工程环节,决策树模型需将离散型特征(如装修情况“毛坯/简装/精装”)转换为数值型标签,连续型特征(如建成年代)通过分箱处理(如“2000年前/2000-2010年/2010年后”)增强模型鲁棒性。例如,在波士顿房价预测中,决策树模型通过将“房间数>6”作为分裂节点,成功捕捉到学区房溢价随面积增大的非线性衰减规律。
决策树模型:从基础到集成的演进
基础决策树模型
CART决策树通过基尼系数或均方误差(MSE)选择最优分裂点,可直接用于回归任务。在波士顿房价数据集上,决策树回归的MAE(Mean Absolute Error)比线性回归降低18%,但存在过拟合风险(测试集R²仅0.72)。为缓解过拟合,研究者采用剪枝技术(如预剪枝限制树深度、后剪枝合并相似节点)简化模型结构,同时通过交叉验证优化超参数(如最小样本分裂数、最大叶子节点数)。
集成学习优化
为提升泛化能力,研究者广泛采用集成方法:
- 随机森林(Random Forest):通过行/列采样构建多棵决策树并投票,在Kaggle房价竞赛中成为TOP解决方案。其优势在于通过Bagging过程准确评判“冗余”特征,例如在烟台市房价预测中,随机森林模型通过特征重要性分析发现“距离地铁站距离”对房价的影响权重高于“房间数”。
- 梯度提升树(GBDT):XGBoost、LightGBM通过迭代优化残差,进一步将预测误差降低至MAE<3%。例如,在京津冀地区房价预测中,XGBoost模型结合20+特征(包括GDP增长率、人均可支配收入等宏观经济指标),预测精度达90%以上,且支持“假设分析”(如“增加10㎡面积对房价的影响”)。
- 可解释性增强:SHAP值(Lundberg & Lee, 2017)可量化每个特征对预测结果的贡献,解决“黑箱模型”信任问题。例如,在上海市房价预测中,SHAP值分析显示“学区房”平均溢价30%,且溢价幅度随面积增大呈指数衰减。
Python技术栈:加速模型落地
Python的开源生态显著降低了房价预测系统的开发门槛:
- 数据处理:Pandas实现数据清洗与特征工程,GeoPandas处理地理空间数据,Optuna库实现自动化超参数调优。
- 模型训练:Scikit-learn提供标准化API,支持决策树、随机森林的快速实现;XGBoost/LightGBM通过并行计算加速大规模数据训练。
- 部署应用:Flask/Django构建Web服务,Streamlit实现低代码可视化;Plotly生成交互式地图展示房价热力图,Matplotlib绘制趋势图(如滑动时间轴查看历史数据)。
例如,某系统通过Scrapy框架爬取链家、安居客等平台的房源数据,结合高德地图API获取周边配套信息,构建包含20+特征的标准化房价数据库。模型层采用XGBoost处理非线性特征关系,通过SHAP值解释各因素影响权重,最终为购房者提供“目标房源性价比评分”(对比同区域同户型均价)及砍价参考区间,为投资者输出“高潜力区域榜单”(结合涨幅预测与配套规划)。
现存问题与挑战
尽管Python与决策树模型的结合显著提升了房价预测的精度与可解释性,但仍面临以下瓶颈:
- 数据质量瓶颈:爬虫数据存在反爬机制限制(如链家网IP封禁),地理数据更新滞后(POI信息可能因店铺倒闭失效)。
- 模型泛化能力不足:训练于特定城市的数据难以直接迁移至其他区域(如一线城市与三四线城市的房价驱动因素差异显著),极端市场波动(如2020年全球房价暴涨)导致模型预测偏差扩大。
- 实时性挑战:集成模型推理速度较慢(XGBoost单次预测耗时>100ms),难以支持高频交易场景。
未来趋势
- 跨区域数据融合:联邦学习(Yang et al., 2019)可在保护数据隐私的前提下,联合多机构训练全局模型,解决小样本区域过拟合问题。
- 轻量化模型设计:将房屋节点与周边POI构建异构图,通过图神经网络(GNN)捕捉空间依赖关系,同时压缩模型参数量以支持边缘设备部署。
- 自动化开发框架:H2O AutoML、TPOT等工具可自动完成特征工程、模型选择与调优,降低开发门槛。
- 多模态数据融合:融合街景图像(通过计算机视觉识别小区环境如绿化率、建筑年代)、文本数据(如房源描述中的情感分析)等非结构化数据,补充传统特征维度。
结论
Python与决策树模型的结合为房价预测提供了高精度、可解释的解决方案,其技术路径已从单一模型迭代演进至多源数据融合与集成学习阶段。未来研究需聚焦于跨区域泛化、轻量化部署及自动化开发,以推动系统从学术研究向实际业务场景落地,为购房者、投资者及政策制定者提供数据驱动的决策支持。
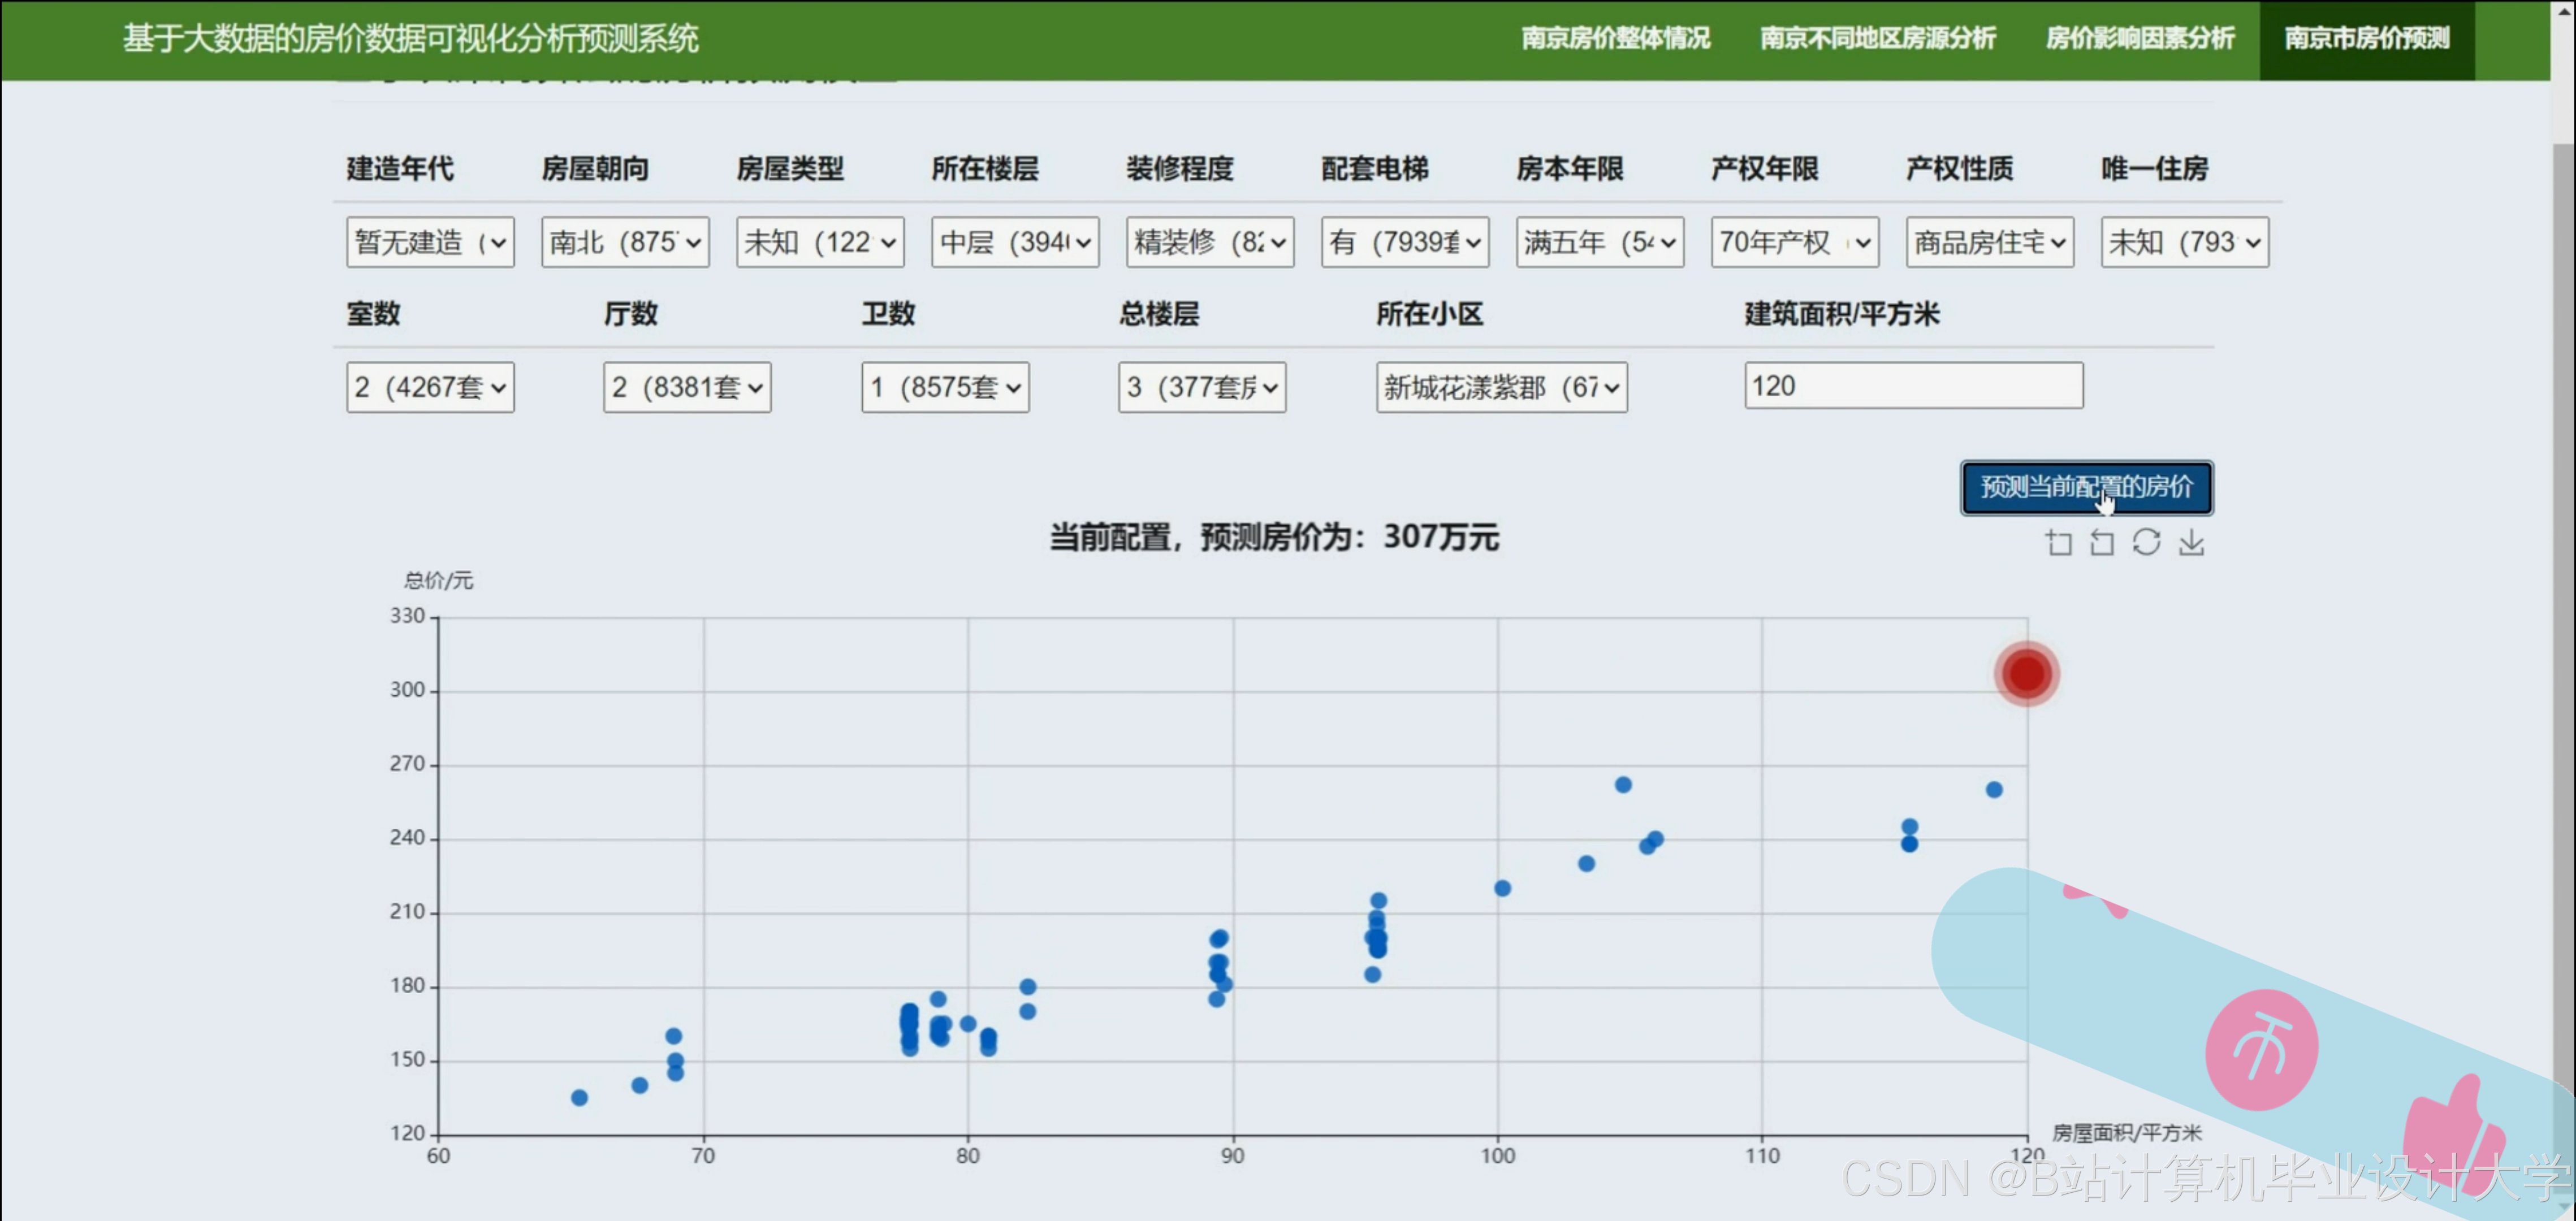
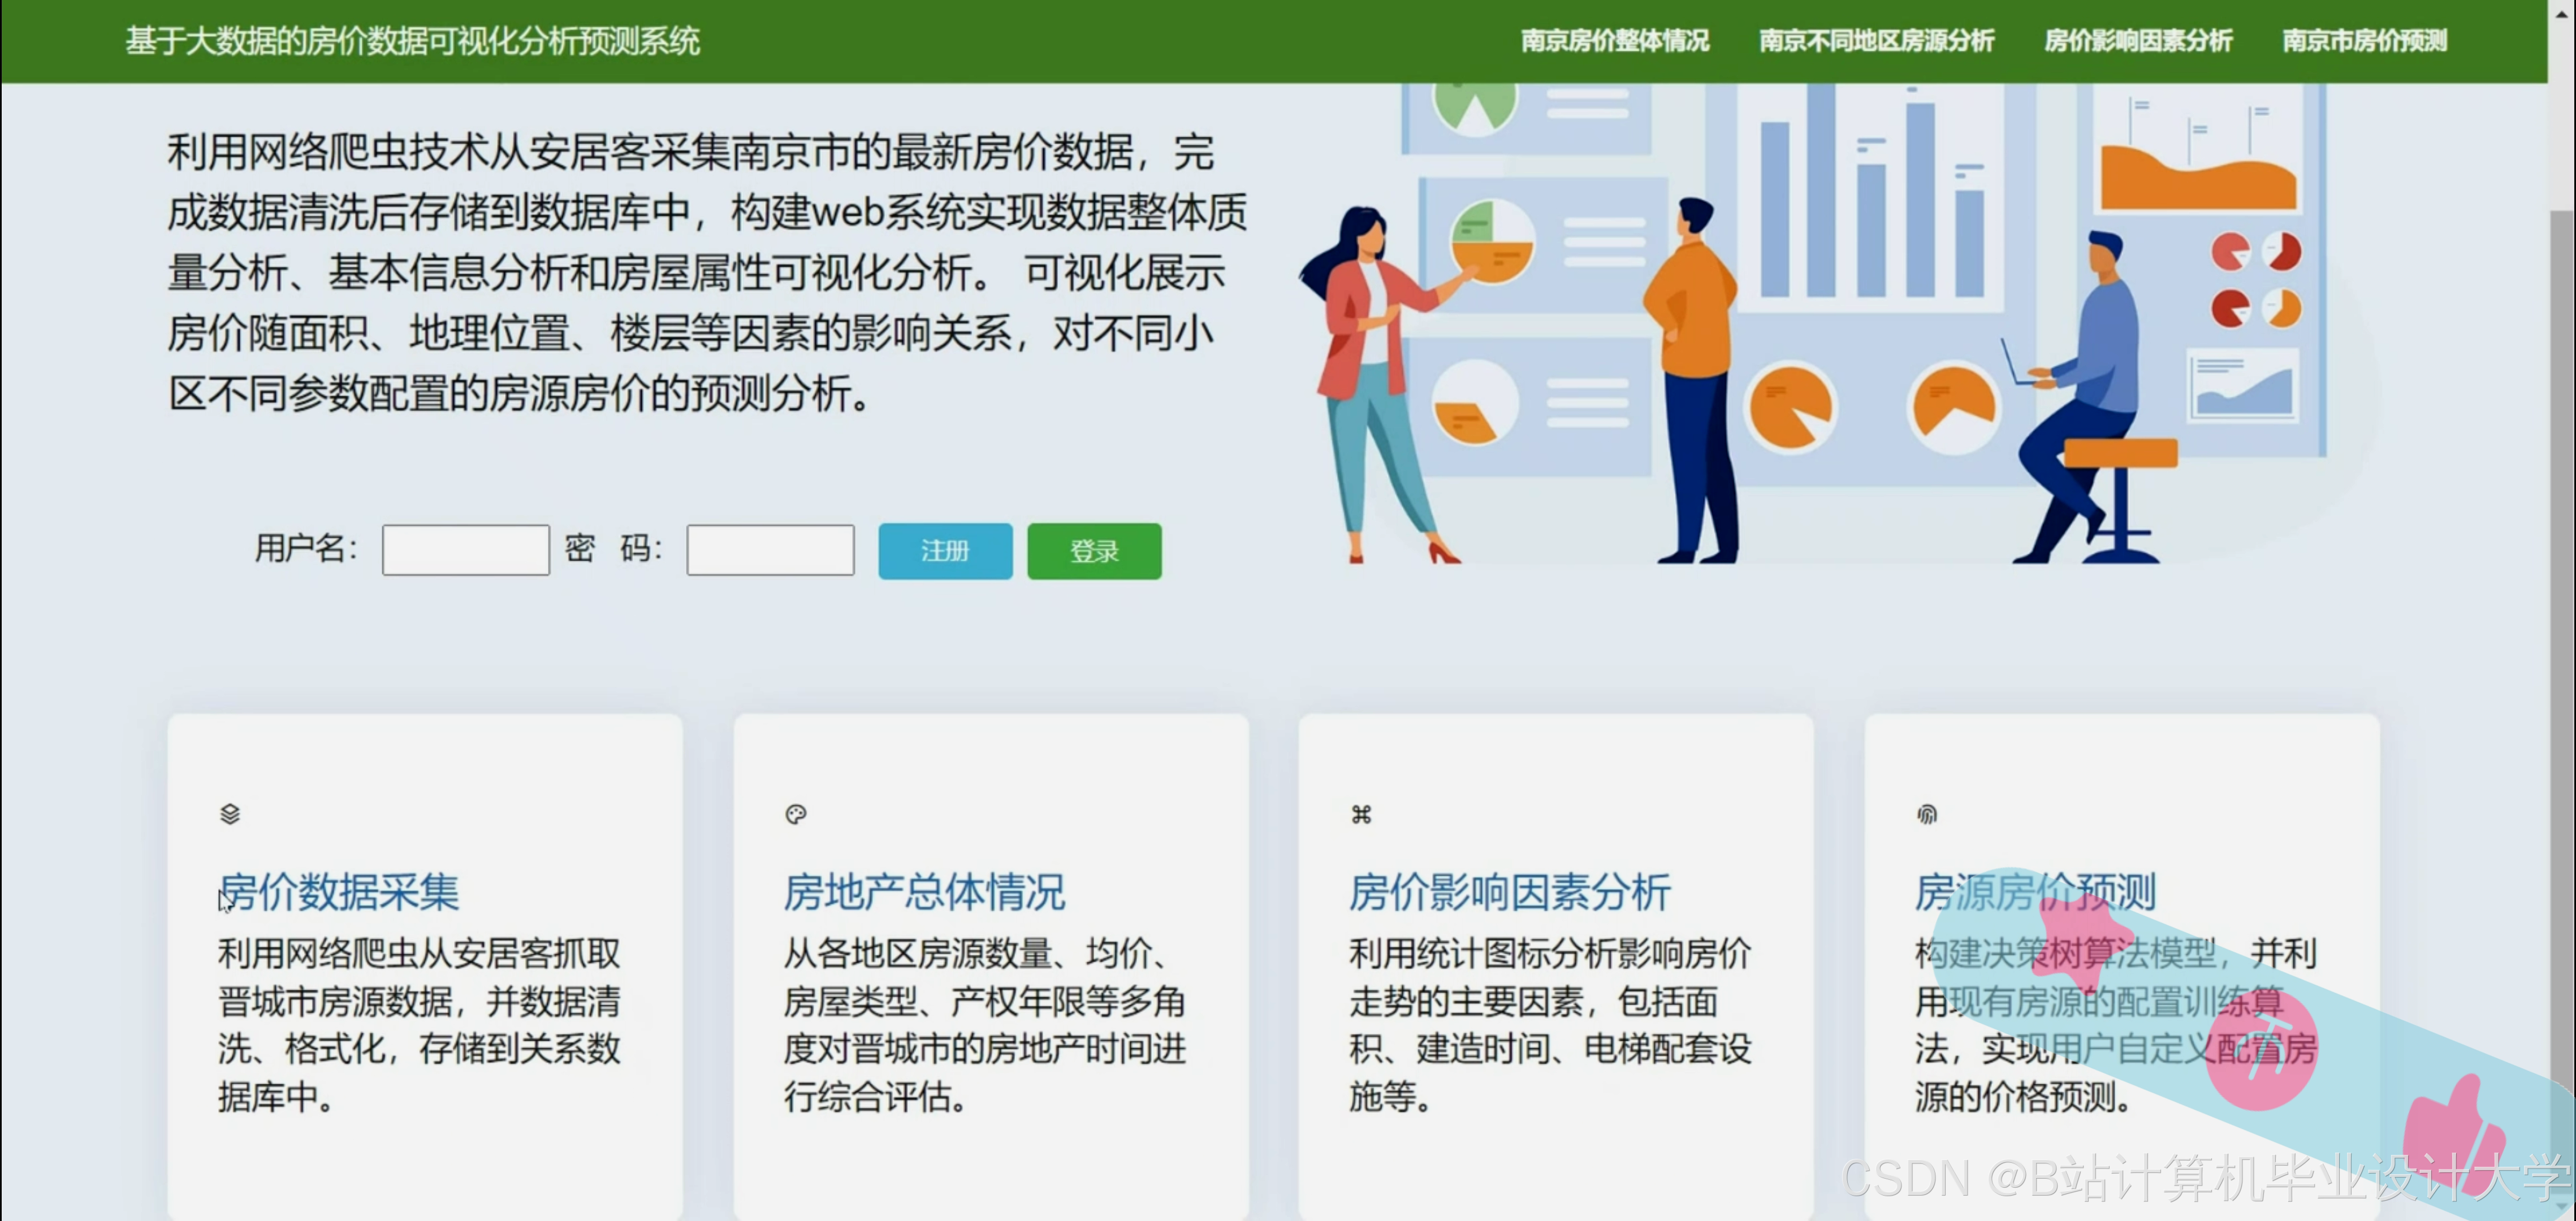
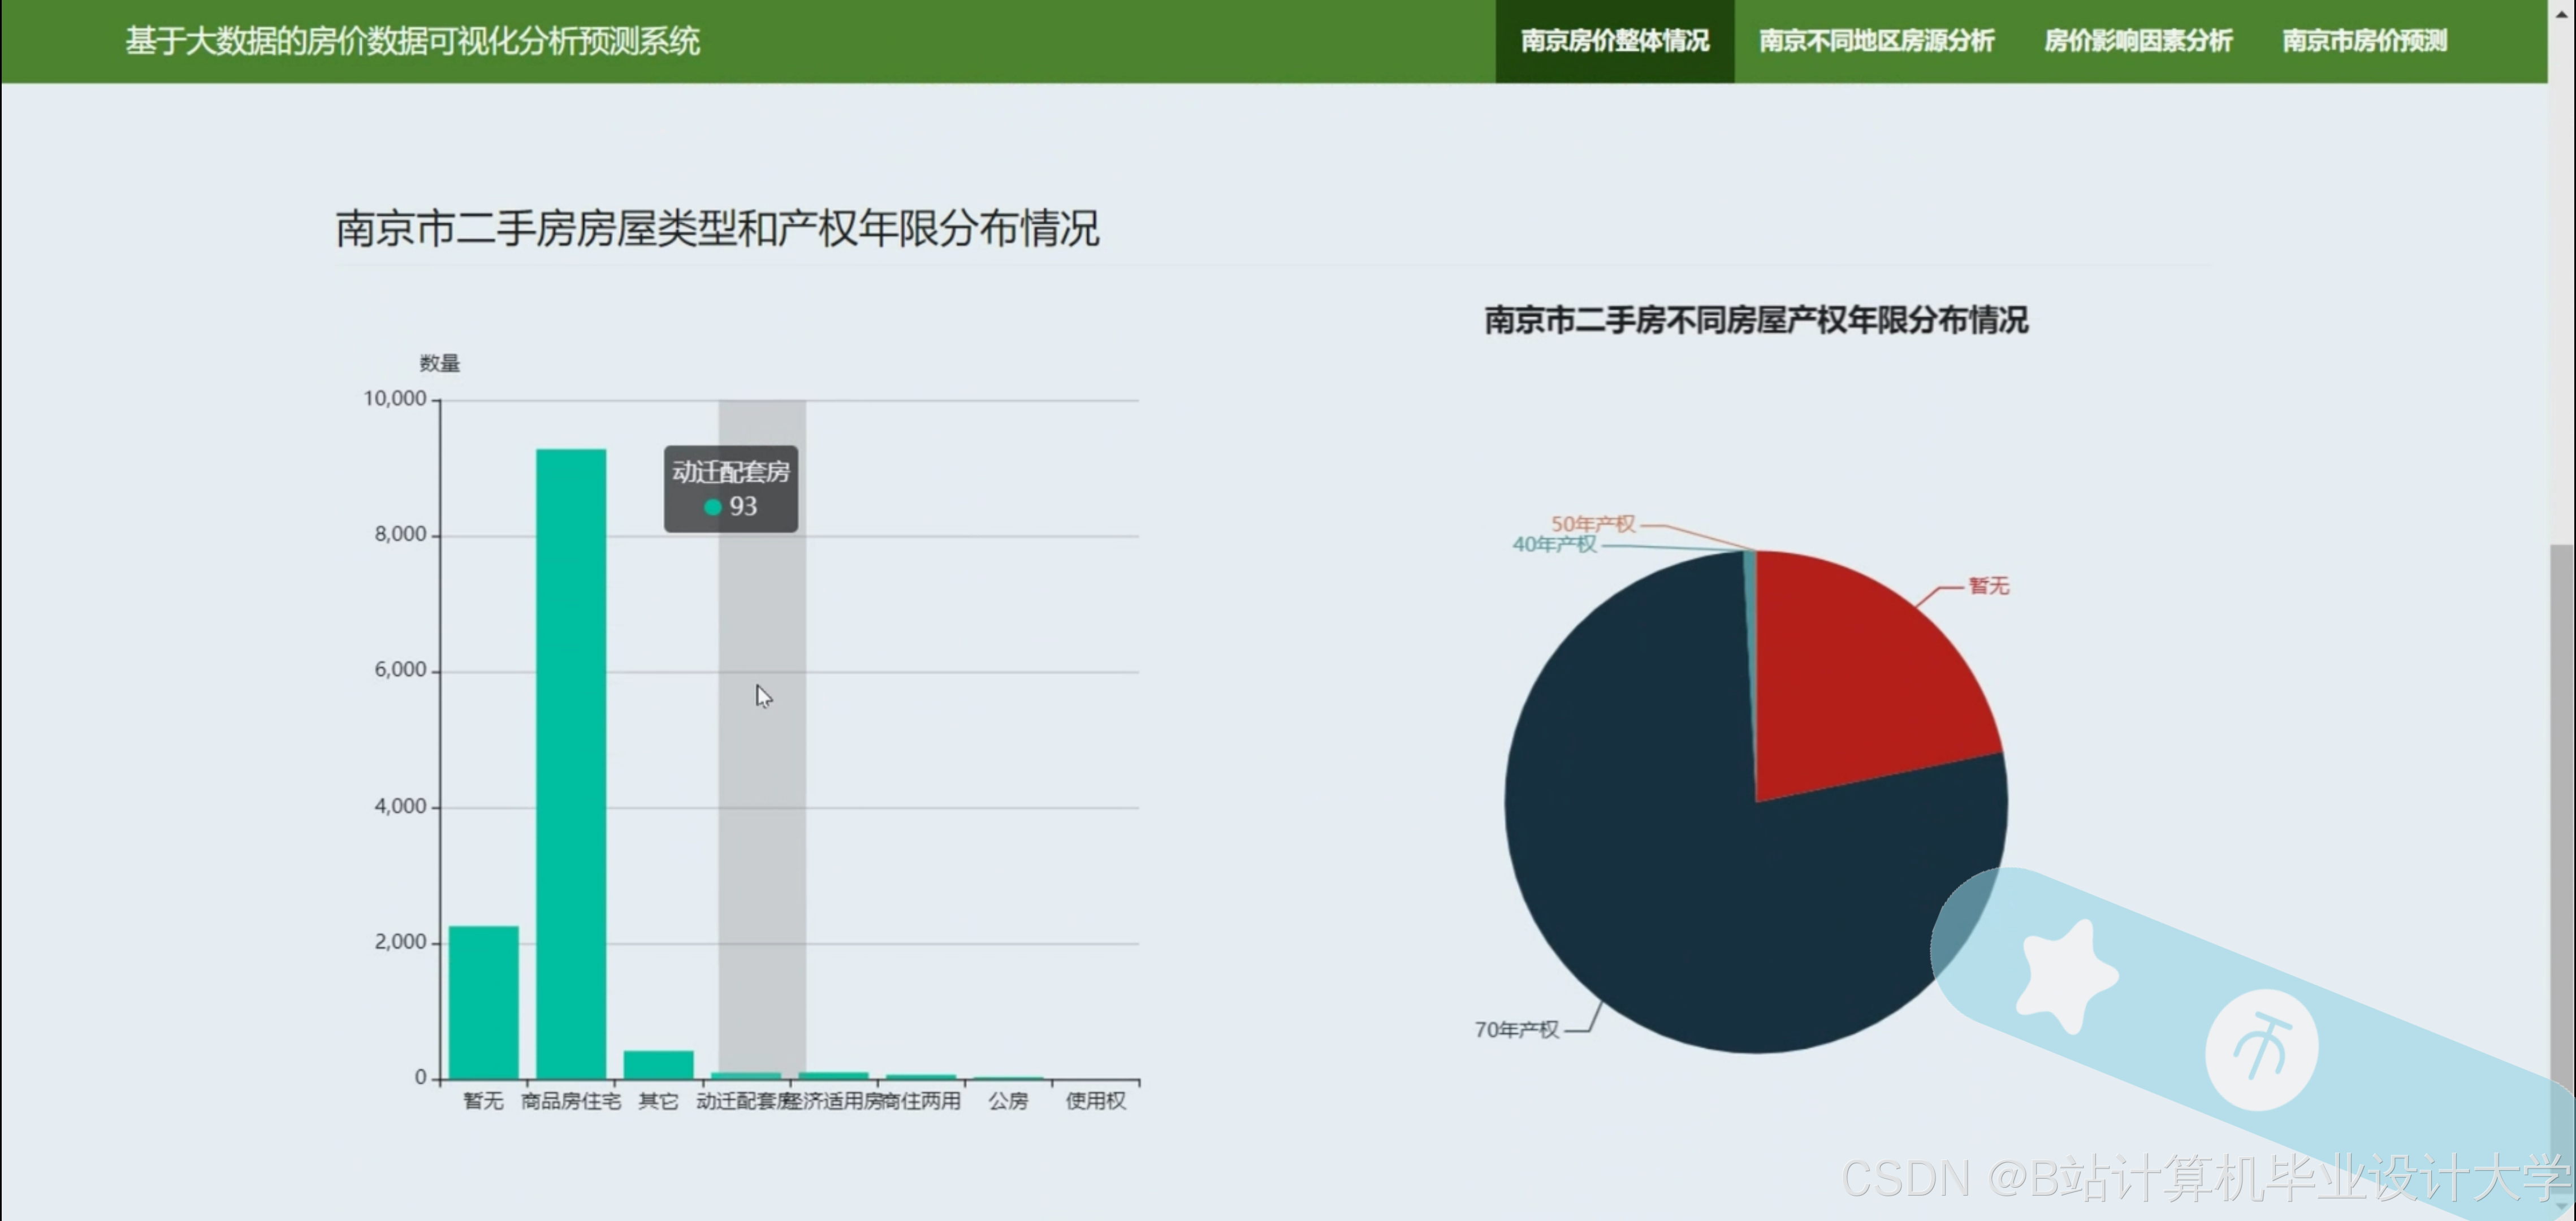
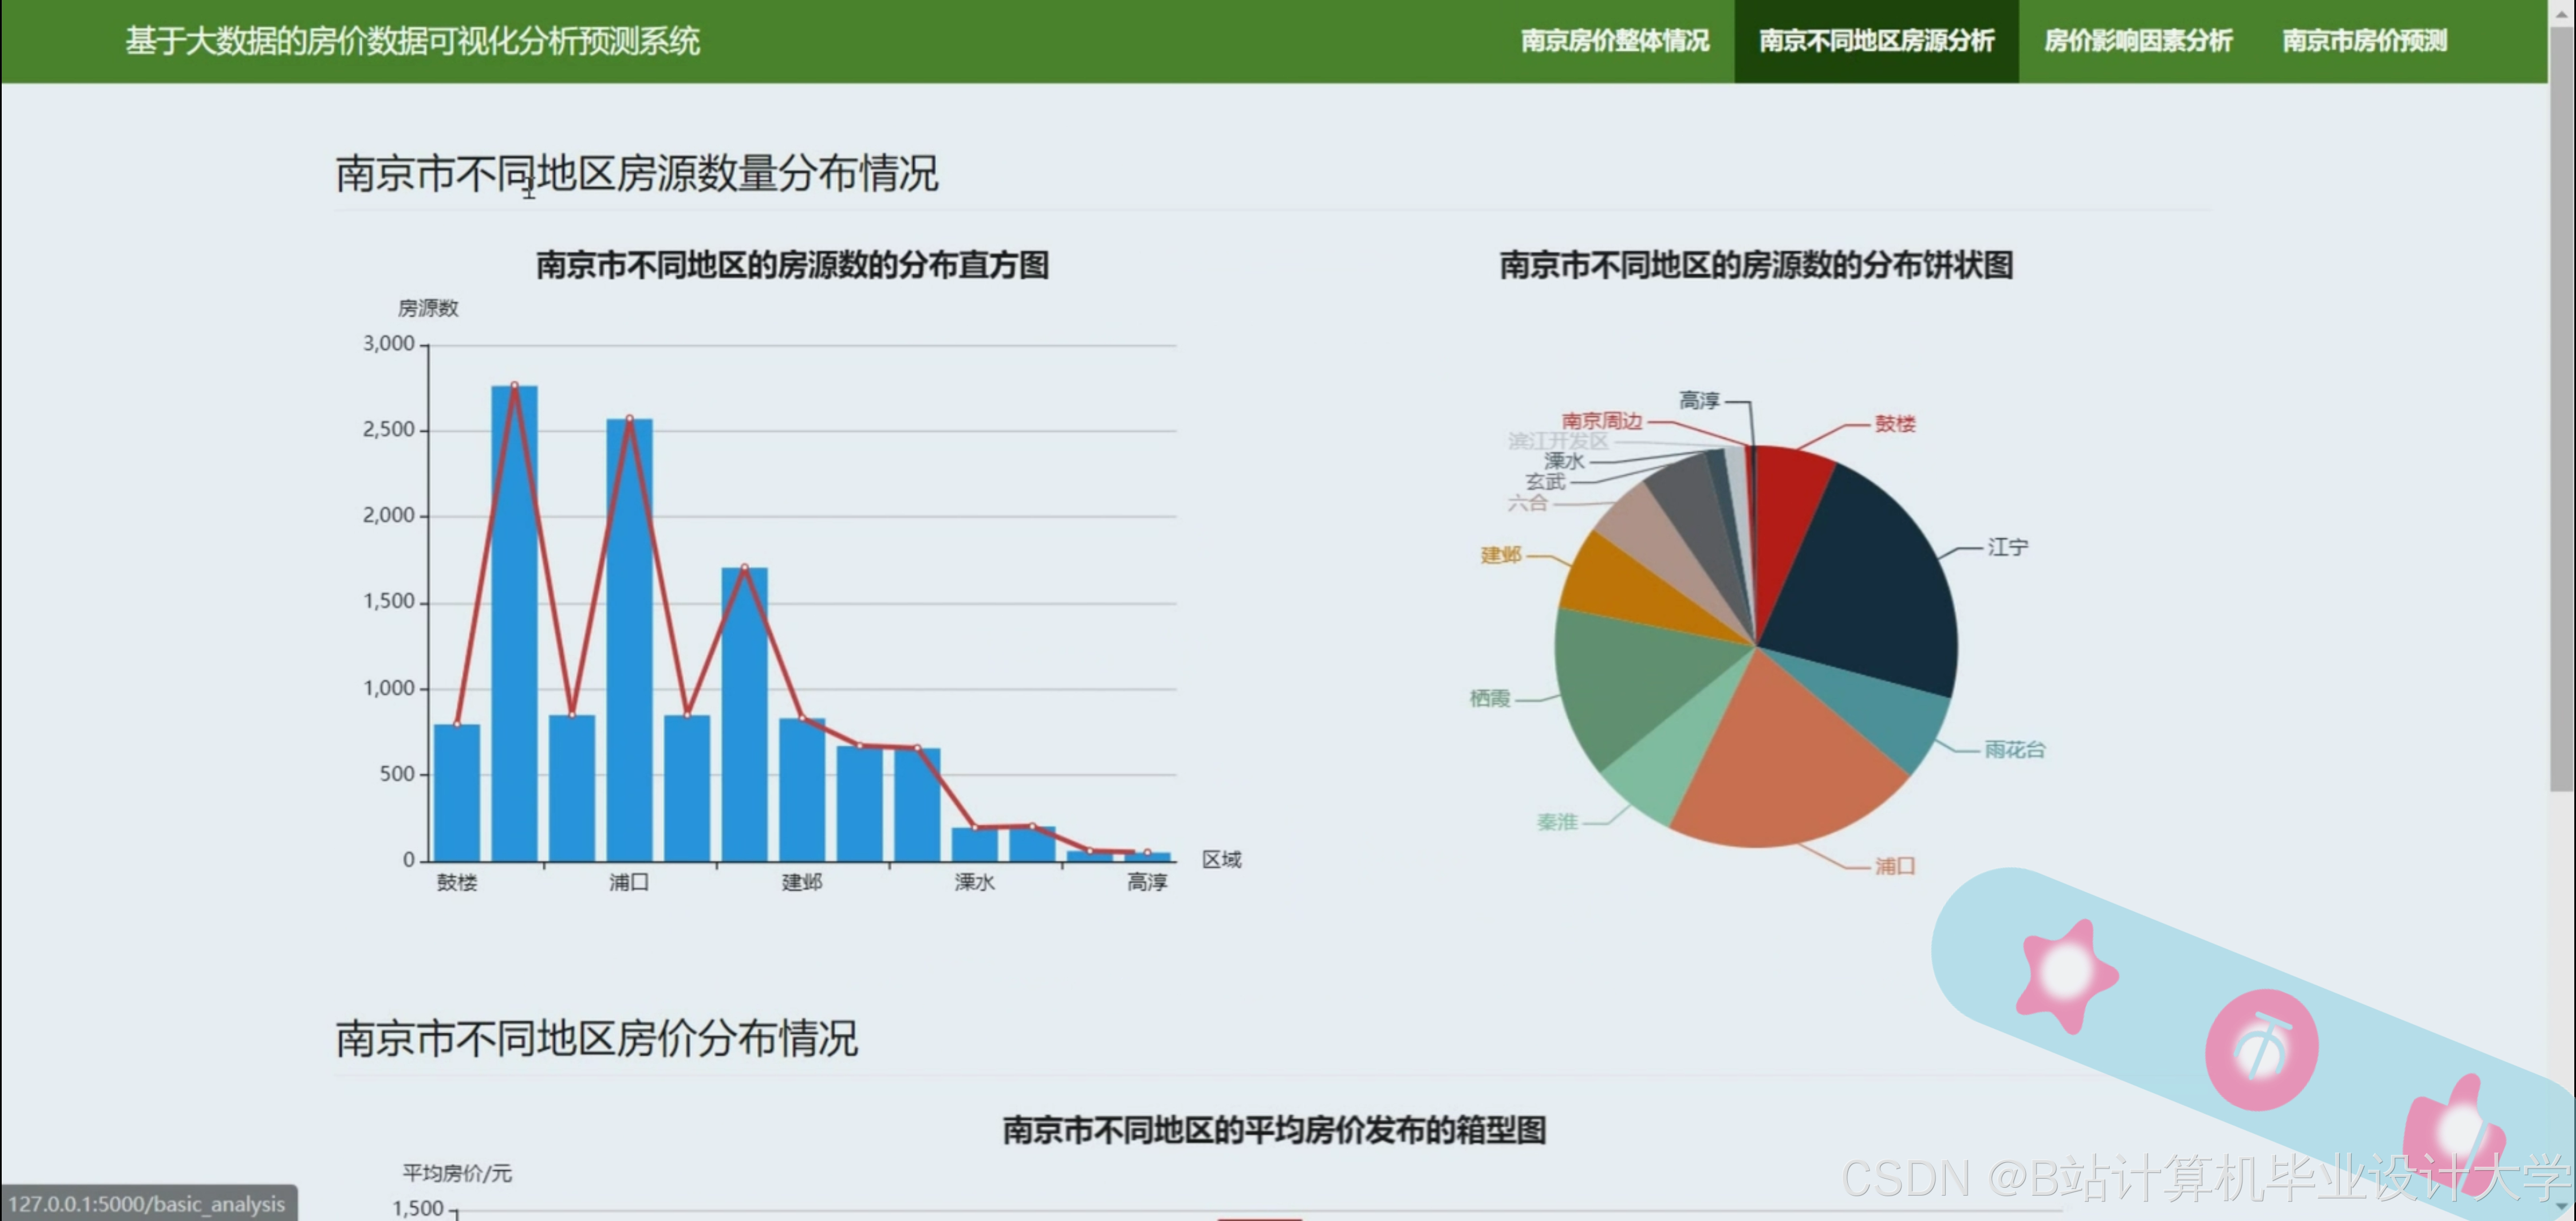
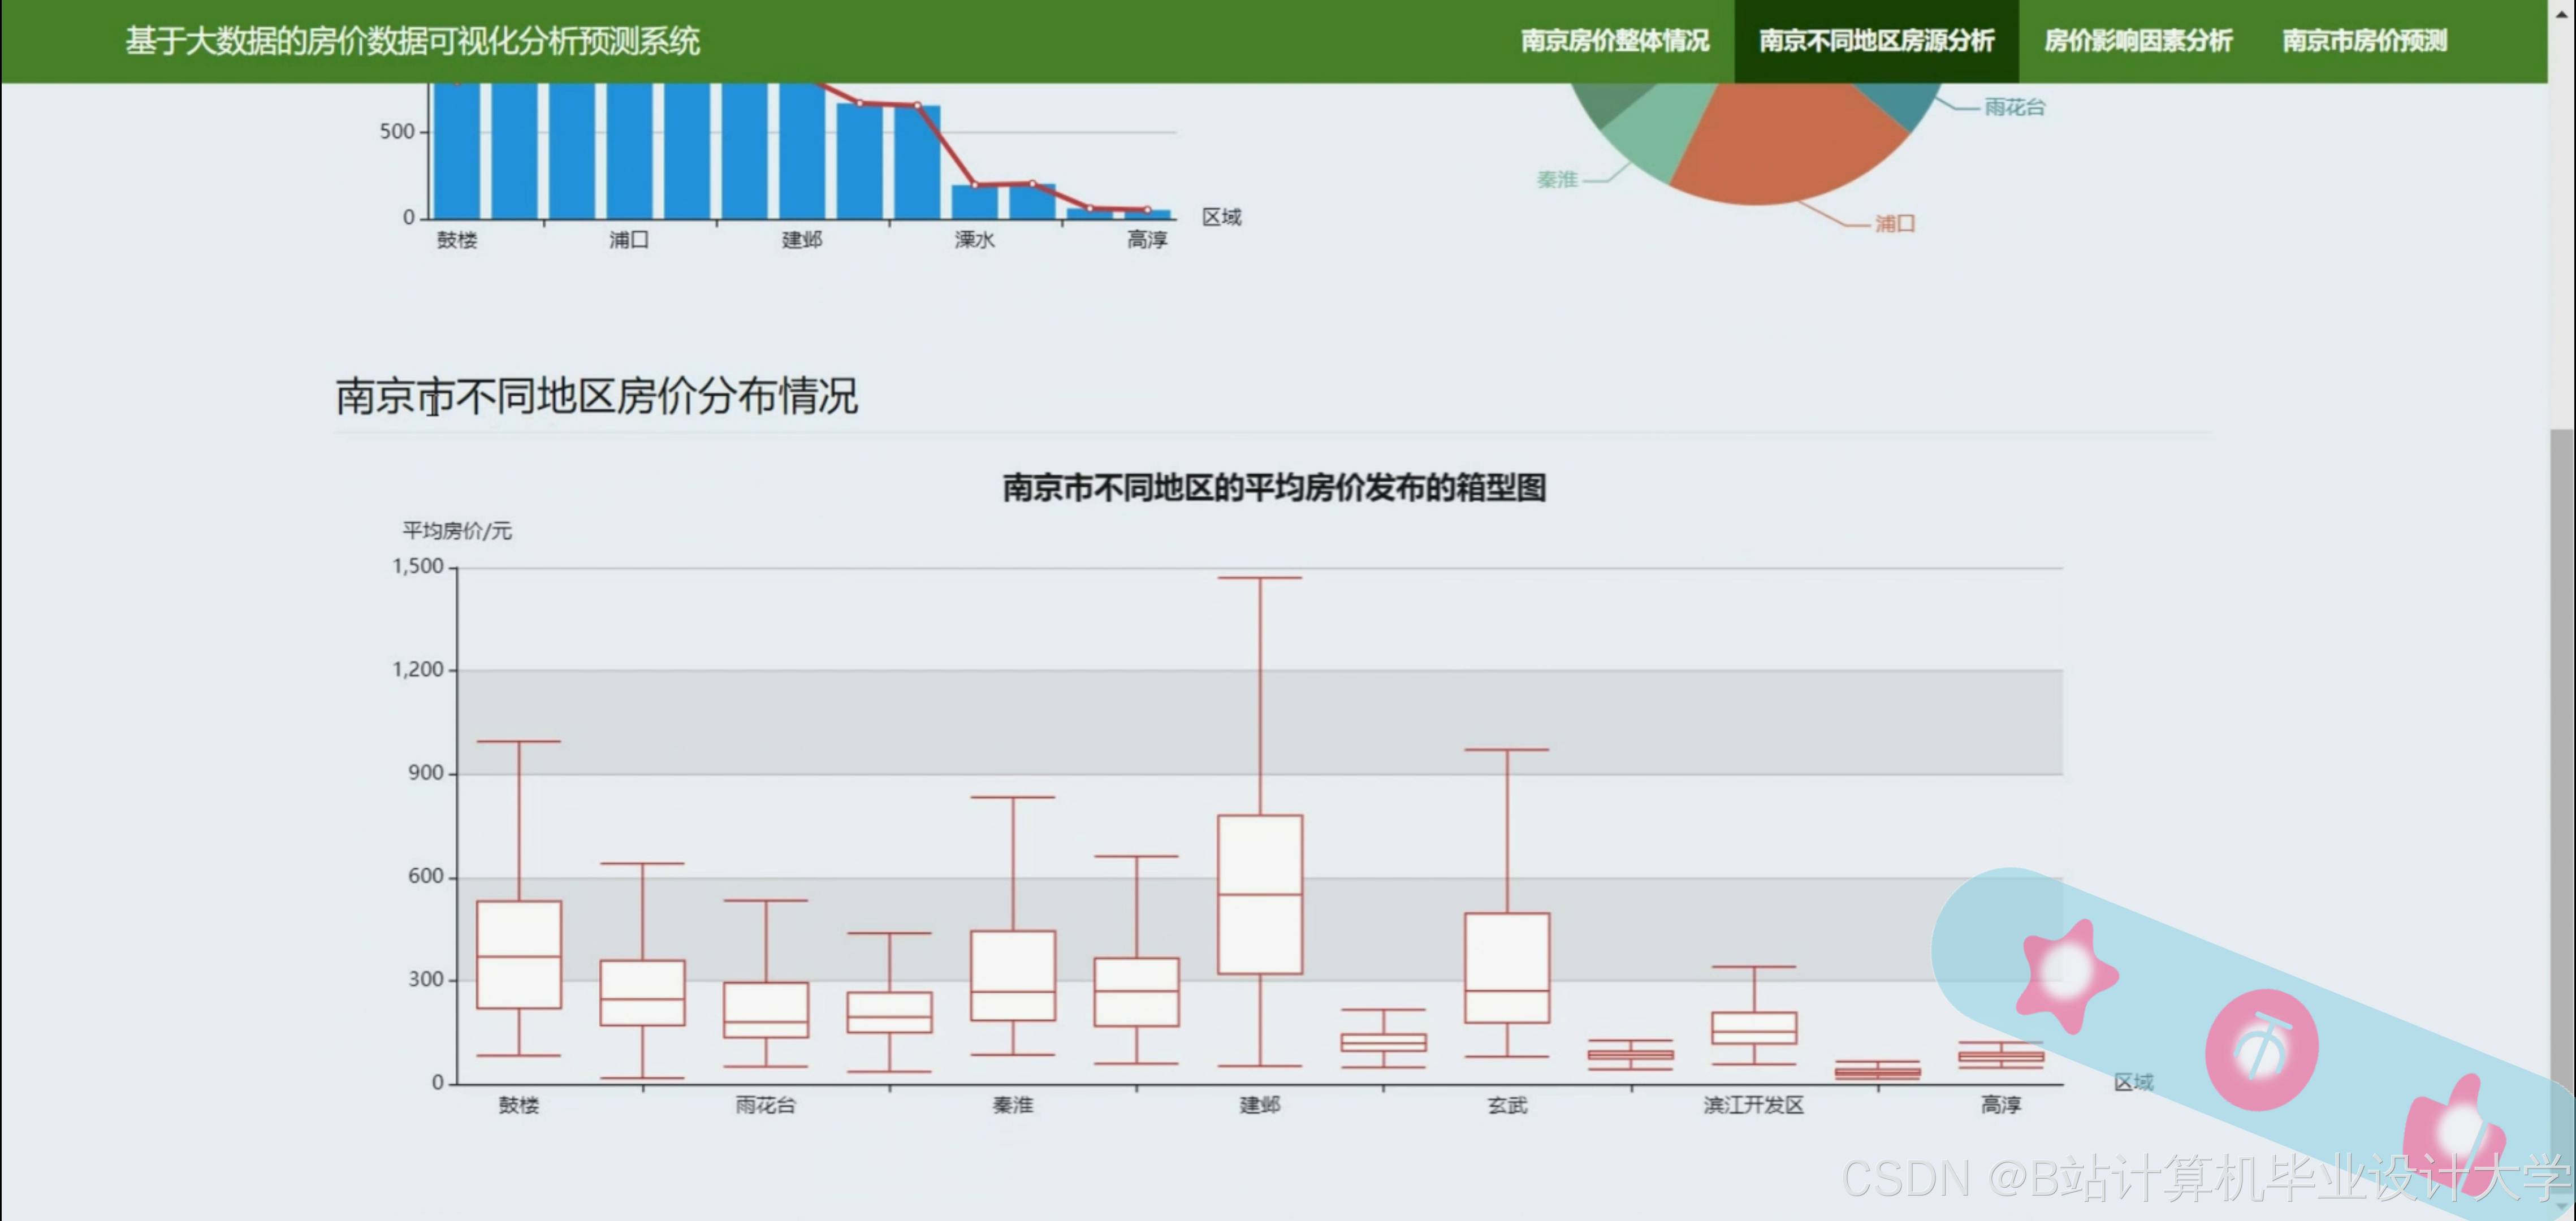
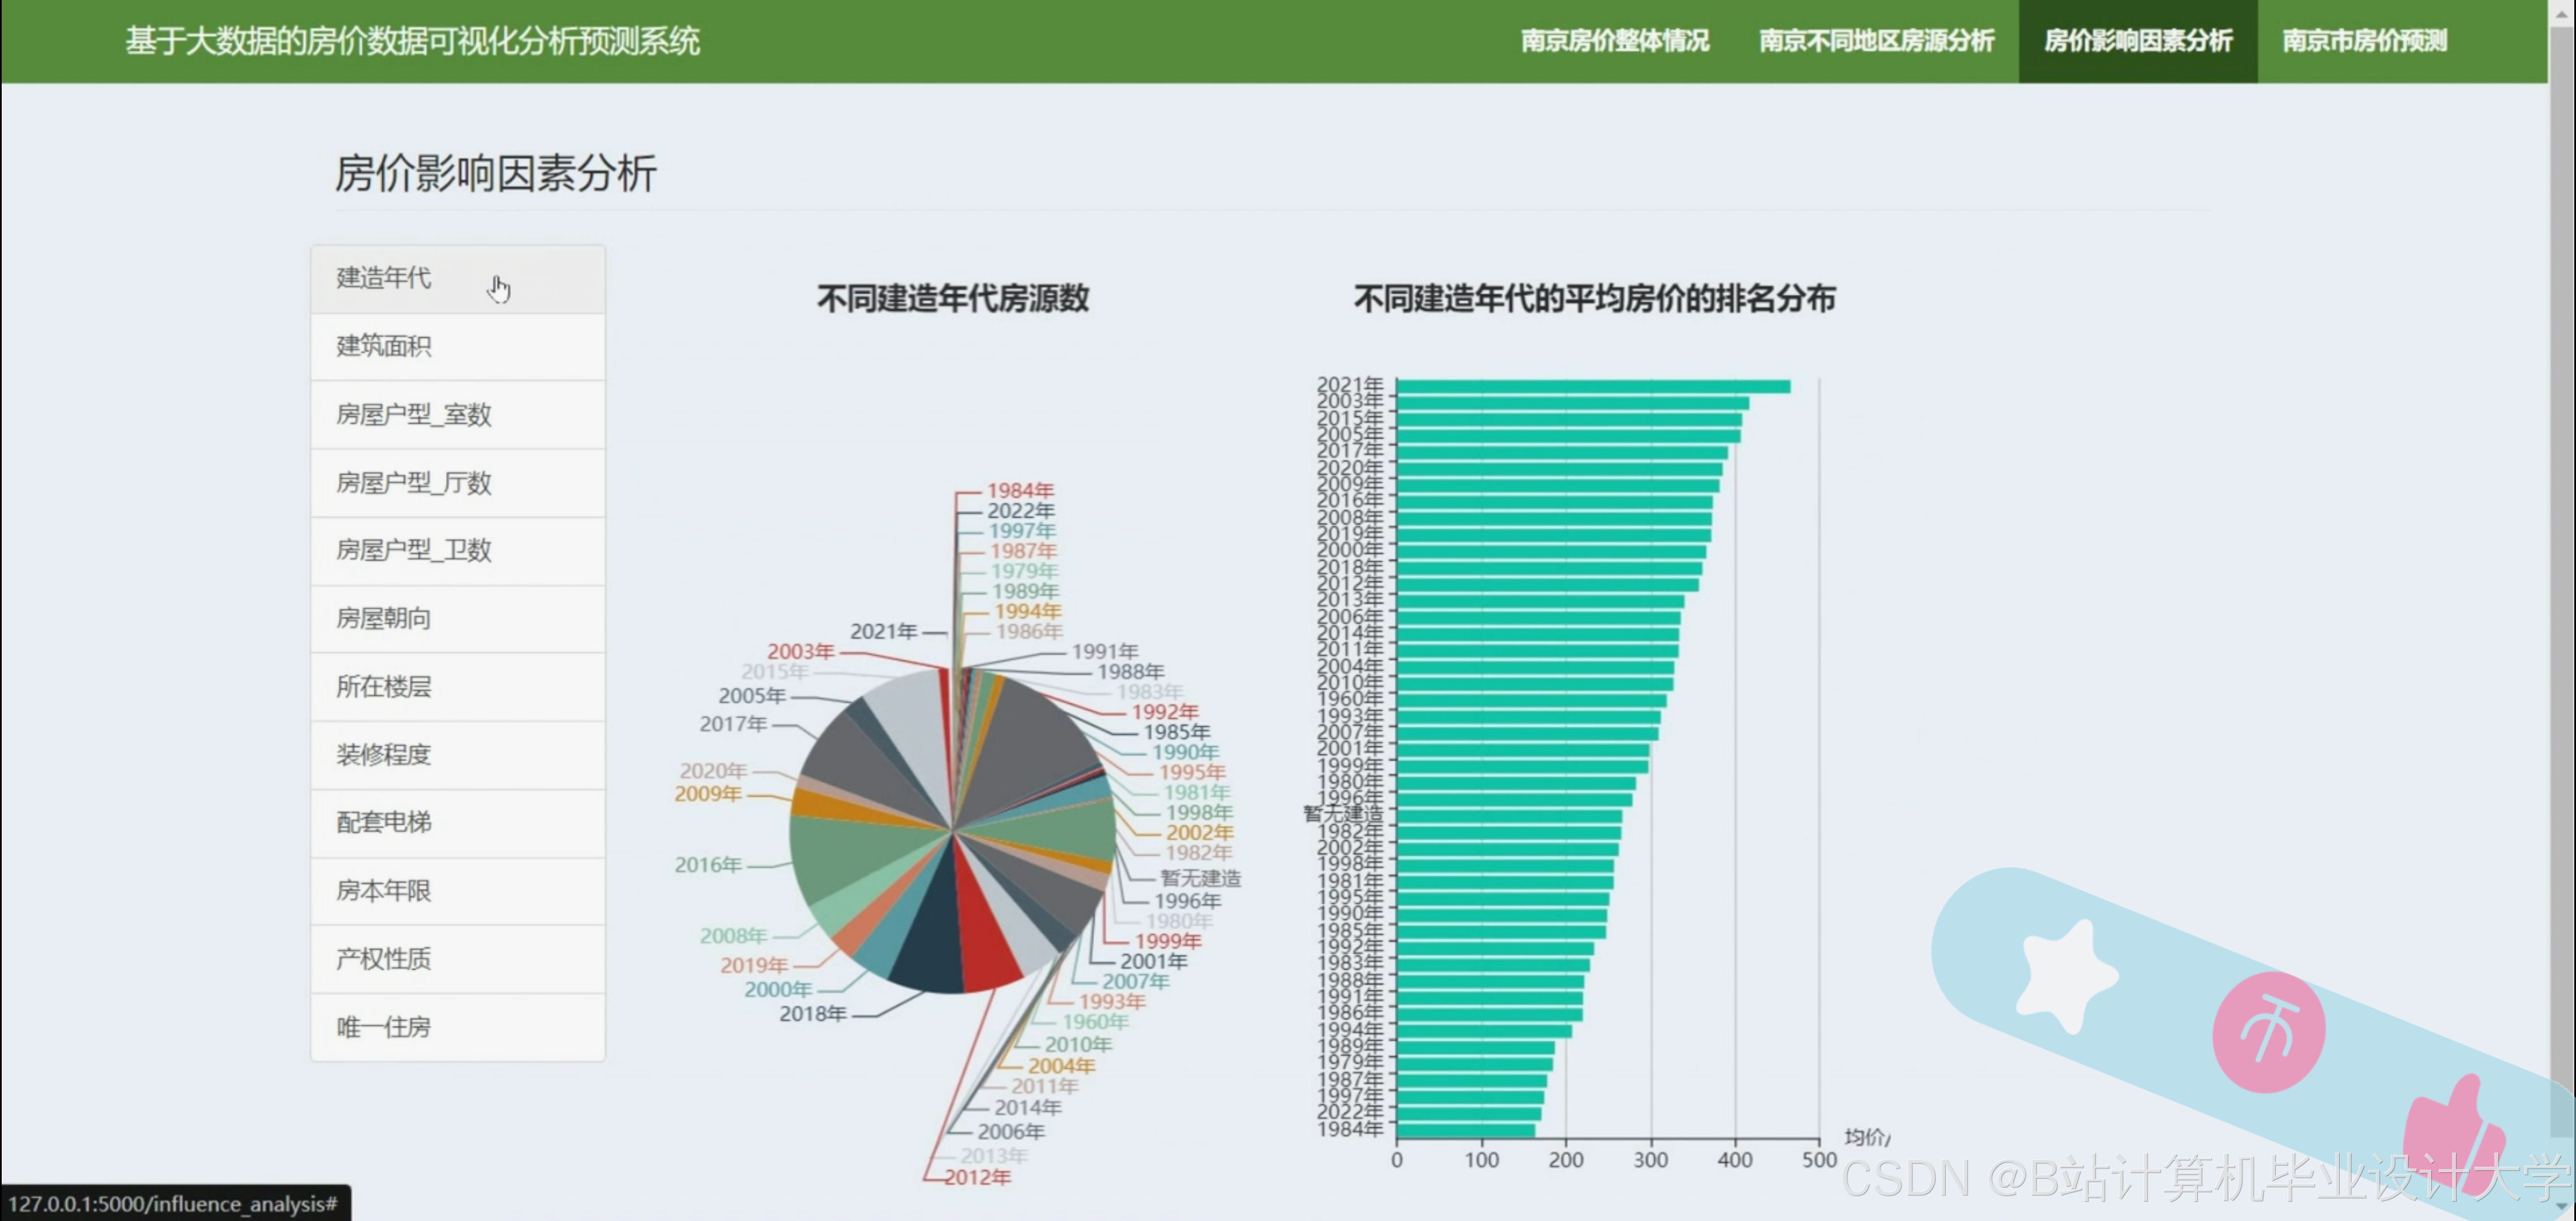
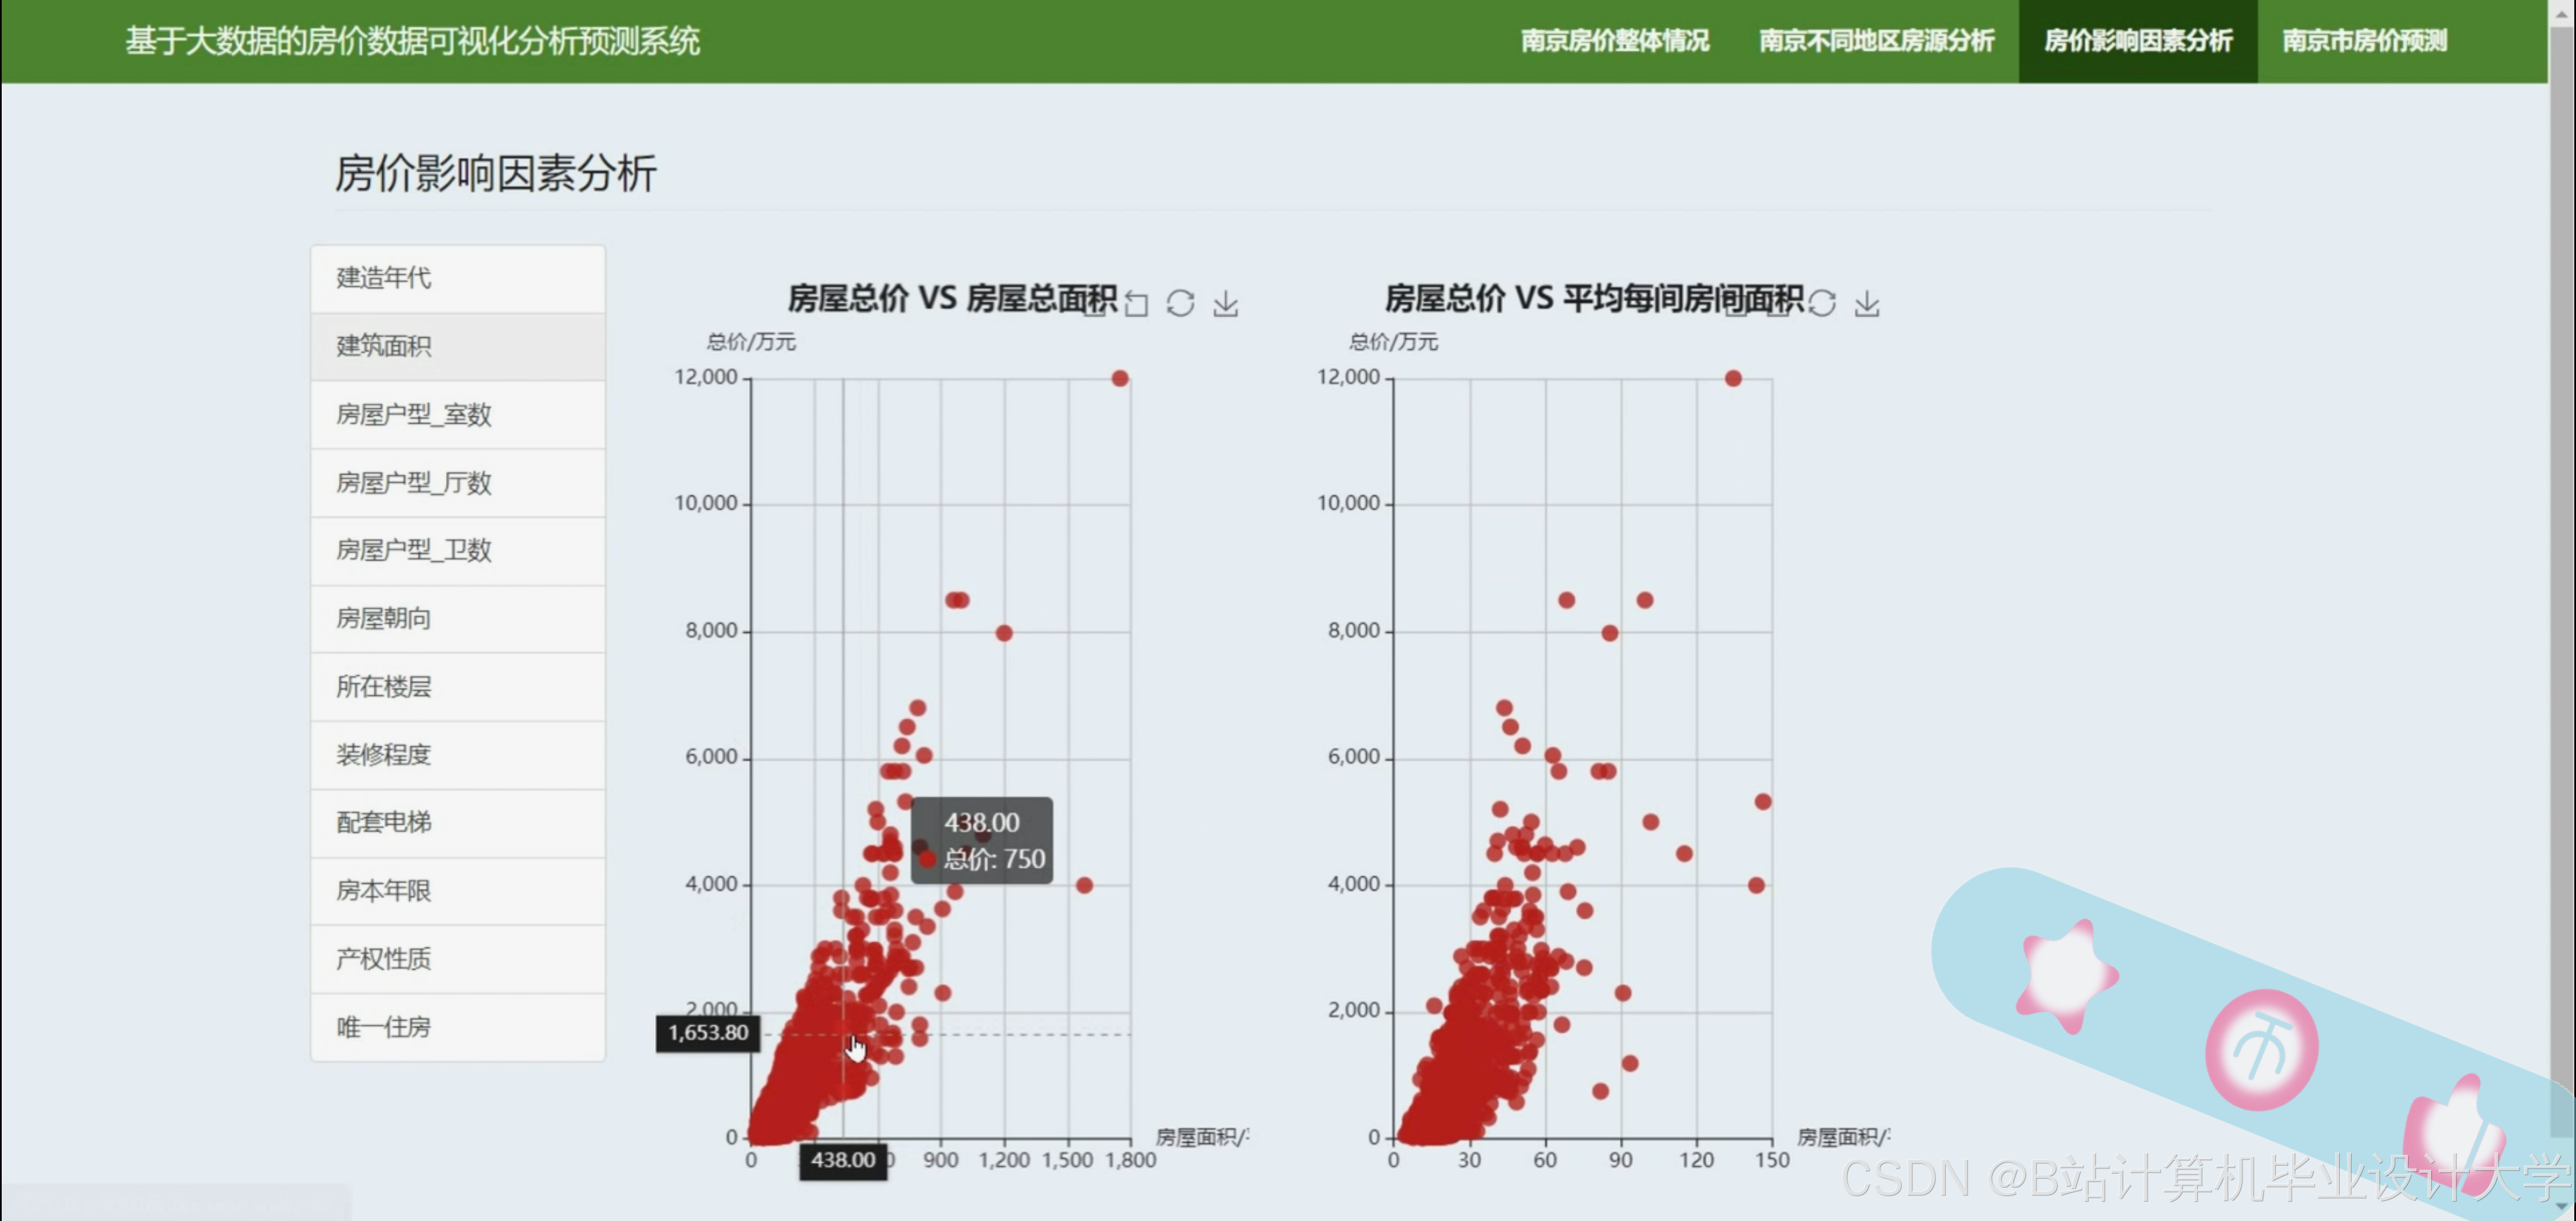
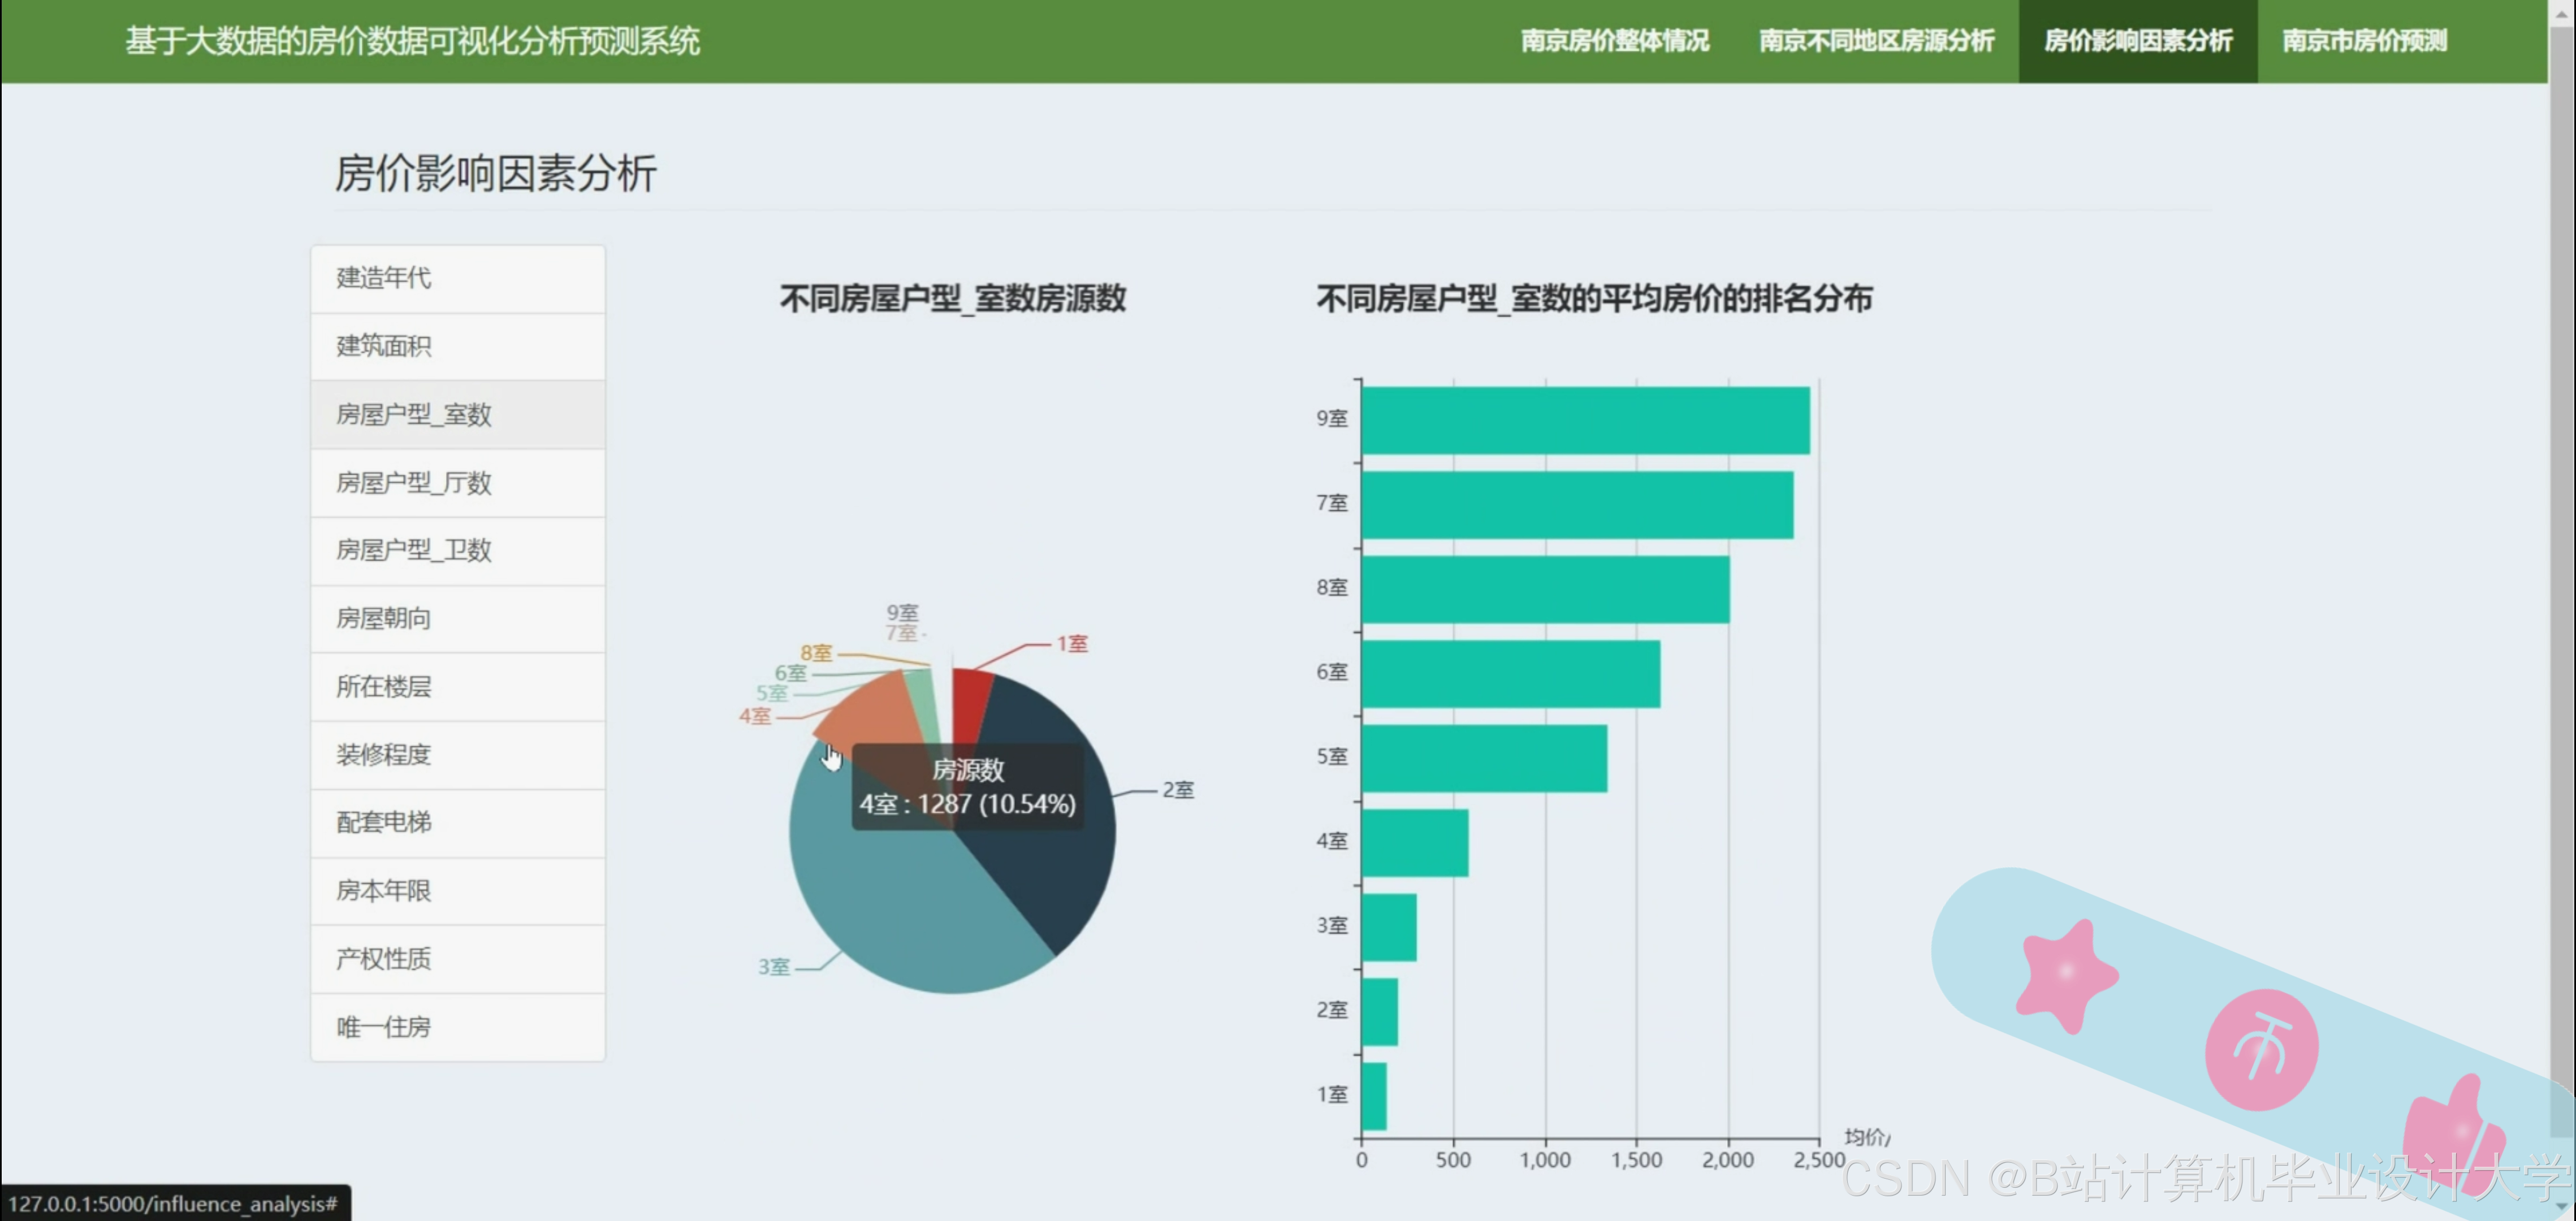
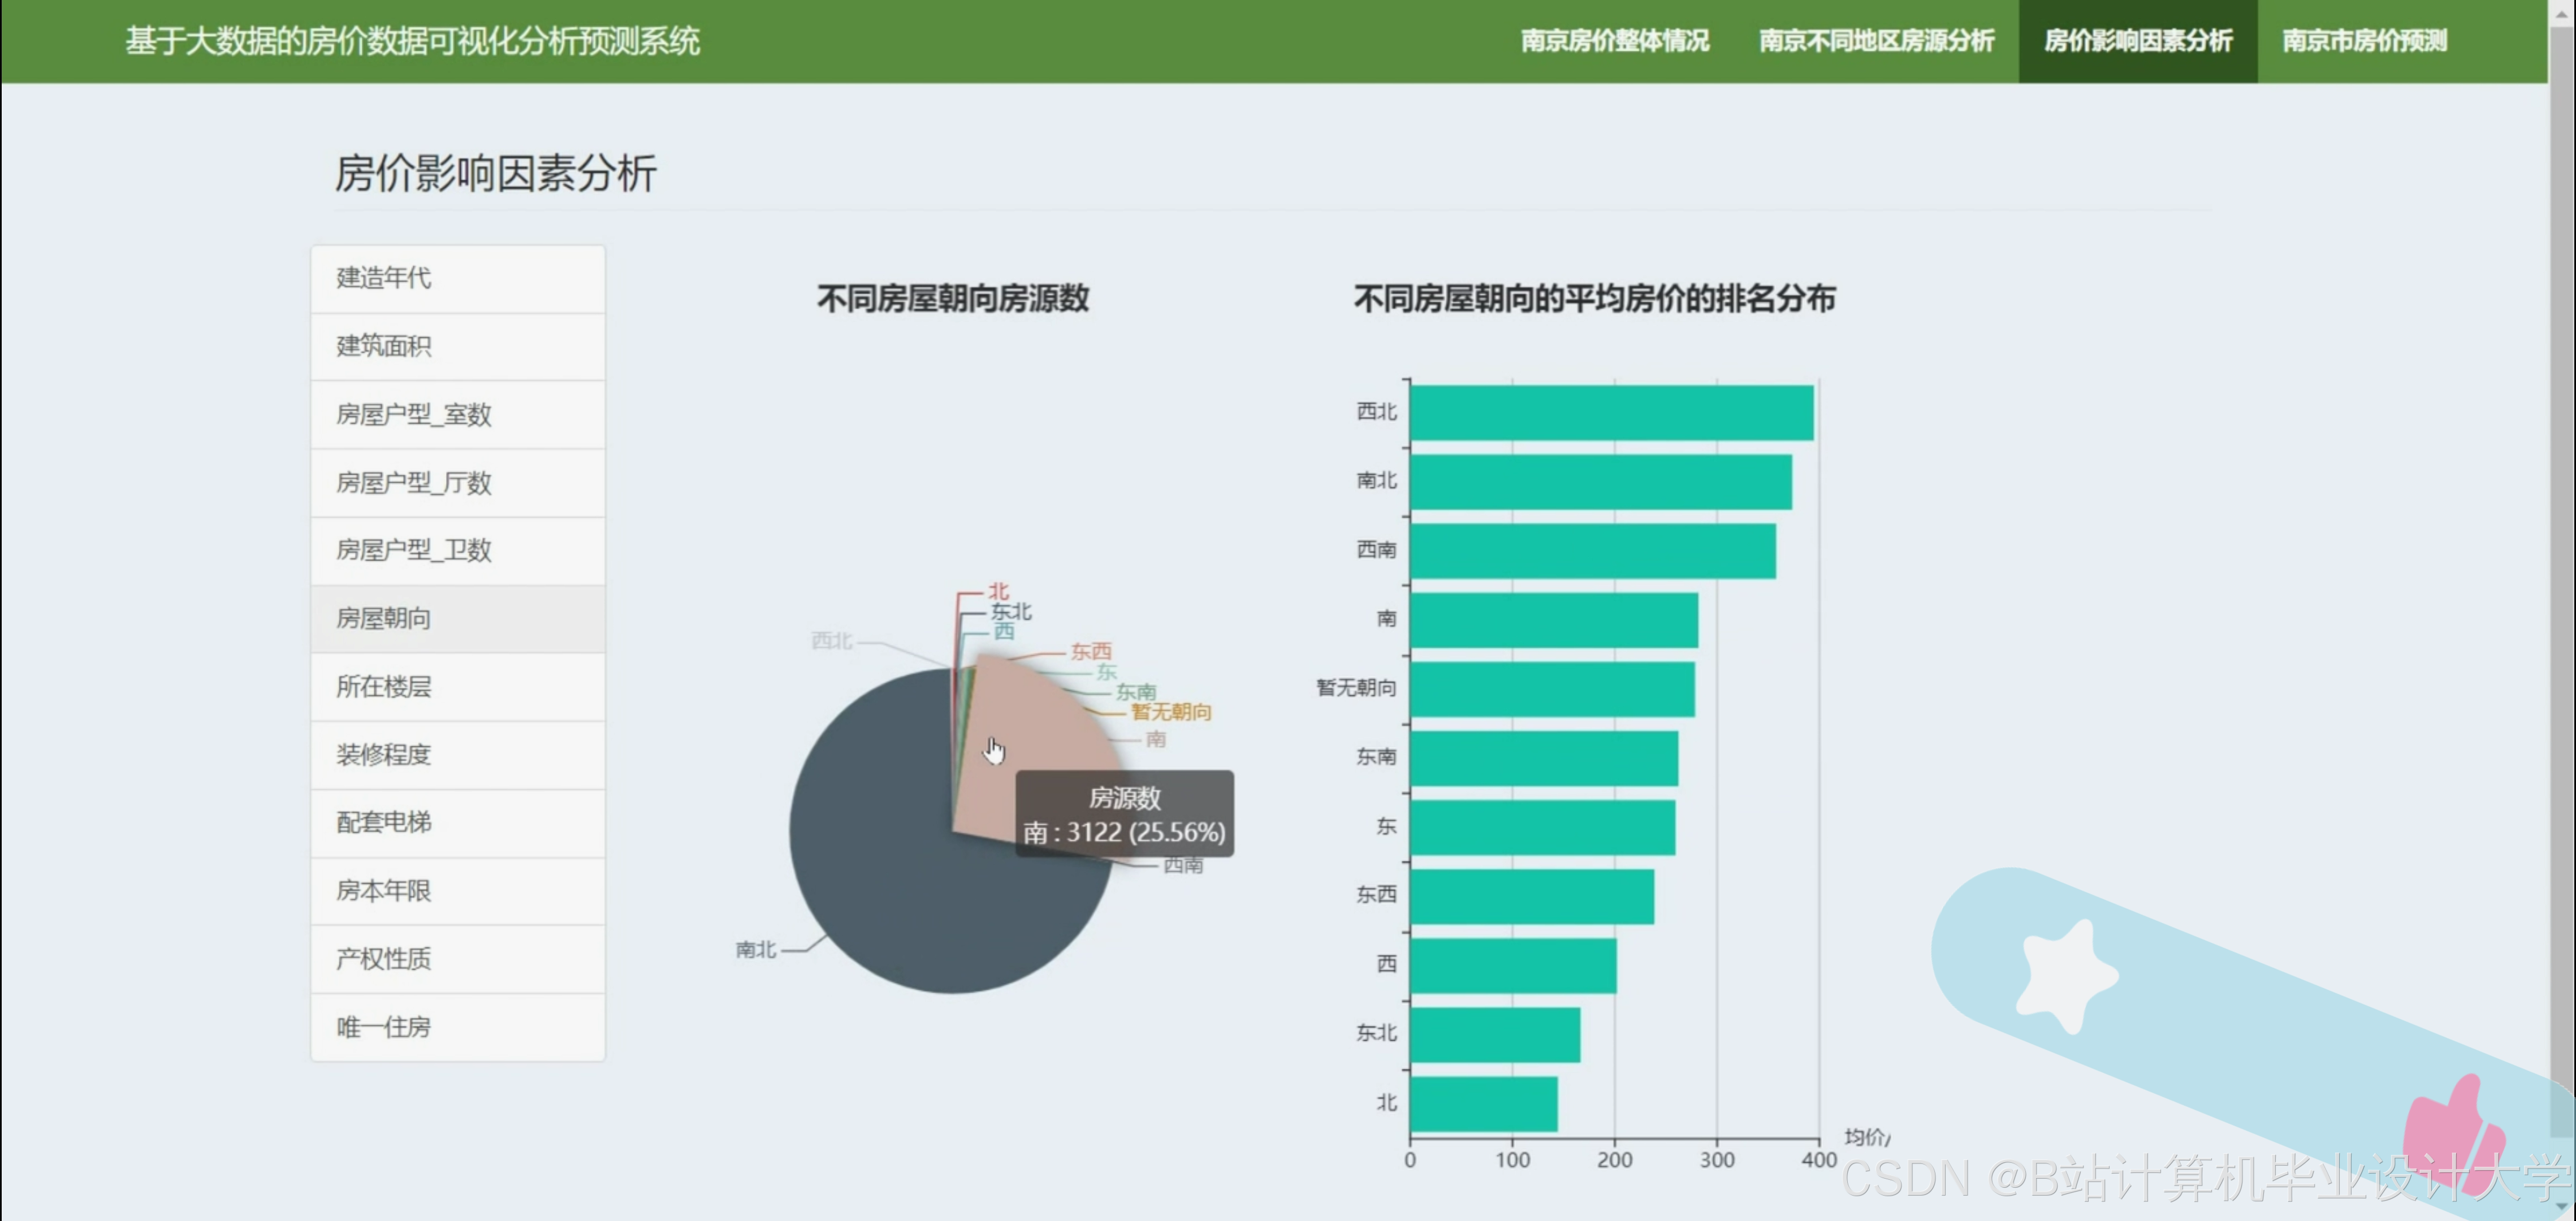
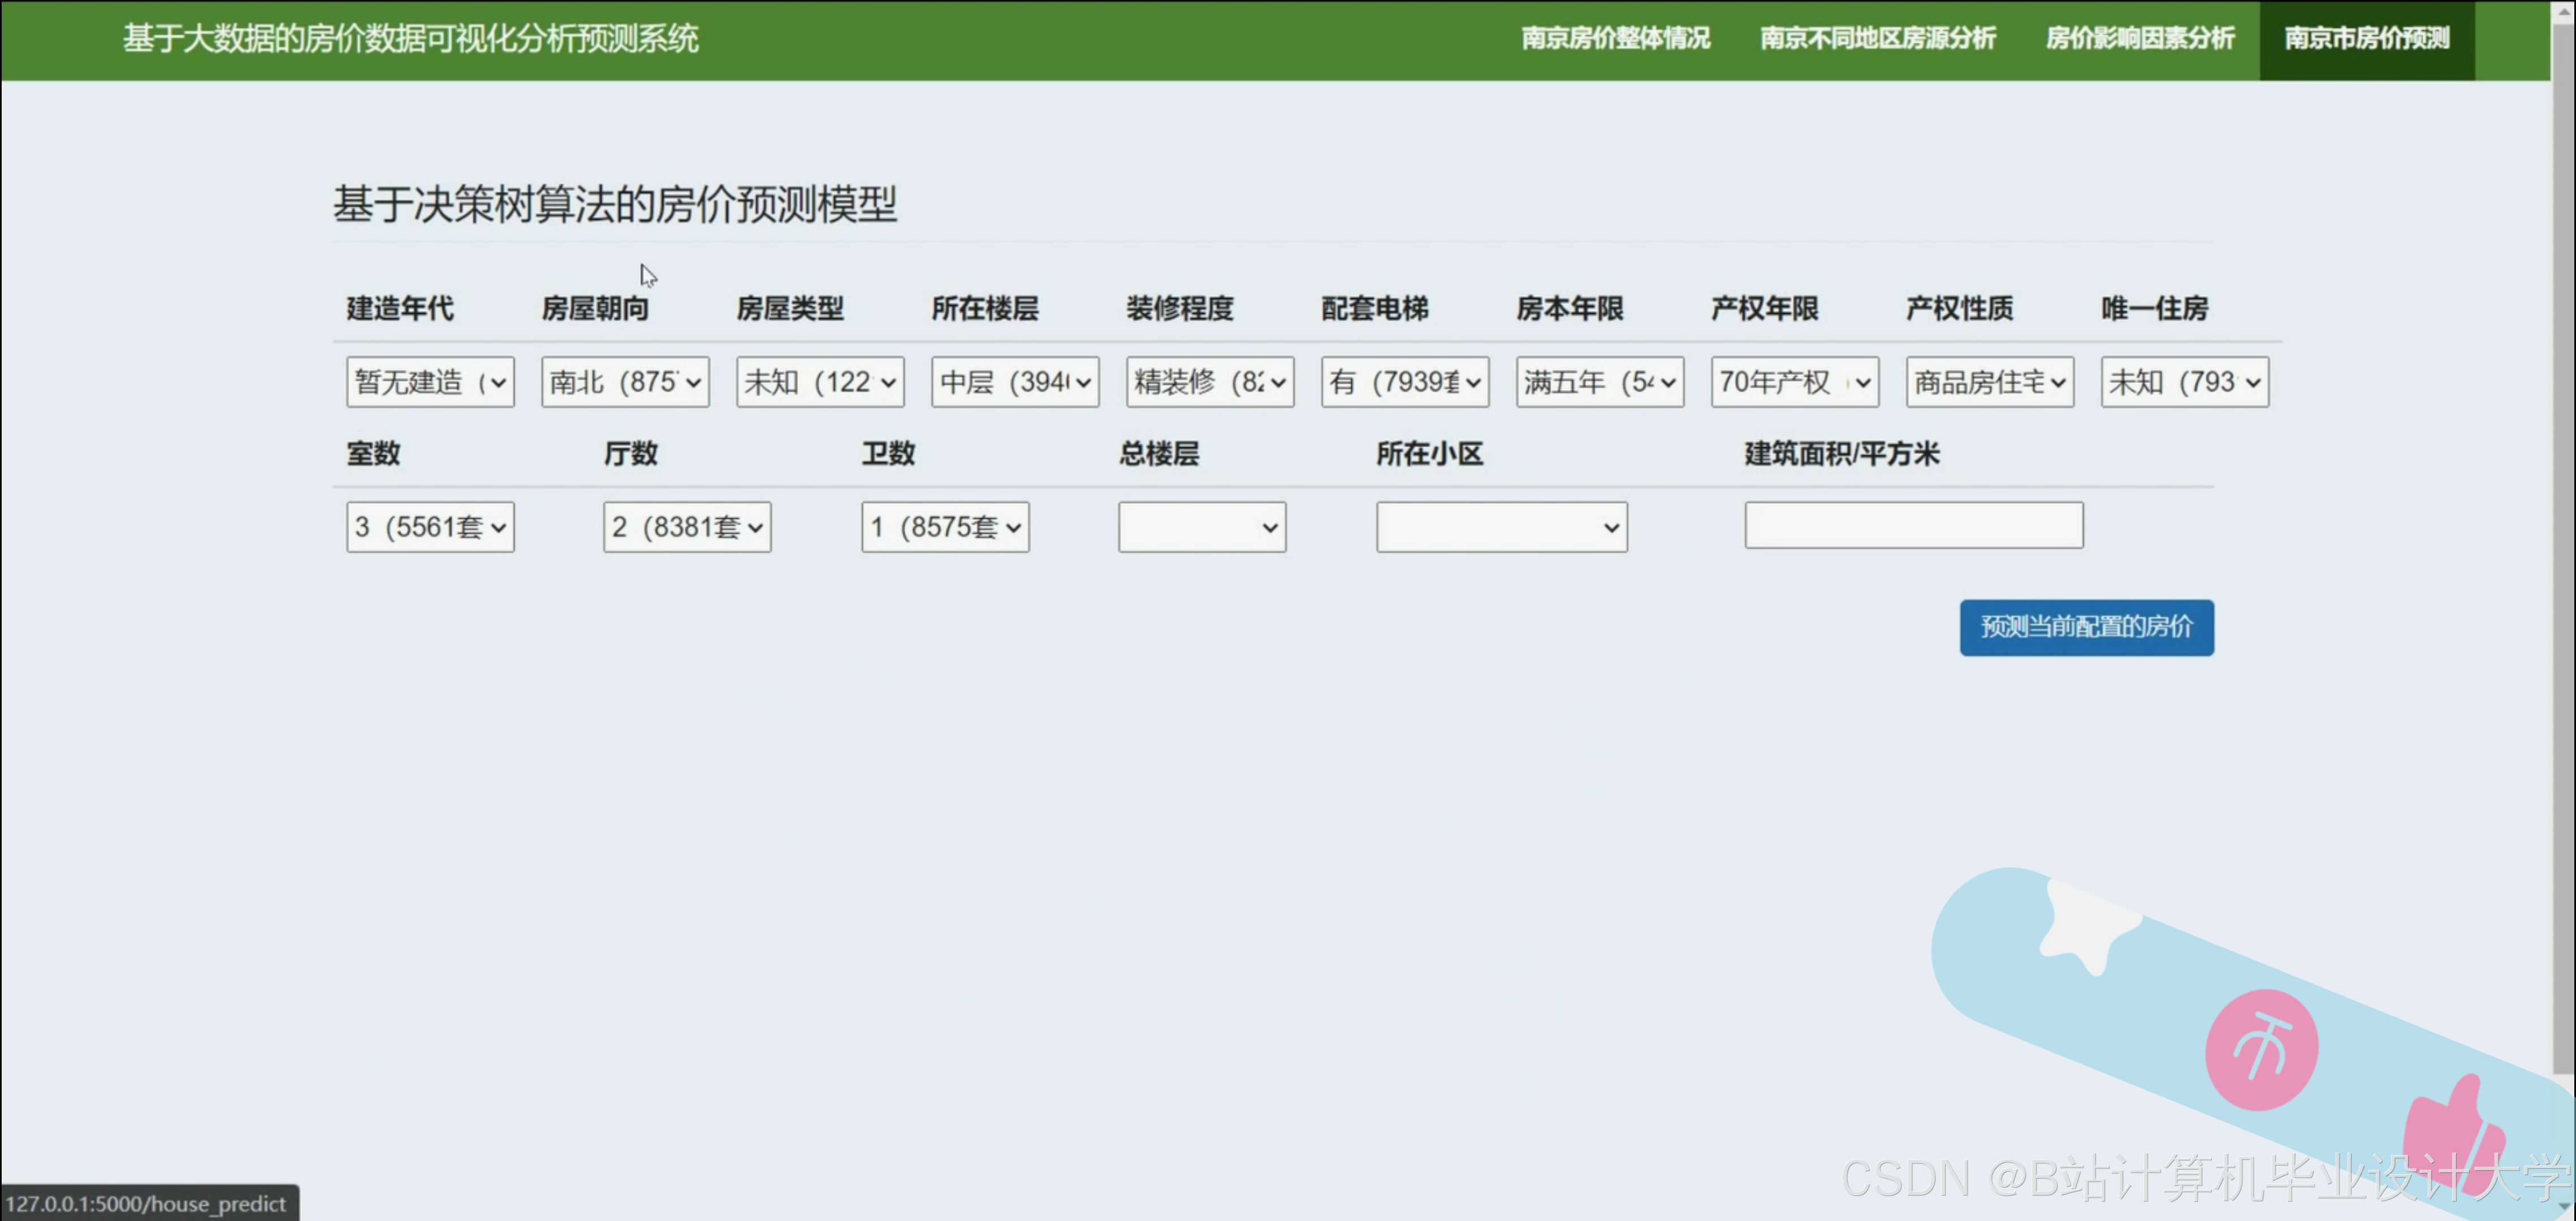
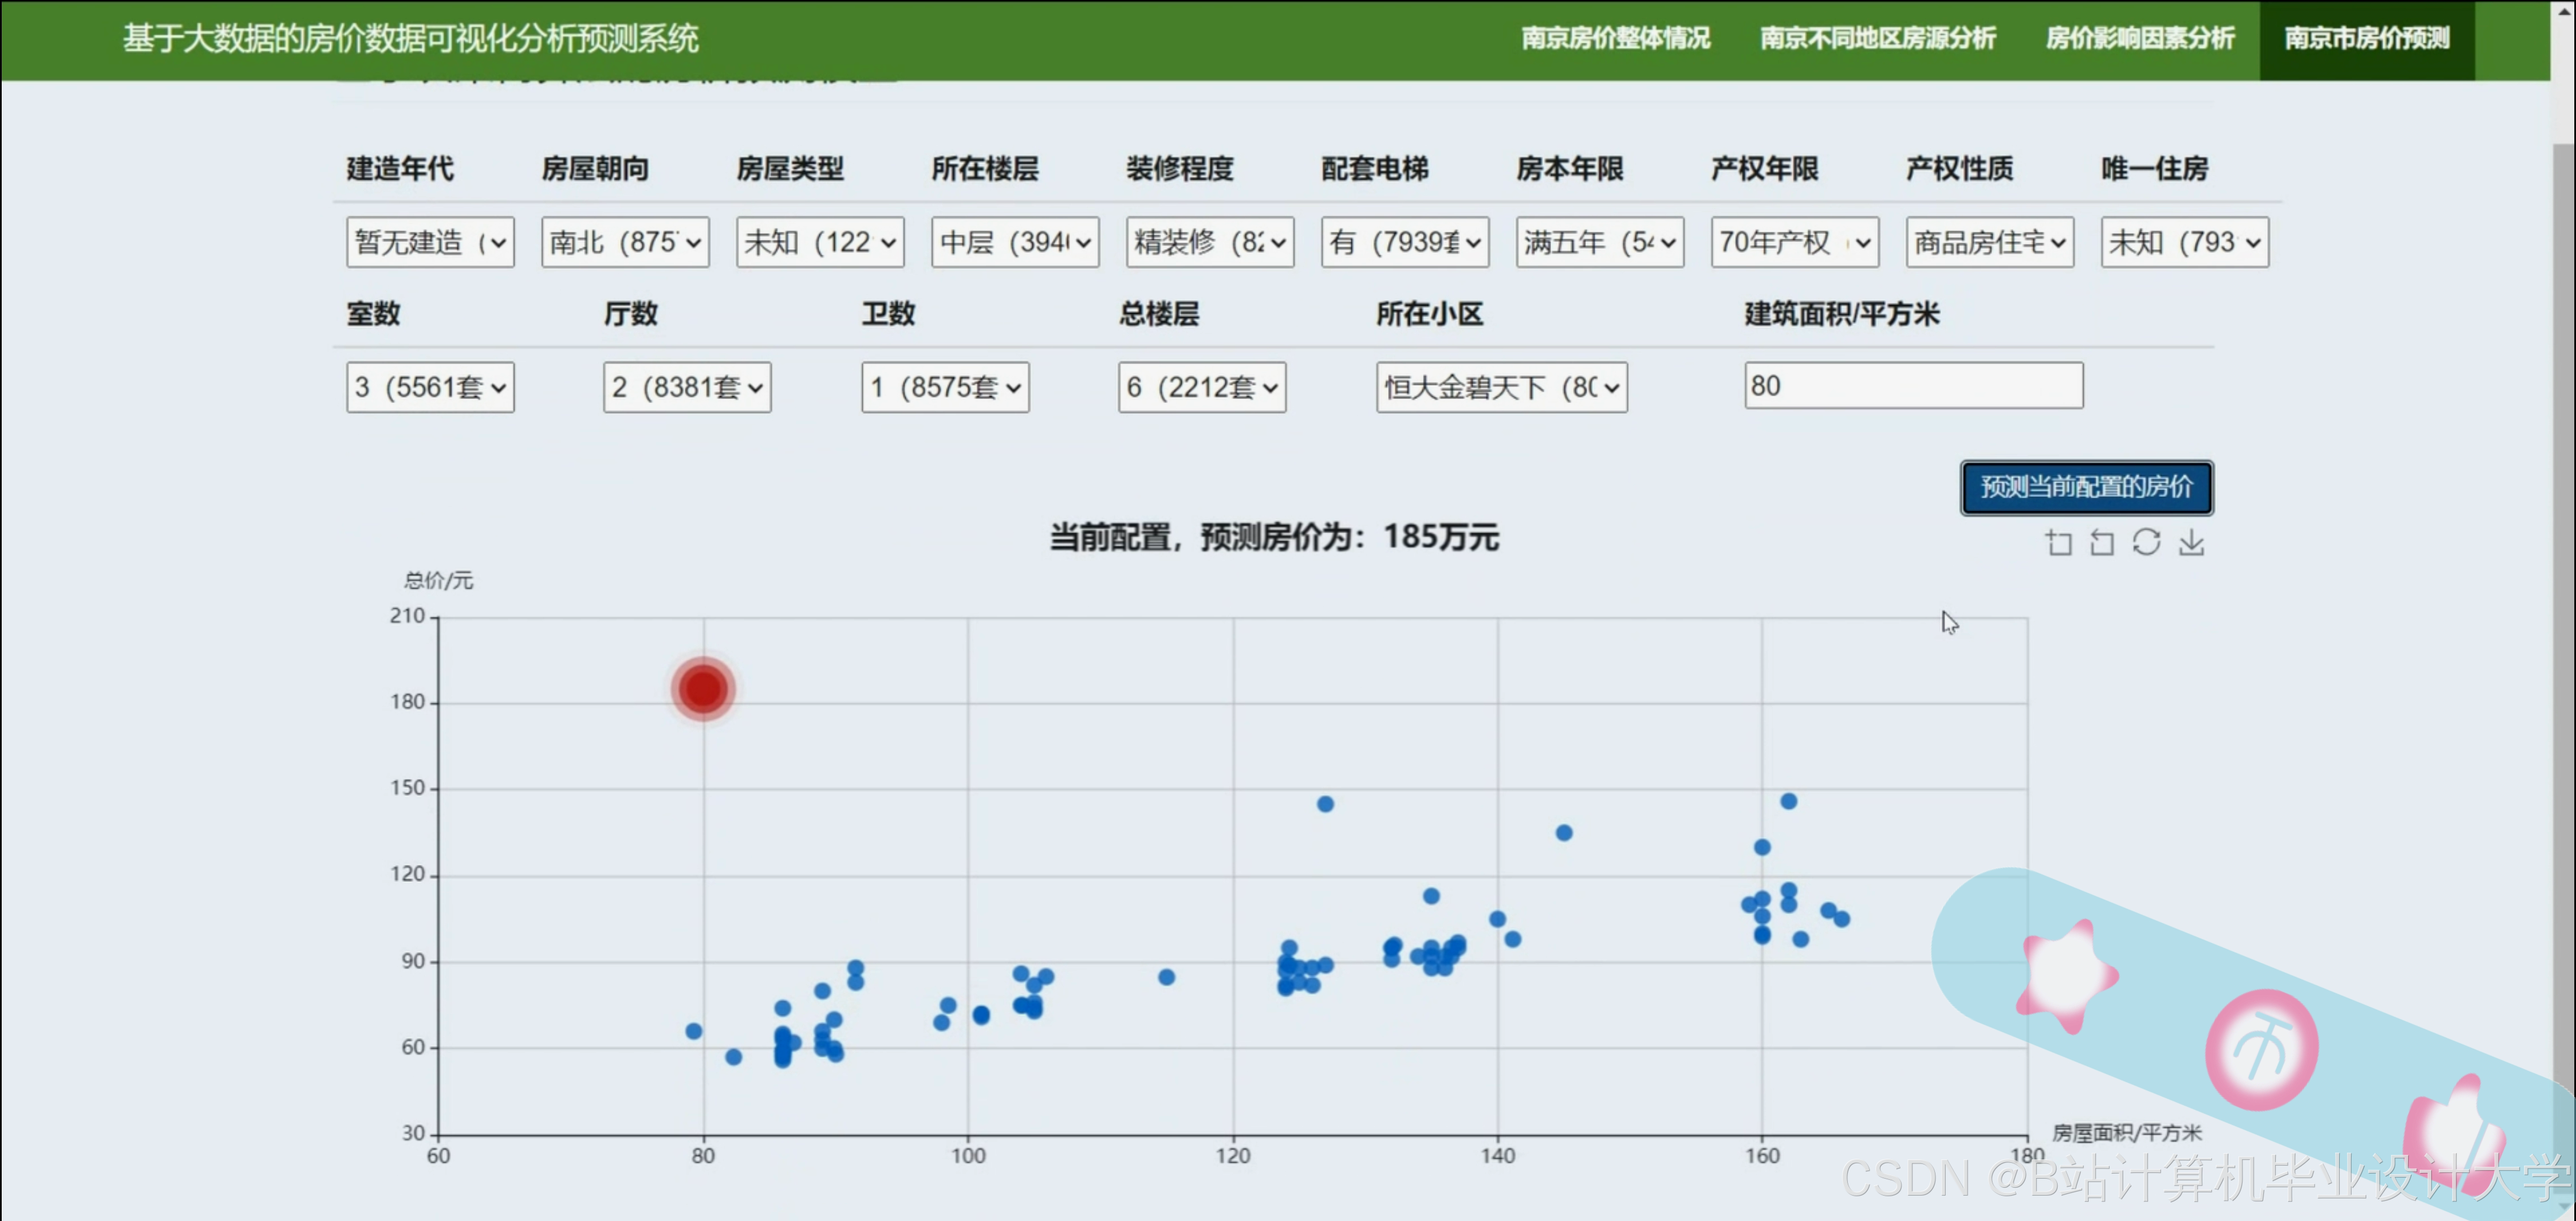
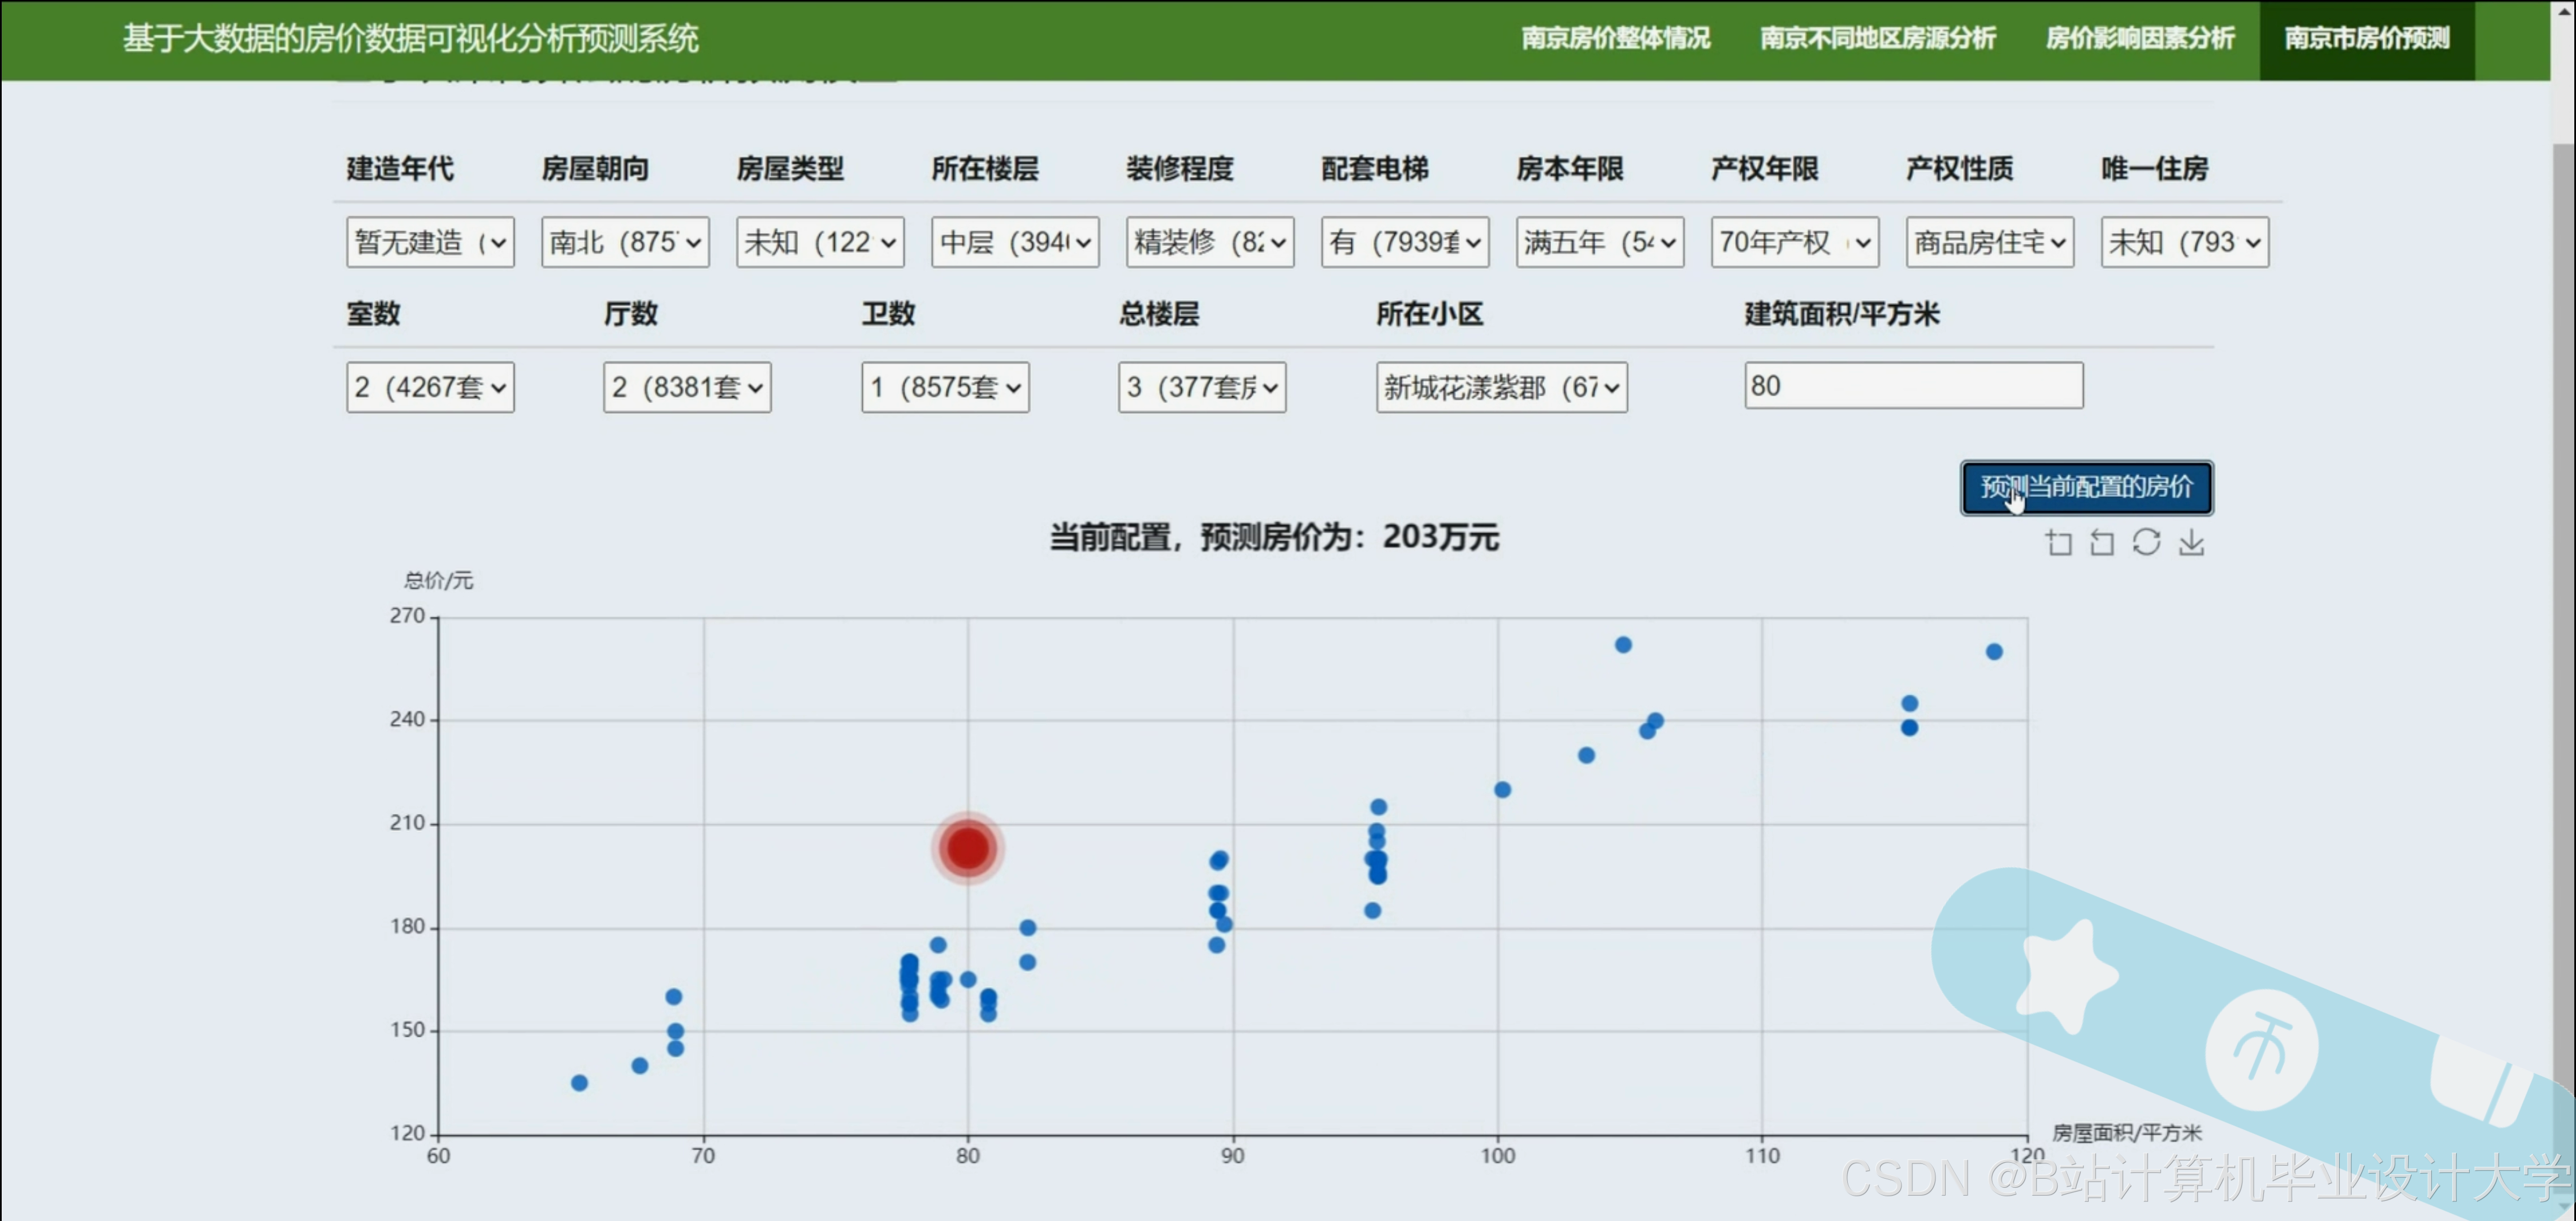
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 24
 0
- 0


 已为社区贡献573条内容

所有评论(0)