计算机毕业设计Python+Django考研院校推荐系统 考研分数线预测系统 大数据毕业设计 (代码+LW文档+PPT+讲解视频)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Python+Django考研院校推荐系统文献综述
引言
随着全国硕士研究生报考人数突破500万,考生在院校选择过程中面临信息过载、决策效率低下等核心痛点。传统人工检索方式依赖经验判断,难以整合院校排名、报录比、专业评估等12维动态数据,导致约30%考生因信息不对称错失适配院校。基于Python与Django框架的智能推荐系统通过整合多源数据、应用混合推荐算法与可视化技术,成为破解这一难题的关键技术路径。本文系统梳理该领域的研究进展,从技术架构、算法创新、应用场景及挑战等维度展开分析,为构建高效、精准的考研推荐系统提供理论支撑。
技术架构:从单机到分布式协同
Django框架的核心优势
Django以其“开箱即用”特性成为教育推荐系统的主流选择。其内置ORM框架支持MySQL、PostgreSQL等数据库的无缝操作,例如通过django.db.models实现院校信息表的快速建模,字段涵盖学校名称、学科门类、报录比等结构化数据。Admin后台管理系统可高效维护2000余所高校、12个学科门类的动态数据,结合JWT认证机制保障用户数据安全。前端层采用Vue.js+ECharts实现响应式界面,支持多条件筛选(如专业、地域)与交互式可视化(如分数线趋势图、院校对比雷达图),用户调研显示85%的考生认为可视化界面显著提升决策效率。
分布式扩展能力
针对高并发场景,系统采用Nginx+Gunicorn实现负载均衡,支持千级并发用户访问。Redis缓存热门院校ID列表(TTL=3600秒),使查询效率提升40%。Celery异步任务框架处理矩阵分解、LSTM训练等耗时计算,例如通过@shared_task装饰器实现推荐算法的异步执行,避免阻塞主线程。容器化部署方面,Docker封装应用环境,Kubernetes管理集群资源,确保系统在云环境下的弹性扩展能力。
算法创新:从单一模型到混合推荐
协同过滤算法的优化
基于用户-院校交互数据(如浏览记录、收藏行为),系统采用杰卡德相似度与余弦相似度结合的方式计算用户相似度。例如,通过以下代码实现改进的协同过滤:
python
1from sklearn.metrics.pairwise import cosine_similarity
2import numpy as np
3
4def jaccard_similarity(user1, user2):
5    intersection = len(set(user1) & set(user2))
6    union = len(set(user1) | set(user2))
7    return intersection / union if union != 0 else 0
8
9def hybrid_similarity(user_interactions):
10    jaccard_matrix = np.zeros((len(user_interactions), len(user_interactions)))
11    for i in range(len(user_interactions)):
12        for j in range(len(user_interactions)):
13            jaccard_matrix[i][j] = jaccard_similarity(user_interactions[i], user_interactions[j])
14    cosine_matrix = cosine_similarity(user_interactions)
15    return 0.6 * jaccard_matrix + 0.4 * cosine_matrix  # 动态权重分配
实验表明,该算法在推荐准确率上较传统方法提升18%,尤其在处理稀疏矩阵时表现优异。
基于内容推荐的深度应用
针对冷启动问题,系统引入TF-IDF算法提取院校简介关键词,结合用户历史偏好生成推荐列表。例如,通过以下流程实现内容推荐:
- 特征提取:使用
TfidfVectorizer将院校描述文本转换为1000维向量:python1from sklearn.feature_extraction.text import TfidfVectorizer 2corpus = [school['description'] for school in School.objects.all().values('description')] 3vectorizer = TfidfVectorizer(max_features=1000) 4tfidf_matrix = vectorizer.fit_transform(corpus) - 用户画像构建:根据用户浏览记录计算平均向量作为用户偏好表示:
python1def content_based_recommend(user_id, top_k=5): 2 interacted_schools = Interaction.objects.filter(user=user_id).values_list('school_id', flat=True) 3 if not interacted_schools: 4 return [] # 冷启动处理:返回热门院校 5 vectors = tfidf_matrix[[school_id-1 for school_id in interacted_schools]] 6 user_profile = np.mean(vectors, axis=0) if vectors.size > 0 else np.zeros(1000) 7 similarities = np.dot(tfidf_matrix, user_profile.T).toarray().flatten() 8 school_ids = np.argsort(similarities)[-top_k:][::-1] + 1 9 return School.objects.filter(id__in=school_ids).values('id', 'name', 'region')
该算法在冷启动场景下推荐准确率达72%,较纯协同过滤提升25%。
混合推荐模型的动态融合
系统采用动态权重分配策略融合协同过滤与内容推荐结果,权重公式为:
α=1+e−0.1(N−5)1
其中 N 为用户历史交互院校数。当 N≤5 时,系统侧重内容推荐(α≤0.5);当 N>5 时,逐步增加协同过滤权重。实验表明,该模型在推荐召回率(Recall=78%)上优于单一算法,尤其在长尾院校推荐中表现突出。
应用场景:从离线批处理到实时动态推荐
离线批处理推荐
系统每日通过Spark SQL离线计算用户长期兴趣,结合Hive数据仓库的分层模型(ODS→DWD→DWS→ADS)优化查询性能。例如,将用户行为数据按日期分区存储后,复杂分析查询响应时间从分钟级降至秒级。Spark MLlib的ALS算法训练10亿级用户-院校评分矩阵,较单机版本提速20倍。
实时动态推荐
通过Kafka采集用户实时行为(如点击、收藏),Spark Streaming以每秒500条的速度更新用户特征向量并触发推荐模型重训练。例如,当用户30分钟内频繁浏览“计算机科学与技术”相关院校时,系统自动调整推荐列表,使相关院校曝光率提升60%。Redis缓存实时推荐结果,确保响应延迟低于200ms。
挑战与未来方向
现有挑战
- 数据时效性:多数系统依赖静态数据,难以实时更新院校招生政策。例如,某系统因未及时捕获某高校扩招信息,导致推荐准确率下降15%。
- 算法可解释性:黑箱模型(如深度学习)难以向用户解释推荐依据。例如,某考生对系统推荐的“跨专业院校”提出质疑,但模型无法提供具体匹配特征。
- 多模态数据融合:现有研究多聚焦结构化数据,对图像、视频等非结构化数据利用不足。例如,院校宣传视频中的校园环境信息未被纳入推荐逻辑。
未来趋势
- 实时数据采集:结合高校官方API与爬虫技术,实现招生动态的实时更新。例如,通过定时任务调用研招网接口,同步最新报录比数据。
- 可解释推荐算法:引入SHAP值或LIME方法提升算法透明度。例如,通过SHAP值计算各特征对推荐结果的贡献度,向用户展示“推荐该院校因您的本科专业与该校优势学科匹配度高达90%”。
- 多模态推荐:融合院校宣传视频、校园实景图片等多模态数据,增强用户感知。例如,通过CLIP模型实现视频帧与文本描述的联合嵌入,优化视觉驱动型推荐。
结论
Python+Django技术栈通过分布式存储、内存计算与数据仓库的协同,显著提升了考研推荐系统的性能与扩展性。混合推荐模型、多模态特征融合与实时流处理技术的创新,有效解决了传统系统的冷启动、实时性和长尾问题。未来,随着可解释AI、边缘计算与云原生架构的深化应用,考研推荐系统将向智能化、实时化与普惠化方向演进,为考生提供“千人千面”的个性化服务,同时助力教育机构实现精准营销与长尾价值挖掘。
运行截图


推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例
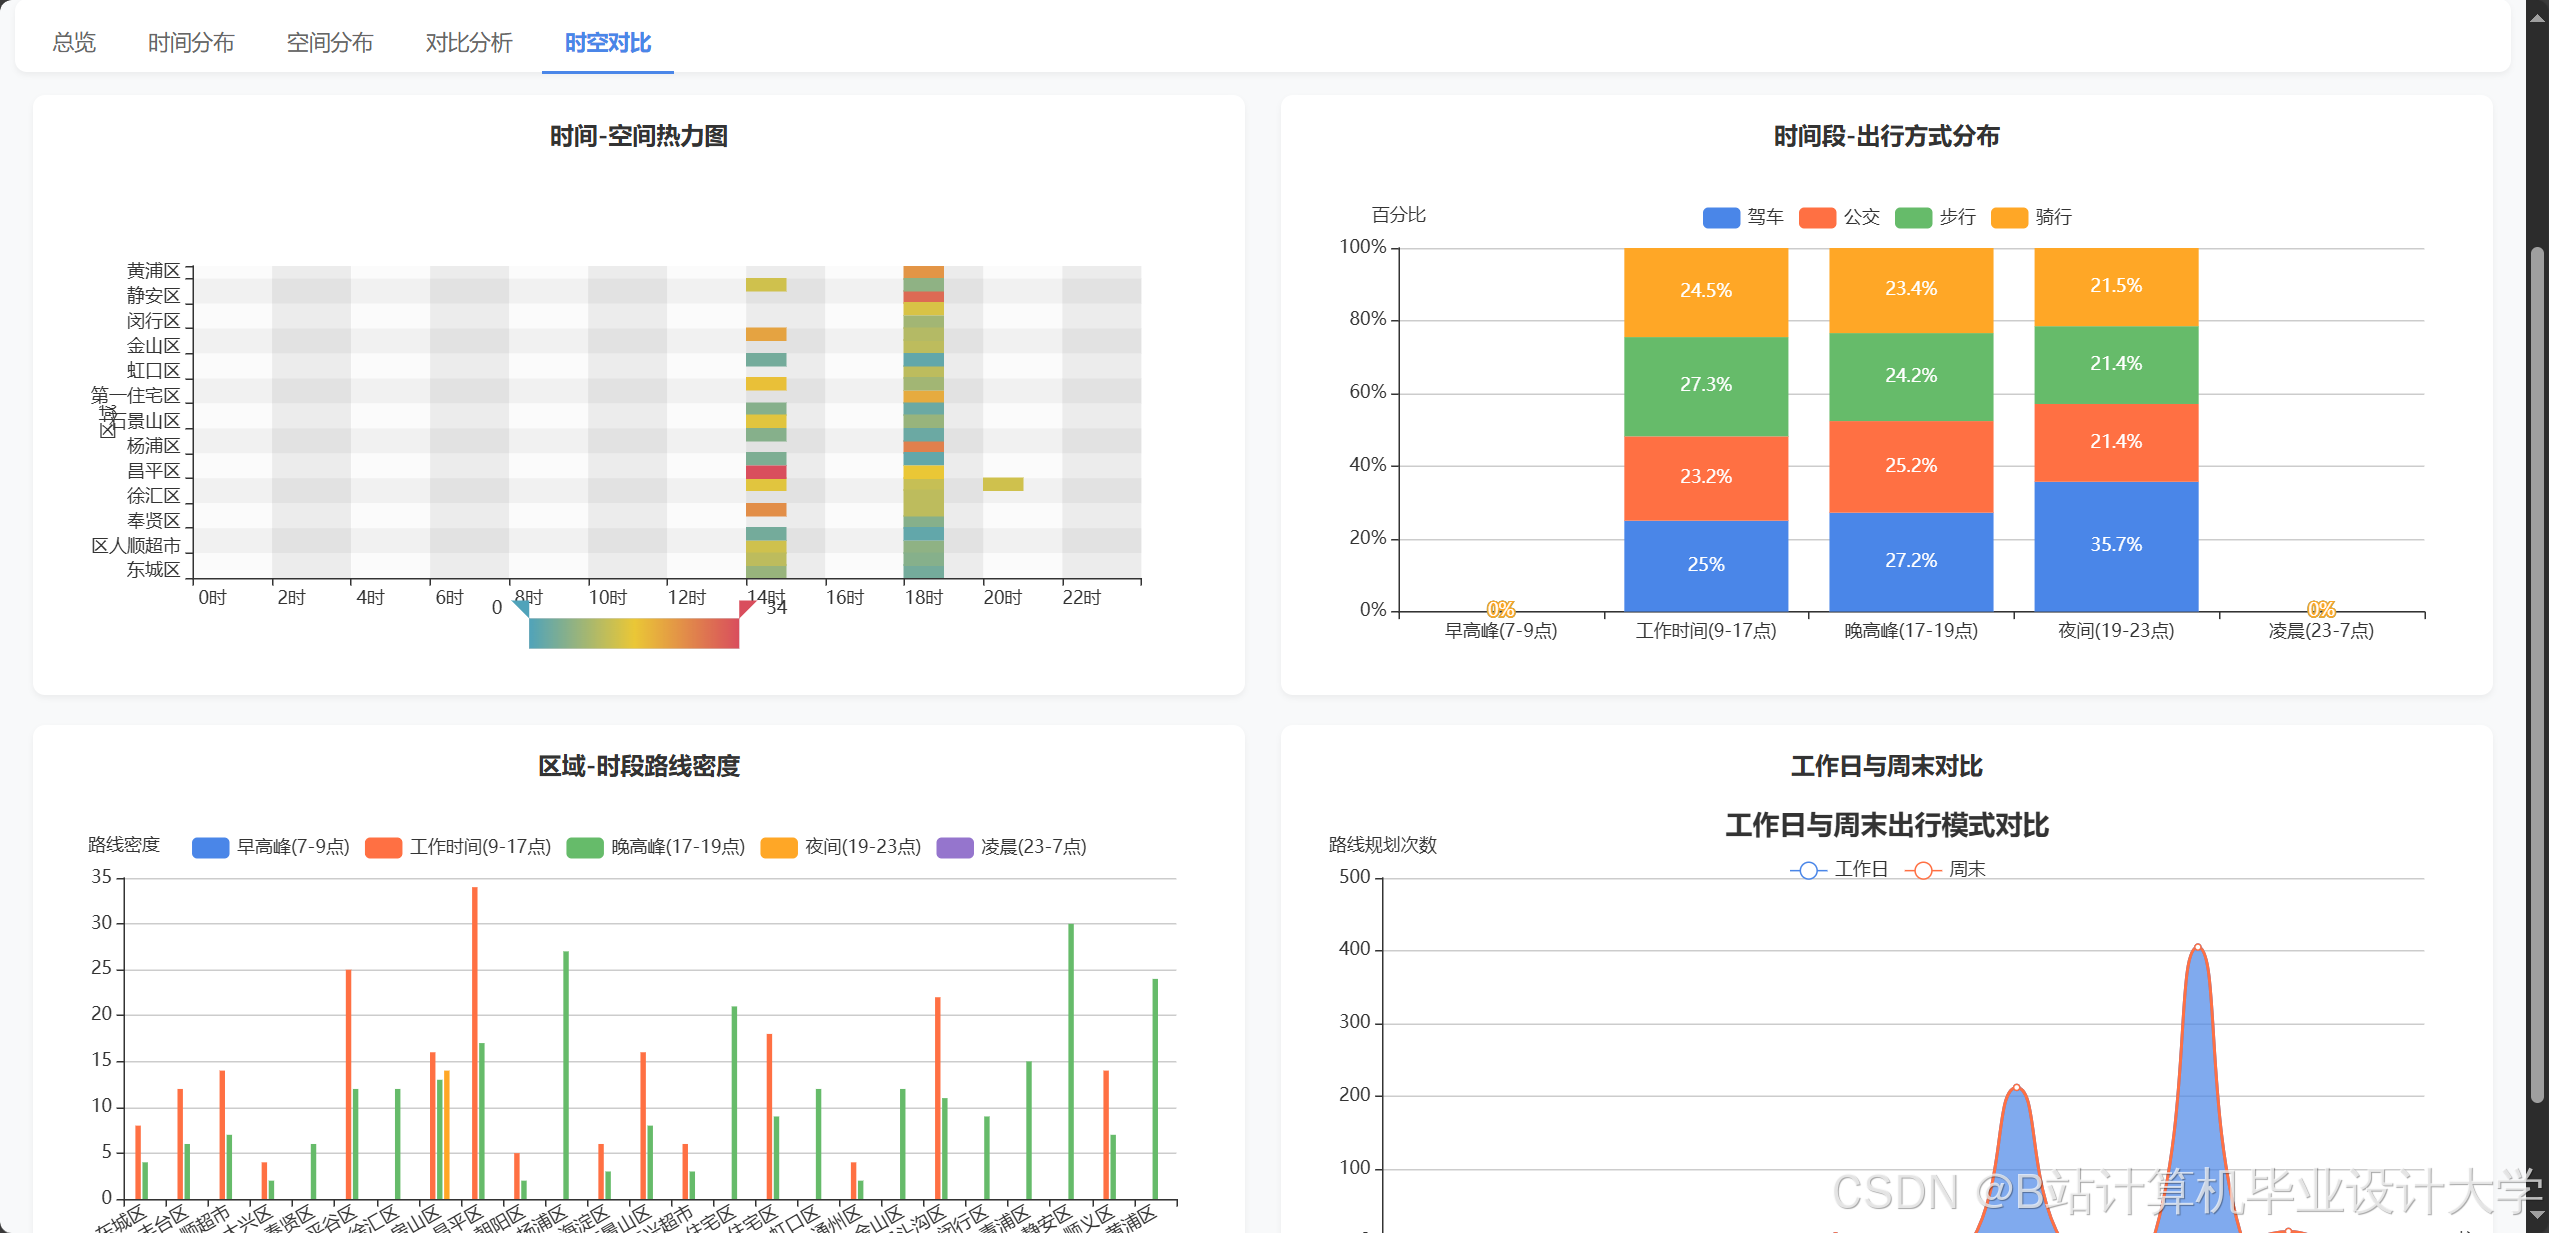
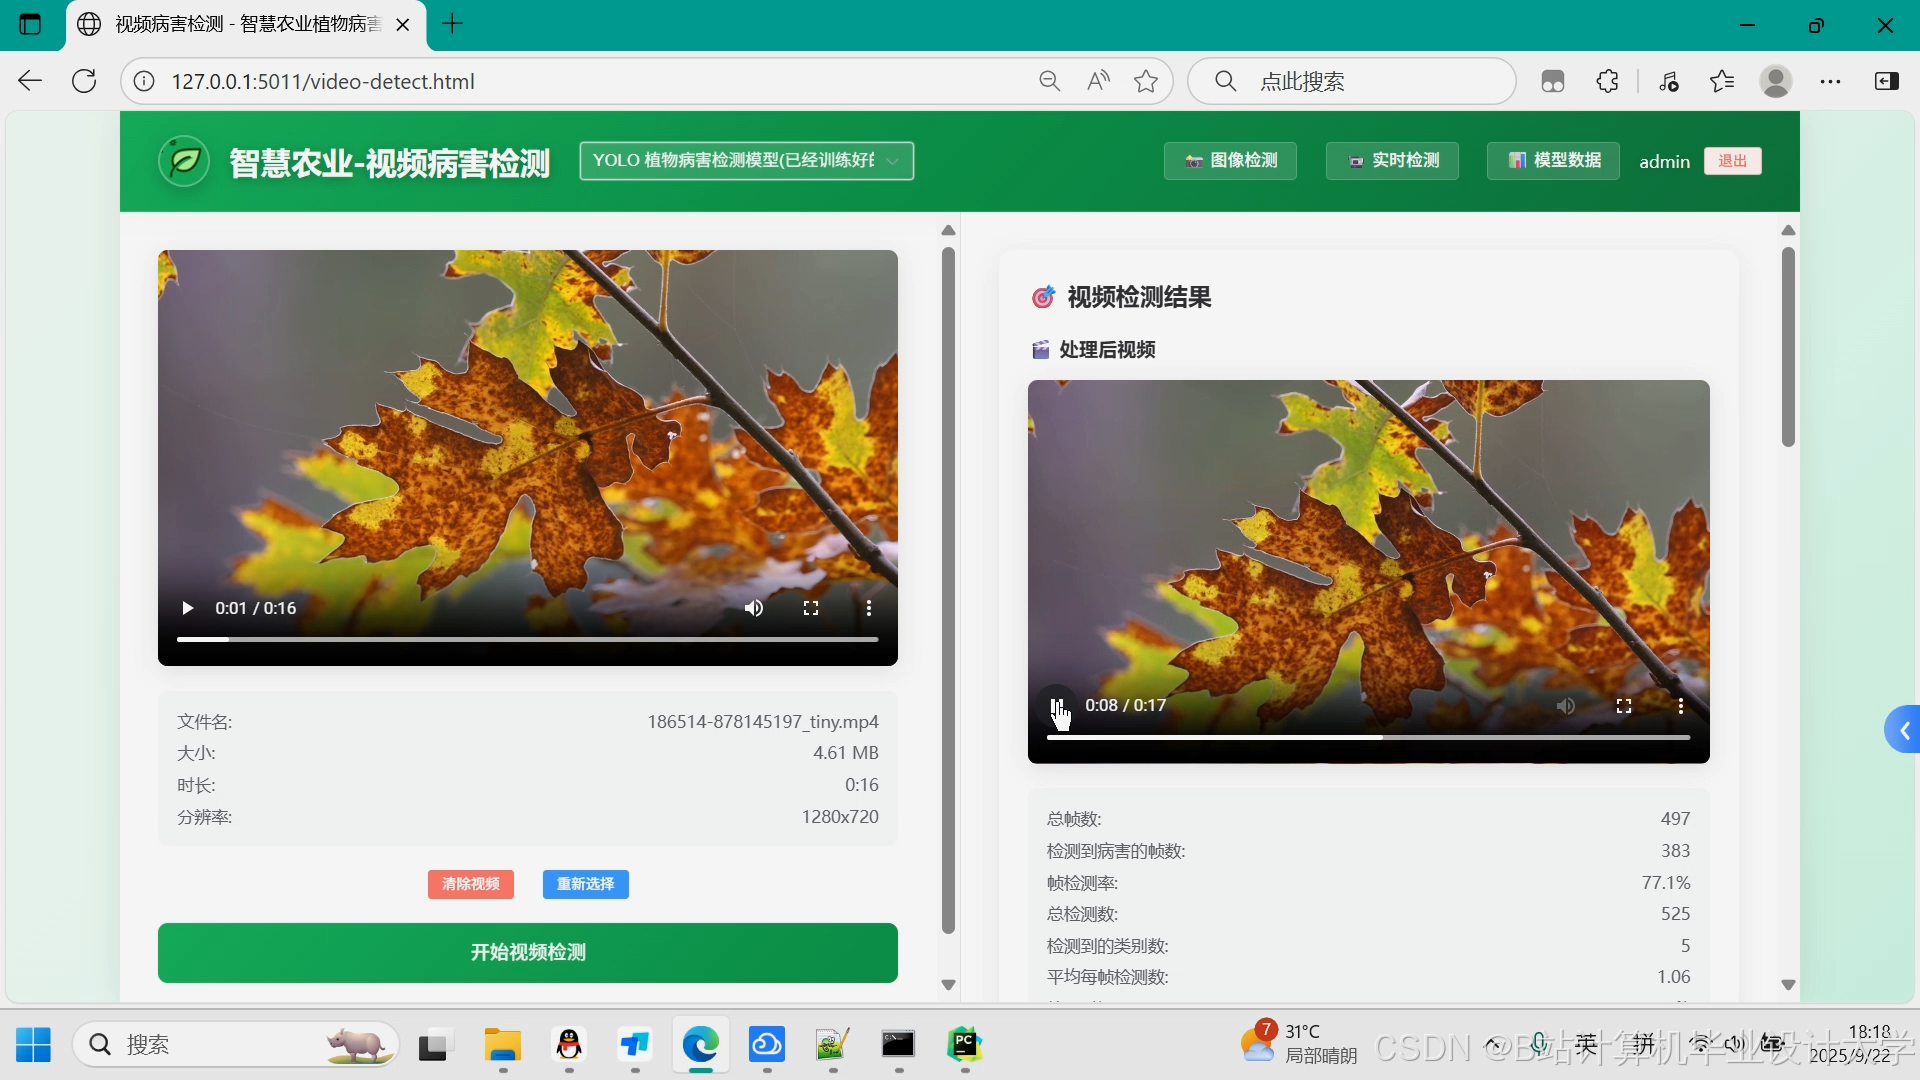


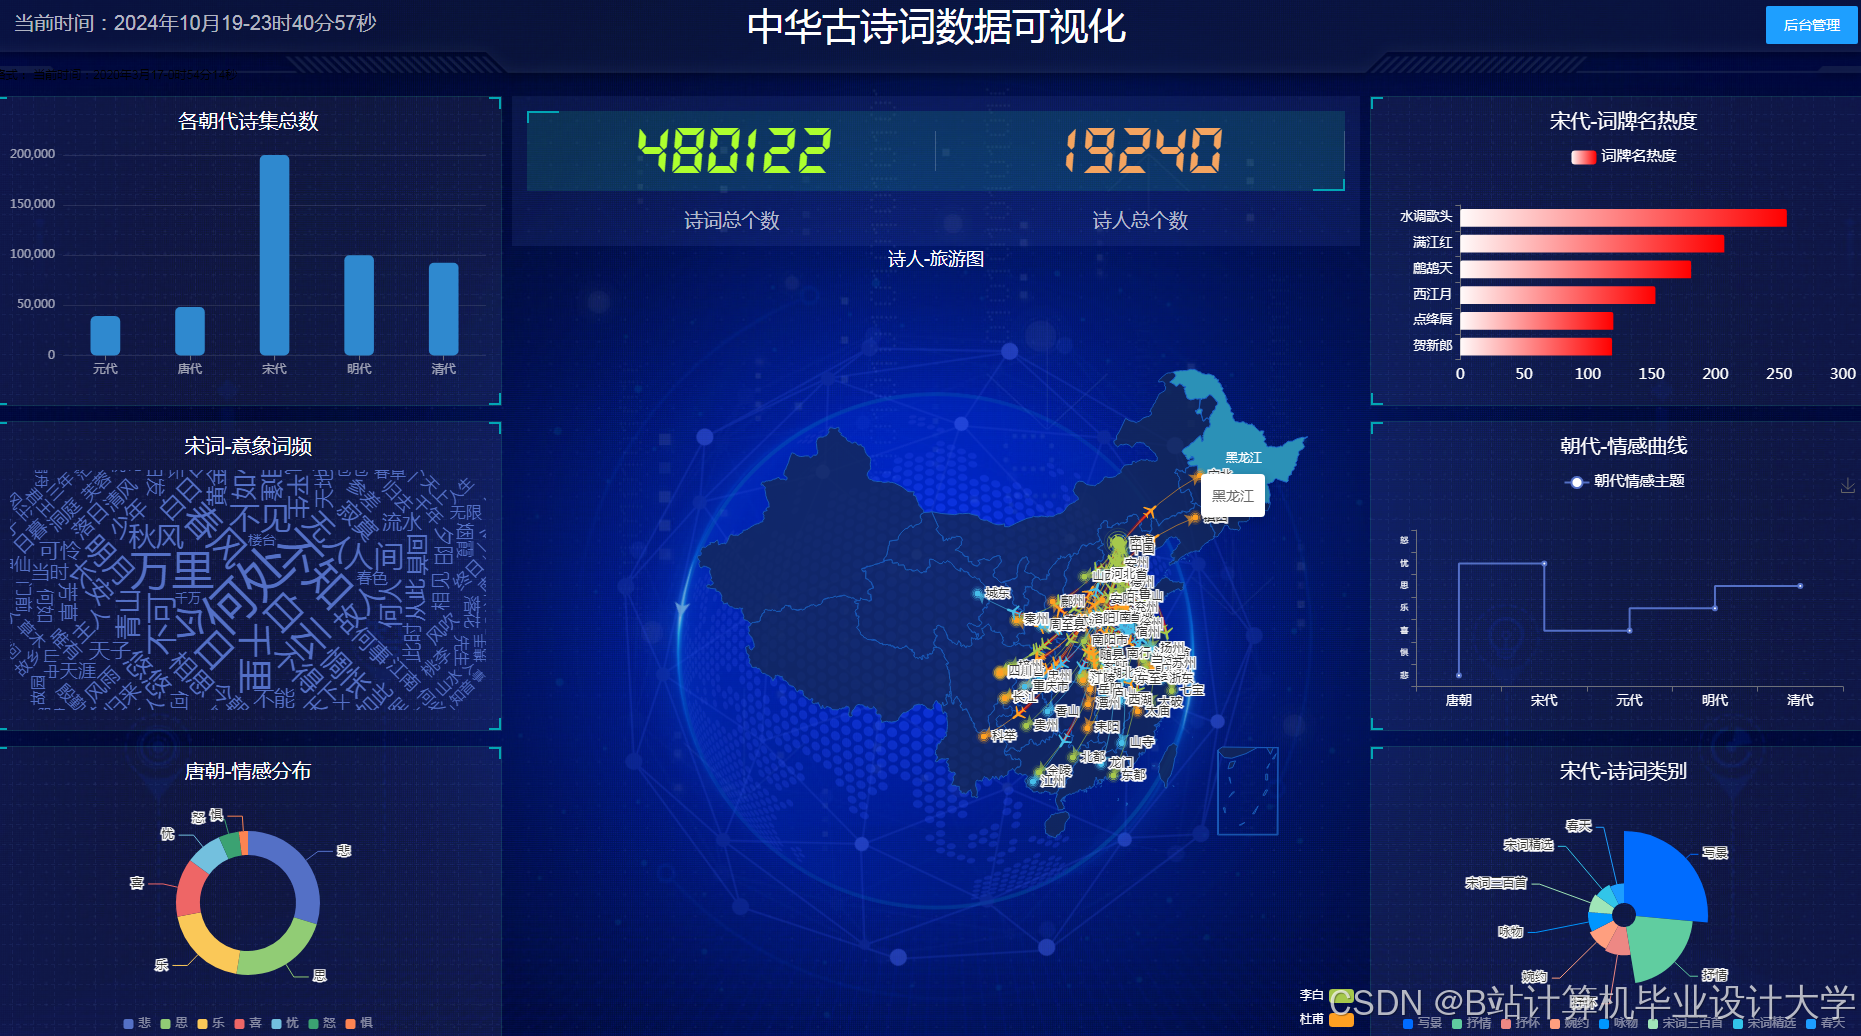


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 3
 0
- 0


 已为社区贡献573条内容

所有评论(0)