沐神《动手学深度学习》之3.6softmax回归
目录
前言
现在,我们已经知道了神目石softmax回归,也拥有了Fashion-MINIST数据集。所有的准备工作已经完成,本节我们要从零开始实现softmax回归。
那好,我们接下来开始。
一、加载数据集
在上一节,我们已经把Fashion-MINIST数据集加载器封装成了一个类。作者把它放在了load_data_fashion_mnist.py文件中,我们想要用Fashion-MINIST数据集,只需要导入这个文件就行了。
from load_data_fashion_mnist import FashionMNISTDataLoader

fashion_minist = FashionMNISTDataLoader(batch_size=256)
#创建FashionMNISTDataLoader类对象(这里batch_ size默认值是256,不设置也行)

train_iter, test_iter = fashion_minist.create_dataloaders()#迭代器
二、初始化模型参数
所有模型的最终目的都是寻找最合适的权重W和偏置b,但是想要训练模型,得先初始化这两个值。
与线性回归一样,我们将使用正态分布初始化我们的权重W,偏置初始化为0。
import torch
num_input = 28*28
num_output = 10
W = torch.normal(0,0.01,(num_input,num_output),requires_grad=True)
b = torch.zeros(num_output,requires_grad=True)
三、定义softmax操作
还记得softmax函数吗?
K是总类别数,对于类别 j的得分 sj,其概率 P(j) 为:
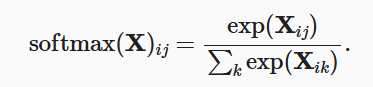
书上根据公式,将softmax实现分成了三步:
1.对每个项求幂(使用exp);
2.对每一行求和(小批量中每个样本是一行),得到每个样本的规范化常数;
3.将每一行除以其规范化常数,确保结果的和为1。
实现代码如下:
#定义softmax操作
def softmax(X):
    X_exp = torch.exp(X)
    partition = X_exp.sum(dim=1,keepdim=True)#计算每一行的总和,计算结果是一个列向量
    return X_exp / partition  # 这里应用了广播机制

#更具softmax函数定义模型
def net(X):
    return softmax(torch.matmul(X.reshape((-1, W.shape[0])), W) + b)
四、损失函数
3.4节说过的交叉熵损失:
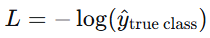
#交叉熵损失
def cross_entropy(y_hat, y):
    return - torch.log(y_hat[range(len(y_hat)), y])
以下的256是batch_size,也就是批量大小
y_hat:预测值,形状(256,10),y_hat = WX +b
len(y_hat):获取y_hat维度的长度,256
range(len(y_hat)):生成一个从 0 到256-1 的整数序列,作为每个样本的索引。
y:真实类别标签,形状(256,)
y_hat[range(len(y_hat)), y]:它从y_hat这个预测张量中,精确地挑选出每个样本对应真实标签 y 的那个预测值,结果是一个一维张量,形状为(256,),包含了每个样本对其真实标签的预测值。
因为涉及到线性代数,所以比较抽象,看不懂多看几遍。
五、分类精度
分类精度即正确预测数量与总预测数量之比。
5.1正确预测数量
def accuracy(y_hat, y):  #@save
    """计算预测正确的数量"""
    if len(y_hat.shape) > 1 and y_hat.shape[1] > 1:
        y_hat = y_hat.argmax(dim=1)#取概率最大值的列索引
    cmp = y_hat.type(y.dtype) == y#判断y_hat和y是否相同,返回布尔值
    return float(cmp.type(y.dtype).sum().item())#把布尔值转化为数字,然后累计求和
    #使用 .item() 或 .detach() 方法从张量中提取值,同时中断梯度跟踪。
首先判断, len(y_hat.shape) > 1检查y_hat是否是二维及以上张量,y_hat.shape[1] > 1第二维度是否大于1。
为什么要加这个判断呢?这个判断条件是为了区分两种不同的预测结果格式。
我们这个y_hat是矩阵,一定满足这个条件,所以是不需要这个判断的。但是为了避免模型输出直接的类别预测,而不是概率分布,所以需要加上这个判定条件。
5.2累加器
class Accumulator:  #@save
    """在n个变量上累加"""
    def __init__(self, n):#需要累加变量的数量
        self.data = [0.0] * n#创建长度为n的列表


    def add(self, *args): #将传入的每个参数与对应的累加器位置的值相加
        self.data = [a + float(b) for a, b in zip(self.data, args)]

    def reset(self):#将所有累加值重置为 0.0,但保持原来的长度
        self.data = [0.0] * len(self.data)

    def __getitem__(self, idx):#访问索引
return self.data[idx]这个类的主要功能是同时跟踪和累加多个数值变量,特别适用于批量训练时累计损失、准确率等指标。
我来解释一下这个方法add(self, *args)
初始化的self.data=[10.0,20.0,30.0]
投入的参数*args=(1,2,3),*args可变参数,可以接受任何数量的参数
for循环就是:
a = 10.0, b = 1
a = 20.0, b = 2
a = 30.0, b = 3
最后self.data = [11.0,22.0,33.0]
5.3模型评估函数
def evaluate_accuracy(net, data_iter):
    if isinstance(net, torch.nn.Module):
        net.eval()
    metric = Accumulator(2)#在Accumulator实例中创建了2个变量, 分别用于存储正确预测的数量和预测的总数量
    with torch.no_grad():
        for X, y in data_iter:#把每所有批次都累加起来
            metric.add(accuracy(net(X), y),y.numel())
    return metric[0]/metric[1]#分类精度即正确预测数量与总预测数量之比。
为什么要 设置评估模式:
-
确保评估结果的稳定性和可重复性
-
关闭训练特有的随机性(如Dropout)
-
使用固定的归一化统计量(BatchNorm)
-
获得模型的最佳性能表现
六、训练
6.1模型训练函数
这是一个完整的模型训练周期函数,用于在单个epoch内训练模型并计算训练指标。和线性回归有很多相似的过程。
代码有什么不懂的地方看注释。
def train_epoch_ch3(net, train_iter, loss, updater):
    if isinstance(net, torch.nn.Module):
        net.train()#将模型设置成训练模式
    metric = Accumulator(3)# 训练损失总和、训练准确度总和、样本数
    for X, y in train_iter:
        y_hat = net(X)#向前传播
        l = loss(y_hat, y)
        if isinstance(updater, torch.optim.Optimizer):# 使用PyTorch内置的优化器和损失函数
            updater.zero_grad()  # 清空梯度
            l.mean().backward()  # 计算梯度(对平均损失)
            updater.step()  # 更新参数
        else:#自定义优化器
            l.sum().backward()  # 计算梯度(对损失总和)
            updater(X.shape[0])  # 自定义参数更新,传入批次大小
        metric.add(float(l.sum().item()), accuracy(y_hat, y), y.numel())
    return metric[0] / metric[2], metric[1] / metric[2]
6.2绘图工具
接下来我们实现一个工具类Animate,它r是一个实时动画绘图工具,用于在机器学习训练过程中动态显示损失、准确率等指标的变化。
书上使用了d2l包,我这里仍然不使用。
import matplotlib.pyplot as plt
from IPython import display
import numpy as np


class Animator:

    def __init__(self, xlabel=None, ylabel=None, legend=None, xlim=None,
                 ylim=None, xscale='linear', yscale='linear',
                 fmts=('-', 'm--', 'g-.', 'r:'), nrows=1, ncols=1,
                 figsize=(3.5, 2.5)):
        # 设置SVG显示以获得更清晰的图像
        plt.rcParams['figure.figsize'] = figsize
        plt.rcParams['font.size'] = 12

        # 增量地绘制多条线
        if legend is None:
            legend = []

        # 创建图形和坐标轴
        self.fig, self.axes = plt.subplots(nrows, ncols, figsize=figsize)
        if nrows * ncols == 1:
            self.axes = [self.axes, ]

        # 配置坐标轴的函数
        self.config_axes = lambda: self._set_axes(
            self.axes[0], xlabel, ylabel, xlim, ylim, xscale, yscale, legend)

        # 初始化数据存储
        self.X, self.Y, self.fmts = None, None, fmts

    def _set_axes(self, axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend):
        """设置坐标轴"""
        axes.set_xlabel(xlabel)
        axes.set_ylabel(ylabel)
        axes.set_xscale(xscale)
        axes.set_yscale(yscale)
        axes.set_xlim(xlim)
        axes.set_ylim(ylim)
        if legend:
            axes.legend(legend)
        axes.grid()

    def add(self, x, y):
        # 向图表中添加多个数据点
        if not hasattr(y, "__len__"):
            y = [y]
        n = len(y)
        if not hasattr(x, "__len__"):
            x = [x] * n

        # 初始化数据存储
        if not self.X:
            self.X = [[] for _ in range(n)]
        if not self.Y:
            self.Y = [[] for _ in range(n)]

        # 添加数据点
        for i, (a, b) in enumerate(zip(x, y)):
            if a is not None and b is not None:
                self.X[i].append(a)
                self.Y[i].append(b)

        # 清空并重新绘制
        self.axes[0].cla()
        for x, y, fmt in zip(self.X, self.Y, self.fmts):
            self.axes[0].plot(x, y, fmt)

        # 配置坐标轴并显示
        self.config_axes()
        display.display(self.fig)
        display.clear_output(wait=True)

    def close(self):
        """关闭图形"""
        plt.close(self.fig)
上面这个不是深度学习的主线内容,我就不过多介绍了。
6.3训练过程
以下函数是一个完整的模型训练流程,它集成了训练、评估和可视化功能。
def train_ch3(net, train_iter, test_iter, loss, num_epochs, updater):
    animator = Animator(xlabel='epoch', xlim=[1, num_epochs], ylim=[0.3, 0.9],
                        legend=['train loss', 'train acc', 'test acc'])
    for epoch in range(num_epochs):
        train_metrics = train_epoch_ch3(net, train_iter, loss, updater)
        test_acc = evaluate_accuracy(net, test_iter)
        animator.add(epoch+1, train_metrics + (test_acc,))

    train_loss, train_acc = train_metrics

    # 确保 train_loss 是标量值
    if torch.is_tensor(train_loss):
        train_loss = train_loss.item()
    if torch.is_tensor(train_acc):
        train_acc = train_acc.item()
    if torch.is_tensor(test_acc):
        test_acc = test_acc.item()

    # 使用更友好的断言
    assert train_loss < 0.5, f"训练损失 {train_loss} 过高,期望小于 0.5"
    assert 0.7 < train_acc <= 1, f"训练准确率 {train_acc} 不在期望范围内 (0.7, 1]"
    assert 0.7 < test_acc <= 1, f"测试准确率 {test_acc} 不在期望范围内 (0.7, 1]"
animator = Animator(...)#初始化可视化工具
for epoch in range(num_epochs): #循环训练,线性回归中也有类似的代码
train_metrics = train_epoch_ch3(net, train_iter, loss, updater)#训练
test_acc = evaluate_accuracy(net, test_iter)#评估
animator.add(epoch + 1, train_metrics + (test_acc,))#更新可视化
train_loss < 0.5:训练损失应该小于0.5(对于分类问题,这通常是合理的)
train_acc > 0.7:训练准确率应该大于70%
test_acc > 0.7:测试准确率应该大于70%
如果这些条件不满足,会抛出异常并显示实际值
6.4小批量随机梯度下降来优化模型的损失函数
lr = 0.1
#小批量随机梯度下降来优化模型的损失函数,将学习率设置为0.1
def updater(batch_size):
    with torch.no_grad():  # 不跟踪梯度计算
        for param in [W, b]:
            # SGD更新公式: param = param - lr * gradient / batch_size
            param -= lr * param.grad / batch_size
            # 清空梯度,为下一次计算做准备
            param.grad.zero_()
6.5训练
以上所有的一切,都是为了现在。
#训练
num_epochs = 10
train_ch3(net, train_iter, test_iter, cross_entropy, num_epochs, updater)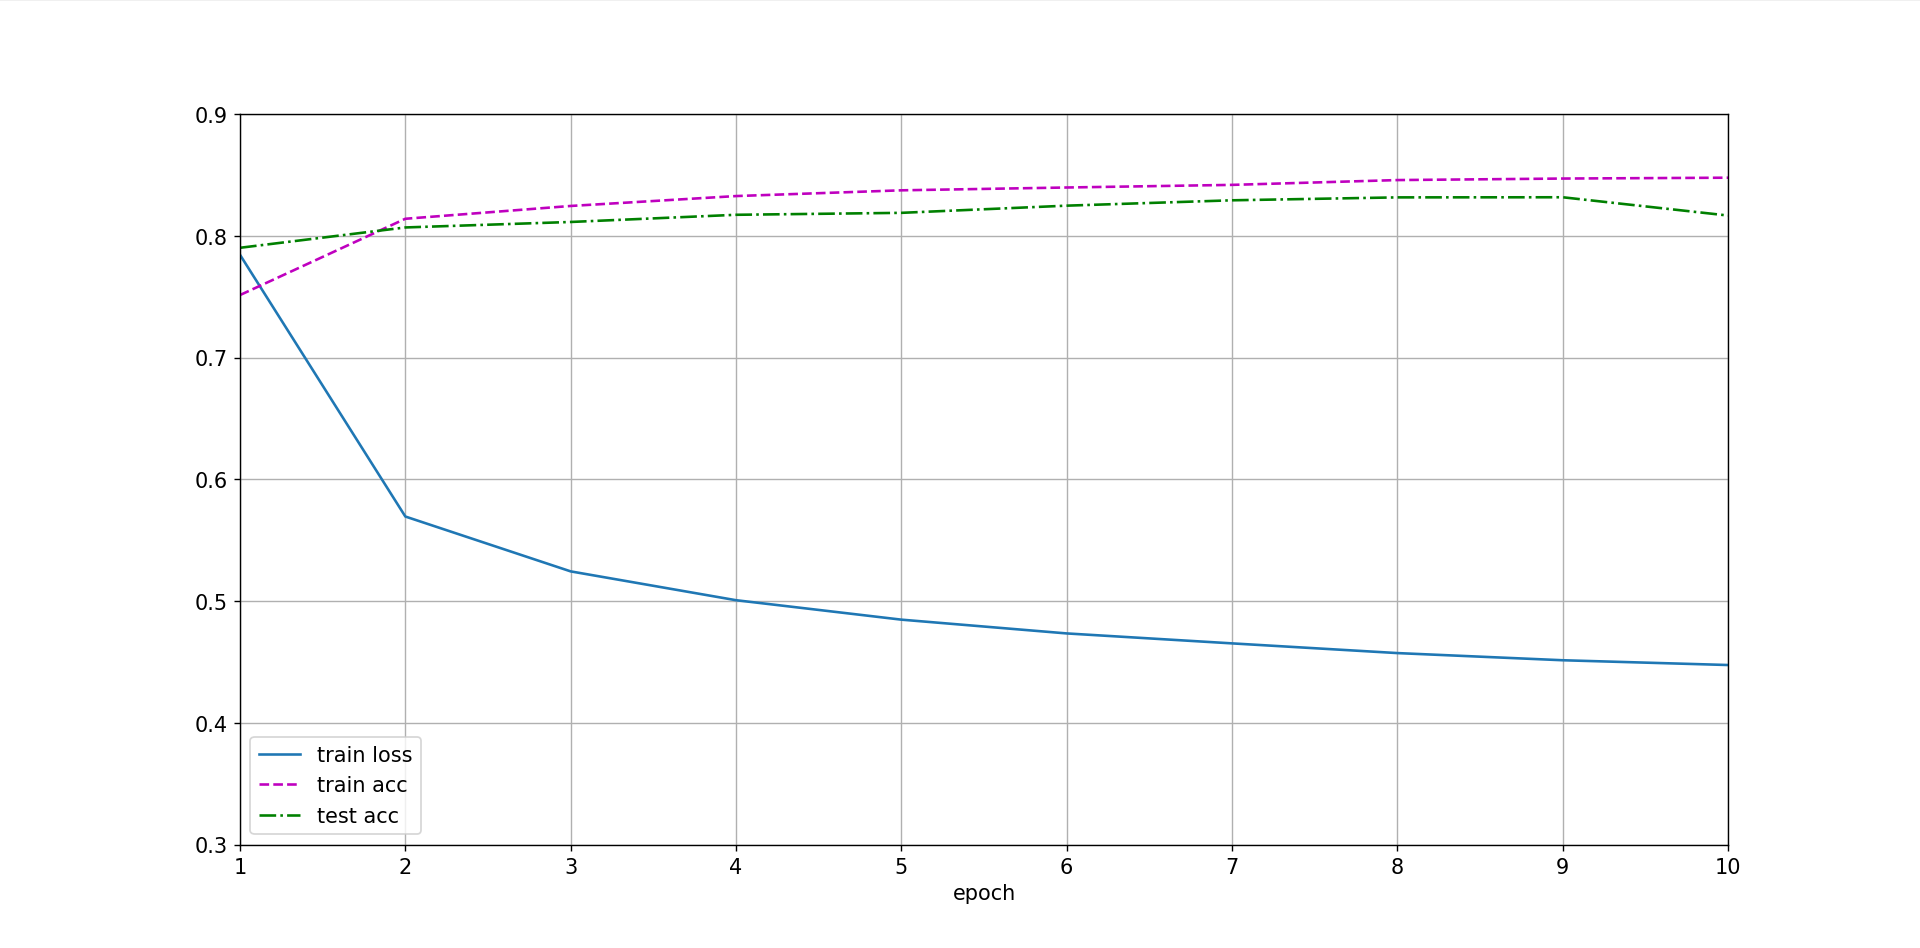
6.6预测
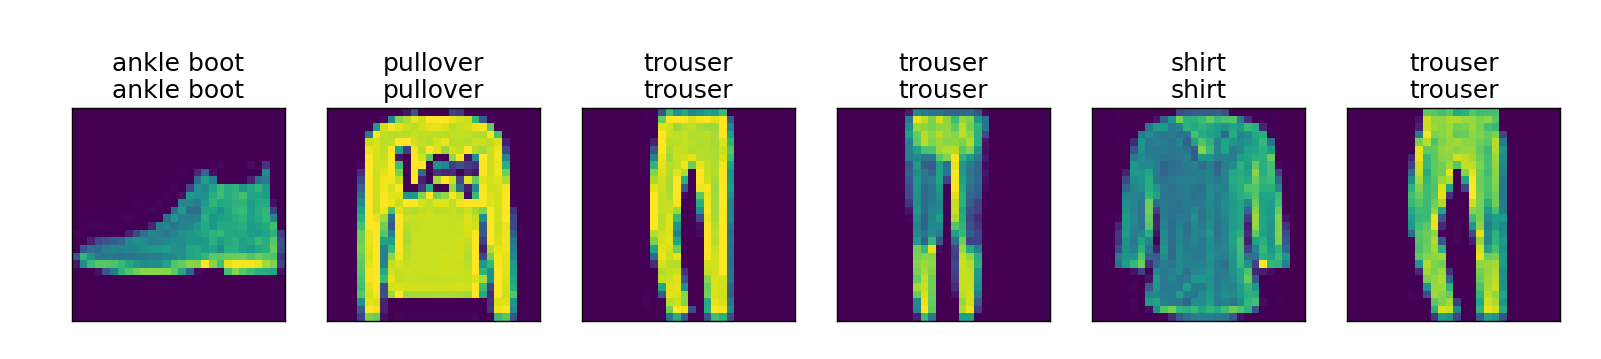
训练完成后,如果终止代码,模型参数(W和 b)会丢失,因为它们是存储在内存中的。为了避免白训练,所以直接在代码训练之后预测。
下面get_fashion_minist_labels和show_images方法,都在3.5章实现过。
预测的核心功能在predict_ch3中。
def get_fashion_mnist_labels(labels):
    """将数字标签转换为对应的文本标签"""
    text_labels = ['t-shirt', 'trouser', 'pullover', 'dress', 'coat',
                   'sandal', 'shirt', 'sneaker', 'bag', 'ankle boot']
    return [text_labels[int(i)] for i in labels]


def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5):
    """绘制图像列表"""
    figsize = (num_cols * scale, num_rows * scale)
    _, axes = plt.subplots(num_rows, num_cols, figsize=figsize)
    axes = axes.flatten()
    for i, (ax, img) in enumerate(zip(axes, imgs)):
        if torch.is_tensor(img):
            # 张量图像
            ax.imshow(img.numpy())
        else:
            # PIL图像
            ax.imshow(img)
        ax.axes.get_xaxis().set_visible(False)
        ax.axes.get_yaxis().set_visible(False)
        if titles:
            ax.set_title(titles[i])
    plt.show()
    return axes


def predict_ch3(net, test_iter, n=6):
    """预测标签(不使用d2l包)"""
    # 从测试数据迭代器中获取第一批数据
    for X, y in test_iter:
        break

    # 获取真实标签和预测标签
    trues = get_fashion_mnist_labels(y)
    preds = get_fashion_mnist_labels(net(X).argmax(axis=1))

    # 创建标题,格式为"真实标签\n预测标签"
    titles = [true + '\n' + pred for true, pred in zip(trues, preds)]

    # 显示前n个图像
    # 注意:X的形状可能是[batch_size, 1, 28, 28],需要调整为[batch_size, 28, 28]用于显示
    if X.dim() == 4 and X.shape[1] == 1:
        # 如果有单通道维度,移除它
        images = X.squeeze(1)  # 从[batch_size, 1, 28, 28]变为[batch_size, 28, 28]
    else:
        # 如果已经是展平的,需要重塑为图像
        images = X.reshape(-1, 28, 28)

    # 显示图像
    show_images(images[0:n], 1, n, titles=titles[0:n])


# 使用示例
predict_ch3(net, test_iter)
预测结果

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 43
 0
- 0


 已为社区贡献20条内容

所有评论(0)