深度学习入门:神经网络层数选择指南
一、理论基础:层数与模型性能的关联
1.1 层数的本质:特征提取的层级性
神经网络的隐藏层负责特征提取,层数越多,特征提取的层级越深入:
-
浅层网络(1-3层隐藏层):仅能提取低级特征(如像素、单个特征值),适用于线性可分或简单非线性任务;
-
深层网络(8层以上):可逐层将低级特征组合为抽象特征(如语义、物体结构),但需依赖海量数据和强算力支撑。
1.2 层数对训练的影响
层数增加会带来两个核心问题:
-
梯度消失/爆炸:深层网络反向传播时,梯度经过多层乘法易趋近于0或无穷大,导致训练停滞;
-
过拟合风险:模型复杂度超过数据承载能力,过度拟合训练集噪声,泛化性能下降。
二、分场景层数选择指南(附实操建议)
结合任务类型、数据量及模型结构,给出针对性层数建议,配套代码框架供参考。
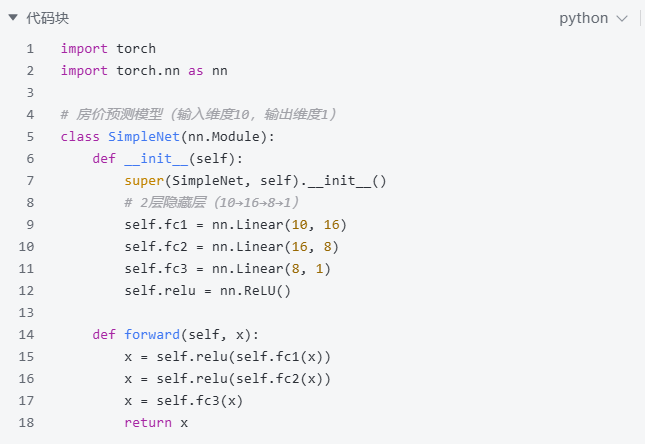
2.1 结构化数据任务(如回归、传统分类)
数据特点:特征为结构化表格(如房价预测的面积、地段,信贷评分的收入、征信),特征维度低(通常几十到几百维)。
✅ 层数建议:隐藏层1-3层,总层数3-5层;神经元数按“输入维度→0.5-2倍输入维度→输出维度”设计。
📌 代码示例(PyTorch):
2.2 非结构化数据入门任务(简单图像/短文本)
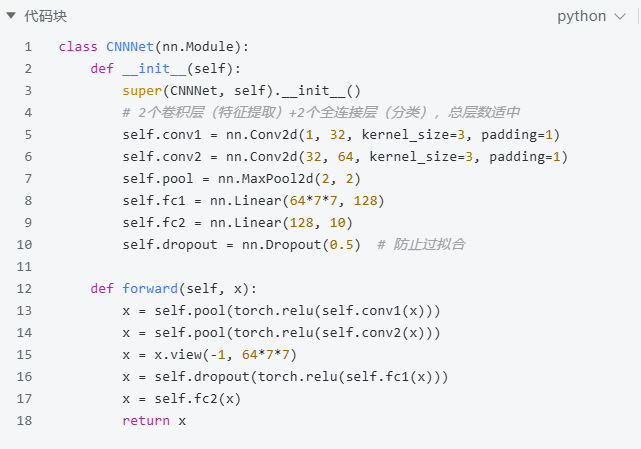
数据特点:图像(28×28手写数字、小尺寸猫狗图)、短文本(句子级情感分析),数据量1万-10万条。
✅ 层数建议:
-
全连接网络:3-5层隐藏层;
-
CNN网络:2-4个卷积层+1-2个全连接层(卷积层自带特征提取能力,无需过多全连接层)。
📌 代码示例(PyTorch CNN,MNIST手写数字识别):
2.3 复杂非结构化数据任务(高清图像/长文本)
数据特点:高清图像(256×256及以上)、长文本(篇章级语义理解)、医学影像,数据量10万条以上。
✅ 层数建议:基于预训练模型微调,自定义层数2-5层(无需从零搭建深层网络)。
示例:用ResNet18(18层)微调图像分类任务,仅修改输出层及少量全连接层。
三、超参数调优:层数与其他参数的协同调整
3.1 层数与神经元数的平衡
核心原则:模型总参数数量控制在合理范围(避免过拟合),公式参考:
总参数数 ≈ Σ(每层输入维度×每层输出维度 + 偏置项)
建议:层数增加时,适当减少每层神经元数;反之则增加神经元数。
3.2 层数与正则化的配合
当层数较多(≥8层)时,需搭配正则化策略抑制过拟合:
-
Dropout:隐藏层加入dropout层(概率0.3-0.5);
-
L2正则化:优化器中加入weight_decay(1e-4-1e-2);
-
早停(Early Stopping):监测验证集准确率,停止过早过拟合。
四、常见问题及解决方案
|
问题现象 |
可能原因(层数相关) |
解决方案 |
|---|---|---|
|
训练准确率低,验证准确率低(欠拟合) |
层数过少,模型能力不足 |
增加1-2层隐藏层,或增加神经元数,补充数据 |
|
训练准确率高,验证准确率低(过拟合) |
层数过多,模型复杂度超标 |
减少层数,加入dropout/正则化,数据增强 |
|
训练时梯度为0(梯度消失) |
层数过多,激活函数选择不当 |
减少层数,改用ReLU/LeakyReLU激活函数,使用残差连接 |
五、总结与实操建议
1. 新手优先级:先适配任务场景选择基础层数,再通过迭代调优优化,复杂任务优先用预训练模型;
2. 核心逻辑:层数选择=任务复杂度+数据量+算力支撑,三者平衡是关键;
3. 避坑核心:不盲目追求深层,优先保证模型泛化性能,再提升拟合能力。
后续将分享神经元数、学习率的调优技巧,关注我,持续更新深度学习入门实操内容~
📚 参考资料:《深度学习》(Goodfellow)、PyTorch官方文档、工业界超参数调优经验总结。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 33
 0
- 0


 已为社区贡献1条内容

所有评论(0)