小杰机器学习(four)——线性回归方程、损失函数、迭代次数、过拟合、早停法、三维动态。
1.线性回归
定义:
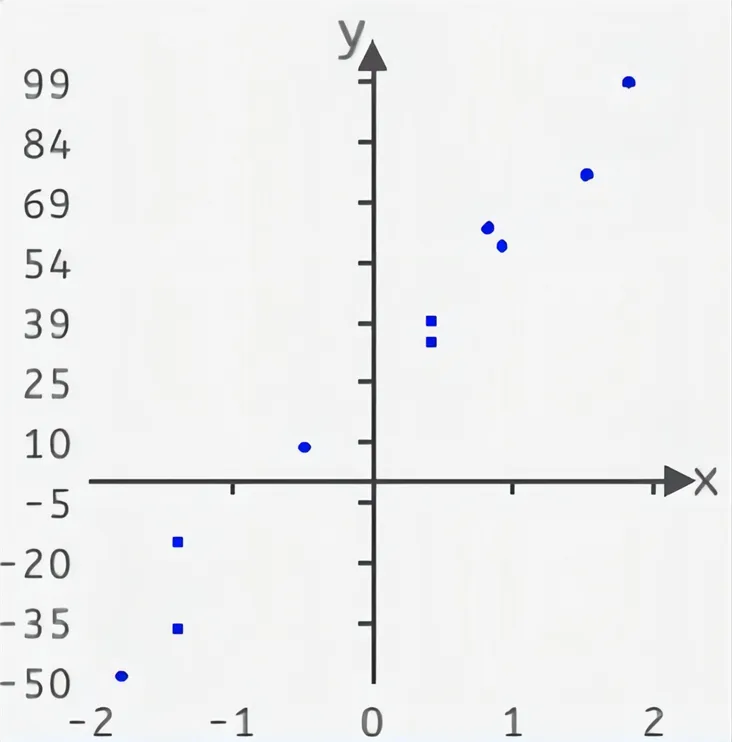
线性回归是一种用于建立自变量与因变量之间关系的统计方法。
它假设因变量(或响应变量)与一个或多个自变量(或预测变量)之间的关系是线性的。
其主要目标是通过拟合一个线性模型来预测因变量的数值。
2. 线性回归方程
线性回归模型可以表示为:
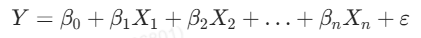
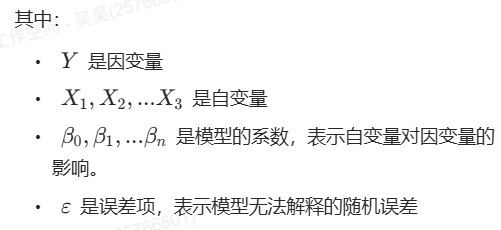
目标:线性回归的目标是找到最佳的系数来使模型与观察到的数据尽可能拟合。
线性回归的应用
- 预测:给定自变量的值,预测因变量的值。
- 回归分析:确定自变量对因变量的影响程度。
总结
线性回归是统计学和机器学习中最简单且最常用的技术之一,它提供了一个基本框架来理解和分析变量之间的的关系,并用于许多实际应用中,如经济学、金融学、医学、社会科学等领域。
3. 相关概念
- 参数
模型中可调整的变量,它们用来捕捉数据中的模式和特征。这些参数在模型训练过程中被不断调整以最小化损失函数或优化某种目标。例如之前的w和b参数。
- 权重(Weights)
用来表示不同输入特征与神经元之间的连接强度。
- 偏置(Biases)
用于调整每个神经元的激活阈值,使模型能够更好地拟合数据。
- 超参数
不是通过训练数据学习得到的,而是在训练过程之前需要手动设置的参数。包括学习率、正则化参数、迭代次数、批量大小、神经网络层数和每层的神经元数量与激活函数等。例如之前的K
学习率(Learning Rate):
用于控制优化算法中每次更新参数时的步长。较小的学习率会导致训练收敛较慢,而较大的学习率可能导致训练不稳定或震荡。
正则化参数(Regularization Parameter):
用于控制正则化的强度,如L1正则化和L2正则化。较大的正则化参数会增强正则化效果,有助于防止过拟合。
迭代次数(Number of Iterations):
用于控制训练的迭代次数。迭代次数太小可能导致模型未完全学习数据的特征,而迭代次数太大可能导致过拟合。
批量大小(Batch Size):
用于控制每次训练时用于更新参数的样本数量。批量大小的选择会影响训练速度和内存消耗。
神经网络层数和每层的神经元数量(Number of Layers and Neurons per Layer):
用于定义神经网络的结构。
激活函数(Activation Function):
用于控制神经网络每个神经元的输出范围,如Sigmoid、ReLU等。
4.数学方法实现线性回归过程
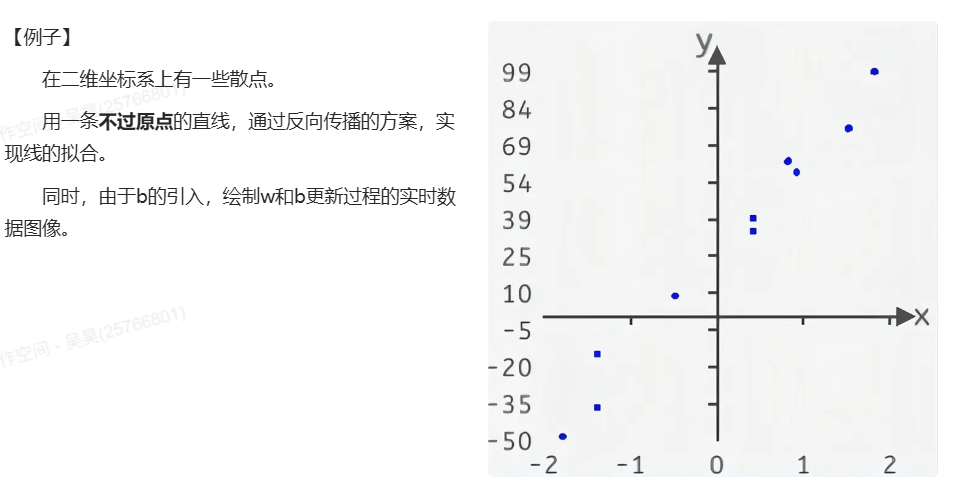
(1)散点输入
(2)参数初始化
在前向传播实验中,知道了参数不同时对应的损失函数值也不同,所以需要先初始化一下参数和超参数,进行一次前向传播,得到损失值,这样才能通过反向传播减小损失,使直线的拟合效果更好。这里通过“参数初始化”组件来初始化w和b以及学习率这三个参数/超参数。
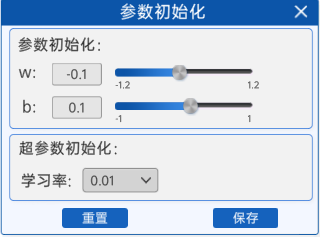
无论初始化的参数wb是什么,理论上都可以得到理想的结果。
(3)损失函数
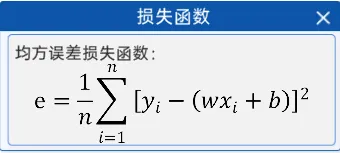
与前向传播实验和反向传播实验不同,此时b的值不再是0,也就意味着损失函数不仅仅受到w的影响,还会受到b的影响,将 y=wx+b 带入损失函数的表达式后,新的损失函数就变成了如下图所示的表达式:
(4)开始迭代
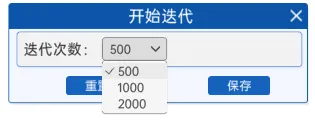
迭代次数通常指的是反向传播的次数,即通过反向传播来更新模型的参数,直到达到一定的迭代次数或者达到收敛的条件为止。
迭代的次数越多,模型参数就越接近最优解,从而使得损失函数达到最小值,但是可能会造成过拟合(过拟合在之后的实验会讲到)。
一般来说,迭代次数需要根据具体情况来确定,通常需要进行多次迭代来更新模型参数,直到达到收敛的条件为止,在“开始迭代”组件中默认的是500次。
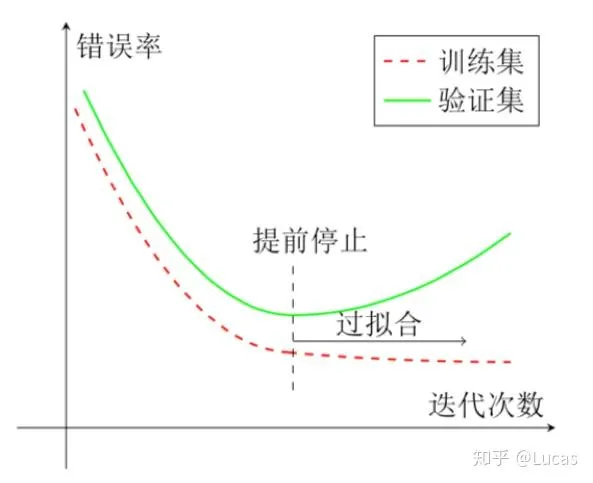
需要注意的是,机器学习的准确率满足需求后,继续迭代可能会出现过拟合情况,此时应该使用早停法。
过拟合(Overfitting)是机器学习中一个常见的问题,指的是模型在训练数据上表现得非常好,但是在新的、未见过的数据上表现不佳的现象。换句话说,模型学习到了训练数据中的噪声(没有完美的数据)和细节,而不仅仅是底层的数据分布。
早停法(Early Stopping,即提前停止):在验证集上的性能不再提升时停止训练。属于比较简单粗暴的过拟合解决方法。
(5) 反向传播
反向传播可以自动求导。当参数和损失函数都设置好之后,就开始反向传播了,也就是损失函数对w和b进行求导并且不断更新w和b的过程,是一个复合函数求导的过程。损失函数对w和b的求导过程如下:
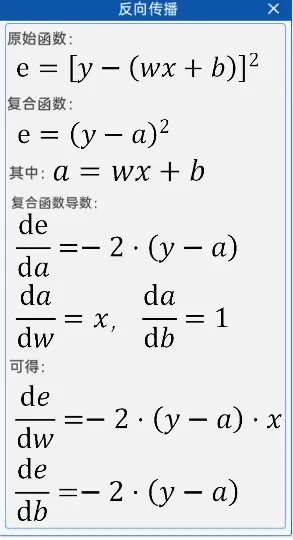 需注意,左图中的最终结果单点误差(损失函数),实际计算要考虑到所有的店的均方误差:
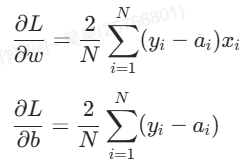
(6)显示频率设置
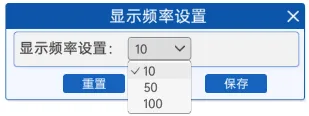
求导完成之后,使用梯度下降的方法来更新w和b的值。为了更好的在实验中看现象,这里有一个“显示频率设置”组件,就是每经过多少次迭代,绘制一次当前参数的拟合线及损失函数的大小。
(7)梯度下降显示
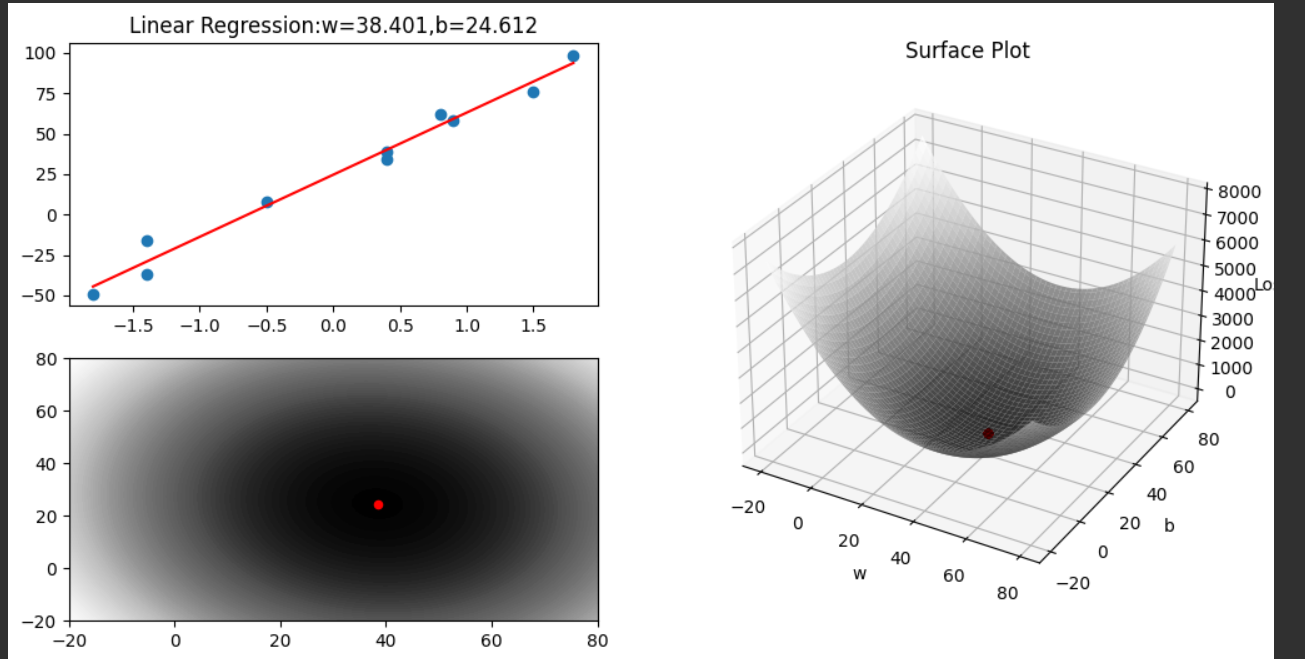
迭代的结果通过“梯度下降显示”组件进行查看。如下图所示,38.4是w 的实时值,24.58是b的实时值,42.68是最后的损失值。
除此之外,该组件还有三个图,左边的是实时的直线图,参数每更新一次,该直线就更新一次,右边的是损失值的图像,显示的是经过迭代后的损失值的大小,下方的图是W和B随着不断的更新而变化的等高线图
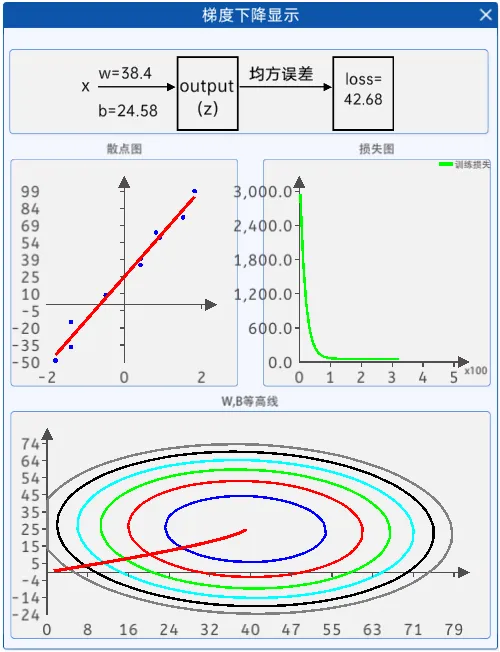
实际上第三个等高线图的横轴是w,纵轴是b,内层的圈可以看做是凹陷,因为如果加入第三维损失函数的值,越内层的圈表示损失函数的值越小。实际上这个逼近谷底的过程就是梯度下降的过程。
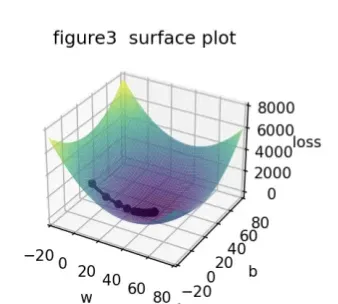
代码
# 导入相关库
import matplotlib.pyplot as plt
# IPython是一个交互式Python环境,配合Jupyter可以提供动态显示功能。
from IPython import display
import numpy as np
import matplotlib.gridspec as gridspec # 网格布局
[14]
# 1、散点输入
data = [[-0.5, 7.7], [1.8, 98.5], [0.9, 57.8], [0.4, 39.2], [-1.4, -15.7], [-1.4, -37.3], [-1.8, -49.1], [1.5, 75.6],
        [0.4, 34.0], [0.8, 62.3]]
# 转换为np数组
data = np.array(data)
data
# 提取每个点的x_data和y_data
x_data = data[:,0]
y_data = data[:,1]
print(x_data)
print(y_data)
[-0.5  1.8  0.9  0.4 -1.4 -1.4 -1.8  1.5  0.4  0.8]
[  7.7  98.5  57.8  39.2 -15.7 -37.3 -49.1  75.6  34.   62.3]

[15]
# 2. 参数初始化
w = 1.0
b = 0
learning_rate = 0.01

[16]
# 3. 损失函数
def loss_function(X, Y, w, b):
    """
    计算损失函数的值
    """
    y_predicted = np.dot(X, w) + b # dot可以支持多维乘法,虽然现在用不到,但是这种写法更标准
    loss = np.mean((y_predicted - Y) ** 2)
    return loss
[17]
# 开始采样构建网格,目标是绘制左下角子图,顺带着使用穷举法找到比较理想的w和b
# 使用等差数列构建网格
w_values = np.linspace(-20, 80, 100)
b_values = np.linspace(-20, 80, 100)
b_values
array([-20.        , -18.98989899, -17.97979798, -16.96969697,
       -15.95959596, -14.94949495, -13.93939394, -12.92929293,
       -11.91919192, -10.90909091,  -9.8989899 ,  -8.88888889,
        -7.87878788,  -6.86868687,  -5.85858586,  -4.84848485,
        -3.83838384,  -2.82828283,  -1.81818182,  -0.80808081,
         0.2020202 ,   1.21212121,   2.22222222,   3.23232323,
         4.24242424,   5.25252525,   6.26262626,   7.27272727,
         8.28282828,   9.29292929,  10.3030303 ,  11.31313131,
        12.32323232,  13.33333333,  14.34343434,  15.35353535,
        16.36363636,  17.37373737,  18.38383838,  19.39393939,
        20.4040404 ,  21.41414141,  22.42424242,  23.43434343,
        24.44444444,  25.45454545,  26.46464646,  27.47474747,
        28.48484848,  29.49494949,  30.50505051,  31.51515152,
        32.52525253,  33.53535354,  34.54545455,  35.55555556,
        36.56565657,  37.57575758,  38.58585859,  39.5959596 ,
        40.60606061,  41.61616162,  42.62626263,  43.63636364,
        44.64646465,  45.65656566,  46.66666667,  47.67676768,
        48.68686869,  49.6969697 ,  50.70707071,  51.71717172,
        52.72727273,  53.73737374,  54.74747475,  55.75757576,
        56.76767677,  57.77777778,  58.78787879,  59.7979798 ,
        60.80808081,  61.81818182,  62.82828283,  63.83838384,
        64.84848485,  65.85858586,  66.86868687,  67.87878788,
        68.88888889,  69.8989899 ,  70.90909091,  71.91919192,
        72.92929293,  73.93939394,  74.94949495,  75.95959596,
        76.96969697,  77.97979798,  78.98989899,  80.        ])
[18]
W,B = np.meshgrid(w_values, b_values) # 构建100*100网格分别存储横轴和竖轴数据
print(W.shape)
W
(100, 100)

array([[-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ],
       [-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ],
       [-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ],
       ...,
       [-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ],
       [-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ],
       [-20.        , -18.98989899, -17.97979798, ...,  77.97979798,
         78.98989899,  80.        ]])
[19]
# 创建一个100*100的数组存储对应点的损失函数值
loss_values = np.zeros_like(W)
print(loss_values.shape)
loss_values
(100, 100)

array([[0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       ...,
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.]])
[20]
# 遍历10000个网格,计算每个网格的损失函数值
for i, w in enumerate(w_values):
    for j, b in enumerate(b_values):
        # 第j行第i列的损失函数
        loss_values[j, i] = loss_function(x_data, y_data, w, b)
loss_values
array([[7401.106     , 7223.21490725, 7048.31738659, ..., 4083.74162902,
        4196.22702847, 4311.706     ],
       [7303.74246567, 7125.99421549, 6951.23953739, ..., 4000.23382369,
        4112.86206571, 4228.48387981],
       [7208.41953943, 7030.81413182, 6856.2022963 , ..., 3918.76662647,
        4031.53771105, 4147.30236772],
       ...,
       [7457.91448893, 7293.87912519, 7132.83733354, ..., 5484.55583165,
        5610.89696011, 5740.23166065],
       [7558.48994041, 7394.59741924, 7233.69847016, ..., 5598.98701214,
        5725.47098316, 5854.94852627],
       [7661.106     , 7497.3563214 , 7336.60021488, ..., 5715.45880073,
        5842.08561433, 5971.706     ]])
[21]
min_loss_value = np.min(loss_values)
min_loss_value # 这是穷举法暴力计算出的比较理想的损失函数值,但是当模型更复杂时这样的效率太低
42.75126068768492
[22]
print(w, b)
# 重置wb
w = 0
b = 0
80.0 80.0

# 4. 开始迭代
# 创建图形对象和子图布局
fig = plt.figure(figsize=(12, 6)) # 12x6的窗口
gs = gridspec.GridSpec(2, 2) # 2x2网格布局

# 左上格子
ax1 = fig.add_subplot(gs[0, 0]) # 子图1在网格的第一行第一列
ax1.set_xlabel('X')
ax1.set_ylabel('Y')
ax1.set_title("Linear Regression")

# 左下格子
ax2 = fig.add_subplot(gs[1, 0]) # 子图2在网格的第2行第一列
ax2.set_xlabel('w')
ax2.set_ylabel('b')
ax2.set_title("Contour Plot")

# 右侧大格子
ax3 = fig.add_subplot(
    gs[:, 1], # 子图3在网格的第2列
    projection='3d' # 三维显示
)
# 设定三维数据
ax3.plot_surface(
    W, # 第一维数据
    B, # 第二维数据
    loss_values, # 第三维数据:损失函数值
    cmap='Greys_r', # 黑白配色
    alpha=0.8 # 不透明度
)
ax3.set_xlabel('w')
ax3.set_ylabel('b')
ax3.set_zlabel('Loss')
ax3.set_title("Surface Plot")

# 迭代次数
num_iterations = 600
# 记录梯度
gd_path = []
# 样本点数量,后续求平均值用
l_x_data = x_data.size

# 开始迭代
for n in range(1, num_iterations + 1):
    # 记录新计算的梯度
    gd_path.append((w, b)) # 记录梯度对应的wb值
    # 5. 反向传播
    a = w * x_data + b # a即y的预测值
    # 求偏导
    gradient_w = -2 * (y_data - a).dot(x_data) / l_x_data
    gradient_b = -2 * (y_data - a).sum() / l_x_data
    # 更新参数:GD
    # w新 = w旧 - 学习率 * 斜率
    w = w - learning_rate * gradient_w
    b = b - learning_rate * gradient_b
    # 损失函数
    # print(loss_function(x_data, y_data, w, b))

    # 6. 显示频率设置
    frequency_display = 10
    # 整数倍次和第一次刷新显示
    if n % frequency_display == 0 or n == 1:
        # 清空之前显示
        display.clear_output(wait=True)

        # 7. 梯度下降显示
        # 更新子图1并绘制
        ax1.clear()
        ax1.scatter(x_data , y_data) # 画散点
        # 取出直线的端点的x坐标
        x_min, x_max = x_data.min(), x_data.max()
        # 计算对应的y值
        y_min = w * x_min + b
        y_max = w * x_max + b
        # 绘制直线
        ax1.plot(
            [x_min, x_max],
            [y_min, y_max],
            '-',
            color='r'
        )
        # 更新标题
        ax1.set_title(f'Linear Regression:w={round(w,3)},b={round(b,3)}')

        # 开始绘制子图2
        ax2.clear()
        # 等高线
        ax2.contourf(
            W, # 横轴数据
            B, # 竖轴数据
            loss_values, # 海拔高度
            levels=100, # 等高线数量
            cmap='Greys_r' # 配色
        )
        # 红点:当前的w和b
        ax2.scatter(
            w,
            b,
            color='r',
            s=20
        )

        # 绘制子图3的红点
        ax3.scatter(
            w,
            b,
            loss_function(x_data, y_data, w, b), # Z轴
            color='r',
            s=20
        )

        # 绘制子图2和子图3的梯度下降路径
        # 取出已经算过的w和b值
        gd_w, gd_b = zip(*gd_path)
        # print(*gd_path)
        # print(gd_w)
        # 给子图2和子图3绘制下降路径
        ax2.plot(gd_w, gd_b)

        ax3.plot(gd_w,
                 gd_b,
                 [loss_function(x_data, y_data, np.array(gd_w[i]), np.array(gd_b[i])) for i in range(len(gd_w))],
                c='b')

        # 显示图形
        display.display(plt.gcf())
        # 清空Jupter输出
        display.clear_output(wait=True)

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 32
 0
- 0


 已为社区贡献30条内容

所有评论(0)