小白学大模型:FlashAttention--大模型处理长序列的高效利器,解决计算瓶颈必备技术!!
简介
FlashAttention通过I/O感知、Tiling和Recomputation技术,将注意力机制的内存占用从平方关系降低为线性关系。FlashAttention-2优化了工作划分和并行化,FlashAttention-3进一步利用现代硬件特性和低精度计算,实现比标准实现快10倍以上的性能提升,同时保持数值稳定性,使大模型能够高效处理超长文本。
在 Transformer 架构中,注意力机制的计算复杂度与序列长度(即文本长度)呈平方关系 ()。这意味着,当模型需要处理更长的文本时(比如从几千个词到几万个词),计算时间和所需的内存会急剧增加。最开始的标准注意力机制存在两个主要问题:
- 内存占用高:模型需要生成一个巨大的注意力矩阵 (N×N)。这个矩阵需要被保存在高带宽内存 (HBM) 中。对于长序列,这很快就会超出 GPU 的内存容量。
- 计算效率低:标准实现会将注意力计算分解成多个独立的步骤(矩阵乘法、softmax 等)。每一步都需要将数据从速度较慢的 HBM 中读取,计算后又写回 HBM。这种频繁的数据移动(内存读写)成为了性能瓶颈,导致 GPU 的计算单元(如 Tensor Cores)利用率低下。
什么是 FlashAttention?
FlashAttention 使得处理长达数万甚至数十万个 token 的超长文本成为可能。这解锁了新的应用场景,例如分析法律文档、总结长篇小说或处理整个代码库。
FlashAttention 使得模型的训练和推理速度更快,尤其是在长序列场景下。例如,FlashAttention-2 在长序列上比标准实现快 10 倍,使得训练成本更低,用户体验更好。
最新的 FlashAttention-3 利用了新硬件(如 NVIDIA H100)的 FP8 精度,进一步提升了性能,同时通过特殊的算法保持了计算的准确性,让模型训练更加高效。
FlashAttention v1
FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
https://arxiv.org/abs/2205.14135
许多研究提出了近似注意力方法,试图通过减少计算量(FLOPs)来提高效率。然而,这些方法通常忽略了GPU不同层级内存(如高速的片上SRAM和相对较慢的高带宽HBM)之间的I/O开销,导致它们在实际运行时并没有带来显著的加速。

FlashAttention的核心思想是I/O感知,即在设计算法时,将数据在不同层级内存之间的读写开销考虑在内。论文指出,在现代GPU上,计算速度已经远超内存访问速度,因此大多数操作都受限于内存访问。FlashAttention通过以下两个关键技术来解决这一问题:
- Tiling (平铺) :将输入数据(Q、K、V矩阵)分割成小块,并在GPU的片上SRAM中进行计算。这样可以避免将庞大的 N×N 注意力矩阵完整地写入到速度较慢的HBM中。
- 内存优化:在反向传播时,FlashAttention 不存储巨大的中间注意力矩阵,而是只保存前向传播中计算出的Softmax归一化因子。这样,反向传播时可以利用这些因子在SRAM中快速地重新计算注意力矩阵,从而避免了从HBM读取大矩阵的开销。
GPU内存层级
- HBM (高带宽内存) :容量大(如A100 GPU的40-80 GB),但速度相对较慢(带宽1.5-2.0 TB/s)。
- 片上SRAM (静态随机存取存储器):容量小(每个流式多处理器有192 KB),但速度极快(带宽估计达19 TB/s),比HBM快一个数量级以上。
由于GPU的计算速度增长快于内存速度,许多操作的性能瓶颈在于内存访问,而不是计算本身。因此,如何高效利用快速的SRAM变得至关重要。
运算类型
根据算术强度(每字节内存访问的算术运算次数),操作可分为两类:
- 计算密集型 (Compute-bound) :运算时间由算术操作数量决定,内存访问时间相对较小。例如,大规模矩阵乘法。
- 内存密集型 (Memory-bound) :运算时间由内存访问次数决定,计算时间相对较小。例如,大多数元素级操作(如激活函数、Dropout)和归约操作(如Softmax、LayerNorm)。
注意力实现改进

给定查询 Q、键 K 和值 V 矩阵,注意力的计算分三步:
- 相似度计算:
- Softmax归一化:
- 加权求和:
标准实现(如“Algorithm 0”所示)将每一步都作为一个独立的GPU核函数,并物化(materialize)中间矩阵 S 和 P 到HBM中。
这种实现方式导致了两个主要问题:
- 巨大的内存占用:中间矩阵 S 和 P 的大小为 N×N,其内存占用与序列长度 N 的平方成正比。
- 大量的HBM访问:由于每个步骤都需要读写HBM,导致I/O开销巨大。论文指出,这种方法对HBM的访问次数是 O(N2) 级别的,这在长序列(通常 N≫d)时会成为主要的性能瓶颈,导致运行时间慢。

FlashAttention旨在减少对GPU高带宽内存(HBM)的读写,实现对确切注意力(exact attention)的快速、内存高效的计算。为此,它采用了两种关键技术:
- Tiling(分块):将输入的 Q,K,V 矩阵分成若干小块。然后,在计算过程中,每次只将一小块数据从慢速的HBM加载到快速的片上SRAM进行计算,而不是一次性加载整个大矩阵。
- Recomputation(重计算):为了避免在反向传播时存储 O(N2) 的中间注意力矩阵 S 和 P,FlashAttention只存储 Softmax 的归一化统计量(即 m 和 ℓ)。在反向传播时,它会利用这些统计量,按需在SRAM中重新计算必要的注意力矩阵块。
通过Tiling和Recomputation,FlashAttention能够将所有计算步骤(矩阵乘法、Softmax、可选的遮蔽和Dropout)融合成一个单一的CUDA核函数。这避免了在每个步骤之间反复地将数据写入HBM。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇

实现效果
lashAttention在BERT-large模型上的训练速度超过了MLPerf 1.1的记录保持者。与Nvidia的实现相比,FlashAttention的训练时间缩短了15% ,这证明了其在标准长序列任务上的卓越性能。

FlashAttention在训练GPT-2模型时,相比于流行的HuggingFace和Megatron-LM实现,实现了显著的端到端加速。

- 与Huggingface相比,速度提升高达3倍。
- 与Megatron-LM相比,速度提升高达1.7倍。
- 重要的是,FlashAttention在不改变模型定义的情况下,实现了与基线模型相同的困惑度(perplexity),证明了其数值稳定性。
在Long-Range Arena基准测试中,FlashAttention相比于标准的Transformer实现,实现了2.4倍的加速。此外,块稀疏FlashAttention的表现甚至优于所有已测试的近似注意力方法,证明了其在处理超长序列时的优越性。
lashAttention的内存占用与序列长度呈线性关系,而标准实现是平方关系。这使得FlashAttention的内存效率比标准方法高出20倍。
FlashAttention v2
FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
https://arxiv.org/abs/2307.08691
第一代 FlashAttention 通过利用 GPU 内存层次结构的特性,显著降低了内存占用(从二次方降为线性)并实现了 2-4 倍的加速,且没有引入任何近似。
然而,FlashAttention 的效率仍然不如优化的矩阵乘法(GEMM)操作,其浮点运算性能(FLOPs/s)仅能达到理论峰值的 25-40%。这主要是因为 FlashAttention 存在不优化的工作划分(work partitioning),导致 GPU 线程块(thread blocks)和线程束(warps)之间的并行度不足、占用率低或产生不必要的共享内存读写。
为了解决这些问题,论文提出了 FlashAttention-2,通过以下改进实现了更好的工作划分:
- 减少非矩阵乘法(non-matmul)的浮点运算:虽然这类操作占总 FLOPs 的比例小,但执行起来很慢。
- 在序列长度维度上并行化:即使对于单个注意力头,也将其计算任务分配给不同的线程块,以提高 GPU 的占用率。
- 优化线程块内部的工作分配:在每个线程块内,重新分配线程束之间的工作,以减少通过共享内存进行的通信。
前向传播改进
FlashAttention-2对在线 Softmax 技巧进行了两处微调:

- 延迟归一化:在每个循环迭代中,不立即对输出进行归一化。相反,它维护一个**“未缩放”的中间结果,并在整个循环结束时**仅进行一次最终的归一化。这减少了每个块的缩放操作,从而减少了非 matmul 的 FLOPs。
- 简化统计量:为反向传播存储数据时,只保存logsumexp统计量 L(j)=m(j)+log(ℓ(j)),而不是同时存储最大值 m(j) 和指数和 ℓ(j)。
并行化改进
第一代 FlashAttention 仅在批处理大小和注意力头数量上进行并行化。当序列长度很长时,批处理大小通常很小,导致 GPU 资源的利用率(occupancy)不高。FlashAttention-2 通过在序列长度维度上增加并行化来解决这个问题。

- 前向传播:FlashAttention-2 将注意力矩阵的行块任务分配给不同的线程块,这些线程块之间无需通信。通过在行维度上并行,当批次大小和注意力头数较小时,GPU 的 SM(流式多处理器)能够被更充分地利用,从而提高整体吞吐量。
- 后向传播:类似地,后向传播则在注意力矩阵的列块上进行并行。由于反向传播中的某些更新需要跨线程块通信,作者使用了原子加法(atomic adds)来更新共享的梯度 dK 和 dV,确保了线程安全。

除了线程块级别的并行,FlashAttention-2 还优化了线程块内部线程束之间的工作分配,以减少共享内存的读写。
- 前向传播:
- FlashAttention:采用“split-K”方案,将 K 和 V 矩阵的计算任务分配给不同的线程束。这要求所有线程束将中间结果写入共享内存,再进行同步和求和,导致不必要的共享内存访问。
- FlashAttention-2:改为将 Q 矩阵的计算任务分配给不同的线程束。每个线程束负责计算 Q 的一个分片与完整的 K 的乘积。这样,每个线程束可以独立地完成其部分输出,而无需与其他线程束进行共享内存通信,从而显著提高了效率。
- 后向传播:后向传播的依赖关系更复杂,但 FlashAttention-2 仍然通过避免“split-K”方案来减少共享内存的读写,实现了性能提升。
实现效果
FlashAttention-2 比第一代 FlashAttention 快 1.7-3.0 倍,比 Triton 实现的 FlashAttention 快 1.3-2.5 倍。

在 A100 GPU 上,FlashAttention-2 在前向传播中达到了 230 TFLOPs/s 的峰值,相当于理论最大吞吐量的 73%。在后向传播中,它达到了理论最大吞吐量的 63%。
FlashAttention v3
FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
https://arxiv.org/abs/2407.08608
虽然之前的 FlashAttention 通过减少内存读写来加速计算,但它未能充分利用现代硬件(如 Hopper GPU)的新特性。例如,FlashAttention-2 在 H100 GPU 上的利用率仅为 35%。
与 FlashAttention-2 类似,FlashAttention-3 也将任务并行化到不同的线程块(CTA),但其创新之处在于在单个线程块内部,将线程束(warps)划分为不同的角色。
- 生产者(Producer):负责将数据从 HBM(全局内存)异步加载到 SMEM(共享内存)。
- 消费者(Consumer):在数据加载完成后,从 SMEM 读取数据并执行计算。
生产者和消费者通过一个**循环缓冲区(circular buffer)**进行同步。生产者将数据放入缓冲区,消费者从中取出。当缓冲区中的一个“阶段”被消费后,生产者就可以继续向其中加载新数据。
线程内部的 GEMM 和 Softmax 重叠
在标准 FlashAttention 中,GEMM 和 Softmax 存在顺序依赖:Softmax 必须在第一个 GEMM 计算完成后才能开始,而第二个 GEMM 必须等待 Softmax 的结果。


FlashAttention-3 通过在寄存器中使用额外的缓冲区,打破了这种依赖关系。在每次循环中,它异步启动下一个 GEMM 的计算,而同时执行当前 GEMM 结果的 Softmax 和更新操作。这样,GEMM 和 Softmax 的执行就可以重叠,提高了效率。
FP8 低精度计算
FP8 的 WGMMA(Warp Group Matrix-Multiply-Accumulate)指令要求输入矩阵具有特定的k-major 布局,而输入张量通常是mn-major 布局。

FlashAttention-3 选择在 GPU 内核中(in-kernel)进行转置。它利用 LDSM/STSM 指令,这些指令能够高效地在 SMEM 和 RMEM(寄存器)之间进行数据传输,并在传输过程中完成布局转置,避免了代价高昂的 HBM 读写。
同于传统的逐张量(per-tensor)量化,FlashAttention-3 对每个块进行单独量化。这使得每个块可以有自己的缩放因子,从而更有效地处理离群值,减少量化误差。
实现效果
FlashAttention-3 的前向传播速度比 FlashAttention-2 快 1.5-2.0 倍,后向传播快 1.5-1.75 倍。FP16 版本的 FlashAttention-3 达到了 740 TFLOPs/s 的峰值,相当于 H100 GPU 理论最大吞吐量的 **75%**。

在处理中长序列(1k 及以上)时,FlashAttention-3 的性能甚至超过了 NVIDIA 自家闭源、针对 H100 优化的 cuDNN 库。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
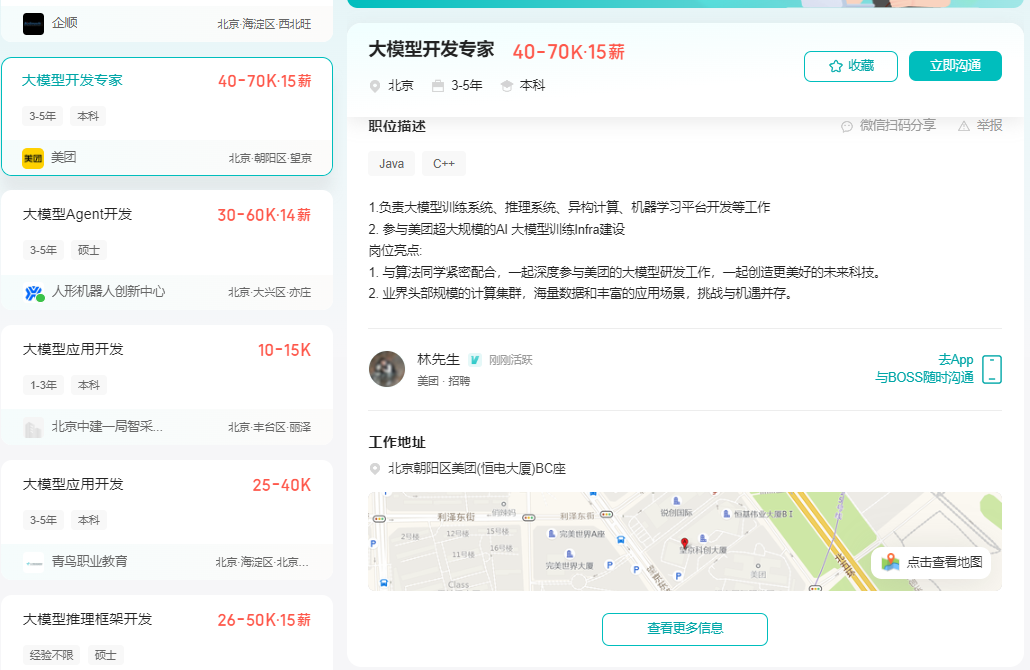
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.如何学习大模型 AI ?
🔥AI取代的不是人类,而是不会用AI的人!麦肯锡最新报告显示:掌握AI工具的从业者生产效率提升47%,薪资溢价达34%!🚀
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 20
 0
- 0


 已为社区贡献104条内容

所有评论(0)