基于 Hadoop/Spark 的分布式爬虫与舆情分析系统实战
·
📄 项目摘要
本项目设计并实现了一个基于 Hadoop 与 Spark 架构的分布式网络爬虫与舆情分析系统,旨在从海量互联网新闻与社交媒体数据中自动采集信息,并进行实时清洗、情感分析与可视化展示。系统采用 Lambda 架构,融合批处理与流式计算,具备高可扩展性与实时性。
整体系统由四大模块构成:
- 分布式爬虫层:基于 Scrapy 与 Redis 实现去重调度,通过 Kafka 将采集数据异步传输;
- 数据处理层:利用 Spark Streaming 消费 Kafka 数据,完成数据清洗与结构化存储;
- 舆情分析层:基于 Spark SQL 与 MLlib,结合 Jieba 中文分词与自定义情感词典,实现情感极性判断与关键词提取;
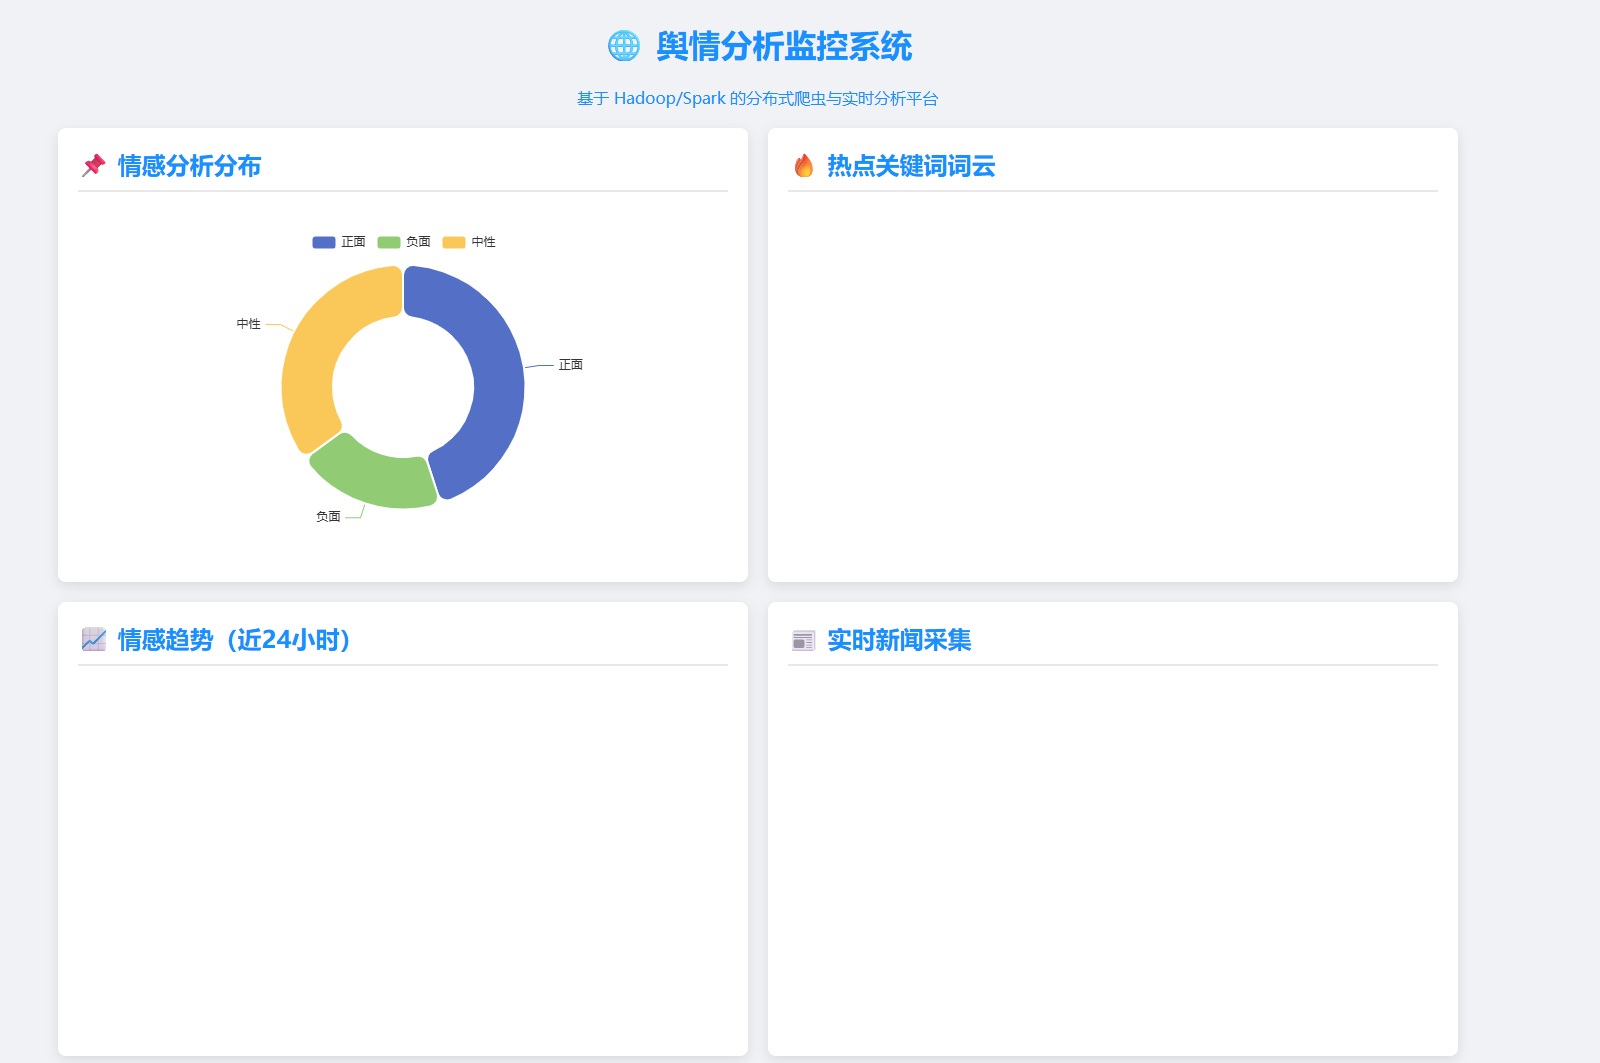
- 可视化展示层:通过 Flask 构建 Web 服务,使用 ECharts 实现情感分布、热点词云、趋势分析等多维度动态展示。
系统支持横向扩展,可部署于集群环境,能够有效应对大规模非结构化文本数据的处理需求。实验结果表明,该系统在中文网络舆情监控场景下具有良好的实用性与稳定性,可为政府、企业等机构提供决策支持。
关键词:分布式爬虫;Spark Streaming;舆情分析;情感计算;ECharts;大数据可视化
在当今信息爆炸的时代,网络舆情已成为政府、企业、媒体关注的重点。如何从海量新闻、社交媒体中自动采集数据,并进行情感分析、热点提取与可视化展示?本文将带你从零开始,手把手实现一个基于 Hadoop/Spark 的分布式爬虫与舆情分析系统。
本项目融合了 Scrapy 分布式爬虫、Kafka 消息队列、Spark Streaming 实时处理、Spark MLlib 舆情分析、Flask 可视化 等核心技术,适合大数据、人工智能方向的初学者和进阶者学习。
🧩 一、系统架构设计
我们采用经典的 Lambda 架构,兼顾实时性与批处理能力。
+------------------+     +---------------------+
|   分布式爬虫集群   | --> |   Kafka 消息队列     |
+------------------+     +---------------------+
                                 |
                                 v
                    +-------------------------+
                    |   Spark Streaming       | --> 清洗、结构化
                    +-------------------------+
                                 |
                                 v
                    +-------------------------+
                    |   HDFS / 本地存储        |
                    +-------------------------+
                                 |
         +-----------------------+------------------------+
         |                                                |
         v                                                v
+----------------------+                    +--------------------------+
|   Spark SQL 统计      |                    |   Spark MLlib 情感分析     |
+----------------------+                    +--------------------------+
                                 |
                                 v
                    +-------------------------+
                    |     Flask + ECharts     |
                    |       可视化平台          |
                    +-------------------------+
⚙️ 二、环境准备
1. 技术栈
| 模块 | 技术 |
|---|---|
| 爬虫 | Scrapy + Redis |
| 消息队列 | Kafka |
| 分布式计算 | Spark (PySpark) |
| 分析 | Jieba + Spark MLlib |
| 可视化 | Flask + ECharts |
| 存储 | HDFS(本地用文件模拟) |
2. 安装依赖
# 创建虚拟环境
conda create -n spark-crawler python=3.9
conda activate spark-crawler

# 安装 Python 包
pip install scrapy scrapy-redis kafka-python pyspark jieba flask textblob
3. 启动 Kafka 和 Redis(Docker)
# 启动 Redis
docker run -d --name redis -p 6379:6379 redis

# 启动 ZooKeeper
docker run -d --name zookeeper -p 2181:2181 zookeeper

# 启动 Kafka
docker run -d --name kafka -p 9092:9092 --link zookeeper \
  -e KAFKA_ZOOKEEPER_CONNECT=zookeeper:2181 \
  -e KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://localhost:9092 \
  -e KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR=1 \
  wurstmeister/kafka
🕷️ 三、分布式爬虫模块(Scrapy + Redis)
项目结构
crawler/
├── scrapy.cfg
└── crawler/
    ├── __init__.py
    ├── items.py
    ├── pipelines.py
    ├── settings.py
    └── spiders/
        └── news_spider.py
1. items.py:定义数据结构
import scrapy

class NewsItem(scrapy.Item):
    title = scrapy.Field()
    content = scrapy.Field()
    source = scrapy.Field()
    url = scrapy.Field()
    publish_time = scrapy.Field()
    crawl_time = scrapy.Field()
2. pipelines.py:写入 Kafka
from kafka import KafkaProducer
import json
from datetime import datetime

class KafkaPipeline:
    def open_spider(self, spider):
        self.producer = KafkaProducer(
            bootstrap_servers='localhost:9092',
            value_serializer=lambda v: json.dumps(v, ensure_ascii=False).encode('utf-8')
        )
        self.topic = 'news_topic'

    def process_item(self, item, spider):
        data = {
            'title': item.get('title'),
            'content': item.get('content'),
            'source': item.get('source'),
            'url': item.get('url'),
            'publish_time': item.get('publish_time'),
            'crawl_time': datetime.now().strftime('%Y-%m-%d %H:%M:%S')
        }
        self.producer.send(self.topic, data)
        return item

    def close_spider(self, spider):
        self.producer.flush()
        self.producer.close()
3. settings.py:启用 Redis 调度
BOT_NAME = 'crawler'
SPIDER_MODULES = ['crawler.spiders']
NEWSPIDER_MODULE = 'crawler.spiders'

# Redis 调度
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RByteDupeFilter"
REDIS_URL = 'redis://localhost:6379'

# 管道
ITEM_PIPELINES = {
    'crawler.pipelines.KafkaPipeline': 300,
}

DOWNLOAD_DELAY = 1
USER_AGENT = 'Mozilla/5.0 ...'
ROBOTSTXT_OBEY = False
4. spiders/news_spider.py:爬取新浪新闻
import scrapy
from ..items import NewsItem
from urllib.parse import urljoin

class SinaNewsSpider(scrapy.Spider):
    name = 'sina_news'
    allowed_domains = ['sina.com.cn']
    start_urls = ['https://news.sina.com.cn/']

    def parse(self, response):
        links = response.css('a::attr(href)').getall()
        for link in links:
            if 'article' in link or 'detail' in link:
                full_url = urljoin(response.url, link)
                yield scrapy.Request(full_url, callback=self.parse_article)

    def parse_article(self, response):
        item = NewsItem()
        item['title'] = response.css('h1::text').get() or response.xpath('//title/text()').get()
        item['content'] = ' '.join(response.css('p::text').getall()).strip()
        item['source'] = 'sina'
        item['url'] = response.url
        item['publish_time'] = response.css('.time::text').get() or response.xpath('//meta[@name="pubdate"]/@content').get()
        yield item
5. 启动爬虫
# 放入起始 URL
redis-cli LPUSH sina_news:start_urls https://news.sina.com.cn/

# 启动爬虫(可多台机器并行)
scrapy crawl sina_news
数据将自动写入 Kafka
news_topic
🔁 四、Spark Streaming 实时清洗
文件:streaming/consumer.py
from pyspark.sql import SparkSession
from pyspark.sql.functions import *
from pyspark.sql.types import *

spark = SparkSession.builder \
    .appName("NewsConsumer") \
    .config("spark.sql.streaming.checkpointLocation", "/tmp/checkpoint") \
    .getOrCreate()

kafka_bootstrap_servers = "localhost:9092"
kafka_topic = "news_topic"

df = spark \
    .readStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", kafka_bootstrap_servers) \
    .option("subscribe", kafka_topic) \
    .load()

schema = StructType([
    StructField("title", StringType(), True),
    StructField("content", StringType(), True),
    StructField("source", StringType(), True),
    StructField("url", StringType(), True),
    StructField("publish_time", StringType(), True),
    StructField("crawl_time", StringType(), True)
])

parsed_df = df.select(
    from_json(col("value").cast("string"), schema).alias("data")
).select("data.*")

cleaned_df = parsed_df.filter(
    (col("title").isNotNull()) & (length(col("title")) > 5)
).withColumn(
    "content", regexp_replace(col("content"), "<[^>]+>", "")
).withColumn(
    "title", trim(col("title"))
)

query = cleaned_df.writeStream \
    .outputMode("append") \
    .format("parquet") \
    .option("path", "output/news_raw") \
    .option("checkpointLocation", "output/checkpoint") \
    .start()

query.awaitTermination(60)
spark.stop()
🧠 五、舆情分析(情感 + 关键词)
文件:analysis/sentiment_analysis.py
from pyspark.sql import SparkSession
from pyspark.sql.functions import *
import jieba
import jieba.analyse

# 停用词
stop_words = set()
with open("stopwords.txt", "r", encoding="utf-8") as f:
    stop_words = set([line.strip() for line in f])

def analyze_sentiment(text):
    if not text:
        return "中性"
    positive = {'好', '积极', '成功', '赞扬', '优秀', '正面'}
    negative = {'坏', '失败', '批评', '负面', '差劲', '糟糕'}
    words = [w for w in jieba.cut(text) if w not in stop_words and w.isalnum()]
    pos = sum(1 for w in words if w in positive)
    neg = sum(1 for w in words if w in negative)
    return "正面" if pos > neg else "负面" if neg > pos else "中性"

sentiment_udf = udf(analyze_sentiment, StringType())

def extract_keywords(text):
    if not text:
        return []
    keywords = jieba.analyse.textrank(text, topK=5, withWeight=False)
    return [kw for kw in keywords if kw not in stop_words]

keywords_udf = udf(extract_keywords, ArrayType(StringType()))

spark = SparkSession.builder.appName("SentimentAnalysis").getOrCreate()
df = spark.read.parquet("output/news_raw")

result_df = df.withColumn("sentiment", sentiment_udf(col("content"))) \
              .withColumn("keywords", keywords_udf(col("content")))

result_df.select("title", "sentiment", "keywords", "source", "crawl_time") \
         .write.mode("overwrite").parquet("output/analyzed")

# 统计情感分布
result_df.groupBy("sentiment").count().show()

spark.stop()
📊 六、可视化平台(Flask + ECharts)
文件:web/app.py
from flask import Flask, render_template, jsonify
from pyspark.sql import SparkSession

app = Flask(__name__)
spark = SparkSession.builder.appName("WebApp").getOrCreate()

@app.route('/')
def index():
    return render_template('index.html')

@app.route('/api/sentiment')
def sentiment():
    df = spark.read.parquet("output/analyzed")
    result = df.groupBy("sentiment").count().collect()
    data = [{"value": row['count'], "name": row['sentiment']} for row in result]
    return jsonify(data)

@app.route('/api/keywords')
def keywords():
    df = spark.read.parquet("output/analyzed")
    all_keywords = df.select(explode("keywords").alias("word")).groupBy("word").count()
    top_words = all_keywords.orderBy(desc("count")).limit(50).collect()
    data = [{"name": row['word'], "value": row['count']} for row in top_words]
    return jsonify(data)

if __name__ == '__main__':
    app.run(debug=True)
前端:web/templates/index.html
<!DOCTYPE html>
<html>
<head>
    <title>舆情分析系统</title>
    <script src="https://cdn.jsdelivr.net/npm/echarts@5.4.0/dist/echarts.min.js"></script>
</head>
<body>
    <h1>舆情分析 Dashboard</h1>
    <div id="sentiment" style="width: 600px; height: 400px;"></div>
    <div id="wordcloud" style="width: 800px; height: 400px;"></div>

    <script>
        const sentimentChart = echarts.init(document.getElementById('sentiment'));
        fetch('/api/sentiment').then(r => r.json()).then(data => {
            option = { series: [{ type: 'pie', data: data }] };
            sentimentChart.setOption(option);
        });

        const wordcloudChart = echarts.init(document.getElementById('wordcloud'));
        fetch('/api/keywords').then(r => r.json()).then(data => {
            option = { series: [{ type: 'wordCloud', data: data }] };
            wordcloudChart.setOption(option);
        });
    </script>
</body>
</html>
▶️ 七、运行流程
# 1. 启动 Kafka 和 Redis(Docker)
# 2. redis-cli LPUSH sina_news:start_urls https://news.sina.com.cn/
# 3. scrapy crawl sina_news
# 4. python streaming/consumer.py
# 5. python analysis/sentiment_analysis.py
# 6. python web/app.py
# 7. 浏览 http://localhost:5000
📦 项目结构
hadoop-spark-crawler/
├── crawler/               # 爬虫
├── streaming/             # Spark 流处理
├── analysis/              # 舆情分析
├── web/                   # 可视化
├── output/                # 输出
├── stopwords.txt          # 停用词
└── requirements.txt

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 24
 0
- 0


 已为社区贡献2条内容

所有评论(0)