机器学习第四章:决策树
决策树就是根据树的结构来对问题进行判断的过程,类似于我们人的脑回路的流程。
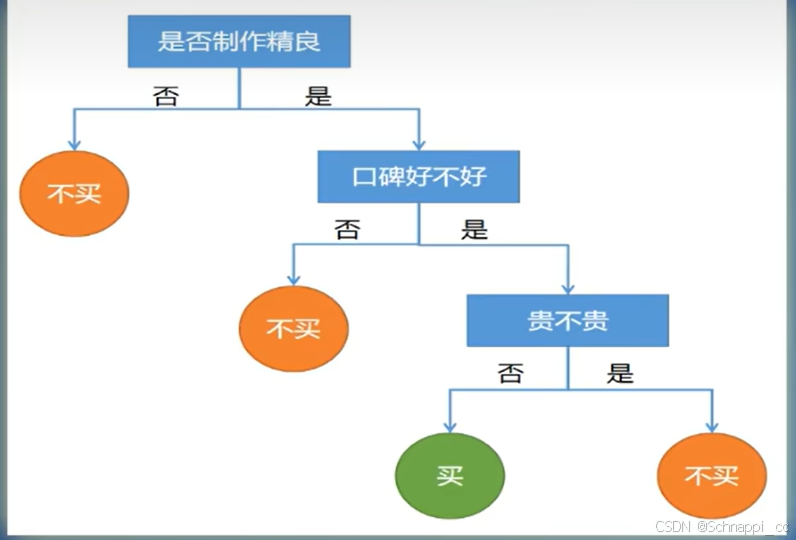
以二分类问题为例,一个样本有很多个属性,我们依次对每个属性进行判断,只有这个属性满足正类的特征,我们才判断下一个属性,最后得出最终结论:这个样本是不是正类。
一个决策树包含一个根节点,多个叶节点,多个内部节点。根节点包含样本全集,内节点对应一个属性测试,叶节点对应决策结果。
决策树学习的目的就是为了产生一棵泛化能力强的决策树,我们希望用它来帮我们做决策。
那么怎么构建决策树呢,根据不同的指标来构建就产生了不同的算法。
ID3算法
这个算法是根据信息增益来构建的。
我们希望决策树的分支节点所包含的样本尽可能属于同一类,也就是节点的纯度越高越好。通过信息熵可以度量纯度,信息熵可以理解为事件发生的不确定性,计算公式如下:
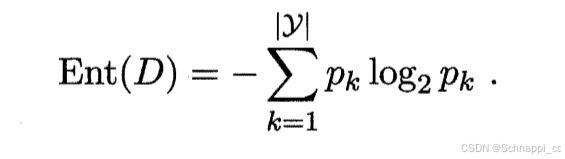
其中pk表示集合D中第k类样本的所占的比例,(k=1,2,...,|y|)。Ent(D)值越小,代表纯度越高,不确定性越小。
假设一个属性a有V个可能的取值,根据a进行划分,就可以分为v个分支节点,记作Dv,由于每个分支节点上的样本数不同,需要加权来消除这个影响因素。
那么就可以计算属性a对样本D进行划分的信息增益,计算公式如下:
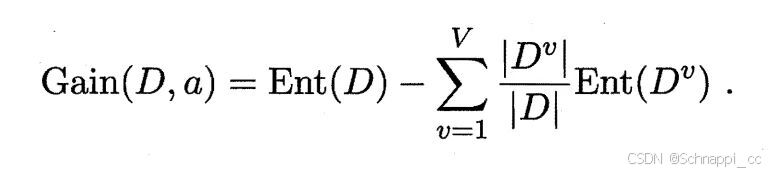
这个信息增益的值越大,代表我们可以使用这个属性来进行决策树的划分属性选择,也就是在分支节点使用这个属性来分类。
- 举个例子可以跟好的理解这个算法
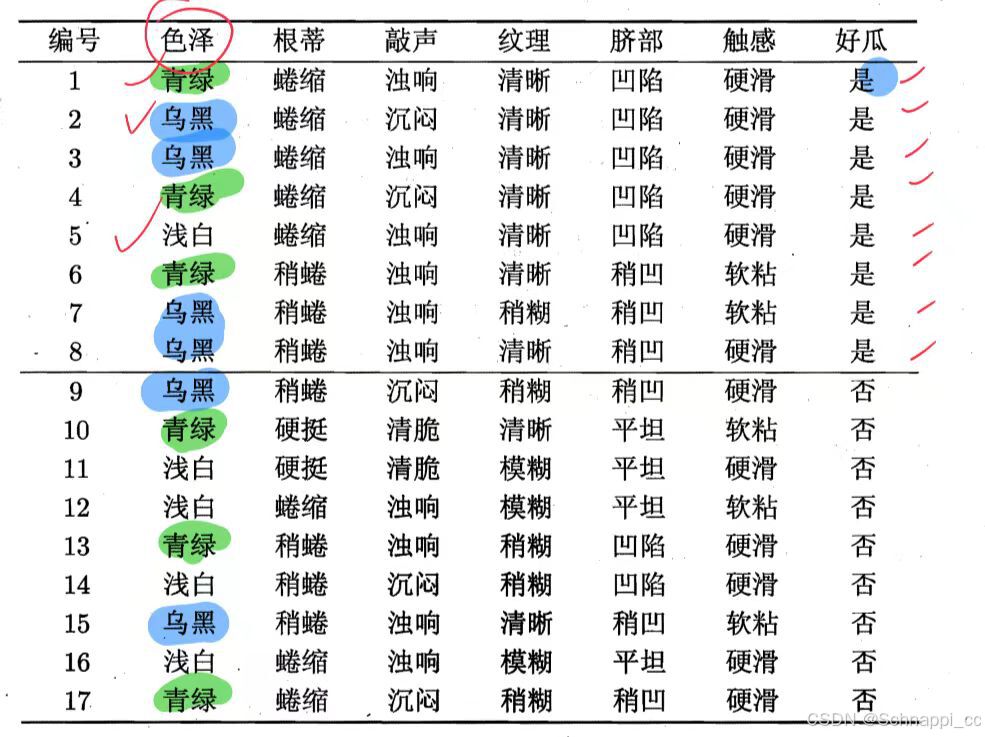
假设数据集如上所示,我们要预测一个没切开的西瓜是不是好瓜。
- 根节点包含所有的样本,根据公式可以计算出根节点的熵
- 然后以第一个属性色泽为例,有青绿、乌黑、和浅白 三个取值,记为D1,D2,D3。D1包含6个样例,其中3个为好瓜,3个为坏瓜。进而可以计算出三者的熵:Ent(D1) = 1 ,Ent(D2) = 0.918 ,Ent(D3) = 0.722 。
- 然后根据公式就可以计算出色泽这个属性的信息增益
Gain(D,色泽) = - 那么其他属性的信息增益也是一样的方法计算
Gain(D,根蒂) = 0.143,
Gain(D,敲声) = 0.141
Gain(D,纹理) = 0.381,
Gain(D,脐部) = 0.289,
Gain(D,触感) = 0.006 - 可以发现,纹理的信息增益最大,那么就可以用纹理这个属性对根节点进行划分,可以得到如下的分类结果:
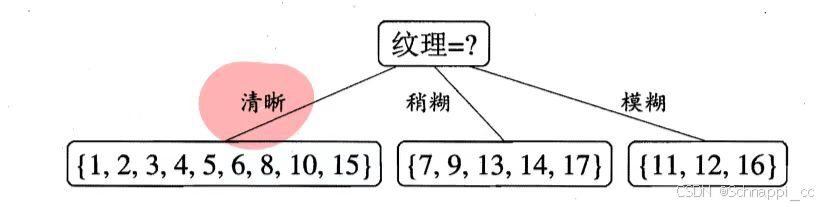
- 然后,同样的,以纹理为清晰的字节点为例,我们可以计算除了纹理之外的所有属性的信息增益,然后取最大的进行分类,如果多个属性的信息增益相同,任选其一即可。
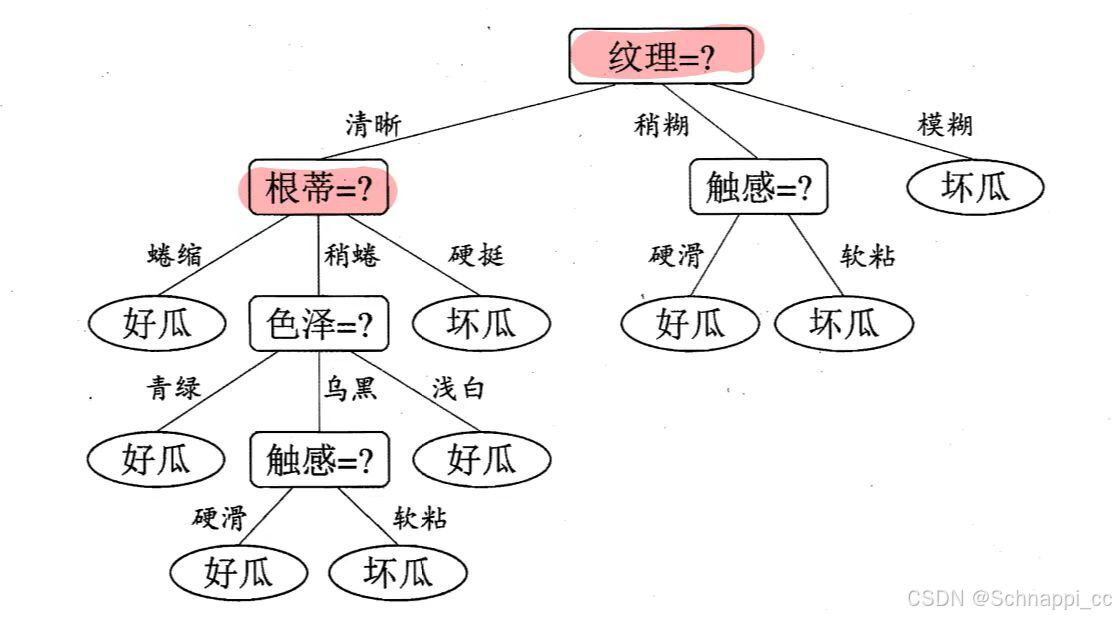
- 最后,可以得到如下的决策树:
C4.5算法
现在,我们考虑一个极端例子:
假设属性 A 在数据集中每个样本都有一个唯一的取值,也就是该属性的取值数目与样本数目相同。在这种情况下,对于属性 A 的每个取值 v,子集 Sv 只包含一个样本。由于单个样本的熵为0(因为不存在不确定性),所以Ent(Sv)=0,这时候的信息增益达到了最大。所以可以得出结论:信息增益准则对可取值数目较多的属性有偏好。
为了规避这个影响,我们使用信息增益比(增益率)来构建决策树。也就是C4.5算法。
增益率的计算方式:
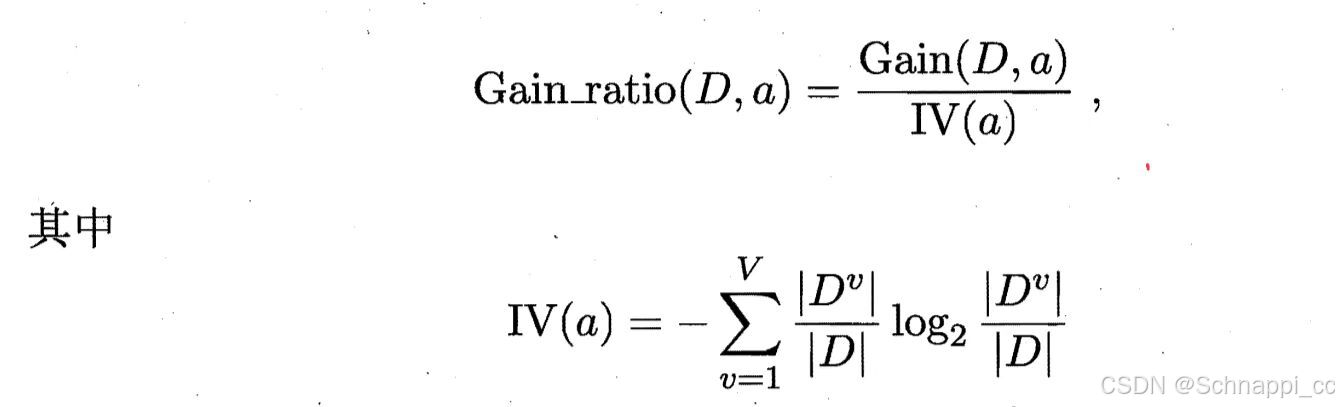
属性a的取值越多,一般来说 IV(a) 也越大。
- 首先要先计算每一个属性的信息增益,并计算他们的平均值
- 在从里面选出信息增益 > 平均值的属性
- 再从中选出增益率最高的属性作为划分属性。
CART算法
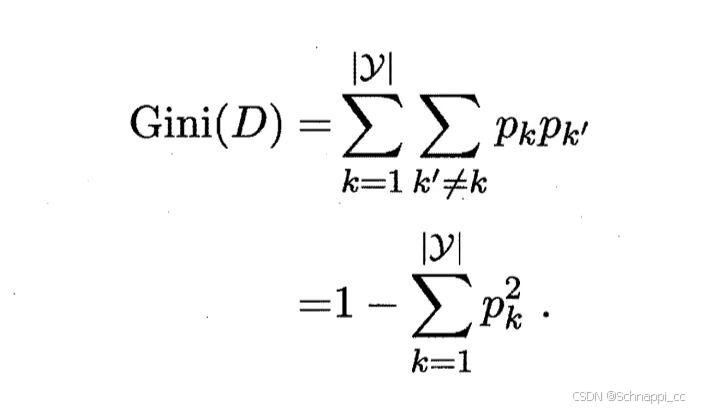
这个算法是根据基尼指数来构建决策树的,计算方法如下:
这个基尼值表示从集合中随机抽两个样本,类别标志不一致的概率,Gini值越小,数据集的纯度越高。计算方法如下:
属性a的基尼指数计算方法如下:
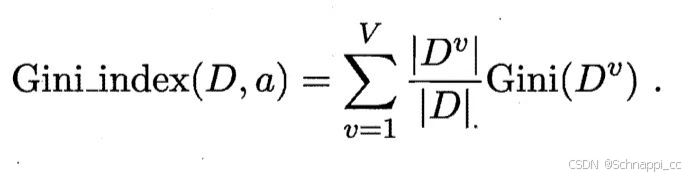
我们在计算每一个属性的基尼指数后,选择基尼指数最小的属性作为划分属性。
过拟合
为了防止过拟合,在决策数的分支过多的时候,我们会使用剪枝的手段来降低风险。剪枝分为预剪枝和后剪枝。
- 预剪枝是指在划分前进行估计,如果划分后无法带来决策树的性能提升,就停止划分,并将这个节点标记为叶节点。这个方法可以使决策树的很多分支无法展开,降低了过拟合的风险。
- 后剪枝是指生成决策树后,在从下往上对非叶节点进行考察,如果把这个节点对应的子树替换为叶节点可以带来决策树的性能提升,就把子树替换为叶节点。这个方法的泛化性能比预剪枝的好,但是训练时间比较长。
判断决策数的性能,可以利用性能指标来评估,有流出法、交叉验证法、自助法等等。
连续值的处理
使用的是C4.5算法。需要对连续值进行离散化处理,可以使用二分法。
假设数据集D中的属性a有n个不同的取值,从小到大排列,记作a1,a2,...,a。我们把区间 [ ai , ai + 1)的中点记作候选划分点,再对这些划分点计算信息增益,选择信息增益最大的点作为划分点。
缺失值的处理
我们经常会遇到样本的属性值缺失的情况,这时候我们就需要对其进行处理。
我们先把集合D中不缺失属性a的样本拿出来,记为集合D1,把p记为无缺失样本所占的比例,
再计算D1中属性a的信息增益Gain(D1,a),再计算 p*Gain(D1,a),即可得到样本集D的属性a的信息增益。最后把信息增益最大的属性进行划分。只是缺失属性a的样本要进入下面的每一个分支中。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)