【第十三周】机器学习笔记02
摘要
本周学习了线性回归中成本函数的基本概念及其与模型参数的关系,通过简化模型(f(x) = wx)直观展示了成本函数 J(w) 如何随参数 w 的变化而变化,并说明了如何通过最小化成本函数找到最优参数。进一步,文章详细讲解了梯度下降算法的原理、学习率的作用及其在线性回归中的应用,强调了梯度下降如何通过迭代更新参数使成本函数收敛到全局最小值,最终实现模型对数据的有效拟合。
Abstract
This week studies the basic concept of the cost function in linear regression and its relationship with model parameters. By using a simplified model (f(x) = wx), it visually demonstrates how the cost function J(w) varies with the parameter w and explains how to find the optimal parameters by minimizing the cost function. Furthermore, the article elaborates on the principle of the gradient descent algorithm, the role of the learning rate, and its application in linear regression, emphasizing how gradient descent iteratively updates parameters to converge the cost function to the global minimum, thereby achieving effective model fitting to the data.
一、代价函数的直观理解
上周我们学习成本函数的基本概念,所谓的成本函数,它衡量的是模型预测与y的实际真实值之间的差异,找到一个合适的成本函数,就是在线性回归中尝试找到w和b的值,然后使含有w的j尽可能的小,即我们要找到最小化的j,打个比方,成本函数j(x)就好比你行走的路线,假设我从A走到B,肯定是要找一个更近更省时的路线,成本函数就是估算你每条路所需要消耗的代价,以便你能找到一个条最合适的路线。
现在,为了让我们更好的可视化成本函数J,我们使用线性回归模型的简化版本。即f(x)= wx
你可以认为这是取左边的原始模型,去掉参数b,或者将参数b设置为0:
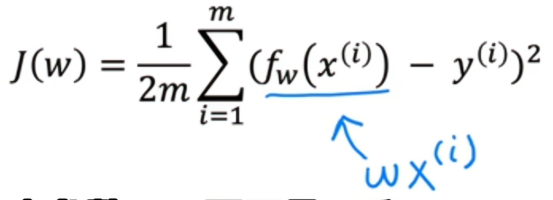
使用这个简单的模型,目标是找到w的值,使w的J最小化。从视觉上来看,这意味着如果b设置为0,则f定义一条看起来像这样的线:
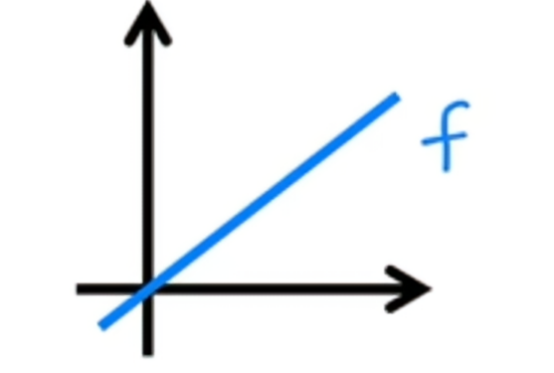
现在,使用这个简化的模型,让我们看看当我们为参数w选择不同的值成本函数会如何变化并且绘制出x的模型f和成本函数J的图表。可以看到两者之间的关系,首先我们要注意到,对于f下标w,当参数w固定不变时,即始终为常数值时,则f只是x的函数,也就是说y的估计值取决于输入x的值。相反,右边的成本函数是w的函数,其中w控制由fw定义的直线的斜率。J定义的成本取决于参数,在本例中为参数w。
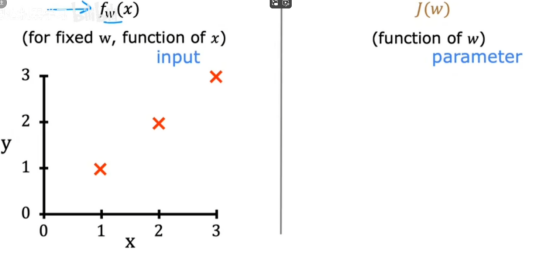
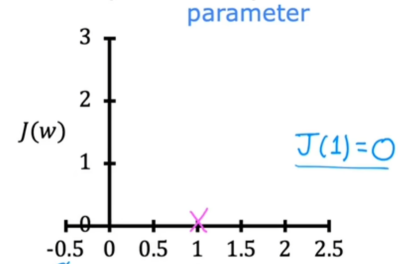
我们将从模型开始,即左侧x的函数fw,训练集是左图上的小红叉,所代表的是(1,1)、(2,2)、(3,3)这三个点,显而易见,我们可以选择w=1,即斜率为1的一条直线,接下来,我们可以计算w=1时的成本J。按照前面给的J(x)的公式,我们可以算到J=0。
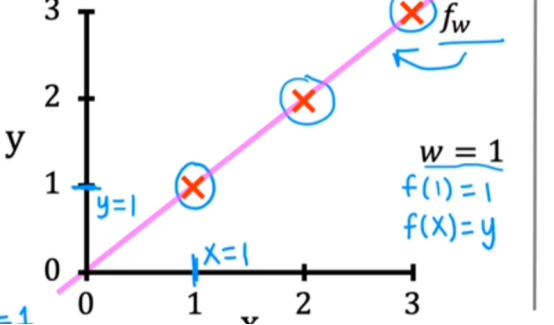
现在,我们绘制右边的成本函数J,注意因为成本函数J是w的函数,所以水平轴为w而不是x,垂直轴为J而不是y,刚才的结果是J(1)=0,换句话说,当w=1时,J(w)=0.
现在我们将w设置为0.5,即f(x)是一条斜率为0.5的一条直线,我们还可以计算成本函数J
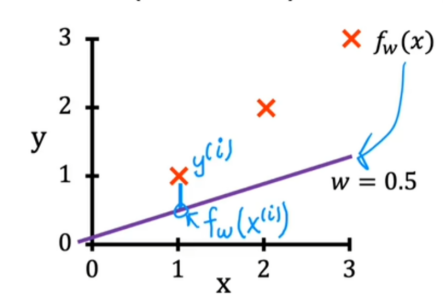
从视觉上我们可以看出,成本函数计算一个例子的误差就是计算该例子到成本函数垂直线的高度,对于第一个例子,当x为1,f(x)为0.5,所以第一个例子的平方误差为0.5-1的平方,依次计算其他例子的平方误差,把他们加和在一起,然后我们在乘以2m分之1,提醒一下m是训练示例的个数,最终我们算J大约为0.58,让我们继续在右边绘制它。
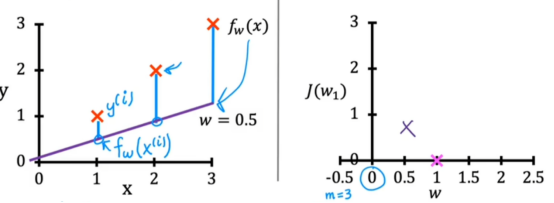
当我们w=0时,f和J的图形是什么样的呢?事实证明,如果w=0,那么f就是x轴水平线上的一条直线,每个示例的误差都是一条线,从每个点向下延伸到f的水平线上,此时算得J=2.33,然后再在右边绘制w=0且J=2.33的点。
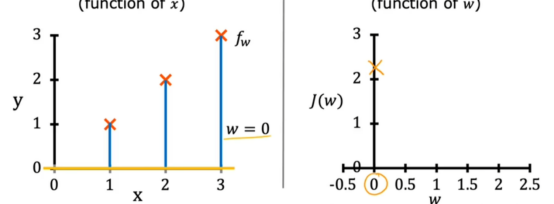
我们可以对w的其他值继续测试,由于w可以是任何数字,它也可以是负值,事实证明,通过一系列的计算,我们可以慢慢找出成本函数J的样子
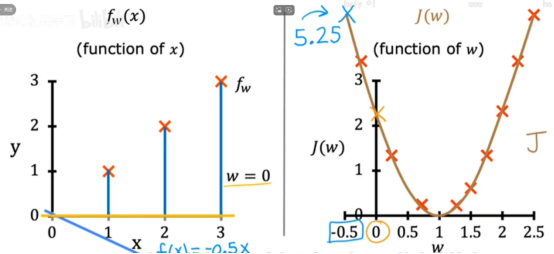
正如我们之前猜想的那样,J是衡量平方误差有多大的成本函数,因此选择最小化这些平方误差的w,使他们尽可能的小,将为我们提供一个好的模型,在本次示例中,如果我们选择的w值会导致w的J的最小可能值,我们最终会选择w=1,这就是在线性回归中如何使用成本函数来找到使J最小化的w值,在更一般的情况下,我们有参数的w和b而不仅仅是w,我们则需要找到使得J最小化的w和b的值,总而言之,我们看到了f和J的图,并且研究了两者之间的关系,线性回归的目标就是找到参数w和b,使得成本函数J的值最小
现在,让我们回到带有参数w和b的原始模型,但不将b设置为等于0,和上例一样,我们想要直观的了解函数模型,带有x的f,如左图所示,以及它与w、b的成本函数J的关系如右图所示。
二、梯度下降
梯度下降在机器学习中无处不在,不仅用于线性回归,还用于训练一些最先进的神经网络模型,也称为深度学习模型。梯度下降是一种可用于尝试最小化任何函数的算法,而不仅仅是线性回归的成本函数。如何使用梯度下降算法,我们要做的就是每次稍微改变参数w和b以尝试降低w和b的成本j,直到j稳定或接近最小值。需要注意的是,有些函数不像二次函数那样会只有一个最小值点。
让我们来看一个例子:
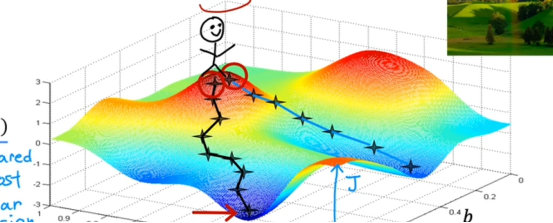
假设我们所处的红色山峰是一座山的山顶,现在我们要到整座山的山脚,于是我们选择左边的那条黑色道路,这条道路是从山顶通往山脚的,但是我们第二天上来,发现右边那条道路也可以到达山脚,这个例子旨在说明,不同的w和b的值可能导致相同的最小值。
梯度算法的公式为
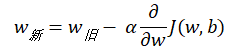
1、梯度下降的直观理解
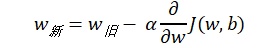
这是我们之前学习的梯度算法的公式,但我们开头说明了这次不仅仅只有参数w,还有参数b,其实参数b的公式跟w的有异曲同工之妙
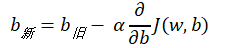
我们来看下公式里面参数的含义
b和w就无需多言了,在前面已经解释过了,α我们称为学习率,学习率控制的是更新模型参数w和b时采取的步骤大小,用我们上面下山的例子来说的话,学习率就是下山的步幅,学习率一般在0~1之间,学习率越大,我们下山的步幅就越大,下山就越快,学习率越小,我们下山的步幅就越小,下山就越慢。而后面的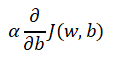
则是J(w,b)对b的偏导数。
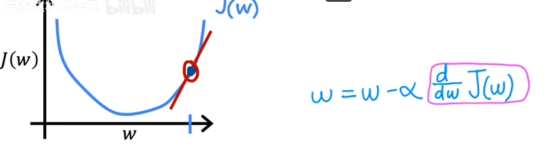
所谓偏导数,以上图为例,假设我们只有w一个参数,则是在函数某点的切线的斜率,当切线指向上方和右侧时,斜率为正,这意味着该导数是正数,因此大于0,更新后就是原来的w减去一个正数,得到的w新值会比原来的值小,在图中的表达的话,该w点会向左移动,这与我们降低成本J的目标不谋而合。
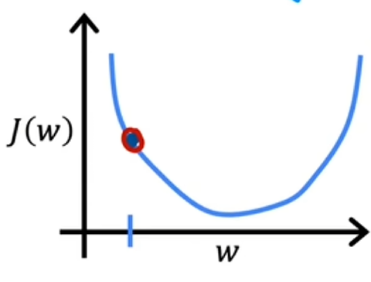
让我们再看另外一种情况,图中我们的点在左侧,我们得到的切线斜率是负数,这意味着偏导数是小于0的,这样原w值减去一个负数,即加上一个正数,新w值会比原w值大,在图中的表示就是该点向右移动,直到接近J的最小值。
2、学习率
学习率α的选择将对你实现梯度下降的效率产生巨大的影响,如果选择不当,下降率可能起不到效果甚至会起副作用
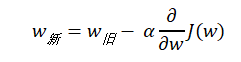
让我们再来看简化后只有一个参数的公式,看看如果学习率太小或者太大会发生什么。
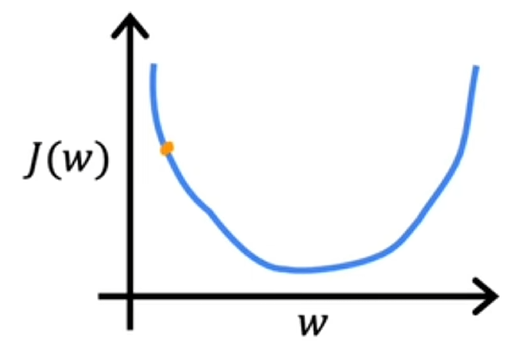
如果学习率太小,我们从黄色小点开始对下降进行分级,随后发生的事情是我们将导数项乘以一个非常非常小的数字,比如0.0000001,所以我们最终会迈出非常小的一步,如果我们要到达J的最小值的话,会迈出非常多的步骤,如下图所示。
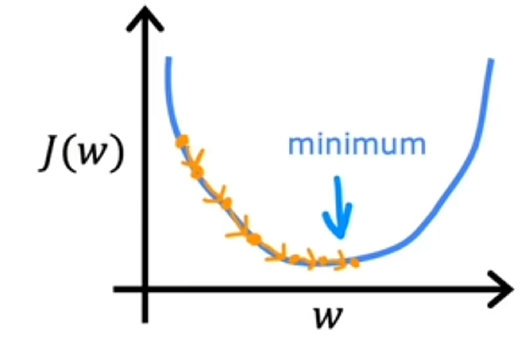
总而言之,如果学习率太小,虽然梯度下降会起作用,但速度会很慢,这样会耗费不必要的时间,也许学习率稍微大点也可以达到同样的效果,并且耗费的时间比学习率小的少。
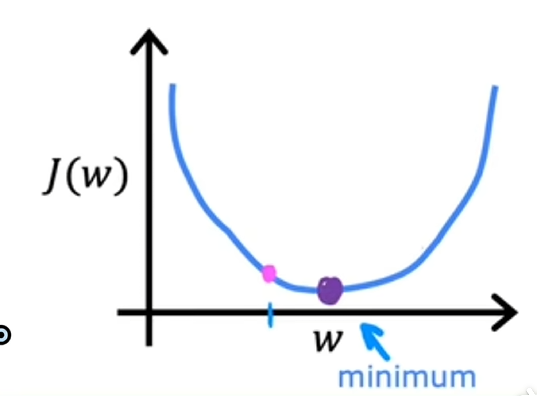
如果学习率太大会怎么样,让我们来看这样一个例子,现在我们在这个淡紫色小点这里,由图可知,该点离J的最小值已经非常接近了,如果学习率过大的话,那么我们更新w会迈出非常大的一步。
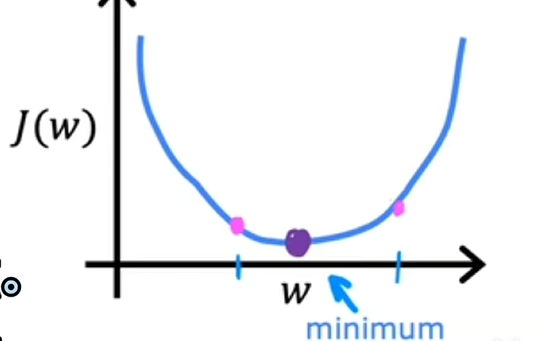
实际上更新w后花费的代价比没更新前花费的还多,这样我们会一步步离最小值越来越远,这样是适得其反的,我们永远不可能得到最小值。
还有一个更复杂的例子:
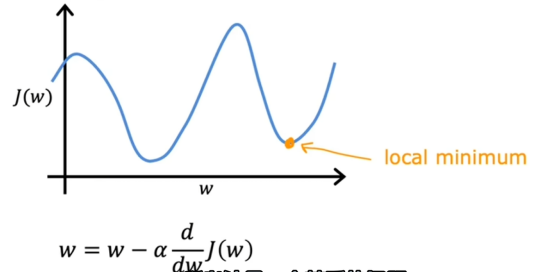
假设我们的成本函数是这样一种形状,我们看到这个成本函数右两个局部最小值,对应图中是两个低谷,假设目前我们在黄色小点上,该点是成本函数中的局部最小点,带入公式我们可以发现在这里切线斜率是为0,按照我们之前阐述的理论,切线斜率为0的话,意味着我们找到了成本函数中的最小值。
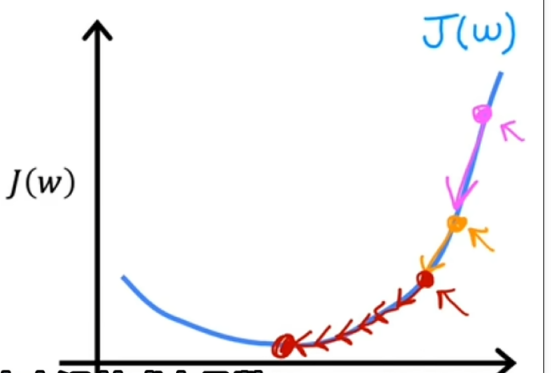
让我们来看另外一个例子来理解梯度下降算法为什么能够达到局部最小值。
我们初始点在紫色小点上,根据公式可知,在α不变的情况下,紫色小点的切线斜率是较大的并且为正数,这样会导致该点往左垮了一大步到达黄色小点上,相比于紫色小点,虽然黄色小点的切线斜率也为正数,但大小比紫色小点上的小,这样黄色小点会向左跨一步,但是比紫色跨的小,到达红色小点,同上面一样,红色小点的切线斜率会更小导致它向左迈出更小的一步,如此往复,直到达到局部最小值。
总而言之,在α合适且不变的情况下,我们越接近局部最小值,我们迈出的步幅就会越小,直到局部最小值,这就是梯度算法,我们可以用它来尝试最小化任何成本函数J。
3、线性回归下的梯度下降
使用平方误差成本误差成本函数来构建具有梯度下降的线性回归模型可以使我们能够训练线性回归模型以拟合一条直线来实现训练数据。
我们来回顾几个基本公式
线性回归模型:
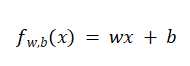
成本函数:
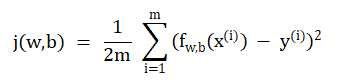
梯度下降算法:
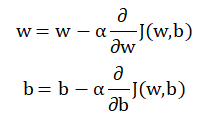
我们可以计算 和

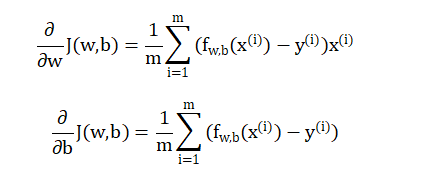
要知道如何计算出来,则是由微积分的知识推导而来,推导过程如下:
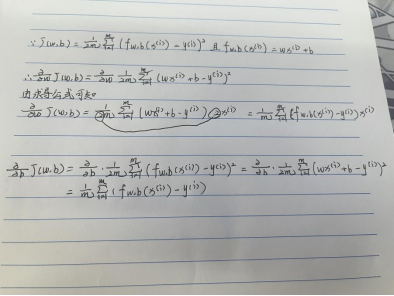
现在,让我们熟悉一下梯度下降的工作原理
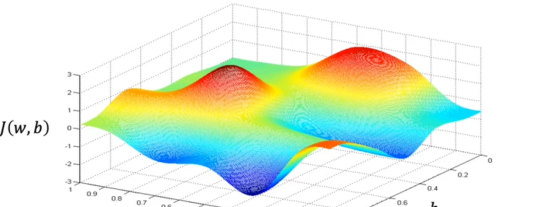
我们看到的一种梯度下降是它可以导致局部最小值而不是全局最小值,根据你初始w和b值的不同,我们可能会以不同的局部最小值结束。
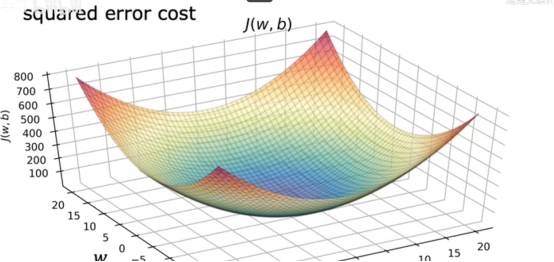
事实证明,当我们使用线性回归的平方误差成本函数时,成本函数不会也永远不会有多个局部最小值,由于这种碗形,它具有单一的全局最小值。通俗来说,它不会有任何局部最小值,好处是,当你选择了一个合适的学习率,它总是会收敛到全局最小值。
4、运行梯度下降
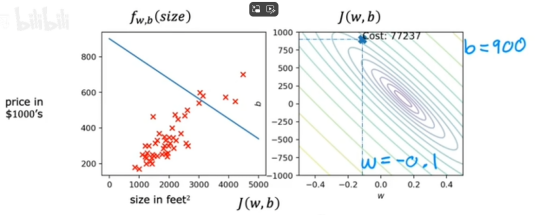
让我们来看看线性回归运行梯度下降时会发生什么,由上图可知,左边是模型和数据图,右上角是成本函数的等高线图,底部是相同成本函数的曲面图。,通常w和b都会被初始化0,但对于这个演示,让我们初始化w=-0.1和b=900.
现在,如果我们使用梯度下降迈出一步,我们最终会从成本函数的这一点向右下方移动到这一点。
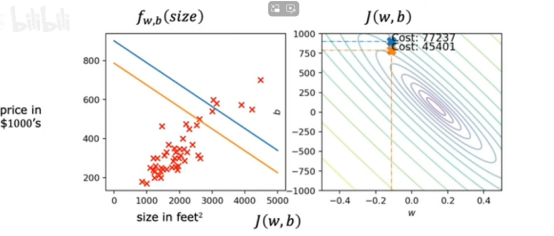
当成本函数移动到第三个,函数f同样会发生变化。
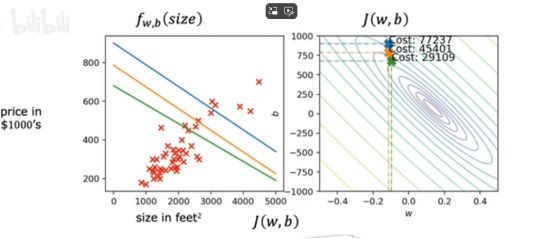
随着我们采取更多的步骤,每次更新成本都会降低,所以参数w和b遵循这个轨迹,我们看向下图的左边,我们会发现,拟合直线会越来越适合数据,直到我们达到全局最小值。
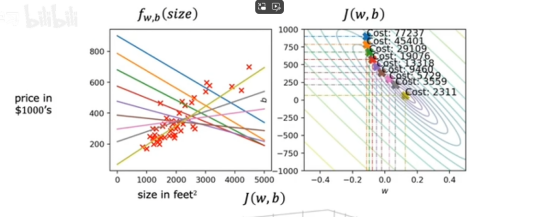
全局最小值对应的是最后一条直线 ,对数据拟合的比较好,这就是梯度下降,我们将使用它来使模型适合持有的数据,现在我们可以使用此f(x)模型来预测我们的客户或其他人的房屋价格。
更严格来说,这个梯度下降过程被称为批量梯度下降,在梯度下降的每一步中,我们都在查看所有的训练示例而不仅仅是训练数据的一个子集。
总结
本文系统阐述了成本函数与梯度下降在线性回归中的核心作用。成本函数量化了模型预测与真实值的误差,而梯度下降通过迭代优化参数最小化这一误差。学习率的选择对算法效率至关重要,过大或过小均会影响收敛效果。线性回归的平方误差成本函数具有唯一全局最小值,确保了梯度下降的有效性。最终,通过批量梯度下降可得到最优模型,实现对数据的准确拟合。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 10
 0
- 0


 已为社区贡献6条内容

所有评论(0)